香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


最小可用的海外 AI 知识库,不需要在服务器上部署大模型。服务器只负责运行一个轻量 API 服务和向量数据库,问题改写、文本向量化与最终回答交给兼容 OpenAI 接口格式的模型服务完成。这样可以在没有 GPU 的情况下,先完成知识库导入、检索问答和访问验证。
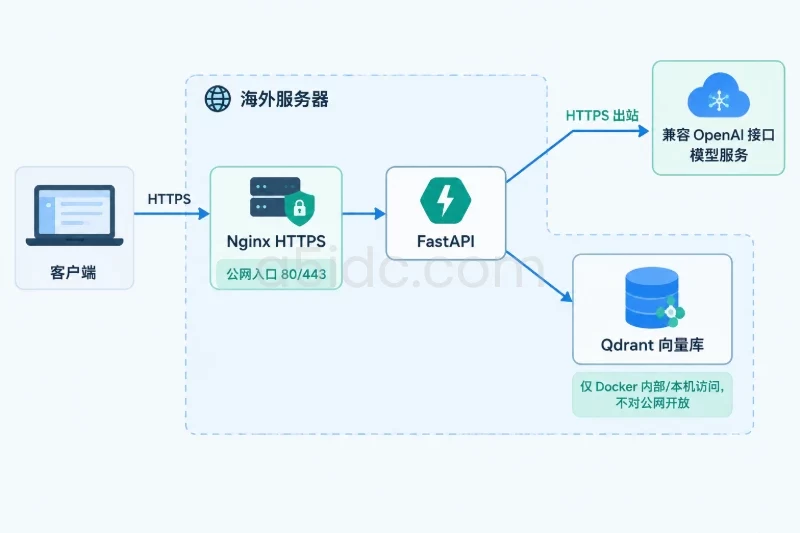
本方案使用 Ubuntu 22.04/24.04、Docker Compose、Qdrant 向量库和一个 FastAPI 应用。完成后,访问链路为“客户端 → Nginx HTTPS → FastAPI → 模型接口与 Qdrant”,其中 Qdrant 不对公网开放,管理重建接口也限制在服务器本机调用。适合首次上线少量 Markdown、TXT 文档的内部问答服务,暂不包含多租户、复杂权限、文件在线上传和会话持久化。
A5数据面向海外AI知识库、接口服务与容器化应用,提供中国香港、美国、日本、韩国、中国台湾、新加坡和马来西亚等地区的物理服务器资源,覆盖AMD EPYC、Xeon、NVMe存储及不同带宽线路配置,可为FastAPI应用、向量数据库、原始文档存储和多任务运行提供相应的硬件与网络基础;香港、美国的GPU系列也可用于模型推理和相关计算场景。
由于模型不在本机运行,服务器不需要 GPU。以下是首次部署的参考配置:
| 项目 | 建议值 | 说明 |
|---|---|---|
| 操作系统 | Ubuntu 22.04 LTS 或 24.04 LTS | 使用 amd64 架构示例 |
| CPU | 2 vCPU 起 | 用于 API、文本切分和向量入库 |
| 内存 | 4 GB 起 | 文档量较小可从 2 GB 起步 |
| 磁盘 | 20 GB SSD 起 | 包含系统、镜像、向量库和备份空间 |
| 公网端口 | 22、80、443 | 22 用于管理,80 用于证书验证,443 提供 HTTPS |
| 出站网络 | 允许访问模型接口的 HTTPS | 文档和问题可能会发送到模型服务商 |
| 域名 | 建议准备一个独立子域名 | 例如 kb.example.com |
这里的配置是小规模知识库的起步参考,不代表固定容量上限。真正的容量取决于文档数量、切块大小、向量维度、模型接口限制和并发量。
服务器所在地区会影响访问者到服务器的延迟,也可能影响服务器访问模型接口的网络质量。部署前应确认以下事项:
| 组件 | 作用 | 是否对公网开放 |
|---|---|---|
| Nginx | HTTPS 终止、反向代理和管理接口限制 | 是,仅开放 80/443 |
| FastAPI 应用 | 接收问题、调用模型、检索知识库、返回答案 | 仅绑定服务器本机 |
| Qdrant | 保存文档向量和文本片段 | 否,仅允许 Docker 内部和本机访问 |
| 外部模型接口 | 生成向量和回答 | 由服务器主动出站访问 |
/data 目录 | 保存待导入的 Markdown/TXT 文件 | 不直接暴露下载 |
应用只保存向量和文本片段,不保存完整聊天会话。每次请求会把问题转换为向量,再从 Qdrant 找出相似片段,将这些片段与问题一起发送给聊天模型。
示例程序使用以下两个接口:
POST {MODEL_BASE_URL}/embeddings
POST {MODEL_BASE_URL}/chat/completions
模型服务需要返回类似下面的 JSON 结构:
{
  "data": [
    {
      "index": 0,
      "embedding": [0.0123, -0.0456]
    }
  ]
}
聊天接口需要返回类似下面的结构:
{
  "choices": [
    {
      "message": {
        "content": "回答内容"
      }
    }
  ]
}
不同服务商可能使用不同的模型名称,但只要基础地址和返回格式兼容,应用代码通常不需要修改。如果服务商的嵌入接口路径、认证方式或返回字段不同,应先按照服务商接口文档调整代码,不要直接把聊天模型名称填入嵌入模型配置。
先通过 SSH 登录服务器,确认系统版本和磁盘空间:
cat /etc/os-release
uname -m
df -h /
示例方案以 x86_64 或 amd64 为主。如果输出的是其他架构,应先确认所选 Docker 镜像和 Python 基础镜像是否支持。
更新系统软件索引并安装 Docker:
sudo apt-get update
sudo apt-get install -y ca-certificates curl docker.io docker-compose-plugin
sudo systemctl enable --now docker
检查版本:
sudo docker version
sudo docker compose version
需要确认命令是 docker compose,而不是旧版的 docker-compose。如果系统提示找不到 docker-compose-plugin,不要同时安装多个来源的 Compose 版本,应根据当前 Ubuntu 软件源或 Docker 官方软件源补齐插件,再重新执行版本检查。
本方案后面的命令全部使用 sudo docker compose,这样不需要把当前用户加入 Docker 用户组。将用户加入 docker 组会赋予其近似 root 的主机控制能力,如果确实需要免 sudo 使用 Docker,应先确认该权限边界。
sudo mkdir -p /opt/ai-kb/app
sudo mkdir -p /opt/ai-kb/data
sudo mkdir -p /opt/ai-kb/backup
sudo chown -R "$USER":"$USER" /opt/ai-kb
cd /opt/ai-kb
最终目录结构如下:
/opt/ai-kb/
├── app/
│   ├── app.py
│   ├── Dockerfile
│   └── requirements.txt
├── data/
├── backup/
├── .env
└── compose.yaml
先生成一个应用访问密钥:
openssl rand -hex 32
复制输出结果,写入 .env。下面的模型名称和接口地址是占位示例,需要替换为实际可用的值:
APP_API_KEY=替换为刚才生成的随机字符串

MODEL_BASE_URL=https://api.example.com/v1
MODEL_API_KEY=替换为模型服务商的API密钥
CHAT_MODEL=chat-model-name
EMBEDDING_MODEL=embedding-model-name

QDRANT_URL=http://qdrant:6333
QDRANT_COLLECTION=kb_documents
DATA_DIR=/data
MODEL_TIMEOUT=60
写入后限制权限:
chmod 600 /opt/ai-kb/.env
注意事项:
MODEL_BASE_URL 通常需要包含服务商要求的版本路径,例如 /v1,但不要机械添加,需以接口文档为准。CHAT_MODEL 和 EMBEDDING_MODEL 通常不是同一个模型。APP_API_KEY 是访问本应用的密钥,与模型服务商的 MODEL_API_KEY 不是一回事。APP_API_KEY。创建 /opt/ai-kb/app/requirements.txt:
fastapi==0.115.6
uvicorn[standard]==0.34.0
httpx==0.28.1
qdrant-client==1.13.3
pydantic==2.10.5
这些版本用于形成一个可重复构建的示例环境。如果后续升级依赖,应先在备份或测试目录验证 Qdrant 客户端接口是否仍然兼容。
创建 /opt/ai-kb/app/Dockerfile:
FROM python:3.11-slim

ENV PYTHONDONTWRITEBYTECODE=1
ENV PYTHONUNBUFFERED=1

WORKDIR /app

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY app.py .

EXPOSE 8000

CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000"]
创建 /opt/ai-kb/app/app.py:
import hashlib
import hmac
import os
import uuid
from pathlib import Path
from typing import Optional

import httpx
from fastapi import Depends, FastAPI, Header, HTTPException
from pydantic import BaseModel, Field
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, PointStruct, VectorParams


API_KEY = os.getenv("APP_API_KEY", "")
MODEL_BASE_URL = os.getenv("MODEL_BASE_URL", "").rstrip("/")
MODEL_API_KEY = os.getenv("MODEL_API_KEY", "")
CHAT_MODEL = os.getenv("CHAT_MODEL", "")
EMBEDDING_MODEL = os.getenv("EMBEDDING_MODEL", "")
QDRANT_URL = os.getenv("QDRANT_URL", "http://qdrant:6333")
COLLECTION_NAME = os.getenv("QDRANT_COLLECTION", "kb_documents")
DATA_DIR = Path(os.getenv("DATA_DIR", "/data"))
MODEL_TIMEOUT = float(os.getenv("MODEL_TIMEOUT", "60"))

if not MODEL_BASE_URL or not MODEL_API_KEY:
    raise RuntimeError("MODEL_BASE_URL 和 MODEL_API_KEY 不能为空")

if not CHAT_MODEL or not EMBEDDING_MODEL:
    raise RuntimeError("CHAT_MODEL 和 EMBEDDING_MODEL 不能为空")

app = FastAPI(
    title="Minimal AI Knowledge Base",
    docs_url=None,
    redoc_url=None,
)

qdrant = QdrantClient(url=QDRANT_URL)


class ChatRequest(BaseModel):
    query: str = Field(min_length=1, max_length=2000)
    top_k: int = Field(default=4, ge=1, le=8)


class ReindexRequest(BaseModel):
    reset: bool = False


def require_api_key(x_api_key: Optional[str] = Header(default=None)):
    if not API_KEY:
        raise HTTPException(status_code=500, detail="服务端未设置 APP_API_KEY")

    if not x_api_key or not hmac.compare_digest(x_api_key, API_KEY):
        raise HTTPException(status_code=401, detail="无效的访问密钥")

    return True


async def model_post(path: str, payload: dict) -> dict:
    headers = {
        "Authorization": f"Bearer {MODEL_API_KEY}",
        "Content-Type": "application/json",
    }

    try:
        async with httpx.AsyncClient(timeout=MODEL_TIMEOUT) as client:
            response = await client.post(
                f"{MODEL_BASE_URL}{path}",
                headers=headers,
                json=payload,
            )
            response.raise_for_status()
            return response.json()
    except httpx.HTTPStatusError as exc:
        detail = exc.response.text[:500]
        raise HTTPException(
            status_code=502,
            detail=f"模型接口返回 HTTP {exc.response.status_code}: {detail}",
        ) from exc
    except httpx.RequestError as exc:
        raise HTTPException(
            status_code=502,
            detail=f"无法连接模型接口: {exc.__class__.__name__}",
        ) from exc


async def embed_texts(texts: list[str]) -> list[list[float]]:
    if not texts:
        return []

    vectors: list[list[float]] = []

    # 分批发送,避免一次请求过大。
    for start in range(0, len(texts), 32):
        batch = texts[start:start + 32]
        data = await model_post(
            "/embeddings",
            {
                "model": EMBEDDING_MODEL,
                "input": batch,
            },
        )

        items = data.get("data")
        if not isinstance(items, list) or len(items) != len(batch):
            raise HTTPException(
                status_code=502,
                detail="嵌入接口返回的数据数量与输入不一致",
            )

        items = sorted(items, key=lambda item: item.get("index", 0))

        for item in items:
            embedding = item.get("embedding")
            if not isinstance(embedding, list) or not embedding:
                raise HTTPException(
                    status_code=502,
                    detail="嵌入接口未返回有效向量",
                )
            vectors.append(embedding)

    return vectors


def collection_exists() -> bool:
    collections = qdrant.get_collections().collections
    return any(item.name == COLLECTION_NAME for item in collections)


def ensure_collection(vector_size: int) -> None:
    if not collection_exists():
        qdrant.create_collection(
            collection_name=COLLECTION_NAME,
            vectors_config=VectorParams(
                size=vector_size,
                distance=Distance.COSINE,
            ),
        )
        return

    info = qdrant.get_collection(COLLECTION_NAME)
    current_size = info.config.params.vectors.size

    if current_size != vector_size:
        raise HTTPException(
            status_code=409,
            detail=(
                f"向量维度不一致:现有集合为 {current_size},"
                f"当前嵌入模型返回 {vector_size}。"
                "请保持嵌入模型不变,或先备份后使用 reset=true 重建。"
            ),
        )


def split_text(text: str, chunk_size: int = 1200, overlap: int = 150) -> list[str]:
    text = text.strip()
    if not text:
        return []

    step = chunk_size - overlap
    return [
        text[start:start + chunk_size].strip()
        for start in range(0, len(text), step)
        if text[start:start + chunk_size].strip()
    ]


def load_documents() -> list[dict]:
    documents = []

    for path in sorted(DATA_DIR.rglob("*")):
        if not path.is_file() or path.suffix.lower() not in {".md", ".txt"}:
            continue

        text = path.read_text(encoding="utf-8", errors="ignore")
        chunks = split_text(text)
        relative_path = str(path.relative_to(DATA_DIR))

        for index, chunk in enumerate(chunks):
            documents.append(
                {
                    "source": relative_path,
                    "chunk": index,
                    "text": chunk,
                }
            )

    return documents


@app.get("/healthz")
def healthz():
    try:
        qdrant.get_collections()
        return {"status": "ok", "qdrant": "ok"}
    except Exception:
        raise HTTPException(status_code=503, detail="Qdrant 不可用")


@app.post("/admin/reindex")
async def reindex(
    request: ReindexRequest,
    _: bool = Depends(require_api_key),
):
    documents = load_documents()

    if not documents:
        raise HTTPException(
            status_code=400,
            detail="没有找到 .md 或 .txt 文档",
        )

    texts = [item["text"] for item in documents]
    vectors = await embed_texts(texts)

    if len(vectors) != len(documents):
        raise HTTPException(status_code=502, detail="向量数量与文档片段数量不一致")

    vector_size = len(vectors[0])

    # 只有在嵌入请求成功后才执行 reset,避免模型接口失败时先清空原集合。
    if request.reset and collection_exists():
        qdrant.delete_collection(COLLECTION_NAME)

    ensure_collection(vector_size)

    points = []
    for item, vector in zip(documents, vectors):
        point_key = f"{item['source']}:{item['chunk']}"
        point_id = str(uuid.uuid5(uuid.NAMESPACE_URL, point_key))

        points.append(
            PointStruct(
                id=point_id,
                vector=vector,
                payload=item,
            )
        )

    qdrant.upsert(
        collection_name=COLLECTION_NAME,
        points=points,
        wait=True,
    )

    return {
        "status": "ok",
        "documents": len({item["source"] for item in documents}),
        "chunks": len(documents),
        "vector_size": vector_size,
        "reset": request.reset,
    }


@app.post("/chat")
async def chat(
    request: ChatRequest,
    _: bool = Depends(require_api_key),
):
    if not collection_exists():
        raise HTTPException(
            status_code=503,
            detail="知识库尚未建立,请先执行 /admin/reindex",
        )

    query_vector = (await embed_texts([request.query]))[0]

    hits = qdrant.search(
        collection_name=COLLECTION_NAME,
        query_vector=query_vector,
        limit=request.top_k,
        with_payload=True,
    )

    context_parts = []
    sources = []

    for hit in hits:
        payload = hit.payload or {}
        source = payload.get("source", "unknown")
        chunk = payload.get("chunk", -1)
        text = payload.get("text", "")

        context_parts.append(
            f"【{source},片段 {chunk}】\n{text}"
        )
        sources.append(
            {
                "source": source,
                "chunk": chunk,
                "score": round(float(hit.score), 4),
            }
        )

    context = "\n\n".join(context_parts)

    if not context:
        context = "没有检索到可用的知识库片段。"

    system_prompt = (
        "你是一个知识库问答助手。只能依据给出的知识库片段回答问题。"
        "如果片段中没有足够依据,请明确说知识库中没有相关信息,"
        "不要编造产品参数、时间、价格或政策。回答尽量简洁,并保留必要的条件。"
    )

    user_prompt = (
        f"知识库片段:\n{context}\n\n"
        f"用户问题:{request.query}"
    )

    result = await model_post(
        "/chat/completions",
        {
            "model": CHAT_MODEL,
            "temperature": 0.2,
            "messages": [
                {"role": "system", "content": system_prompt},
                {"role": "user", "content": user_prompt},
            ],
        },
    )

    try:
        answer = result["choices"][0]["message"]["content"]
    except (KeyError, IndexError, TypeError) as exc:
        raise HTTPException(
            status_code=502,
            detail="聊天接口返回格式不符合预期",
        ) from exc

    return {
        "answer": answer,
        "sources": sources,
    }
这个应用刻意保持简单:
/healthz 用于检查应用和 Qdrant 是否连通。/admin/reindex 扫描 /data 下的 Markdown、TXT 文件并建立向量。/chat 接收问题,检索相似片段,再调用聊天模型生成答案。X-API-Key 认证。创建 /opt/ai-kb/compose.yaml:
services:
  qdrant:
    image: qdrant/qdrant:v1.13.2
    restart: unless-stopped
    ports:
      - "127.0.0.1:6333:6333"
    volumes:
      - qdrant_storage:/qdrant/storage

  app:
    build:
      context: ./app
    restart: unless-stopped
    env_file:
      - .env
    depends_on:
      - qdrant
    ports:
      - "127.0.0.1:8000:8000"
    volumes:
      - .//ro

volumes:
  qdrant_storage:
    name: ai_kb_qdrant_storage
这里的两个端口都绑定到 127.0.0.1:
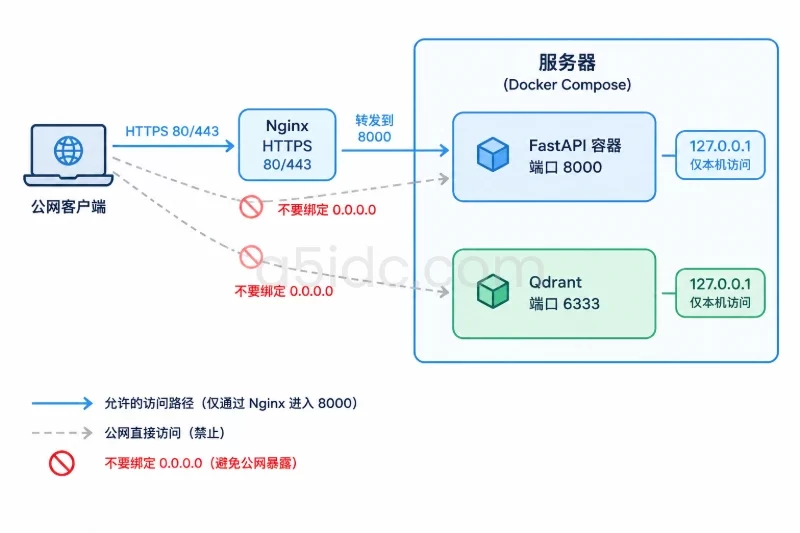
8000 只允许本机访问,公网请求必须经过 Nginx。6333 只允许本机和 Docker 内部访问,不允许外部直接访问 Qdrant。不要把它们改成 0.0.0.0:8000:8000 或 0.0.0.0:6333:6333,否则应用接口和向量数据库都可能直接暴露在公网。
创建 /opt/ai-kb/data/faq.md:
# 知识库服务说明

本服务通过 HTTPS 提供问答接口。

## 访问方式

客户端需要在请求头中提供 X-API-Key。
聊天接口路径为 /chat。
健康检查路径为 /healthz。

## 文档更新

将 Markdown 或 TXT 文件放入 data 目录后,需要调用管理员重建接口。
文档会被切分为多个片段,生成向量后保存到 Qdrant。

## 回答边界

如果知识库没有相关内容,助手应明确说明没有找到依据,不应自行补充未提供的信息。
实际使用时,可以把产品文档、内部手册、常见问题和服务说明放入 data 目录。首次部署建议先使用少量文本验证链路,确认成功后再导入完整文档。
在项目目录执行:
cd /opt/ai-kb
sudo docker compose config >/dev/null
如果没有输出,说明 Compose 文件的基本结构可以解析。若提示环境变量缺失,应检查 .env 文件是否位于 /opt/ai-kb/.env,以及变量名是否拼写一致。
构建并启动:
sudo docker compose up -d --build
查看容器状态:
sudo docker compose ps
正常情况下应看到 qdrant 和 app 两个服务处于运行状态。查看最近日志:
sudo docker compose logs --tail=100 app qdrant
日志中不应出现模型接口密钥。若应用启动即退出,通常是 .env 中缺少模型地址、密钥或模型名称。
在服务器本机执行:
curl -sS http://127.0.0.1:8000/healthz
预期返回类似:
{"status":"ok","qdrant":"ok"}
如果返回 503,说明 FastAPI 进程在运行,但无法连接 Qdrant。此时查看:
sudo docker compose logs --tail=100 qdrant
sudo docker compose ps
再确认本机端口绑定情况:
sudo ss -lntp | grep -E ':(6333|8000)\b'
预期是 127.0.0.1:6333 和 127.0.0.1:8000,而不是公网地址。
先把 .env 中的变量加载到当前 Shell。该命令不会把密钥直接写入 Shell 历史:
cd /opt/ai-kb
set -a
. ./.env
set +a
调用重建接口:
curl -sS -X POST \
  http://127.0.0.1:8000/admin/reindex \
  -H "Content-Type: application/json" \
  -H "X-API-Key: ${APP_API_KEY}" \
  -d '{"reset":false}'
正常返回示例:
{
  "status": "ok",
  "documents": 1,
  "chunks": 1,
  "vector_size": 1536,
  "reset": false
}
vector_size 是嵌入模型返回的向量长度。它不是固定值,取决于实际嵌入模型。后续只要继续使用同一个嵌入模型,向量维度就应保持一致。
如果向 data 目录添加了新文件,再次执行相同命令即可。程序会使用“文件相对路径 + 片段编号”生成固定 ID,同一片段会被更新,而不是无限重复插入。
当前示例不会自动删除已经从磁盘移除的旧片段。因此,如果删除了某份文件并且希望向量库完全同步,需要先备份,再使用 reset=true 重建:
curl -sS -X POST \
  http://127.0.0.1:8000/admin/reindex \
  -H "Content-Type: application/json" \
  -H "X-API-Key: ${APP_API_KEY}" \
  -d '{"reset":true}'
reset=true 会删除当前集合中的所有向量,再根据 /data 目录重新建立索引。它不会删除服务器上的原始文档,但会影响当前知识库的可检索内容,必须在备份或确认可重建的前提下使用。
执行:
curl -sS -X POST \
  http://127.0.0.1:8000/chat \
  -H "Content-Type: application/json" \
  -H "X-API-Key: ${APP_API_KEY}" \
  -d '{"query":"知识库服务使用什么方式访问?","top_k":4}'
预期响应结构类似:
{
  "answer": "知识库服务通过 HTTPS 提供问答接口,客户端需要在请求头中提供 X-API-Key。",
  "sources": [
    {
      "source": "faq.md",
      "chunk": 0,
      "score": 0.8123
    }
  ]
}
验证时主要看三点:
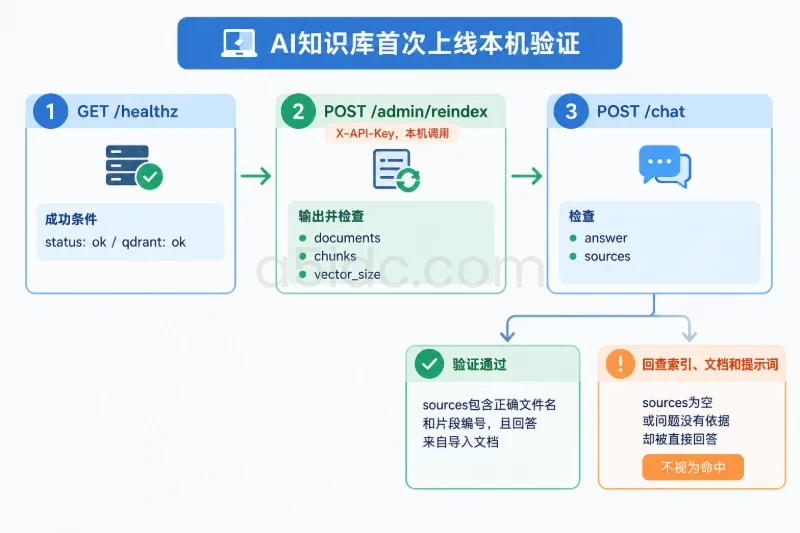
answer 是否来自刚才导入的文档。sources 是否包含正确的文件名和片段编号。如果返回答案但 sources 为空,说明检索结果为空或向量库中没有有效片段,不能把这类结果当作知识库命中。
本机验证通过后,再把服务发布到域名。不要直接把 8000 或 6333 暴露给公网。
在域名服务商处添加 A 记录:
主机记录:kb
记录类型:A
记录值:服务器公网 IPv4 地址
等待 DNS 生效后,在服务器或本地检查:
getent hosts kb.example.com
将 kb.example.com 替换成实际域名。如果服务器只有 IPv4,暂时不要配置指向错误地址的 AAAA 记录,否则部分客户端可能优先访问不可用的 IPv6。
sudo apt-get update
sudo apt-get install -y nginx
sudo systemctl enable --now nginx
创建站点配置:
sudo tee /etc/nginx/sites-available/ai-kb >/dev/null <<'EOF'
server {
    listen 80;
    listen [::]:80;

    server_name kb.example.com;

    client_max_body_size 2m;

    location = /admin/reindex {
        allow 127.0.0.1;
        deny all;

        proxy_pass http://127.0.0.1:8000;
        proxy_http_version 1.1;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_read_timeout 120s;
    }

    location / {
        proxy_pass http://127.0.0.1:8000;
        proxy_http_version 1.1;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_read_timeout 120s;
    }
}
EOF
启用站点并检查配置:
sudo ln -sf /etc/nginx/sites-available/ai-kb /etc/nginx/sites-enabled/ai-kb
sudo nginx -t
sudo systemctl reload nginx
/admin/reindex 被限制为本机访问,因此后续重建知识库时仍然使用:
curl -sS -X POST \
  http://127.0.0.1:8000/admin/reindex \
  -H "Content-Type: application/json" \
  -H "X-API-Key: ${APP_API_KEY}" \
  -d '{"reset":false}'
即使管理接口带有 API 密钥,也不建议把文档重建操作直接开放给任意公网客户端。
先确认云厂商安全组只放行必要端口:
如果使用 UFW,先查看当前状态和 SSH 端口:
sudo ufw status verbose
sudo ss -lntp
确认 SSH 端口和当前管理来源后,再添加规则。下面以 SSH 端口 22 为例:
sudo ufw allow from 管理员公网IP to any port 22 proto tcp
sudo ufw allow 80/tcp
sudo ufw allow 443/tcp
sudo ufw status numbered
确认 22 端口规则没有问题后再启用:
sudo ufw enable
启用防火墙可能导致 SSH 被锁在服务器外,尤其是 SSH 使用了非 22 端口、管理员 IP 会变化、或者云厂商安全组尚未放行时。执行前应保留云厂商控制台或带外终端作为恢复入口。回滚规则时,先执行:
sudo ufw status numbered
根据实际编号删除错误规则:
sudo ufw delete 规则编号
不要在没有控制台恢复能力的情况下直接执行 ufw reset。
先备份 Nginx 配置:
sudo cp -a /etc/nginx "/etc/nginx.backup.$(date +%Y%m%d-%H%M%S)"
安装证书工具:
sudo apt-get install -y certbot python3-certbot-nginx
确认域名已经解析到本机,并且 80 端口可以从公网访问后执行:
sudo certbot --nginx -d kb.example.com
按照提示选择 HTTP 自动跳转 HTTPS。证书签发工具会修改 Nginx 配置,完成后检查:
sudo nginx -t
sudo systemctl reload nginx
sudo certbot renew --dry-run
如果证书修改后出现问题,先查看:
sudo nginx -t
sudo journalctl -u nginx --no-pager -n 100
不要直接删除整个 /etc/nginx 目录。应根据前面的备份恢复具体配置文件,恢复后再次执行 nginx -t,确认语法正确再 reload。
先验证 HTTPS 健康检查:
curl -sS https://kb.example.com/healthz
再从公网调用聊天接口:
curl -sS -X POST \
  https://kb.example.com/chat \
  -H "Content-Type: application/json" \
  -H "X-API-Key: ${APP_API_KEY}" \
  -d '{"query":"知识库服务使用什么方式访问?","top_k":4}'
如果 HTTPS 正常但聊天请求返回 401,通常是请求头没有传递或密钥不一致。如果返回 502,则需要区分是 Nginx 无法连接应用,还是应用无法连接模型接口。
先查看状态和日志:
sudo docker compose ps
sudo docker compose logs --tail=150 app
常见原因包括:
.env 文件没有放在 Compose 文件同一目录。MODEL_BASE_URL、MODEL_API_KEY、CHAT_MODEL 或 EMBEDDING_MODEL 为空。检查端口:
sudo ss -lntp | grep -E ':(6333|8000)\b'
如果端口被其他业务占用,不要直接停止未知服务。可以先修改本项目的本机端口映射,但应用容器内部端口仍保持 8000,修改后还要同步更新 Nginx 的 proxy_pass。
错误码含义通常如下:
| 返回现象 | 优先检查 |
|---|---|
| 401/403 | MODEL_API_KEY 是否有效,认证头格式是否正确 |
| 404 | MODEL_BASE_URL 是否已经包含正确版本路径 |
| 400 | 模型名称、输入字段或接口能力是否匹配 |
| 429 | 服务商限流、并发限制或账户额度 |
| 5xx | 模型服务暂时异常或请求参数触发服务端错误 |
| 连接超时 | 服务器到模型接口的出站网络、DNS 或接口响应时间 |
可以从应用日志查看错误摘要:
sudo docker compose logs --tail=100 app
不要为了排查问题把完整 API 密钥打印到日志或命令输出中。若怀疑密钥已经泄露,应在模型服务商控制台立即轮换,并同步修改 .env。
如果返回类似:
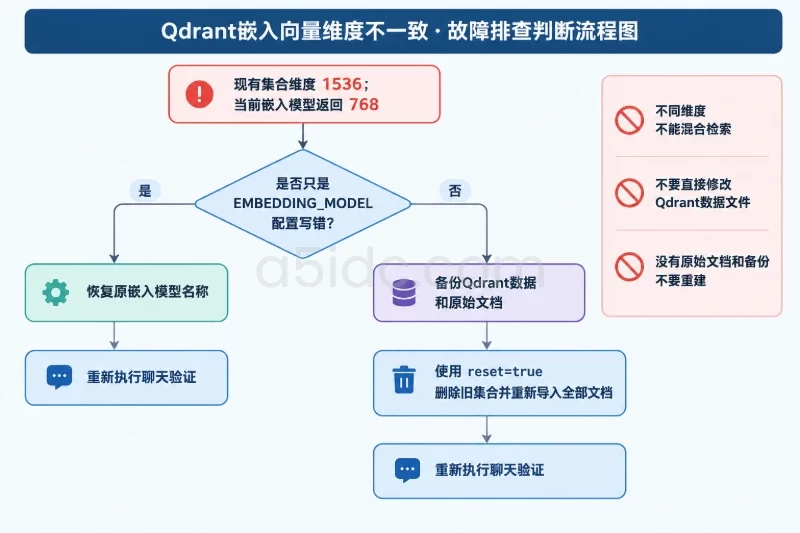
向量维度不一致:现有集合为 1536,当前嵌入模型返回 768
说明当前 Qdrant 集合是用旧嵌入模型建立的,而新的模型生成了不同长度的向量。不同维度不能混合检索。
安全处理顺序是:
EMBEDDING_MODEL。reset=true 删除旧集合并重新导入全部文档。不要直接修改 Qdrant 数据文件中的维度,也不要在没有原始文档和备份的情况下执行重建。
这通常表示还没有成功执行索引。检查数据目录:
find /opt/ai-kb/data -maxdepth 3 -type f \( -name '*.md' -o -name '*.txt' \) -print
如果没有输出,说明文件不在正确目录,或者扩展名不符合程序筛选条件。文件挂载为只读,应用只读取内容,不会修改原始文档。
如果已经有文件,重新执行:
curl -sS -X POST \
  http://127.0.0.1:8000/admin/reindex \
  -H "Content-Type: application/json" \
  -H "X-API-Key: ${APP_API_KEY}" \
  -d '{"reset":false}'
先查看返回的 sources:
sources 为空:检索没有找到片段,应检查索引是否成功、问题与文档是否相关。sources 正确但回答超出文档:可进一步收紧系统提示词,降低 temperature,或减少 top_k。sources 指向旧文件:之前只做了增量 upsert,删除文件后旧片段仍存在,需要备份后使用 reset=true。split_text 的 chunk_size,但修改后应重新建立索引并验证接口成本与上下文长度。不要把检索分数当成“答案正确率”。分数只是向量相似度指标,最终回答仍取决于文档质量、切块方式和模型生成结果。
检查应用是否监听本机 8000:
sudo ss -lntp | grep ':8000'
sudo docker compose ps
sudo docker compose logs --tail=100 app
如果应用正常,再检查 Nginx:
sudo nginx -t
sudo journalctl -u nginx --no-pager -n 100
聊天请求可能需要等待模型接口响应,配置中的 proxy_read_timeout 120s 只是等待上限,不代表模型一定会在这个时间内返回。若模型接口本身超时,应先确认出站网络和服务商状态,不要只增加 Nginx 超时时间。
先确认没有执行过带 -v 的停止命令:
sudo docker volume inspect ai_kb_qdrant_storage
正常情况下,普通的:
sudo docker compose down
不会删除命名卷,重新执行 up -d 后数据仍应存在。
不要在日常维护中执行:
sudo docker compose down -v
该命令会删除 Compose 关联的卷,可能造成 Qdrant 数据丢失。若确实需要删除整个知识库,应先导出原始文档、完成数据备份,并确认具备重建条件。
在修改应用代码、模型配置或批量替换文档前,先备份:
cd /opt/ai-kb
tar czf "backup/project-$(date +%Y%m%d-%H%M%S).tar.gz" \
  --exclude='./backup' \
  .env compose.yaml app data
该备份包含 .env,属于敏感文件,应继续保持目录权限受控:
chmod 700 /opt/ai-kb/backup
为了得到一致的数据副本,先停止应用和 Qdrant。该操作会短暂中断聊天服务,但不会删除数据:
cd /opt/ai-kb
sudo docker compose stop app qdrant
执行卷备份:
BACKUP_DIR="$(pwd)/backup"
STAMP="$(date +%Y%m%d-%H%M%S)"

sudo docker run --rm \
  -v ai_kb_qdrant_storage:/data \
  -v "$BACKUP_DIR:/backup" \
  alpine:3.20 \
  sh -c "tar czf /backup/qdrant-$STAMP.tar.gz -C /data ."
备份完成后恢复服务:
sudo docker compose up -d
确认健康检查:
curl -sS http://127.0.0.1:8000/healthz
如果只是代码或配置更新后出现问题,可以恢复项目文件,再重新构建应用:
cd /opt/ai-kb
sudo docker compose down
sudo docker compose up -d --build
普通 down 不会删除命名卷,因此 Qdrant 数据仍然保留。回滚 .env 后,应用会在重新创建容器时读取旧配置。
如果是 API 密钥轮换,修改 .env 后执行:
sudo chmod 600 /opt/ai-kb/.env
sudo docker compose up -d
应用访问密钥和模型服务密钥都会立即以新配置生效,旧密钥不再有效。执行前要同步更新所有客户端,否则客户端会收到 401。
只有在确认当前向量库损坏、误执行 reset=true 或导入了错误数据时,才恢复 Qdrant 数据卷。该操作会覆盖当前向量库,影响全部问答请求,必须先把当前数据再次备份。
停止服务:
cd /opt/ai-kb
sudo docker compose stop app qdrant
确认备份文件存在:
ls -lh /opt/ai-kb/backup/qdrant-*.tar.gz
使用指定备份文件恢复。下面的 qdrant-YYYYMMDD-HHMMSS.tar.gz 必须替换为真实文件名:
BACKUP_DIR="/opt/ai-kb/backup"
BACKUP_FILE="qdrant-YYYYMMDD-HHMMSS.tar.gz"

sudo docker run --rm \
  -v ai_kb_qdrant_storage:/data \
  -v "$BACKUP_DIR:/backup" \
  alpine:3.20 \
  sh -c "find /data -mindepth 1 -maxdepth 1 -exec rm -rf -- {} + && tar xzf /backup/$BACKUP_FILE -C /data"
find ... rm -rf 会删除当前 Qdrant 卷中的全部内容,影响范围是整个 kb_documents 数据目录。执行前必须确认:
/opt/ai-kb/data 或其他备份中。恢复后启动:
sudo docker compose up -d
curl -sS http://127.0.0.1:8000/healthz
如果备份来自同一套 Qdrant 配置,通常可以直接读取。如果应用代码、Qdrant 版本或集合结构发生过较大变化,优先使用原始文档重新索引,避免直接恢复不兼容的数据文件。
上线前可以按下面的顺序逐项确认:
docker compose version 可正常返回。/opt/ai-kb 有独立目录。127.0.0.1,没有对公网监听。MODEL_BASE_URL 指向正确的兼容接口地址。.env 权限为 600,没有提交到公开代码仓库。/healthz 返回 status: ok。/admin/reindex 能返回文档数量、片段数量和向量维度。/chat 返回答案和来源片段。nginx -t。/admin/reindex 只能从服务器本机访问。X-API-Key 认证。docker compose logs --tail=100 app,避免密钥、错误堆栈或异常请求持续累积。certbot renew --dry-run。docker compose down -v 作为普通重启命令。完成以上检查后,这套方案已经具备一个可访问、可检索、可回滚的最小 AI 知识库后端。后续增加网页聊天界面、用户级权限、文件上传、会话记录或多知识库隔离时,可以继续复用当前的模型接口、Qdrant 和 Nginx 基础结构。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/2938.html