香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


目标状态是:慢查询能够被稳定捕获并按指纹归类,索引和执行计划有明确证据,InnoDB 内存与日志参数符合服务器内存和写入量,磁盘 I/O 不处于持续排队状态;调整后,应用侧的 p95/p99 查询延迟、超时率和错误率均不劣于调整前。香港服务器还要特别关注应用与数据库之间的网络往返次数,不能把远程连接延迟误判成 MySQL 磁盘性能问题。
实施顺序建议固定为“先采集基线,再处理慢查询和索引,之后调整 InnoDB,最后核对存储 I/O 与连接数”。不要一开始就增大 max_connections、关闭事务持久化或盲目把 innodb_buffer_pool_size 调到物理内存的绝大部分。每次只改一组相关参数,保留旧值、备份配置和可恢复的数据副本,才能判断收益与回退范围。
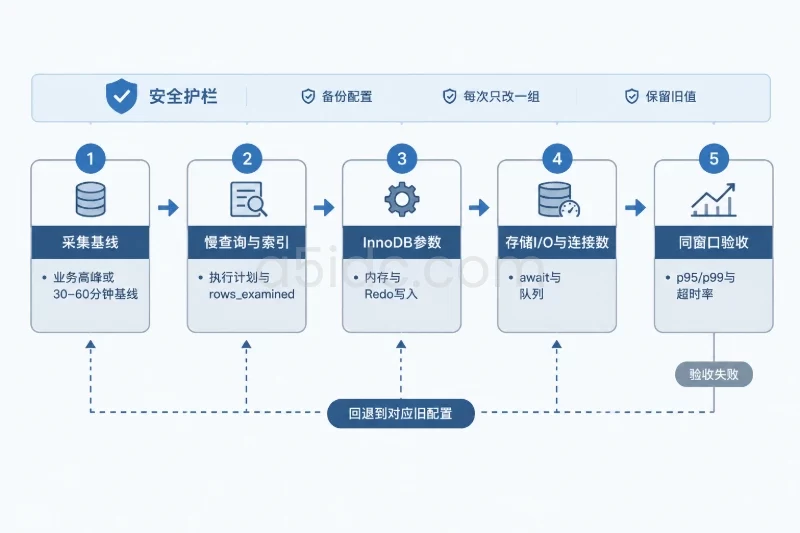
以下步骤以 Linux + MySQL 8.0 + systemd 为主要环境,命令示例优先兼容 Ubuntu/Debian。RHEL、Rocky Linux 等发行版的服务名通常也是 mysqld,配置目录可能不同,修改前必须先核验。
本文涉及的变更风险如下:
| 变更对象 | 主要影响 | 变更前要求 | 常用回滚方式 |
|---|---|---|---|
| 慢查询日志 | 增加磁盘写入和日志占用 | 确认日志目录剩余空间,设置采集时长 | 关闭日志并轮转、删除过期日志 |
索引和 ALTER TABLE | 占用 CPU、I/O、空间,可能等待元数据锁 | 完成备份或快照,避开高峰 | 删除新增索引,或恢复备份 |
innodb_buffer_pool_size | 影响内存占用和缓存命中 | 核对物理内存、连接数和其他进程 | 恢复旧值,必要时重启 |
| Redo 日志容量 | 影响写入波动和崩溃恢复时间 | 计算写入量,不手工删除日志文件 | 恢复配置并按版本要求重启 |
| I/O 参数 | 影响刷脏页速度和磁盘延迟 | 先记录 iostat,使用稳定 I/O 指标 | 恢复原参数 |
max_connections、会话缓冲 | 可能直接触发内存不足 | 先统计峰值连接和应用连接池 | 恢复旧值并限制连接池 |
如果数据库承载核心交易,至少应有一份近期可恢复备份,或者经过验证的云盘、虚拟机快照。仅仅复制 ibdata1、Redo 文件或直接打包正在运行的数据目录,不能替代一致性备份。
先确认 MySQL 实例、数据目录、配置来源和存储设备,不要直接套用网上常见路径。
mysql -uroot -p -e "
SELECT
  VERSION() AS mysql_version,
  @@version_comment AS version_comment,
  @@datadir AS datadir,
  @@port AS port,
  @@log_bin AS log_bin,
  @@max_connections AS max_connections;
"

systemctl list-units --type=service | grep -Ei 'mysql|mysqld'
常见配置路径如下,但实际以系统中的 mysqld 配置为准:
/etc/mysql/mysql.conf.d/mysqld.cnf/etc/my.cnf 或 /etc/my.cnf.d/mysqld.cnf查看当前加载的主要参数:
mysql -uroot -p -e "
SHOW VARIABLES WHERE Variable_name IN (
  'slow_query_log',
  'slow_query_log_file',
  'long_query_time',
  'innodb_buffer_pool_size',
  'innodb_flush_log_at_trx_commit',
  'innodb_io_capacity',
  'innodb_io_capacity_max',
  'innodb_flush_method',
  'max_connections',
  'table_open_cache'
);
"

my_print_defaults mysqld 2>/dev/null || true
如果 my_print_defaults 输出与预期不一致,应继续检查 !includedir 和 !include 指向的文件。多份配置同时设置同一参数时,后加载的值可能覆盖前面的值。
先记录调整前的资源与数据库状态,至少覆盖一个业务高峰或连续 30~60 分钟。状态变量是累计值,后续要使用两个时间点的差值,而不是直接把累计数当作当前速率。
sudo mkdir -p /var/backups/mysql-tuning
sudo cp -a /etc/mysql/mysql.conf.d/mysqld.cnf \
  /var/backups/mysql-tuning/mysqld.cnf.$(date +%F-%H%M%S) 2>/dev/null || true

sudo cp -a /etc/my.cnf \
  /var/backups/mysql-tuning/my.cnf.$(date +%F-%H%M%S) 2>/dev/null || true
保存关键变量和状态:
mysql -uroot -p -NBe "
SHOW GLOBAL VARIABLES WHERE Variable_name IN (
  'innodb_buffer_pool_size',
  'innodb_flush_log_at_trx_commit',
  'innodb_io_capacity',
  'innodb_io_capacity_max',
  'innodb_flush_method',
  'max_connections',
  'slow_query_log',
  'long_query_time'
);
SHOW GLOBAL STATUS WHERE Variable_name IN (
  'Threads_connected',
  'Threads_running',
  'Max_used_connections',
  'Connections',
  'Aborted_connects',
  'Innodb_buffer_pool_read_requests',
  'Innodb_buffer_pool_reads',
  'Innodb_os_log_written',
  'Innodb_row_lock_time',
  'Innodb_row_lock_waits'
);
" | tee /var/backups/mysql-tuning/status-before.txt
如果当前没有可用备份,应先执行现有备份流程。以全 InnoDB 数据库为例,可以使用一致性逻辑备份,但大型实例可能产生较大文件和较长读取压力:
mysqldump -uroot -p \
  --single-transaction \
  --routines \
  --events \
  --all-databases \
  > /var/backups/mysql-tuning/all-databases-$(date +%F-%H%M%S).sql
执行前确认备份目录容量和权限;如果实例较大,优先使用已经验证过的物理备份或存储快照,不要在业务高峰临时创建未经测试的备份方案。
慢查询分析的目标不是记录所有 SQL,而是找出对用户延迟、CPU、磁盘读取或锁等待贡献较大的 SQL。阈值应结合业务要求设置。在线交易通常可以先从 0.5 秒或 1 秒开始;后台报表、批处理和管理 SQL 应单独判断,不能把所有任务统一按一个阈值评价。
先查看日志文件和当前值:
mysql -uroot -p -e "
SHOW VARIABLES LIKE 'slow_query_log%';
SHOW VARIABLES LIKE 'long_query_time';
SHOW VARIABLES LIKE 'min_examined_row_limit';
SHOW VARIABLES LIKE 'log_queries_not_using_indexes';
"
在 MySQL 8.0 中,可以先临时启用:
SET GLOBAL slow_query_log = ON;
SET GLOBAL long_query_time = 0.5;
SET GLOBAL min_examined_row_limit = 1000;
SET GLOBAL log_queries_not_using_indexes = OFF;
log_queries_not_using_indexes 不建议在生产环境长期打开。它会把很多低选择性、但并不一定慢的查询写入日志,容易造成日志膨胀和误判。只有在确认需要排查未使用索引的查询时,才可以在短时间窗口内启用。
如果需要用配置文件长期保留,先确认日志目录存在且 MySQL 用户可写,再添加或修改 [mysqld] 段:
[mysqld]
slow_query_log=ON
slow_query_log_file=/var/log/mysql/mysql-slow.log
long_query_time=0.5
min_examined_row_limit=1000
log_queries_not_using_indexes=OFF
配置文件中的日志路径必须以实际目录为准。若目录剩余空间不足,先不要启用长时间慢日志。
采集 10~30 分钟后,先用 mysqldumpslow 按总耗时和平均耗时观察:
sudo mysqldumpslow -s t -t 20 /var/log/mysql/mysql-slow.log
sudo mysqldumpslow -s at -t 20 /var/log/mysql/mysql-slow.log
如果慢日志路径不同,使用 SHOW VARIABLES LIKE 'slow_query_log_file' 的结果替换示例路径。常见排序方式包括:
-s t:按总执行时间排序,适合找整体消耗最大的 SQL;-s at:按平均执行时间排序,适合找单次延迟明显的 SQL;-t 20:只显示前 20 条,避免输出过多。也可以直接从 Performance Schema 的语句摘要中观察归一化 SQL。以下查询使用的是累计数据,适合在两个时间点分别执行后比较变化:
SELECT
  DIGEST_TEXT,
  COUNT_STAR AS exec_count,
  ROUND(SUM_TIMER_WAIT / 1000000000000, 2) AS total_seconds,
  ROUND(AVG_TIMER_WAIT / 1000000, 2) AS avg_ms,
  ROUND(MAX_TIMER_WAIT / 1000000, 2) AS max_ms,
  SUM_ROWS_EXAMINED AS rows_examined,
  SUM_ROWS_SENT AS rows_sent
FROM performance_schema.events_statements_summary_by_digest
WHERE DIGEST_TEXT IS NOT NULL
ORDER BY SUM_TIMER_WAIT DESC
LIMIT 20;
判断重点应同时看执行次数、平均耗时、总耗时、扫描行数和返回行数:
| 观察结果 | 常见含义 | 优先动作 |
|---|---|---|
| 平均耗时高,执行次数少 | 单次查询计划、锁等待或大范围扫描有问题 | 检查执行计划、锁和过滤条件 |
| 平均耗时中等,执行次数极高 | 连接池或应用重复查询放大了开销 | 合并查询、增加合适索引、检查缓存 |
rows_examined 远高于 rows_sent | 过滤效率低、索引不匹配或选择性差 | 检查联合索引和谓词 |
| 总耗时高但单次很快 | 频繁轮询或重复读取 | 检查调用频率、批量处理和缓存 |
| SQL 耗时正常但接口很慢 | 网络往返、应用排队或锁等待可能在数据库外 | 对比应用计时、连接获取时间和 SQL 执行时间 |
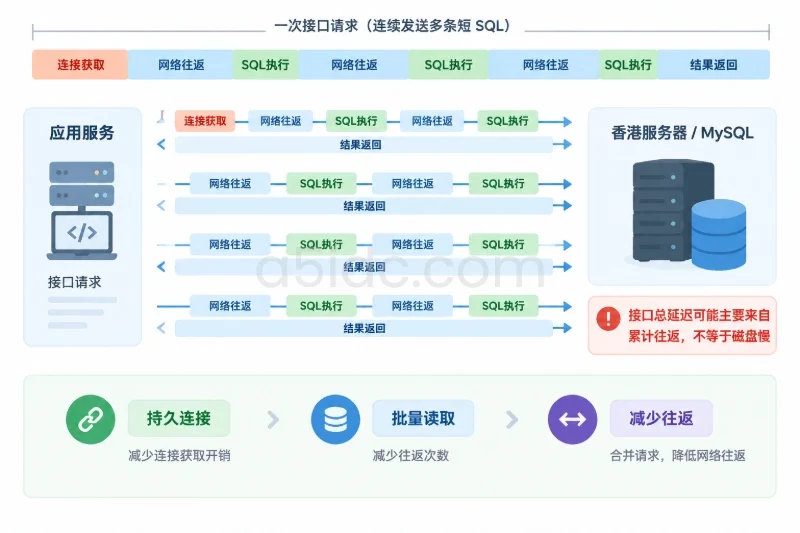
香港服务器上的应用如果与数据库不在同一网络区域,一次接口请求中执行多次短 SQL,累计往返时间可能超过 SQL 本身的执行时间。此时不应单纯增大数据库线程数,应优先减少往返次数、使用持久连接、批量读取,并将高频应用与数据库放在网络距离更近的位置。
对慢日志中的 SQL 进行参数脱敏后,使用真实数据分布接近的参数执行 EXPLAIN。不要只用极少量数据或高度特殊的参数判断全局计划。
EXPLAIN FORMAT=JSON
SELECT
  id, user_id, status, created_at
FROM orders
WHERE user_id = 10001
  AND status = 'paid'
ORDER BY created_at DESC
LIMIT 50;
MySQL 8.0.18 及更高版本可以对只读 SELECT 使用 EXPLAIN ANALYZE,它会实际执行查询,因此不要直接用于可能修改数据的语句,也不要在高峰期对超大范围查询随意执行:
EXPLAIN ANALYZE
SELECT
  id, user_id, status, created_at
FROM orders
WHERE user_id = 10001
  AND status = 'paid'
ORDER BY created_at DESC
LIMIT 50;
重点核对以下字段:
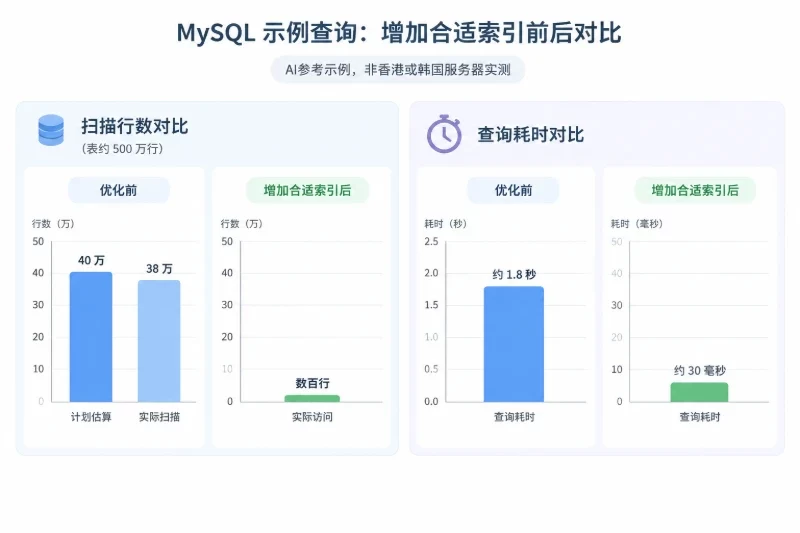
type:ALL 通常代表全表扫描,但小表全表扫描并不一定是问题;key:实际使用的索引,不能只看 possible_keys;rows:优化器估算扫描行数;filtered:过滤比例;Extra:关注 Using filesort、Using temporary,但它们是否需要处理要结合数据量和延迟判断;EXPLAIN ANALYZE 中的实际行数与估算行数:偏差很大时,统计信息可能已经不准确,或者参数分布存在明显倾斜。对于上面的查询,一个可能的联合索引是:
ALTER TABLE orders
  ADD INDEX idx_orders_user_status_created (user_id, status, created_at DESC),
  ALGORITHM=INPLACE,
  LOCK=NONE;
这个示例只适用于表结构、数据分布和访问模式确实符合的情况。联合索引通常应优先覆盖高频等值过滤列,再考虑范围过滤、排序或分组列,但最终顺序必须由执行计划和实际选择性验证。不要把所有 WHERE 字段机械地拼在一起。
加索引前需要核对:
SHOW INDEX FROM orders;
SHOW CREATE TABLE orders\G
如果表很大,在线 DDL 仍可能消耗大量 CPU、I/O 和空间,也可能等待长事务持有的元数据锁。LOCK=NONE 不代表完全没有业务影响;当操作不支持该算法或锁级别时,命令可能失败,也可能需要更换维护窗口。
执行完成后重新分析计划:
ANALYZE TABLE orders;
EXPLAIN FORMAT=JSON
SELECT
  id, user_id, status, created_at
FROM orders
WHERE user_id = 10001
  AND status = 'paid'
ORDER BY created_at DESC
LIMIT 50;
ANALYZE TABLE 会更新统计信息,通常应在低峰执行。若执行计划在更新统计信息后反而变差,先记录新旧计划,不要立刻反复执行 ANALYZE TABLE。需要进一步检查数据倾斜、直方图和参数分布。
每增加一个二级索引,插入、更新和删除都需要维护额外的索引页。以下情况不适合仅因为一次慢查询就建索引:
索引变更后的验收应同时查看查询延迟、rows_examined、写入延迟、Redo 写入量和磁盘等待。只看到 EXPLAIN 使用了新索引,还不足以证明整体性能变好。
innodb_buffer_pool_size 不能简单设置为物理内存的 80% 或 90%。数据库进程还需要连接线程、排序和临时缓冲、表定义缓存、Performance Schema、复制线程、操作系统页缓存以及其他服务空间。
专用数据库服务器可以从物理内存的约 60%~75% 作为起点;与应用、Web 服务或监控组件共用的香港服务器,应为系统和应用预留更多空间。下面是一个 16 GiB 物理内存、同时运行少量应用服务的示例预算,不是固定配置:
| 内存项目 | 示例预算 | 说明 |
|---|---|---|
| InnoDB Buffer Pool | 9~10 GiB | 主要数据页和索引页缓存 |
| MySQL 会话及临时内存 | 2~3 GiB | 与并发连接、排序、临时表有关 |
| MySQL 固定开销 | 1~1.5 GiB | Performance Schema、字典和后台线程 |
| 操作系统及应用 | 2~3 GiB | 系统、监控、Web 服务和安全组件 |
| 预留余量 | 至少 1 GiB | 应对峰值和维护操作 |
实际值应依据 free -h、进程内存、峰值连接数和 OOM 记录调整:
free -h
ps -o pid,ppid,%mem,rss,vsz,cmd -C mysqld -C mariadbd
dmesg -T | grep -Ei 'out of memory|oom|killed process' | tail -20
sort_buffer_size、join_buffer_size、read_buffer_size 等参数可能按连接或操作分配。盲目把这些值调大,配合高 max_connections,很容易在并发上升时耗尽内存。
查看缓存相关状态:
SHOW GLOBAL STATUS LIKE 'Innodb_buffer_pool%';
常用的近似缓存命中率计算方式是:
命中率 ≈ 1 - Innodb_buffer_pool_reads / Innodb_buffer_pool_read_requests
这个比值必须取两个时间点的差值。若 Innodb_buffer_pool_reads 增长很快,同时磁盘读延迟升高,才说明缓存不足或工作集超出内存的可能性较高。命中率接近 100% 也不代表慢查询不存在,索引不匹配、锁等待和 CPU 计算仍可能造成高延迟。
可以先在线调整进行短时观察,但需要确认版本支持动态扩容,并且调整过程本身会带来内存和后台工作负载:
SET GLOBAL innodb_buffer_pool_size = 9663676416;
这里的数值约为 9 GiB,生产环境应替换为按实际内存预算计算的值。缩小 Buffer Pool 可能淘汰大量热页,不建议在业务高峰直接执行。
确认效果后,再把值写入对应配置文件。例如:
[mysqld]
innodb_buffer_pool_size=9G
如果需要重启使配置生效,必须先安排连接排空或维护窗口。systemctl restart mysql 会中断现有连接,应用侧应能重试并避免把数据库重启误判成数据故障。
Redo 太小可能造成频繁刷脏页和写入波动;过大则会增加磁盘占用,并可能延长崩溃恢复时间。不要通过删除 ib_logfile* 或手工移动 Redo 文件来“释放空间”。
先采集 Innodb_os_log_written 两次,例如间隔 60 秒:
SHOW GLOBAL STATUS LIKE 'Innodb_os_log_written';
计算方法为:
Redo 写入速率 = 60 秒内新增的字节数 ÷ 60
例如两个采样点相差 1,200,000,000 字节:
这个容量只是依据写入速率的估算起点,还要结合磁盘空间、峰值写入、恢复时间要求和版本参数。MySQL 8.0 不同小版本的 Redo 配置方式不同,先核验:
SHOW VARIABLES WHERE Variable_name IN (
  'innodb_redo_log_capacity',
  'innodb_log_file_size',
  'innodb_log_files_in_group'
);
如果存在 innodb_redo_log_capacity,优先按当前版本文档和配置方式调整;较早版本可能使用 innodb_log_file_size 与 innodb_log_files_in_group 的组合。不要把两套参数同时随意写入配置。修改 Redo 相关参数前必须保留配置备份,并准备可控重启。
默认建议保留:
[mysqld]
innodb_flush_log_at_trx_commit=1
如果启用了二进制日志,并且业务要求事务提交与 Binlog 持久化保持一致,通常也应核对:
[mysqld]
sync_binlog=1
把 innodb_flush_log_at_trx_commit 改为 2,或者把 sync_binlog 改为更宽松的值,可能降低磁盘写入压力,但在操作系统或服务器异常断电时会扩大最近事务丢失范围。除非业务明确接受该风险,并完成故障恢复演练,否则不要把可靠性参数作为普通性能开关。
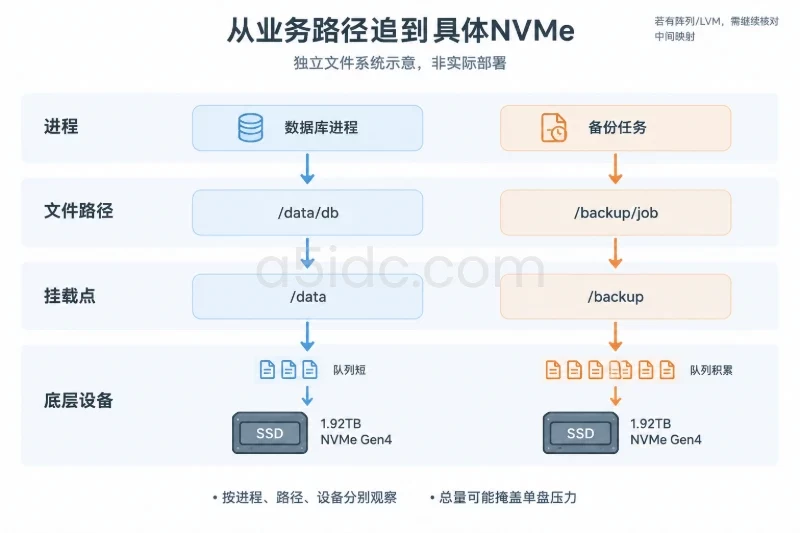
先确认 MySQL 数据目录、挂载点、文件系统和设备类型:
DATADIR=$(mysql -uroot -p -NBe "SELECT @@datadir;")
echo "$DATADIR"

df -hT "$DATADIR"
findmnt -T "$DATADIR"
lsblk -o NAME,TYPE,SIZE,FSTYPE,ROTA,MOUNTPOINT
需要重点确认:
把数据目录从一个目录移动到另一个目录,不等于获得独立 I/O。只有底层设备、配额或存储队列真正分离,才可能减少争用。移动数据目录还涉及停机、权限、SELinux/AppArmor 和启动配置,不应作为首次调优动作。
如果系统已经安装 sysstat,在业务高峰采集:
iostat -xz 1 10
vmstat 1 10
pidstat -d -p "$(pidof mysqld)" 1 10
没有 iostat 或 pidstat 时,先核对软件包来源和维护窗口,不要在生产环境随意安装或升级系统组件。
重点关注:
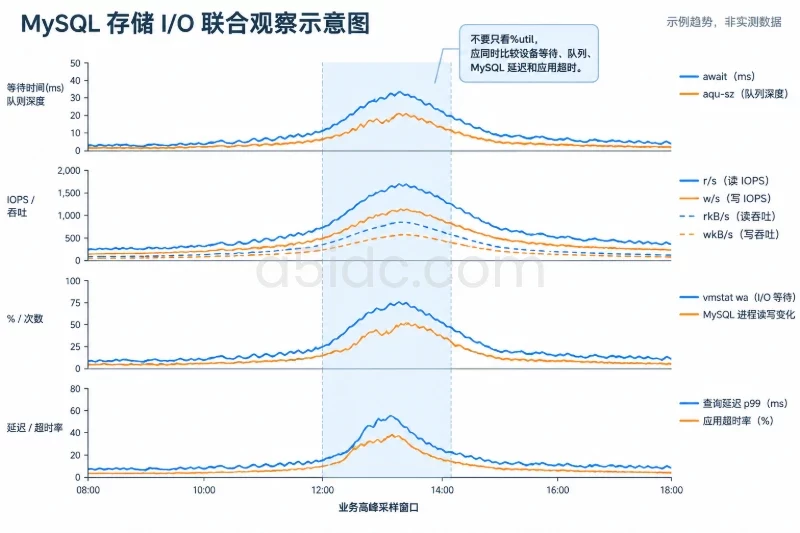
await:I/O 请求从提交到完成的平均等待时间;aqu-sz:设备队列长度;%util:设备忙碌程度,接近 100% 且等待时间升高时通常需要重点调查;r/s、w/s:读写 IOPS;rkB/s、wkB/s:读写吞吐;vmstat 中的 wa:CPU 等待 I/O 的比例;pidstat 中 MySQL 进程的读写变化。不能只看 %util 判断性能。不同存储设备和虚拟化层的 %util 含义可能不同,应该把设备等待、队列、MySQL 延迟和应用超时放在同一时间窗口内比较。
例如,某设备在高峰持续约 5,000 次 16 KiB I/O,每秒理论数据量为:
这个结果只是块大小和 IOPS 的换算,不代表实际吞吐一定能达到该值,也不能替代存储服务的延迟和突发性能限制。MySQL 的随机读写通常更应该关注 IOPS、延迟和队列,而不是只追求顺序吞吐。
innodb_io_capacity 用于影响后台刷脏页等工作,不能简单理解为“把磁盘速度设置成这个数”。默认值适合部分通用场景,但高性能存储和低性能云盘需要通过实际 I/O 观察调整。
示例配置如下:
[mysqld]
innodb_io_capacity=1000
innodb_io_capacity_max=2000
这里的数值仅作为调整格式示例。更合理的做法是:
iostat、Redo 写入和事务延迟;await、队列、CPU 和业务延迟没有同步恶化;如果 innodb_io_capacity 过低,脏页积压可能在检查点压力升高时集中刷盘;过高则可能让后台刷盘与前台查询争用 I/O。innodb_io_capacity_max 通常应高于基础值,但不应远超存储设备的稳定能力。
innodb_flush_method 也不能脱离系统测试直接修改。Linux 上常见的 O_DIRECT 可以减少操作系统页缓存与 Buffer Pool 的重复缓存,但是否适合要看文件系统、内核、存储层和备份工具。可以先记录当前值:
SHOW VARIABLES LIKE 'innodb_flush_method';
如果要试用其他值,应在非高峰窗口配置并重启验证。重启前必须确认 MySQL 能正常启动,重启后检查错误日志和磁盘延迟;一旦出现启动失败、I/O 错误或延迟明显上升,立即恢复旧配置。
A5数据提供面向数据库与业务后台的香港物理服务器资源,覆盖Xeon Gold、AMD EPYC等平台,并配备SSD或NVMe存储及不同内存配置,为MySQL缓存、数据读写和多任务运行提供硬件基础。香港方案同时提供CN2与国际带宽,可结合本地访问、跨区域业务及接口服务的网络需求,承载网站、数据库和应用服务。
SHOW GLOBAL STATUS WHERE Variable_name IN (
  'Threads_connected',
  'Threads_running',
  'Max_used_connections',
  'Connections',
  'Aborted_connects'
);

SHOW FULL PROCESSLIST;
Threads_connected 表示当前连接数,Threads_running 更接近正在执行或等待处理的连接数,Max_used_connections 是自上次重启以来的峰值。若 Threads_connected 很高但 Threads_running 很低,常见原因是连接池过大或连接长期空闲;若 Threads_running 长时间接近连接上限,则应先处理慢查询、锁等待和应用突发流量。
连接池应根据应用实例数量、实际并发数据库工作量和事务持续时间确定。例如,4 个应用实例各设置 20 个数据库连接,总连接数为 80,再预留管理、备份和复制连接空间,数据库上限可以从约 100 附近评估。但这只是计算方式,不是通用推荐值,最终要结合每个连接的内存使用和峰值压测。
不要因为出现 “Too many connections” 就直接把 max_connections 从几百调到几千。连接上限提高后,如果每个线程都在排序、创建临时表或等待磁盘,结果可能是内存耗尽和整体超时。
香港服务器的公网或跨区域网络延迟会放大短 SQL 的调用成本。优先检查:
MySQL 8.0 已不应围绕传统查询缓存参数进行调优。query_cache_size 等旧参数不是解决现代 MySQL 慢查询的通用方案。优先使用 InnoDB Buffer Pool 缓存热数据,通过应用层缓存减少重复读取,并对缓存失效和数据一致性设置明确边界。
完成一组调整后,至少观察一个完整业务周期,最好覆盖香港服务器上的实际高峰。不要在刚重启或刚清空 Performance Schema 后,仅凭几分钟数据下结论。
建议至少记录以下指标:
| 类别 | 验证指标 | 正向变化 | 需要警惕的变化 |
|---|---|---|---|
| 查询 | p95、p99、超时率 | 慢查询延迟和超时下降 | 平均值下降但 p99 上升 |
| 执行计划 | 实际索引、扫描行数 | rows_examined 减少 | 计划频繁漂移 |
| 连接 | Threads_running、连接获取时间 | 排队减少 | 连接数和内存一起上涨 |
| Buffer Pool | 读请求、物理读差值 | 热数据物理读压力下降 | 命中率改善但 CPU、锁等待未改善 |
| Redo | Innodb_os_log_written、事务延迟 | 写入波动变小 | 磁盘写队列持续升高 |
| 存储 | await、队列、wa | I/O 等待下降 | %util 和 await 同时上升 |
| 系统 | 内存、Swap、OOM 日志 | 保持余量 | Swap 增长或出现 OOM |
如果只优化了一条 SQL,应使用同一类参数、相近数据量和相同业务路径复测。单独执行 EXPLAIN 显示索引命中,并不等于应用接口一定变快;还要核对网络往返、锁等待、连接池排队和结果集传输时间。
systemctl status mysql --no-pager
journalctl -u mysql --since "30 minutes ago" --no-pager | tail -100

df -h
free -h
确认以下结果:
如果磁盘剩余空间快速下降,先停止扩大采集范围:
SET GLOBAL slow_query_log = OFF;
然后确认日志文件大小并执行轮转。不要在 MySQL 正在写入时直接 rm 当前日志文件而不刷新句柄。可在确认日志路径后执行:
FLUSH SLOW LOGS;
再由系统日志轮转工具压缩和清理旧文件。若日志目录已经接近满盘,优先恢复可用空间,避免数据库因无法写日志或 Binlog 而受到连带影响。
可能原因包括统计信息过期、查询条件选择性低、联合索引顺序不合适、隐式类型转换、函数包裹索引列,或者优化器认为全表扫描成本更低。处理顺序如下:
EXPLAIN 和 EXPLAIN ANALYZE;ANALYZE TABLE;先查看元数据锁和正在执行的 DDL:
SHOW FULL PROCESSLIST;
如果启用了 performance_schema,可以进一步查看等待中的元数据锁:
SELECT
  OBJECT_SCHEMA,
  OBJECT_NAME,
  LOCK_TYPE,
  LOCK_DURATION,
  LOCK_STATUS,
  THREAD_ID
FROM performance_schema.metadata_locks
WHERE OBJECT_SCHEMA IS NOT NULL;
不要随意执行 KILL 大量业务连接。若确认是本次变更创建的 DDL,可以根据进程列表中的线程编号终止对应查询,但终止后仍可能经历回滚或清理阶段。大型表的索引操作应改到维护窗口,或使用经过验证的在线变更工具和发布流程。
如果出现 Swap、OOM 或 MySQL 被系统杀死,应优先恢复旧值,而不是继续调小其他缓存参数。确认配置文件中的新值并恢复:
[mysqld]
innodb_buffer_pool_size=原有值
然后检查配置语法和服务状态。若服务已停止,先确认配置文件没有重复项和拼写错误,再启动:
systemctl start mysql
systemctl status mysql --no-pager
journalctl -u mysql -n 100 --no-pager
如果无法启动,使用变更前备份恢复配置文件。不要删除数据目录、Redo 文件或系统表来尝试解决启动失败。
当 await、队列长度、应用 p99 同时恶化时,先恢复 innodb_io_capacity 和 innodb_io_capacity_max 的旧值。若只是后台刷盘变少而查询变快,不代表参数一定错误,还需观察脏页、Redo 和崩溃恢复风险。I/O 参数应服务于稳定延迟,而不是追求更高的后台写入数字。
每次变更前保存旧值。对支持动态修改的参数,可直接恢复:
SET GLOBAL long_query_time = 旧值;
SET GLOBAL min_examined_row_limit = 旧值;
SET GLOBAL innodb_io_capacity = 旧值;
SET GLOBAL innodb_io_capacity_max = 旧值;
SET GLOBAL slow_query_log = OFF;
如果使用了 MySQL 8.0 的 SET PERSIST,可以使用对应的 RESET PERSIST 清除持久化项;如果参数写在配置文件中,则应恢复备份文件或删除新增行。运行时值、持久化值和配置文件值不一致时,重启后可能再次出现变化,回滚完成后必须重新核对:
SHOW VARIABLES WHERE Variable_name IN (
  'slow_query_log',
  'long_query_time',
  'innodb_buffer_pool_size',
  'innodb_io_capacity',
  'innodb_io_capacity_max'
);
这类参数可能需要重启。执行前:
sudo cp -a /var/backups/mysql-tuning/mysqld.cnf.变更前时间 \
  /etc/mysql/mysql.conf.d/mysqld.cnf

sudo systemctl restart mysql
sudo systemctl status mysql --no-pager
上面的备份文件名必须替换为实际保存的文件。不同发行版配置路径不同,恢复前先确认路径,避免覆盖了错误文件。
只有确认索引是本次变更新增、并且没有其他发布依赖它时,才执行删除。删除索引同样可能占用 I/O 和等待元数据锁,必须先备份并安排窗口:
SHOW INDEX FROM orders;
确认索引名后:
ALTER TABLE orders
  DROP INDEX idx_orders_user_status_created,
  ALGORITHM=INPLACE,
  LOCK=NONE;
删除后重新执行核心查询的执行计划,并观察写入延迟是否恢复。不要为了快速回滚而直接删除业务表或覆盖整个数据目录。
innodb_buffer_pool_size 留出了操作系统、应用、连接和临时内存空间。innodb_flush_log_at_trx_commit 和 sync_binlog 的可靠性取值经过业务确认。iostat、vmstat 或等效监控确认 I/O 等待、队列和 CPU 等待变化。innodb_io_capacity 使用稳定 I/O 能力作为参考,没有按突发峰值盲目设置。max_connections、Threads_running 和内存占用相互匹配。