

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


以一组便于比较的业务数据为例:应用每秒执行约 300 次查询,慢查询日志中一条按用户和时间范围检索的 SQL 耗时 1.8 秒;数据库所在服务器的磁盘利用率接近 90%,但尚不清楚慢是由缺少索引、磁盘读写拥塞,还是两者共同造成。判断时不要只看服务器位于香港还是韩国,也不要看到磁盘繁忙就直接升级存储:先确认 SQL 执行计划和扫描行数,再结合磁盘延迟、队列与缓存命中情况决定优化顺序。
香港与韩国服务器上的数据库可按同一套方法排查。比较两地部署效果时,应尽量保持数据库版本、数据量、索引、参数和并发一致,并让应用在各自部署位置附近发起测试;否则,跨区域应用到数据库的网络往返时间会混入查询耗时,难以判断究竟是数据库执行慢,还是请求往返慢。下面以 Linux 上的 MySQL 8.0 为例,给出从采集到验证和回滚的流程。
查询耗时可粗略拆成三部分:应用与数据库之间的网络往返、数据库执行与等待、结果传输。慢查询日志记录的是数据库端执行时间,不等同于用户完整感知的接口耗时。如果慢日志耗时不高,而应用响应时间明显更长,应先检查应用到数据库的网络往返、连接池排队和结果集传输,不要仅凭接口耗时给 SQL 加索引。
开始前确认以下条件:
如果慢查询尚未记录,可在确认配置文件位置、磁盘空间和日志权限后启用慢日志。以常见的 Ubuntu/Debian MySQL 安装为例,先检查服务和配置:
mysql --version
sudo systemctl status mysql
sudo grep -R "slow_query_log\|long_query_time\|log_output" /etc/mysql/
确认实际生效的配置文件后,编辑对应的 mysqld 配置段,例如 /etc/mysql/mysql.conf.d/mysqld.cnf:
[mysqld]
slow_query_log = ON
slow_query_log_file = /var/log/mysql/slow.log
long_query_time = 1
log_output = FILE
long_query_time = 1 表示记录执行时间超过 1 秒的语句,可按业务基线调整;它不是性能达标线。先确认日志目录由 MySQL 服务账户可写,且所在文件系统空间充足。配置变更通常需要重启 MySQL,可能造成短暂连接中断;应在维护窗口操作,并提前备份原配置。重启后用 SHOW VARIABLES 核对生效值。若服务未能启动,恢复备份配置并重启服务,再检查错误日志。
SHOW VARIABLES LIKE 'slow_query_log';
SHOW VARIABLES LIKE 'slow_query_log_file';
SHOW VARIABLES LIKE 'long_query_time';
SHOW VARIABLES LIKE 'log_output';
先从慢日志中找出重复出现、耗时较长且影响业务的 SQL,确认参数值具有代表性。不要仅凭一条极端参数下的记录优化所有请求。下面的查询用于说明判断方法:
SELECT id, user_id, created_at, status, amount
FROM orders
WHERE user_id = 812
  AND status = 'paid'
  AND created_at >= '2026-09-01 00:00:00'
ORDER BY created_at DESC
LIMIT 50;
检查表结构和索引,再查看执行计划:
SHOW CREATE TABLE orders;
SHOW INDEX FROM orders;

EXPLAIN
SELECT id, user_id, created_at, status, amount
FROM orders
WHERE user_id = 812
  AND status = 'paid'
  AND created_at >= '2026-09-01 00:00:00'
ORDER BY created_at DESC
LIMIT 50;
重点关注访问类型、候选索引、实际选用索引、估算扫描行数和额外排序信息。若计划显示全表扫描,且估算行数接近全表规模,或扫描后还需对大量记录排序,通常值得检查筛选条件是否有合适的联合索引。若已使用索引但扫描行数远大于返回行数,可能是索引列顺序不合适、条件选择性低,或者统计信息不准确。
联合索引应结合查询的等值条件、范围条件和排序需求设计,而不是把所有字段都塞进去。对上面的 SQL,可以评估如下索引:
CREATE INDEX idx_orders_user_status_created
ON orders (user_id, status, created_at);
通常先考虑等值过滤列,再考虑范围或排序列;但索引能否同时满足过滤与排序,要结合字段类型、排序方向、数据分布和 MySQL 版本验证。SELECT * 会扩大读取和回表成本,能明确列出需要的字段时,优先只取必要列。不要为了减少回表盲目建立包含大量字段的“覆盖索引”,因为索引越宽,占用空间和写入维护成本越高。
MySQL 8.0 可用 EXPLAIN ANALYZE 查看实际执行情况,但它会真正执行查询。只对已评估资源影响的语句使用,避免在高峰期对大范围查询直接运行:
EXPLAIN ANALYZE
SELECT id, user_id, created_at, status, amount
FROM orders
WHERE user_id = 812
  AND status = 'paid'
  AND created_at >= '2026-09-01 00:00:00'
ORDER BY created_at DESC
LIMIT 50;
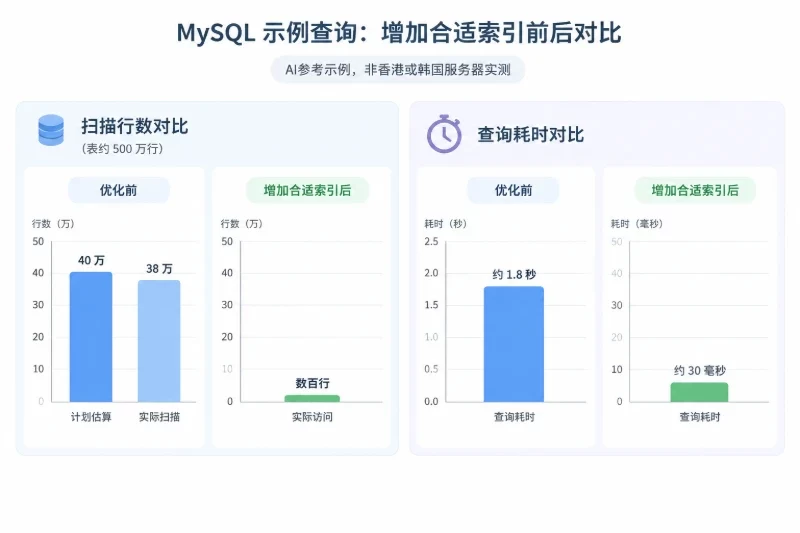
例如,某张表有 500 万行,优化前计划估算扫描 40 万行,实际扫描 38 万行,查询耗时约 1.8 秒;增加合适索引后,执行计划只需访问数百行,耗时降到约 30 毫秒。这些数字仅用于说明数量级,不代表香港或韩国服务器的实测结果。若加索引后扫描行数仍高,应重新检查查询条件和数据分布,而不是继续叠加相似索引。
索引能减少需要读取的记录,但创建和维护索引本身也会增加磁盘读写。确认系统已有 sysstat 工具后,可先用以下命令观察设备状态;命令只读取指标,不修改数据库:
iostat -xz 1 10
vmstat 1 10
若系统提示找不到 iostat,先核对发行版的软件包来源和维护窗口,再安装相应的 sysstat 工具。iostat -xz 中常用指标包括:
r/s、w/s:每秒读写请求量。请求量高本身不代表故障,需与延迟和业务负载一起看。await:I/O 请求平均等待时间,单位通常为毫秒。持续升高,且与查询变慢时间吻合,说明存储等待值得进一步排查。aqu-sz:平均队列长度。若队列持续增加并伴随等待时间上升,可能有 I/O 堵塞。%util:设备忙碌时间占比。接近 100% 且持续伴随高延迟时是告警线索,但对并行度较高的设备,不能单独用它判断性能已到上限。vmstat 中持续出现非零的 wa(I/O 等待)可作为补充线索;若系统同时有大量换页活动,还要检查内存压力,因为缓存被挤出后会增加磁盘读取。不要把一次采样中某个指标偏高就当成根因,至少将采样时间与慢查询出现时段对齐,并观察一段时间。
MySQL 侧可检查 InnoDB 缓冲池和读取情况:
SHOW GLOBAL STATUS LIKE 'Innodb_buffer_pool_read%';
SHOW VARIABLES LIKE 'innodb_buffer_pool_size';
Innodb_buffer_pool_reads 反映需要从磁盘读取数据页的次数,Innodb_buffer_pool_read_requests 反映缓冲池读取请求总量。取相同时间间隔的两次计数,观察磁盘读取次数相对总请求的变化;单看累计值无法判断当前命中表现。粗略估算可用:
缓冲池命中率 ≈ 1 −(区间内物理读取次数 ÷ 区间内总读取请求次数)
例如某 5 分钟区间内总读取请求为 100 万次、物理读取为 2 万次,估算命中率约为 98%。这只是整体参考值,不能说明某一条慢 SQL 一定命中缓存;首次读取、数据集大于缓冲池和查询扫描范围过大都可能造成物理读。不同业务冷热数据分布也会改变结果。
将查询计划和资源指标放在一起看,比单独看索引或磁盘更可靠。
| 执行计划与资源表现 | 更可能的方向 | 优先动作 |
|---|---|---|
| 全表扫描或扫描行数远大于返回行数,磁盘延迟不高 | 索引或 SQL 条件不合适 | 检查筛选条件、联合索引顺序、返回字段和排序 |
执行计划扫描范围合理,但 await、队列和 wa 在慢查询时段持续升高 | 磁盘 I/O 等待 | 检查并发读写、换页、数据集与缓冲池关系,再评估存储资源 |
| 扫描行数多,同时磁盘延迟也高 | SQL 扫描放大了 I/O 压力 | 先验证能减少扫描量的 SQL 或索引调整,再复测 I/O |
| 数据库慢日志耗时低,应用请求耗时高 | 数据库之外的等待 | 检查应用与数据库网络往返、连接池排队、结果集大小 |
| 索引已命中但扫描行数仍大 | 选择性、统计信息或条件写法问题 | 核对数据分布和条件类型;不要立刻叠加重复索引 |
需要优化索引时,先在测试环境或低峰期评估索引创建耗时、临时空间和写入影响。大表创建索引可能增加 I/O 并影响线上负载,具体锁行为与算法受 MySQL 版本、表结构及操作方式影响,不要假定所有建索引操作都完全无锁。执行前确认备份可用、剩余空间足够,并准备好删除新索引的回滚方案。
索引建好后用 SHOW INDEX FROM orders 确认其存在,再对同一条查询、相同参数范围和相近并发量重新执行 EXPLAIN 或受控的 EXPLAIN ANALYZE。同时记录慢日志耗时、扫描行数、设备 await、队列和应用响应时间。建议连续观察数个相近负载窗口,而不是只对比一次结果。若查询扫描行数下降、慢查询耗时改善且 I/O 延迟未恶化,调整方向有依据;若查询变快但写入延迟明显上升,则需评估索引维护成本。
如果新索引无效或造成负面影响,可在确认没有其他查询依赖它后回滚:
DROP INDEX idx_orders_user_status_created ON orders;
删除前确认索引名称和目标表,并记录执行前的索引定义;删除会影响依赖该索引的其他查询计划,操作前应评估业务范围。删除后复查索引列表和慢查询情况。若变更涉及应用 SQL 或数据库参数,也应恢复对应备份版本,并按维护流程验证服务与连接状态。
两地部署的数据库优化结论,首先取决于 SQL、数据分布、存储表现和应用位置,不存在仅凭地域就能确定哪一侧查询更快的规则。若应用与数据库部署在同一地区,网络往返通常较少;应用跨地区访问数据库时,单次查询的网络等待可能更明显,连接池排队也会放大接口延迟。比较时应分别记录数据库慢日志耗时和应用端总耗时,并用相同请求模式测试。
还要控制连接池并发:连接过少可能使请求排队,过多则会提高数据库并发读写压力,进一步推高磁盘队列。观察连接池等待时间、活跃连接数和数据库并发情况后再调整,不要把加连接数当作慢查询优化。缓存也会改变读盘量;热数据命中较高时磁盘读可能下降,但缓存不会修复全表扫描带来的 CPU 消耗,也不能替代正确索引。
如果后续数据量、并发、冷热数据比例或应用与数据库的部署位置发生变化,当前判断也可能改变。相同 SQL 在数据规模扩大后可能从内存命中转为频繁读盘;写入比例上升则会提高索引维护成本;跨区域调用比例变化会改变网络等待占比。每次明显调整后,都应重新采集执行计划、慢日志和 I/O 指标,再决定下一步。


