香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


漏洞补丁快速响应的目标,是在明确影响范围后尽快降低暴露风险,同时让香港服务器保持可恢复状态。生产变更不能把“安装了新内核”当作完成:需要确认补丁来源和修复状态,保留可启动的旧内核与恢复入口,再通过单节点验证、分批更新和业务观察决定是否扩大变更。
对于标记为 Kernel 7.2 的香港节点,我会将补丁响应拆成两条并行工作线:安全侧核实漏洞适用条件,必要时先限制受影响功能;运维侧准备备份、灰度批次和启动回退。更新采用“先摘流、后安装、单次试启动、验证后确认”的顺序,出现启动失败、驱动异常或业务指标越线时停止扩批,而不是让整个服务器池一起承担风险。
“Kernel 7.2”在本方案中是待核验的目标版本标识,不据此认定该版本已经发布、已有特定漏洞,或某个安装包已经完成修复。实施前必须将它对应到发行版、软件仓库、完整软件包版本和安全公告。
内核主版本号不是漏洞判断的充分依据。发行版可能在原有版本上回移安全修复,uname -r 显示的主版本未变,但补丁已经进入发行版软件包;反过来,自行安装较新的主线内核,也不能直接证明所有相关漏洞都已修复。
我会先完成以下核对,再决定更新路径:
| 核对对象 | 需要确认的内容 | 对变更的影响 |
|---|---|---|
| 漏洞公告 | 漏洞编号、受影响版本、利用条件、修复版本 | 决定哪些节点需要处理 |
| 发行版软件包 | 仓库来源、包版本、维护分支、修复说明 | 决定使用哪个更新包 |
| 运行内核 | 当前启动版本、已安装但未启用的内核 | 避免重复安装或误判完成 |
| 节点角色 | Web、数据库、存储、容器宿主机 | 决定摘流和重启顺序 |
| 依赖组件 | 网卡、磁盘、文件系统、外置内核模块 | 决定兼容性测试范围 |
如果目标内核只存在于非生产维护仓库,或者无法确认签名和维护责任,不应为了满足“7.2”这个版本标签直接上线。优先选择发行版支持的修复包;确需使用其他内核分支时,应按独立兼容性变更处理。
以下示例以使用 APT 和 GRUB 的 Debian、Ubuntu 类服务器为对象。其他发行版应使用对应的包管理与启动配置方法,不能照搬命令。容器通常共享宿主机内核,在容器内安装内核包不会替换宿主机正在运行的内核。
先执行只读检查:
cat /etc/os-release
uname -r
uname -m
systemd-detect-virt || true
findmnt /
findmnt /boot || true
findmnt /boot/efi || true
df -h / /boot
df -i / /boot
dpkg-query -W 'linux-image*' 2>/dev/null || true
结果需要形成分支判断:
/boot:可能与根分区共用空间,不等于没有启动文件。同时记录每台节点的业务角色、实例标识、运行内核、候选包、恢复方式和维护负责人。香港节点中不同镜像、虚拟化平台及驱动组合应分组,不能仅因部署地区相同就视为同一批次。
安全响应速度应由实际暴露面决定,而不是只看漏洞评分。需要区分远程可触发、本地权限提升、特定模块加载后才受影响,以及仅在某项功能启用时可触发等情况。
例如,本地权限提升漏洞对于运行不可信租户任务的宿主机,处理优先级可能高于只运行受控服务的专用节点。若漏洞依赖某项可停用功能,可以先实施经过评估的临时限制,再安排内核更新。
临时缓解措施也必须有负责人、适用范围和撤销条件。涉及网络访问策略或模块停用时,先确认管理链路和业务依赖,避免缓解动作先造成失联。已经疑似遭到入侵的节点,应进入事件响应流程;补丁不能替代取证、凭据处置和可信重建。
内核更新前至少保留三类恢复材料:
虚拟机快照不自动等于数据库一致性备份。数据库节点需要结合自身备份、复制和恢复机制;回滚内核时也不应默认恢复整台虚拟机快照,否则可能把已经写入的业务数据一起退回。
下面的命令仅备份启动配置,不构成完整系统备份:
CHANGE_ID="kernel-$(date -u +%Y%m%dT%H%M%SZ)"
BACKUP_DIR="/root/change-backups/$CHANGE_ID"

sudo install -d -m 0700 "$BACKUP_DIR"
sudo cp -a /etc/default/grub "$BACKUP_DIR/"
sudo cp -a /etc/grub.d "$BACKUP_DIR/"
sudo cp -a /boot/grub/grub.cfg "$BACKUP_DIR/"
uname -r | sudo tee "$BACKUP_DIR/running-kernel.txt" >/dev/null
仅在上述路径存在、启动器确实为 GRUB 时使用。备份应同步到受控的异地位置,限制访问权限,并验证可以读取。恢复时优先还原配置源文件并重新生成启动配置,不在不同机器之间直接复制 grub.cfg。
SSH 可用只能说明当前系统正常,不能证明更新失败后能够恢复。开始前应确认该香港服务器是否具备控制台、救援系统或其他带外管理入口,以及对应权限是否已经可用。
如果产品形态没有自助恢复入口,要提前确认服务方的恢复协作流程。不能把“重启后再联系支持”当作回滚方案,也不能默认所有香港服务器产品都支持快照或控制台功能。
恢复演练至少覆盖以下判断:
这里的“保留旧内核”是保留整套可启动依赖,不是只保留一个内核镜像文件。
灰度更新按故障域和节点角色划分,而不是随机抽取固定百分比。一个可参考的节奏是:测试节点、每种关键硬件或虚拟化组合的一台生产节点、小批次节点、剩余节点。
以一个有十台无状态应用节点的服务器池为例,可以先更新一台,观察通过后更新两台,再分批完成余下节点。这个节奏只在剩余节点能够承接流量时成立;若摘除一台就接近容量上限,应先补充容量或缩小维护窗口内的负载。
数据库、存储和集群控制节点不能机械套用上述比例。它们必须遵守复制状态、法定多数和角色切换要求,通常先处理可安全重启的非主节点,并验证同步状态后再推进。
我会在变更单中冻结目标软件包版本、批次名单、每批最大并发、观察时长和停止条件。仓库有新包出现,也不能让后续批次未经复核就换成另一版本。
无状态节点先从负载均衡中摘除,再等待连接排空。长连接、队列消费者、定时任务和后台作业需要单独处理,不能只看 HTTP 健康检查已关闭。
摘流后应确认剩余节点的连接数、错误率、队列积压和资源水位。如果流量转移已经引发异常,先恢复该节点承载并暂停变更,不继续安装内核。
数据库节点则应先确认复制正常,并按数据库自身机制完成角色处理。本文的内核操作不替代数据库切换方案。
不要直接执行全系统升级。内核补丁与业务软件升级放在同一窗口,会扩大影响范围,也使回滚归因更困难。
下列示例要求在同一 Bash 会话中预先设置 TARGET_IMAGE 和 TARGET_VERSION,值应来自已核验的发行版仓库。它们分别表示内核镜像包名和完整包版本,不要根据“7.2”猜测包名。
: "${TARGET_IMAGE:?请先设置已核验的内核镜像包名}"
: "${TARGET_VERSION:?请先设置已核验的软件包完整版本}"

sudo apt-get update
apt-cache policy "$TARGET_IMAGE"
sudo apt-get -s install "$TARGET_IMAGE=$TARGET_VERSION"
模拟结果应人工复核:是否引入预期之外的包、是否删除现有内核、是否涉及不相关的系统升级。存在外置模块时,还应把对应 headers 和模块包纳入冻结清单,确认构建条件齐全。
若使用 GRUB 的 saved-entry 机制,我会在安装前先将已验证的旧内核设为持久默认项,避免安装钩子更新菜单后意外把新内核变成常规启动项。这需要先备份配置,核实当前启动机制支持读取和写入 GRUB 环境。
随后才执行安装:
sudo apt-get install "$TARGET_IMAGE=$TARGET_VERSION"
该操作会修改启动文件,并可能触发 initramfs、GRUB 和模块构建钩子。适用前提是备份、旧内核保留及恢复入口已经就绪。失败时先留存安装日志、检查软件包状态;不要对尚未配置完成的内核安排重启,也不要通过直接删除 /boot 文件强行腾出空间。
目标内核的 release 字符串应从包内容和实际安装文件核实,它不一定等于软件包版本。将核验结果设置为 TARGET_RELEASE 后检查:
: "${TARGET_RELEASE:?请先设置目标内核的实际 release 字符串}"

test -s "/boot/vmlinuz-$TARGET_RELEASE"
test -d "/lib/modules/$TARGET_RELEASE"
test -s "/boot/initrd.img-$TARGET_RELEASE"

if command -v dkms >/dev/null 2>&1; then
    dkms status
fi
文件存在只是最低检查。还应确认安装日志无 initramfs 生成失败,必要的网卡、存储和外置模块可用于目标内核。DKMS 有构建失败、签名失败或目标版本缺少模块时,停止该节点更新。
不要在内核补丁窗口顺便改动网络配置、文件系统参数或无关的 sysctl 设置。每多一个变量,都增加启动失败或性能变化后的排查成本。
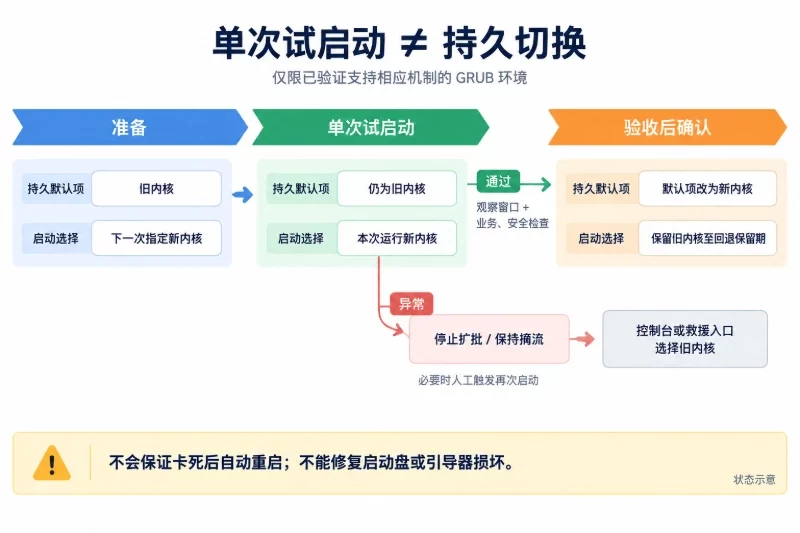
对于支持相应机制的 GRUB 环境,可以保留旧内核为持久默认项,仅让下一次启动选择新内核。实际菜单 ID 必须从本机生成的配置中核对;存在子菜单时,需要使用完整选择路径,不能复制其他服务器的 ID。
先查看菜单定义和环境:
sudo grep -E "^[[:space:]]*(submenu|menuentry) " /boot/grub/grub.cfg
sudo grub-editenv list
配置源文件中通常需要使用 GRUB_DEFAULT=saved,并避免自动保存选择覆盖预期策略。修改前必须备份,修改后执行 update-grub,再核对生成结果。
完成这些前提后,可使用已核验的菜单选择器:
: "${OLD_ENTRY:?请先设置本机旧内核的完整菜单选择器}"
: "${NEW_ENTRY:?请先设置本机新内核的完整菜单选择器}"

sudo grub-set-default "$OLD_ENTRY"
sudo grub-reboot "$NEW_ENTRY"
sudo grub-editenv list
这组操作改变启动选择,仅适用于已验证支持该机制的环境。重启会中断该节点业务,必须在摘流、控制台待命和恢复材料齐备后进行:
sudo systemctl reboot
单次启动不是自动救援。它不能保证内核卡死后机器会自行再次重启,也不能绕过启动盘或引导器损坏;其价值是在机制正常时保留下一次启动旧内核的机会。
自动化工具应落实三个约束:可重复执行、失败即停、状态留证。推荐将流程拆成检查、安装、重启、验证和确认五个阶段,每个阶段都有独立结果。
重复运行时,工具先检查目标包是否已安装、目标内核是否正在运行、该节点是否已经通过业务验证,避免重复重启。灰度阶段并发设为一台;任一关键检查失败,停止后续节点,而不是继续跑完整个清单。
软件包自动更新策略也应纳入核对,防止计划外内核安装或自动重启与灰度窗口冲突。但不应为此长期关闭全部安全更新。内核更新、自动重启和其他软件安全补丁应分别管理。
定时任务适合执行只读巡检,例如每日核对运行内核、已安装修复包和待重启状态,再汇总告警。生产内核安装和重启仍需经过变更授权;需要无人值守更新时,也必须预先具备容量冗余、失败门禁和经过演练的恢复流程。
节点重新可连接后,先确认运行的是目标内核,并检查当前启动日志:
uname -r
systemctl --failed
journalctl -b -k -p warning --no-pager
ip -br address
ip route
findmnt /
不同结果对应不同动作:
日志中有警告不一定需要回滚,应与变更前基线比较;新增且关联关键路径的异常需要阻止扩批。
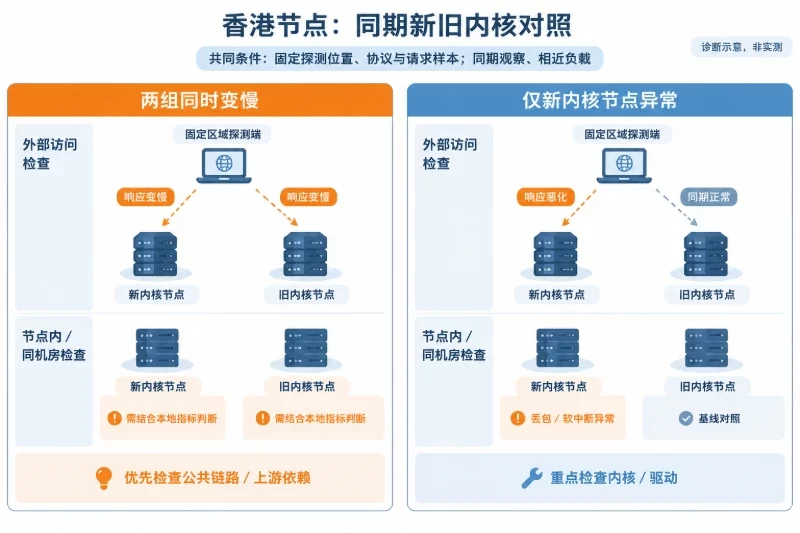
香港服务器的访问体验同时受节点资源、运营商路径、跨境链路和上游服务影响。只从一个外部位置测延迟,不能把波动直接归因于内核。
验证应包含两层:
将新内核节点与同期旧内核节点比较,可以减少全局网络波动带来的误判。若两组同时变慢,应先检查公共链路或上游依赖;若只有新内核节点出现丢包、软中断异常和响应恶化,再重点检查内核与驱动。
灰度流量太低时,也不足以证明高峰期稳定。可先恢复小比例流量,再逐步恢复该节点正常权重,期间持续观察。
下面是可供调整的示例门槛,不是通用性能标准。实际数值应结合业务 SLO、历史波动和采样量提前确定。
| 观察项 | 示例暂停或回滚条件 | 判定重点 |
|---|---|---|
| 业务错误率 | 连续5分钟超出业务阈值,或比基线上升0.5个百分点 | 保证请求样本量足够 |
| P95响应时间 | 相近负载下连续10分钟高于基线20% | 排除上游及路径变化 |
| 内核与驱动 | 出现 panic、重复 I/O 错误、关键设备掉线 | 不等待普通观察窗口结束 |
| 数据与复制 | 一致性校验异常,或复制状态无法恢复 | 优先保护数据 |
| 节点资源 | 持续异常饱和,并伴随业务退化 | 不凭单次 CPU 峰值回滚 |
例如错误率从0.2%升到0.7%,增加的是0.5个百分点。把变化口径写清楚,自动化门禁才不会错误触发。
审计记录应包含软件包来源与版本、变更前后运行内核、安装和启动结果、业务验证数据、摘流与恢复时间、审批及执行身份。日志按需要脱敏,避免把访问令牌、用户数据或完整敏感配置写入变更附件。
不是所有异常都要立即切回旧内核。轻微但原因不明的性能变化,可以保持节点低权重观察,同时停止后续批次;启动失败、存储错误或关键网络故障则需要直接进入回滚。
我会按以下规则执行:
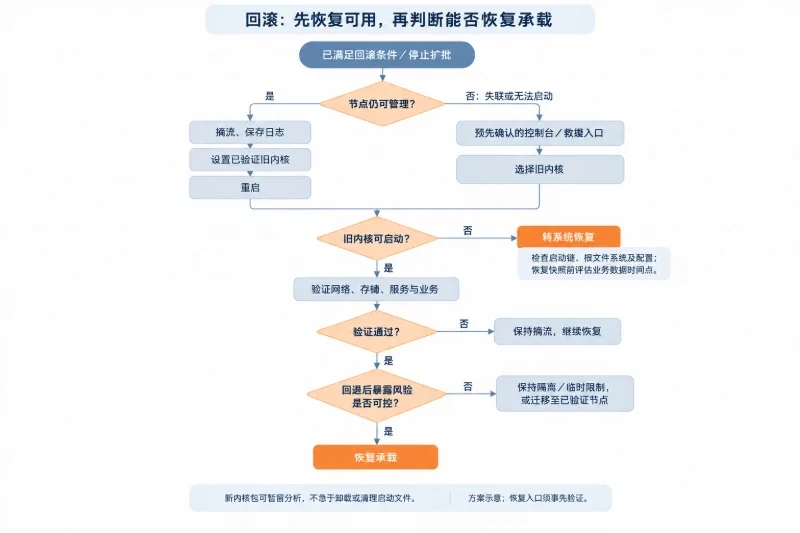
回滚是恢复手段,不是对安全问题的最终处理。如果回退版本仍受漏洞影响,应继续维持临时限制、隔离相关工作负载,或迁移到已经验证的节点。
对仍可管理的节点,先摘流、保存日志,再将已验证的旧内核设为启动目标并重启。对无法启动或失联的节点,使用预先确认的控制台或救援入口选择旧内核。
回退后重新执行网络、存储、服务和业务验证。确认旧内核恢复正常后,再恢复承载;新内核包可以暂时保留以便分析,不必在故障窗口同时进行卸载和启动文件清理。
若旧内核也无法启动,应转入系统恢复流程,检查启动链、根文件系统和配置变更,不能只在多个内核间反复切换。涉及恢复系统快照时,必须先评估数据库及业务数据的时间点,避免扩大损失。
对于普通无状态节点,可参考这样的观察安排:重启后先做10至15分钟功能核验,恢复部分流量后观察30至60分钟;第一台生产灰度节点尽量覆盖一个有代表性的业务高峰。后续批次按相同门禁推进,全部完成后继续观察24至48小时。以上时间是实施参考,不能替代实际负载覆盖。
当节点通过既定窗口、业务和安全检查均无异常后,再把新内核设为持久默认项,并保留旧内核至回退保留期结束。长期不重启的环境尤其要核对默认启动项,避免下一次意外重启又回到旧版本。
最终完成标准是:受影响香港节点的修复状态已核验,目标内核实际运行,业务指标通过观察,默认启动项符合预期,回滚入口仍然可用。观察期内一旦出现关键驱动故障、数据风险或持续业务越线,立即停止扩批并按已确认的路径回滚;回退后若漏洞风险仍高,则保持隔离或临时限制,直到修复方案重新通过验证。