香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


目标状态是:NVMe SSD使用与实际负载匹配的blk-mq调度策略,在达到业务所需IOPS的同时,P99延迟、CPU开销和错误率保持可接受。对2026年运行主流Linux发行版的服务器,none通常适合作为高并发NVMe的对照基线,mq-deadline则值得在读写混合、读请求容易被写入拖慢的场景中比较;不应仅凭“新版内核”就统一切换调度器。
执行前,先核对运行内核、实际承载业务的块设备层、可用调度器、应用并发度,以及nr_requests、rq_affinity、wbt_lat_usec等当前参数。Ubuntu、Debian、RHEL及其兼容发行版可能采用不同内核版本和回移补丁,最终应以本机sysfs输出为准。以下操作面向内核块设备路径上的NVMe SSD;使用SPDK等用户态存储路径时,这套调度器配置不直接适用。
在线切换调度器通常不需要卸载文件系统,但会改变目标块设备上所有业务的I/O排队行为。系统盘、数据库盘和共享存储节点,应安排维护窗口或先在同配置测试节点验证。
实施前需要具备以下条件:
sysfs参数的管理员权限。调度器切换不会主动删除数据,但性能抖动可能造成业务超时。不要把“无需重启”理解为“没有生产影响”。
先执行只读检查:
uname -r
cat /etc/os-release
lsblk -o NAME,TYPE,SIZE,ROTA,MOUNTPOINTS,MODEL
findmnt -T /实际业务目录 -o SOURCE,FSTYPE,TARGET
将最后一条命令中的目录替换为业务数据所在路径。较旧的lsblk若不支持MOUNTPOINTS,可改用MOUNTPOINT。
结果应按以下方式解释:
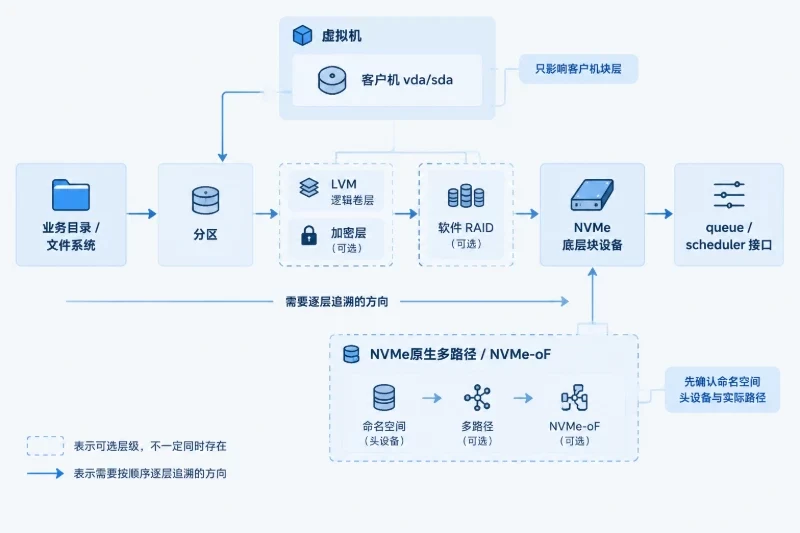
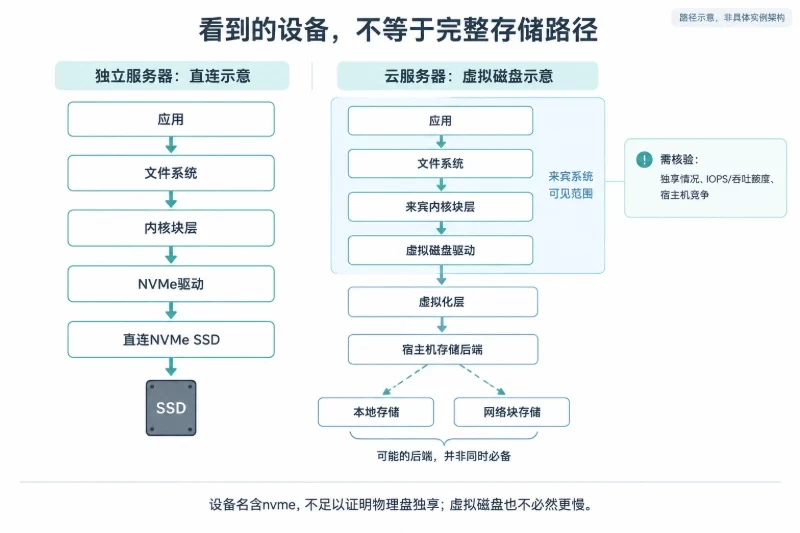
nvme0n1p1:检查其父设备nvme0n1。dm-或md:先追溯LVM、加密层或软件RAID的底层成员,再检查各层可用属性;不要只修改逻辑卷就认为底层已生效。vda或 sda等设备:客户机调度器只影响客户机块层,不能代表宿主机NVMe配置。ROTA=0只表示内核将其视为非旋转设备,不证明它一定是本地NVMe,也不证明存储后端没有限速。
下面示例使用nvme0n1。必须替换为已核对的目标设备;后续命令默认在同一个Bash会话中执行。
DEV=nvme0n1
Q="/sys/block/$DEV/queue"

test -d "$Q" || { echo "目标设备不存在"; exit 1; }
test -r "$Q/scheduler" || { echo "该设备未暴露调度器接口"; exit 1; }

SNAP=$(mktemp -d /var/tmp/a5-nvme-baseline.XXXXXX)
printf '%s\n' "$DEV" > "$SNAP/device"
uname -r > "$SNAP/kernel"
cat "$Q/scheduler" > "$SNAP/scheduler"

sed -n 's/.*\[\([^]]*\)\].*/\1/p' \
  "$Q/scheduler" > "$SNAP/scheduler.active"

for P in nr_requests rq_affinity read_ahead_kb nomerges \
         wbt_lat_usec max_sectors_kb logical_block_size \
         physical_block_size; do
  if [ -r "$Q/$P" ]; then
    cat "$Q/$P" > "$SNAP/$P"
  fi
done

printf '配置快照:%s\n' "$SNAP"
cat "$Q/scheduler"
例如输出:
[none] mq-deadline kyber
方括号中的none是当前调度器,其余是当前可选择项。设备、内核配置和已加载模块不同,输出也可能不同。接口缺失或只提供none时,不要创建不存在的文件,也不要未经核验就套用其他机器的模块加载命令。
高IOPS场景不宜从“所有队列参数都调大”开始。先用当前配置建立基线,再一次只改变一个变量。
| 检查项 | 初始处理建议 | 真正需要关注的偏差 |
|---|---|---|
scheduler | 将none作为对照候选;混合负载比较mq-deadline | 当前调度器与目标负载不匹配,或修改了错误设备 |
nr_requests | 先保留现值 | 应用有积压、设备未充分利用,且确有请求资源压力 |
rq_affinity | 先保留现值并记录 | 完成处理、CPU绑定与NUMA位置不协调 |
wbt_lat_usec | 存在时先保留现值 | 写回节流正在影响读写延迟或吞吐 |
read_ahead_kb | 按缓冲顺序读需求判断 | 随机小块读产生额外预读,或顺序读预读不足 |
nomerges | 先保留现值 | 合并收益与CPU开销失衡,需单独验证 |
max_sectors_kb | 不作为第一轮优化项 | 大块请求被拆分,影响吞吐或CPU成本 |
这里的“基线”是对照起点,不是所有服务器必须使用的统一数值。直接I/O、缓冲I/O、数据库WAL、对象存储后台整理,对这些参数的敏感度并不相同。
none不是完全没有排队。它省去I/O调度器层的额外排序,但请求仍经过blk-mq、驱动和控制器队列。
| 候选 | 适合优先比较的场景 | 不应预期的效果 |
|---|---|---|
none | 高并发直接I/O,应用自身已管理队列的本地NVMe负载 | 不保证P99最低,也不提供业务租户级公平性 |
mq-deadline | 随机读写混合,持续写入时需要保护读延迟 | 不会消除设备内部垃圾回收、固件或介质造成的长尾 |
kyber | 本机可用,并希望比较延迟目标驱动节流行为 | 不等于在任意NVMe上都能提高IOPS |
bfq | 更关注进程间公平性、交互响应的场景,且本机可用 | 通常不应作为高并发服务器NVMe的首个吞吐优化候选 |
第一轮通常比较none和mq-deadline即可。只有出现明确的延迟控制或公平性问题,再扩展其他候选,避免把测试矩阵无谓放大。
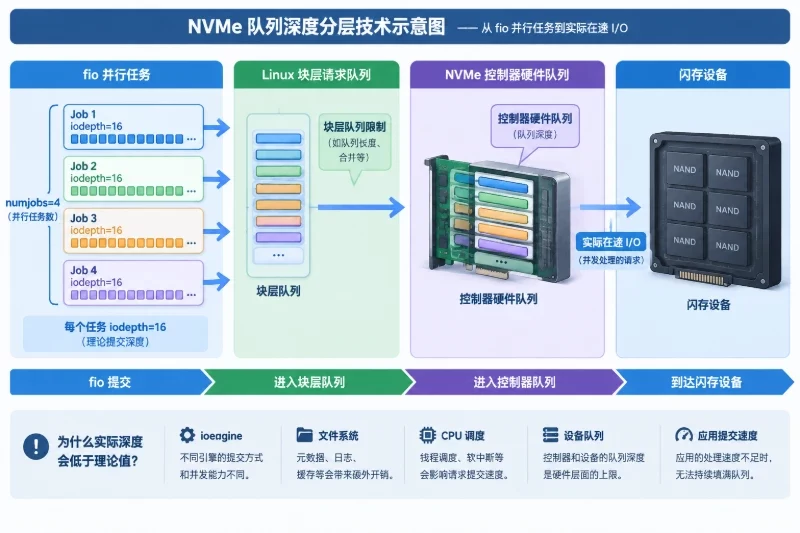
应用并发、块层请求资源和NVMe硬件队列不是同一个参数。
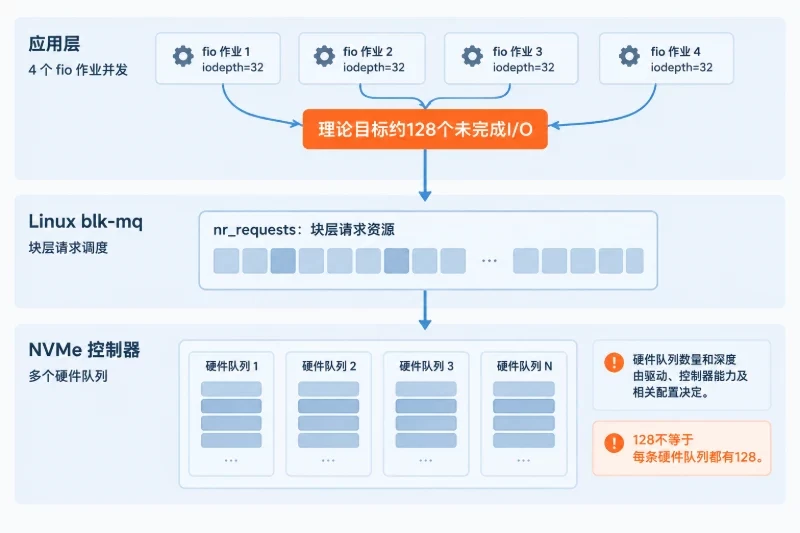
iodepth表示每个作业希望保持的未完成I/O数量,实际深度还受I/O引擎和运行条件影响。nr_requests涉及块层请求资源;在blk-mq下,它与调度器、标签分配及块层实现有关,不是整块SSD的统一并发上限。nr_requests值替代。例如,4个fio作业、每个iodepth=32,理论目标是约128个未完成请求,并不表示每条NVMe硬件队列都有128个请求。
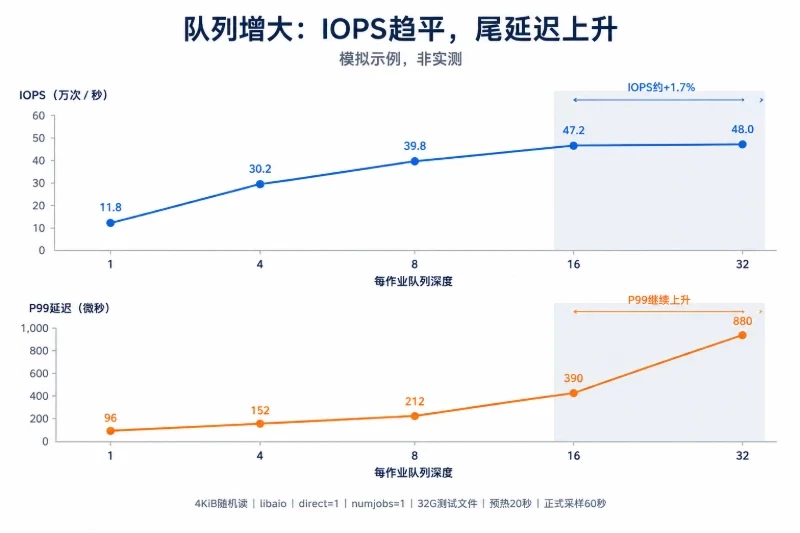
因此,不要因为SSD支持高IOPS,就直接把nr_requests改成1024或4096。队列更深可能增加吞吐,也可能只增加排队时间。
读取现值即可,不在第一轮同时修改:
for P in rq_affinity wbt_lat_usec nr_requests nomerges; do
  if [ -r "$Q/$P" ]; then
    printf '%s=' "$P"
    cat "$Q/$P"
  fi
done
rq_affinity常见取值中,0不施加该项完成CPU亲和策略,1倾向于提交CPU所在的CPU组,2更严格地面向提交CPU。它不是NVMe中断亲和性开关,也不能替代IRQ、NUMA和应用线程布局检查;实际完成路径仍受内核及驱动影响。
wbt_lat_usec存在时,表示块层写回节流使用的延迟目标;0表示关闭该机制,-1用于恢复默认设置。不要为了提高写IOPS而直接关闭:读写混合业务可能因此出现更差的读长尾,写入是否受其影响也取决于实际路径。
read_ahead_kb主要影响文件系统缓冲读取。使用direct=1的小块随机读测试,不能据此决定业务缓冲读的预读配置。
下面仅修改目标设备的调度器,不修改其他队列参数。执行前确认维护窗口和快照路径仍有效。
CANDIDATE=none

AVAILABLE=$(tr '[]' '  ' < "$Q/scheduler")
case " $AVAILABLE " in
  *" $CANDIDATE "*) ;;
  *) echo "目标调度器不可用"; exit 1 ;;
esac

printf '%s\n' "$CANDIDATE" | sudo tee "$Q/scheduler"
cat "$Q/scheduler"
若结果中的[none]已生效,再开始采集数据。比较mq-deadline时,将CANDIDATE改为mq-deadline,重复可用性检查、切换和验证。
切换失败时停止该轮操作,不要继续测试并把结果归到未生效的配置名下。
使用fio前,应在目标文件系统上准备一个独立、已完成写入、非稀疏、无人使用的测试文件。以下示例要求文件至少为16 GiB,其中GiB按二进制计算,16 GiB等于17,179,869,184字节。
不要使用数据库文件、虚拟机镜像或整块裸盘作为测试对象。不要让读测试因为文件不存在而临时创建数据,也不要把新建稀疏文件的读取结果当作SSD性能。
测试文件创建和预写入会占用容量、产生写流量,应单独安排并确认剩余空间。没有合适测试文件时,优先采集业务指标,不要临时对生产盘进行写压测。
以下命令只读测试文件,但仍可能争用设备带宽和CPU。fio需为I/O测试工具,且支持示例中的libaio引擎。
TESTFILE=/实际测试目录/nvme-read-test.bin

test -f "$TESTFILE" || { echo "测试文件不存在"; exit 1; }
test "$(stat -c %s "$TESTFILE")" -ge 17179869184 \
  || { echo "测试文件小于16 GiB"; exit 1; }

fio --name=nvme-randread \
    --filename="$TESTFILE" \
    --allow_file_create=0 \
    --readonly \
    --rw=randread \
    --bs=4k \
    --ioengine=libaio \
    --direct=1 \
    --iodepth=32 \
    --numjobs=4 \
    --size=16G \
    --time_based=1 \
    --runtime=60 \
    --ramp_time=10 \
    --group_reporting=1 \
    --lat_percentiles=1 \
    --percentile_list=50:95:99:99.9 \
    --output-format=json \
    --output="$SNAP/fio-${CANDIDATE}-1.json"
这里的60秒只是初筛示例,不足以证明设备长时间稳态表现。每个候选至少重复三次,分别保存结果,并在候选之间等待业务负载、温度和后台写回回到相近状态。
只读测试也不能回答混合写入时的调度效果。评估数据库或缓存落盘,应补充相同读写比例、块大小和持久化语义的测试。涉及写入时,只能使用可丢弃的独立测试文件,并明确覆盖范围;不要为了跑分关闭数据库同步写、文件系统屏障或其他持久性保护。
在另一终端采集同一时间窗口的数据。以下工具通常由发行版的sysstat包提供,缺失时使用本机对应的软件包管理方式安装。
iostat -x -y 5 18
mpstat -P ALL 5 18
重点检查:
iostat的读写await、平均排队长度和吞吐变化。fio JSON中可能使用lat_ns、clat_ns等字段,也可能因版本不同采用其他单位后缀,解析前必须确认单位。await是平均值,不能替代P99;NVMe的%util接近100%,也不能单独证明设备吞吐已经耗尽。
以下仅演示如何判断结果,并非任何型号的实测数据:
| 候选 | 4 KiB随机读IOPS | P99总延迟 | CPU开销 | 处理意见 |
|---|---|---|---|---|
none | 约520,000 | 0.90 ms | 较低 | 可作为吞吐基线 |
mq-deadline | 约490,000 | 0.68 ms | 略高 | 若业务重视长尾且吞吐足够,可继续验证 |
| 参数放大后的配置 | 约540,000 | 1.80 ms | 明显升高 | 吞吐小幅增加不足以抵消延迟恶化 |
先写明业务验收边界,再看测试结果。比如要求P99不超过1 ms,那么第三项即使IOPS更高,也不应保留。
当两个候选的差异小于多轮测试的自然波动,应视为没有足够证据支持变更,而不是把一次峰值当作优化成功。
如果返回Invalid argument,先重新读取queue/scheduler,确认候选存在。只有一个候选或接口不存在时,应核对设备层和驱动路径,不要强行修改。
如果返回Permission denied,先检查是否错误地使用了sudo echo ... > 文件。重定向由当前Shell执行,示例采用sudo tee就是为了避免这一问题。容器内没有宿主机块设备管理权限时,应到宿主机操作,不要扩大容器权限来绕过边界。
先检查实际I/O是否经过该设备,以及业务是否使用缓冲读取、用户态存储路径或远端限速卷。然后检查应用并发、CPU、cgroup I/O限制、云盘配额和测试文件布局。
若负载主要命中内存缓存,或瓶颈在应用锁、远端存储限速,调度器变化小是正常现象。这时增加队列深度只可能积累更多等待。
先恢复原调度器,观察业务是否回到原水平。若恢复后改善,再降低测试并发或使用更接近真实业务的读写比例复测。
重点区分三类原因:排队深度过高、读写竞争加剧,以及CPU完成处理集中。不能只凭延迟变差就立即修改rq_affinity、关闭WBT或调整IRQ;这些应作为后续独立实验。
此时优先检查温度、设备健康、空闲容量和后台写入。可先读取内核日志:
sudo journalctl -k --since "-15 min" --no-pager
如果安装了nvme-cli,并已确认目标命名空间所属控制器,可读取对应健康日志:
sudo nvme smart-log /dev/nvme0
示例控制器路径不能直接照搬,须按本机映射替换。温度上升、设备重置、超时和介质错误属于不同问题;出现I/O错误时应停止压测并进入存储故障处理流程,而不是继续寻找“更快”的调度器。
本轮排查不应加入格式化、固件升级、设备重置或安全擦除等操作。
写入sysfs的设置通常不会跨重启保留。不要直接用可能变化的nvme0n1编号永久匹配业务盘。
先读取设备属性:
udevadm info --query=property --path="/sys/class/block/$DEV"
下面以本机确实存在且已确认唯一的ID_WWN为例。若该属性不存在,不要猜测值;应选择本机可核验的稳定标识。多路径、克隆磁盘和多命名空间场景需额外确认规则匹配范围。
创建规则前,检查是否已有调度器配置或自动调优服务。若目标规则文件已存在,先备份并人工合并,不要直接覆盖。
在新建的/etc/udev/rules.d/99-a5-nvme-scheduler.rules中写入:
ACTION=="add|change", SUBSYSTEM=="block", ENV{DEVTYPE}=="disk", ENV{ID_WWN}=="替换为本机核验过的完整ID_WWN", TEST=="queue/scheduler", ATTR{queue/scheduler}="none"
将none替换为已通过验收的候选。该规则只应匹配预期磁盘,不应扩大为所有NVMe设备。
重新加载规则,并只对目标设备触发事件:
sudo udevadm control --reload-rules
sudo udevadm trigger --action=change "/sys/class/block/$DEV"
sudo udevadm settle
cat "$Q/scheduler"
规则重载本身不会修改现有设备,定向触发才会应用规则。触发change还可能运行匹配该设备的其他规则,因此仍应在批准的变更窗口执行。
先停用本次新建的规则,或恢复修改前的规则备份,并重新加载udev规则;否则后续事件可能再次应用新配置。仅当该文件确实由本次操作新建时,可执行:
sudo mv /etc/udev/rules.d/99-a5-nvme-scheduler.rules \
  /etc/udev/rules.d/99-a5-nvme-scheduler.rules.disabled

sudo udevadm control --reload-rules
随后从配置快照恢复原调度器:
OLD=$(cat "$SNAP/scheduler.active")
test -n "$OLD" || { echo "快照中没有有效调度器"; exit 1; }

printf '%s\n' "$OLD" | sudo tee "$Q/scheduler"
cat "$Q/scheduler"
停用规则不会自动恢复运行态;上述两步都需要完成。如果另行修改过nr_requests、rq_affinity或wbt_lat_usec,也应逐项按快照恢复并读取核验,而不是写入网上找到的“默认值”。
高IOPS NVMe配置的有效结果,不是队列参数更大或调度器名字更新,而是在相同负载下满足吞吐目标、没有不可接受的长尾和CPU代价。若当前配置已经达到这些条件,且候选方案没有稳定改善,保留现状就是合理的验收结果。