

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


“百万级随机 IOPS”通常是存储设备在特定块大小、队列深度和并发线程下得到的峰值,不等于网站每秒能处理百万次请求。要测试 960G NVMe SSD 香港服务器的站点读写性能,应把测试拆成三层:先测 NVMe 存储本身,再测文件系统与同步写入,最后用接近真实网站访问和写入流程的业务负载验证。只有三层结果能够相互对应,才能判断高 IOPS 是否真正转化为较低的页面延迟和更高的并发承载能力。
实际操作时,至少要同时记录 4K 随机读、4K 随机写、混合读写、队列深度、并发数、吞吐量、平均延迟、P95/P99 延迟、CPU、内存、I/O 等待和错误率。测试结果不应只写“达到多少 IOPS”,而要写清测试节点、时间、系统、磁盘使用率、fio 参数、样本时长和业务负载边界。
IOPS表示每秒完成的存储操作次数,网站请求则是一次完整的 HTTP 请求、页面渲染或业务事务。一次动态页面请求可能包含:
因此,网站每秒 100 个请求,并不一定只产生 100 IOPS。反过来,存储测试得到 100 万 IOPS,也不代表网站可以处理 100 万次请求。
4K 随机 I/O 的吞吐量可以这样换算:
吞吐量 = IOPS × 每次 I/O 的数据量
以 1,000,000 次/秒、每次 4KiB 为例:
这说明百万级 4K IOPS往往需要较高的并发队列。它可能是在较高队列深度下测出的随机读峰值,而普通网站的小并发、低队列请求未必能达到同样的数字。
| 测试层级 | 主要目的 | 重点观察指标 |
|---|---|---|
| 存储设备层 | 观察 NVMe 在不同队列和并发下的极限能力 | IOPS、吞吐量、P50/P95/P99 延迟 |
| 文件系统层 | 判断文件系统、挂载方式和同步写入对结果的影响 | await、I/O 利用率、同步写延迟、写入稳定性 |
| 站点业务层 | 判断真实页面和业务事务的承载能力 | 请求延迟、RPS、错误率、数据库等待、CPU 和内存 |
存储层测试适合回答“这块盘在给定参数下能做到什么程度”,业务层测试则回答“这个网站在给定访问模式下能稳定处理多少请求”。两者不能相互替代。
每次测试前先建立一份环境记录。960G 是标称容量,系统实际可用空间还会受到分区、文件系统、预留空间和已有数据影响。磁盘使用率不同,后台垃圾回收和写放大情况也可能不同。
| 项目 | 需要记录的内容 |
|---|---|
| 服务器 | 960G NVMe SSD 香港服务器,CPU 核数、内存容量 |
| 操作系统 | 发行版、内核版本、文件系统类型 |
| 存储状态 | 挂载点、可用空间、已使用比例、测试文件大小 |
| 测试工具 | fio 版本、监控工具版本、业务压测工具版本 |
| 测试时间 | 开始时间、结束时间、时区 |
| 访问条件 | 压测端位置、连接方式、并发数、目标 RPS |
| 网站状态 | 是否有真实访问、缓存状态、后台任务、备份任务 |
| 测试方式 | 文件测试、独立测试盘、测试环境或生产低峰期 |
可以先使用以下命令核对基础信息。命令只读取系统状态,不会清理缓存,也不会修改网站数据。
uname -a
lscpu
free -h
df -hT
findmnt -T /srv/bench
fio --version
/srv/bench只是示例测试目录,实际使用前应替换为单独的测试路径,并确认该路径不是网站数据目录、数据库数据目录或日志目录。
随机写测试会产生持续 I/O,并可能影响网站响应、数据库提交和日志落盘。安全顺序应当是:
fio 指向数据库原始设备;在生产盘上直接对原始块设备执行随机写,可能覆盖分区或业务数据。除非已经完成完整备份、明确影响范围并具备重建和回滚条件,否则不应采用这种方式。
测试文件太小,可能只覆盖很小的地址范围,无法反映实际 SSD 使用状态;测试文件过大,又可能挤压网站缓存和数据库空间。一般可以按以下原则选择:
以 960G 标称容量的服务器为例,64G 测试文件可以作为演示值,但不代表适合所有站点。若实际数据库活跃数据为 150G,仅用 1G 或 4G 文件测试,结果可能过于理想化。
| 项目 | 建议测试值 | 作用 |
|---|---|---|
| 块大小 | 4K、8K、16K | 对应数据库、日志和小文件访问 |
| 读写模式 | randread、randwrite、randrw | 分别观察读、写和混合负载 |
| 混合比例 | 70%读/30%写、50%读/50%写 | 模拟动态站点和事务型业务 |
| 单线程队列 | QD1、QD4 | 接近低并发和单请求行为 |
| 总队列 | QD16、QD64、QD128、QD256 | 观察并发提高后的峰值能力 |
| 并发作业 | 1、4、8 | 判断多线程扩展能力 |
| 测量时间 | 3至5分钟起步 | 避免只取瞬时峰值 |
| 重复次数 | 每组至少3次 | 观察批次波动和稳定性 |
总队列深度大致等于 iodepth × numjobs。例如 iodepth=32、numjobs=8,总队列约为 256。此时测得的百万级 IOPS,不能直接与 iodepth=1 的网站请求相比较。
下面的命令用于演示 4K 随机读取。它使用测试目录和合成文件,不应指向网站真实数据。
先准备测试目录,并确认剩余空间足够:
mkdir -p /srv/bench/fio-run-01
df -hT /srv/bench/fio-run-01
findmnt -T /srv/bench/fio-run-01
为了让随机读取有实际数据可读,可以先对合成文件进行预填充。下面示例中 size=8G 是每个作业的文件大小,8 个作业合计约 64G。
fio \
  --name=fill-site-set \
  --directory=/srv/bench/fio-run-01 \
  --filename_format='site-set.$jobnum' \
  --size=8G \
  --rw=write \
  --bs=1M \
  --ioengine=libaio \
  --direct=1 \
  --iodepth=16 \
  --numjobs=8 \
  --group_reporting=1
随后执行 4K 随机读取:
fio \
  --name=randread-4k-qd256 \
  --directory=/srv/bench/fio-run-01 \
  --filename_format='site-set.$jobnum' \
  --size=8G \
  --rw=randread \
  --bs=4k \
  --ioengine=libaio \
  --direct=1 \
  --iodepth=32 \
  --numjobs=8 \
  --runtime=300 \
  --ramp_time=60 \
  --time_based=1 \
  --group_reporting=1 \
  --randrepeat=0 \
  --percentile_list=50:90:95:99:99.9
这里有几个关键参数:
--direct=1尽量绕开操作系统页面缓存,减少“内存缓存被误认为磁盘性能”的情况;--iodepth=32表示每个作业保持较深的请求队列;--numjobs=8表示并行运行 8 个作业;--runtime=300表示测量阶段持续 300 秒;--ramp_time=60用于预热,预热阶段不作为主要统计窗口;--percentile_list要求输出多个延迟百分位;--group_reporting=1将多个作业合并显示,便于查看总 IOPS。如果当前系统不支持 libaio,先使用以下命令确认可用 I/O 引擎:
fio --enghelp
再根据系统实际支持情况选择可用引擎,不要直接照搬不兼容的参数。
随机读取只能说明读取能力。网站写入通常涉及事务提交、日志同步和数据持久化,必须单独测试。
随机写可以将上面命令中的关键参数改为:
fio \
  --name=randwrite-4k-q d \
  --directory=/srv/bench/fio-run-01 \
  --filename_format='site-set.$jobnum' \
  --size=8G \
  --rw=randwrite \
  --bs=4k \
  --ioengine=libaio \
  --direct=1 \
  --iodepth=16 \
  --numjobs=8 \
  --runtime=300 \
  --ramp_time=60 \
  --time_based=1 \
  --group_reporting=1 \
  --randrepeat=0 \
  --percentile_list=50:90:95:99:99.9
上面示例中的作业名称出现了空格,实际执行时应使用不含空格的名称,例如:
fio \
  --name=randwrite-4k-qd128 \
  --directory=/srv/bench/fio-run-01 \
  --filename_format='site-set.$jobnum' \
  --size=8G \
  --rw=randwrite \
  --bs=4k \
  --ioengine=libaio \
  --direct=1 \
  --iodepth=16 \
  --numjobs=8 \
  --runtime=300 \
  --ramp_time=60 \
  --time_based=1 \
  --group_reporting=1 \
  --randrepeat=0 \
  --percentile_list=50:90:95:99:99.9
混合读写可以使用 70%读取、30%写入的比例:
fio \
  --name=randrw-4k-70r30w \
  --directory=/srv/bench/fio-run-01 \
  --filename_format='site-set.$jobnum' \
  --size=8G \
  --rw=randrw \
  --rwmixread=70 \
  --bs=4k \
  --ioengine=libaio \
  --direct=1 \
  --iodepth=16 \
  --numjobs=8 \
  --runtime=300 \
  --ramp_time=60 \
  --time_based=1 \
  --group_reporting=1 \
  --randrepeat=0 \
  --percentile_list=50:90:95:99:99.9
这些命令测试的是异步随机 I/O。若站点写入依赖事务提交,还要增加同步写场景,例如使用 fsync=1 或 fdatasync=1,并将结果单独标注为“同步写延迟”。同步写通常不能用异步随机写的 IOPS 代替。
网站读取容易受到页面缓存、对象缓存和数据库缓存影响,应分别测试:
不能为了得到“冷缓存”结果而在生产环境频繁执行清理系统缓存的命令。清理缓存会影响整台服务器上的其他服务,并不能完全复现真实访问。更稳妥的方式是在隔离测试环境中准备可控数据集,分别记录缓存状态。
网站写入测试不能只上传一个大文件。更有参考价值的场景包括:
如果业务本身要求提交后数据不能丢失,应重点观察同步提交后的请求延迟,而不是只看后台异步写入的吞吐量。
只把并发数设置得很高,容易制造队列堆积,最后得到的是“极限压垮点”,而不是可用容量。更合理的测试顺序是:
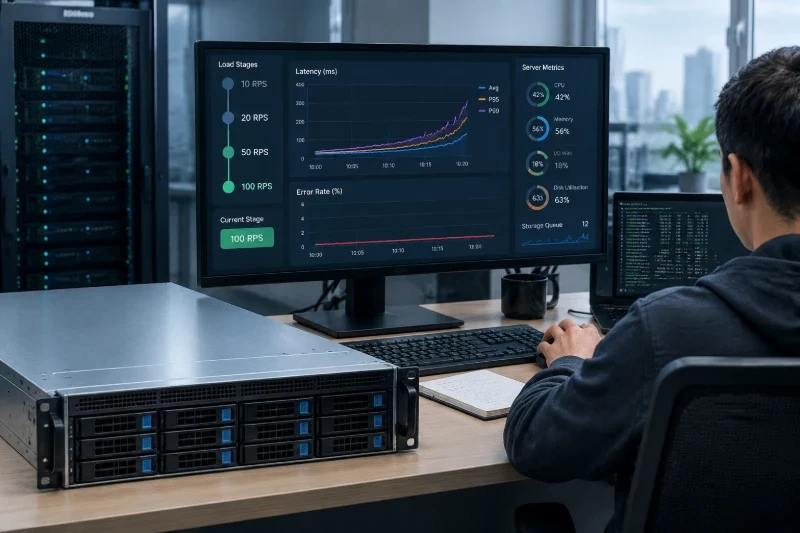
压测端的位置和连接路径要固定。远程网络往返时间应单独记录,不能把网络延迟直接归因于 NVMe。存储层测试应在服务器本机执行,业务层测试则要同时记录客户端到服务器的网络耗时。
| 指标 | 说明 | 主要用途 |
|---|---|---|
| IOPS | 每秒完成的 I/O 次数 | 判断操作次数能力 |
| 吞吐量 | 每秒传输的数据量 | 判断大块读写能力 |
| 平均延迟 | 所有请求的平均完成时间 | 了解总体水平,但容易掩盖尾延迟 |
| P95/P99/P99.9 | 较慢请求的延迟 | 判断用户偶发卡顿和高并发稳定性 |
| I/O 利用率 | 存储设备是否长期繁忙 | 判断是否接近设备饱和 |
await | I/O 从提交到完成的平均等待时间 | 观察设备和队列等待 |
| CPU 使用率 | 用户态、内核态和 I/O 等待 | 排除 CPU 瓶颈 |
| 内存和缓存 | 可用内存、缓存命中情况 | 判断结果是否被内存放大 |
| 请求错误率 | 超时、5xx、连接失败等 | 判断业务是否仍然可用 |
| 业务 RPS | 每秒完成的有效请求数 | 评估站点实际承载能力 |
| 同步提交延迟 | fsync或事务提交耗时 | 判断写入持久化性能 |
可以使用以下监控命令观察服务器状态。若系统未安装相应工具,应先确认工具来源和版本,不要在生产环境中临时执行未经验证的安装操作。
iostat -x 1
vmstat 1
pidstat -d 1
重点关注以下组合:
%util持续接近满载,同时 await和 P99 延迟上升:存储设备或队列可能已经饱和;wa较高、CPU其他指标不高:线程主要在等待 I/O;下面是一组仅用于说明阅读方法的示例数据,不代表该服务器的实际测试结果:
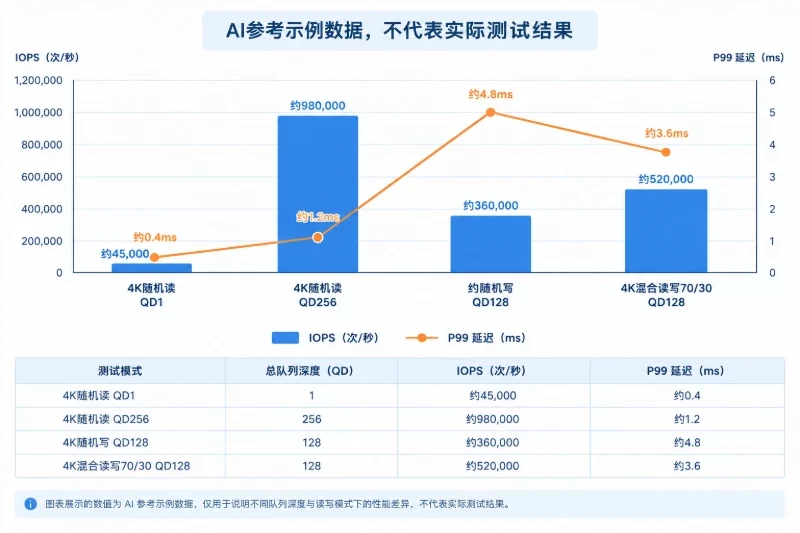
| 测试场景 | 总队列深度 | 示例 IOPS | 示例 P99 延迟 | 可以说明什么 |
|---|---|---|---|---|
| 4K 随机读,1 作业 | 1 | 约 45,000 | 约 0.4ms | 接近单请求、低队列能力 |
| 4K 随机读,8 作业 | 256 | 约 980,000 | 约 1.2ms | 高并发队列下的峰值能力 |
| 4K 随机写,8 作业 | 128 | 约 360,000 | 约 4.8ms | 写入能力和写尾延迟 |
| 4K 混合读写,70/30 | 128 | 约 520,000 | 约 3.6ms | 混合业务下的综合表现 |
如果报告只写“随机读接近百万 IOPS”,读者无法知道这个数字来自 QD1 还是 QD256,也不知道是读、写还是混合场景。正确表达应类似于:
在 4K 随机读、8 个并发作业、每个作业队列深度为 32、总队列深度约 256 的条件下,测试输出约为某个 IOPS 区间;该结果不代表低队列网站请求或同步写入能力。
随着队列深度提高,常见变化是:
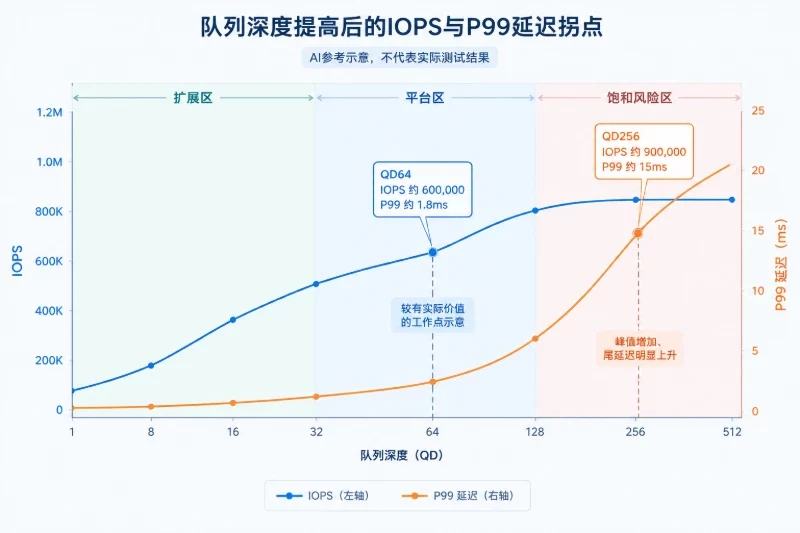
第 3 和第 4 阶段之间通常就是设备从扩展区进入饱和区的位置。网站的可用容量不应直接取最高 IOPS,而应取延迟仍在业务目标内的工作点。
例如某组测试在 QD64 时为 600,000 IOPS、P99 为 1.8ms,在 QD256 时为 900,000 IOPS、P99 升至 15ms。若网站更看重页面响应,那么 QD64 的工作点可能比 QD256 更有实际价值,即使前者的峰值 IOPS较低。
以下情况需要特别复核:
direct=0远高于direct=1:结果可能主要反映页面缓存,而不是 SSD;每组测试至少保留三次结果。可以用“最大值与最小值的差异相对于中位数的比例”观察波动。如果差异达到约 10%或更高,应先排查后台任务、磁盘空间、温度、缓存状态和并发干扰,再决定是否取平均值。
网站容量估算应从业务操作数开始,而不是从“百万 IOPS”倒推。
例如,一个动态请求平均产生 6 次随机读和 1 次随机写,目标流量为 100 RPS,则理论存储操作量约为:
这只是业务层估算。缓存命中、数据库批量读取、预取、写缓冲和事务合并都会改变实际 I/O 数量,因此应使用监控或应用追踪数据校正。
如果目标是 200 RPS、平均响应时间 150ms,则同时在处理中的请求量大约为:
200 × 0.15 = 30 个并发请求
这并不表示存储队列一定是 30,因为一次请求可能包含多个并行查询,但可以帮助确定业务压测的初始并发范围。
实际决策可以按以下边界进行:
余量应根据业务波动、备份任务和增长速度确定。刚开始规划时,可以把目标工作点放在明显低于延迟拐点的位置,再通过持续监控调整,而不是直接以测试中的最高 IOPS 作为上线容量。
960G NVMe SSD 香港服务器的性能结果会随数据量、空间使用率、测试时长和后台任务变化。以下情况发生后,建议重新测试:
复测时应保持以下条件尽量一致:
一份合格的性能记录,不应只有一个“百万级 IOPS”数字,而应包含“测试条件—指标结果—业务表现—限制因素”四部分。对站点读写性能而言,低队列延迟、同步写 P99、混合负载稳定性和目标 RPS下的错误率,通常比脱离业务场景的峰值随机 IOPS更能说明 960G NVMe SSD 香港服务器是否适合当前网站。


