

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


Redis Cluster 写入变慢时,单看 CPU、连接数或磁盘利用率都容易误判。更可靠的判断方式是把同一分钟内的写入延迟、AOF/RDB 状态、磁盘 await 与队列、内存和连接建立速率放在一起比较:如果写入 p99 上升时恰好出现 AOF 重写或 RDB 快照,且磁盘等待和队列同步升高,优先怀疑持久化 I/O;如果磁盘平稳但连接数和新建连接速率突然增加,则应先检查连接池和连接风暴。
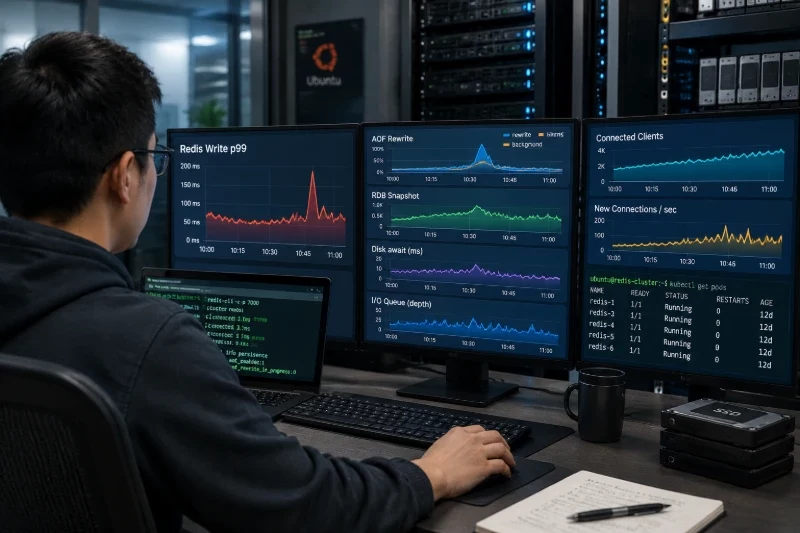
下面以 Ubuntu 22.04/24.04、Redis 7.x、3 个主节点加 3 个副本节点为例。命令中的 IP、密码和路径需要替换为实际值。生产环境调整配置前,应先备份配置文件和持久化目录,并且一次只处理一个节点,避免同时降低集群可用副本数。
Redis Cluster 自身已经提供分片、主从复制和主节点故障转移能力,典型架构是 3 个主节点负责 16384 个哈希槽,3 个副本节点分别对应主节点;Redis 客户端支持 Cluster 拓扑发现和 MOVED、ASK 重定向;每个 Redis 节点同时开放客户端端口 6379 和集群总线端口 16379。
Sentinel 面向的是“一个主节点加多个副本”的非 Cluster 架构。它可以监控独立 Redis 主从组并触发故障转移,但不能替代 Redis Cluster 的槽位管理,也不建议让 Sentinel 对 Redis Cluster 主节点执行另一套独立故障转移。
因此,下面两种架构不要混为一谈:
| 架构 | 适用场景 | 故障转移组件 | 客户端要求 |
|---|---|---|---|
| Redis Cluster | 需要分片和横向扩展 | Cluster 内置故障转移 | 必须使用 Cluster-aware 客户端 |
| Redis 主从 + Sentinel | 数据量可由单主节点承载,不需要分片 | Sentinel | 使用 Sentinel-aware 客户端 |
| Cluster + 独立 Sentinel | 同一环境中同时运行两类 Redis 服务 | Cluster 管理 Cluster,Sentinel 管理独立 Redis | 两类客户端分别连接对应服务 |
如果业务明确要求 Redis Cluster,优先把 Cluster 的节点状态、复制状态和持久化状态做好,不要把 Sentinel 当成 Cluster 的第二层高可用开关。
每个 Cluster 节点应使用相同的大版本,先确认系统和 Redis 版本:
lsb_release -a
redis-server --version
redis-cli --version
systemctl status redis-server --no-pager
如果系统尚未安装基础工具,可以执行:
sudo apt update
sudo apt install -y redis-server redis-tools sysstat
Ubuntu 仓库中的 Redis 版本可能因系统版本和软件源不同而变化,安装后应以 redis-server --version 的实际结果为准。不要在同一集群中随意混用不兼容的大版本。
确认数据盘空间和 inode:
df -h /var/lib/redis
df -i /var/lib/redis
free -h
swapon --show
RDB 快照和 AOF 重写都可能在原有数据之外产生临时文件,磁盘不能只按当前数据集大小预留。尤其是开启 AOF 后,重写期间还要考虑新旧 AOF 文件并存、RDB 前缀和复制缓冲区占用。
Redis 节点只应对业务网段开放,不要把 6379 和 16379 暴露给不受信任的公网。使用 UFW 前先保存当前规则,防止误删现有远程管理规则:
sudo ufw status numbered | tee "$HOME/ufw-before-redis-$(date +%F-%H%M%S).txt"
以下规则仅适用于业务网段为 10.0.0.0/24 的示例环境:
sudo ufw allow from 10.0.0.0/24 to any port 6379 proto tcp
sudo ufw allow from 10.0.0.0/24 to any port 16379 proto tcp
调整防火墙可能立即影响客户端和集群节点通信。回滚时应使用实际添加过的规则:
sudo ufw delete allow from 10.0.0.0/24 to any port 6379 proto tcp
sudo ufw delete allow from 10.0.0.0/24 to any port 16379 proto tcp
Redis 配置至少要包含实际绑定地址、集群模式、集群总线端口和持久化参数。下面是单节点配置片段,不是可直接覆盖整个配置文件的完整模板:
bind 127.0.0.1 10.0.0.11
protected-mode yes
port 6379

cluster-enabled yes
cluster-config-file nodes-6379.conf
cluster-node-timeout 5000
cluster-announce-ip 10.0.0.11
cluster-announce-port 6379
cluster-announce-bus-port 16379

dir /var/lib/redis
dbfilename dump.rdb

appendonly yes
appendfilename "appendonly.aof"
appendfsync everysec
aof-use-rdb-preamble yes

save 900 1
save 300 10
save 60 10000

requirepass
masterauth
cluster-config-file 必须位于 Redis 可写目录中。cluster-announce-ip 要填写其他节点和客户端能够访问的地址,不能只填写 127.0.0.1。
如果是新建、没有业务数据的 6 个空实例,可以在其中一个节点执行集群创建:
redis-cli --cluster create \
  10.0.0.11:6379 \
  10.0.0.12:6379 \
  10.0.0.13:6379 \
  10.0.0.14:6379 \
  10.0.0.15:6379 \
  10.0.0.16:6379 \
  --cluster-replicas 1 \
  --cluster-yes
该命令会分配哈希槽并建立主从关系,只适用于新实例。不要在已有生产数据的节点上直接执行。若创建错误,回滚应使用预先保存的空实例配置和数据目录,不能把 CLUSTER RESET、删除节点配置文件或删除 AOF/RDB 文件当作常规回滚动作。
创建后检查:
redis-cli -h 10.0.0.11 -p 6379 -a '' cluster info
redis-cli -h 10.0.0.11 -p 6379 -a '' cluster nodes
redis-cli --cluster check 10.0.0.11:6379 -a ''
生产环境中不建议把密码直接写在命令行,因为可能出现在 Shell 历史或进程信息中。可使用 Redis ACL、受控环境变量或 redis-cli --askpass,并根据实际 Redis 版本确认参数支持情况。
不要先执行一次 iostat,再隔十分钟查看 Redis 信息。两个时间点不一致时,无法证明它们属于同一个故障。建议在写入变慢期间连续采集 5~10 分钟,每 1 秒或 5 秒记录一次,并把应用侧的 p50、p95、p99、超时率和错误率使用同一时间戳保存。
Redis Cluster 的写入并不是平均落到所有节点。某个热点键、固定哈希标签或业务访问分布,都可能使一个主节点先达到瓶颈。先查看 Cluster 状态:
redis-cli -h 10.0.0.11 -p 6379 -a '' cluster info
redis-cli -h 10.0.0.11 -p 6379 -a '' cluster nodes
重点关注 cluster_state:ok 是否持续、每个主节点负责的槽位是否正常、是否存在 fail、handshake、noaddr 等状态、主节点和副本节点的连接状态,以及业务客户端是否频繁收到 MOVED 或 ASK。
对每个主节点分别采集信息,不要只看第一个节点:
redis-cli -h 10.0.0.11 -p 6379 -a '' info clients
redis-cli -h 10.0.0.11 -p 6379 -a '' info persistence
redis-cli -h 10.0.0.11 -p 6379 -a '' info stats
redis-cli -h 10.0.0.11 -p 6379 -a '' info memory
redis-cli -h 10.0.0.11 -p 6379 -a '' info replication
为了减少输出,可以提取关键字段:
redis-cli -h 10.0.0.11 -p 6379 -a '' info persistence \
  | egrep 'rdb_bgsave_in_progress|rdb_last_bgsave_status|rdb_last_bgsave_time_sec|latest_fork_usec|aof_enabled|aof_rewrite_in_progress|aof_rewrite_scheduled|aof_last_bgrewrite_status|aof_pending_bio_fsync|aof_delayed_fsync'

redis-cli -h 10.0.0.11 -p 6379 -a '' info clients \
  | egrep 'connected_clients|blocked_clients|tracking_clients|rejected_connections'

redis-cli -h 10.0.0.11 -p 6379 -a '' info memory \
  | egrep 'used_memory:|used_memory_rss:|used_memory_peak:|mem_fragmentation_ratio|allocator_frag_ratio'
先确认 Redis 进程:
pgrep -a redis-server
然后在目标节点执行:
vmstat 1 10
iostat -xz 1 10
pidstat -d -p "$(pgrep -xo redis-server)" 1 10
几个指标要结合解释:
| 指标组合 | 更可能的含义 | 不能单独证明的事情 |
|---|---|---|
写入 p99 上升、aof_rewrite_in_progress:1、await 和 aqu-sz 同步上升 | AOF 重写与业务写入争用磁盘 | 不能仅凭 %util 证明 Redis 是唯一 I/O 来源 |
rdb_bgsave_in_progress:1、latest_fork_usec 增大、内存可用量下降 | RDB fork、写时复制和快照 I/O 影响延迟 | fork 时间短不代表快照写盘没有竞争 |
connected_clients 稳定,但 blocked_clients 增大 | 阻塞命令、网络读取或客户端处理变慢 | 不能直接归因于连接池大小 |
connected_clients 短时间暴涨、total_connections_received 增长很快 | 连接风暴或连接池失效 | 高连接数本身不一定是故障 |
| 单一主节点 CPU、写入量和延迟明显高于其他主节点 | 热点键、槽位倾斜或客户端分布不均 | 不能先假设是磁盘慢 |
await 平稳、持久化没有活动,但客户端 p99 变高 | 网络往返、命令执行时间、客户端排队或重定向增多 | 不能只看 Redis 服务端 CPU |
iostat 中的 %util 接近 100% 只能说明设备忙,SSD 或云盘在高并发下仍可能保持可接受延迟;真正有价值的是 await、aqu-sz、%util 是否与 Redis 写入 p99 在同一时间上升。vmstat 的 wa 也可能包含系统其他进程产生的 I/O,必须和 pidstat、Redis 持久化字段交叉确认。
AOF 或 RDB 与磁盘等待同步上升。 AOF 的 appendfsync everysec 通常能在数据安全性和写入延迟之间取得平衡,但它并不意味着磁盘永远不会影响主线程。AOF 重写、操作系统缓存回写、磁盘队列堆积和后台同步都可能把延迟传导给 Redis。
例如,一组用于说明判断过程的监控数据如下:
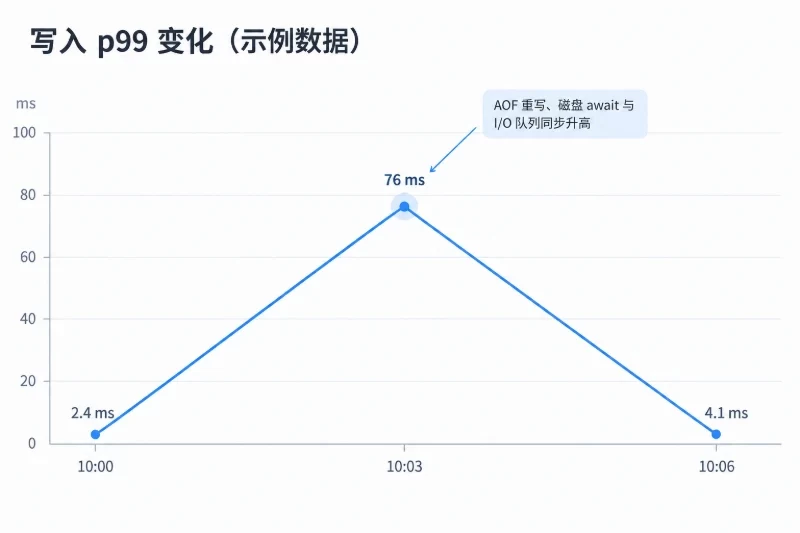
| 时间 | 写入 p99 | AOF 重写 | 磁盘 await | I/O 队列 | 连接数 |
|---|---|---|---|---|---|
| 10:00 | 2.4 ms | 0 | 1.8 ms | 0.3 | 820 |
| 10:03 | 76 ms | 1 | 34 ms | 5.8 | 835 |
| 10:06 | 4.1 ms | 0 | 2.2 ms | 0.4 | 829 |
这组数据中,连接数没有明显变化,但写入延迟只在 AOF 重写和磁盘队列升高时恶化,持久化 I/O 是优先调查方向。应继续检查:
redis-cli -h 10.0.0.11 -p 6379 -a '' info persistence
redis-cli -h 10.0.0.11 -p 6379 -a '' latency latest
redis-cli -h 10.0.0.11 -p 6379 -a '' slowlog get 20
SLOWLOG 记录的是 Redis 执行命令本身较慢的情况,不包括客户端排队、网络往返和连接建立时间。若 SLOWLOG 没有对应记录,但应用 p99 很高,不能据此排除 AOF 或网络等待。
连接数和新建连接速率先变化。 connected_clients 是当前连接数,不能代表单位时间内创建了多少连接。连接池失效时,连接数可能在几秒内大量增长,即使最终连接数没有超过 maxclients,频繁 TCP 建连、认证、拓扑发现和连接关闭也会增加事件循环压力。
同时看这些字段:
redis-cli -h 10.0.0.11 -p 6379 -a '' info clients
redis-cli -h 10.0.0.11 -p 6379 -a '' info stats \
  | egrep 'total_connections_received|rejected_connections|instantaneous_input_kbps|instantaneous_output_kbps'
可以用操作系统连接数做辅助核对:
ss -Htan sport = :6379 | wc -l
典型的连接风暴表现是 connected_clients 快速上升,total_connections_received 增长速率明显高于正常水平,rejected_connections 开始增加或客户端出现连接超时,CPU 使用率和网络包处理量上升,而磁盘 await 没有同步变化;应用侧 p99 和错误率也会先于持久化指标恶化。
处理方向不是简单地把 maxclients 调大,而是让客户端复用连接,并为每个 Cluster 节点设置有上限的连接池。Cluster 客户端通常需要根据拓扑为多个节点维护连接,连接池总量应按业务并发、命令执行时间和节点数估算,而不是按请求量一比一创建连接。
内存压力与 fork 同时出现。 RDB 快照和 AOF 重写都可能使用 fork 创建子进程。父进程继续处理请求时,如果内存页发生写入,会触发写时复制,产生额外内存和 I/O 压力。
需要一起观察:
redis-cli -h 10.0.0.11 -p 6379 -a '' info memory \
  | egrep 'used_memory:|used_memory_rss:|used_memory_peak:|mem_fragmentation_ratio'

redis-cli -h 10.0.0.11 -p 6379 -a '' info persistence \
  | egrep 'latest_fork_usec|rdb_last_cow_size|aof_last_cow_size|rdb_bgsave_in_progress|aof_rewrite_in_progress'

free -h
vmstat 1 10
如果快照开始后 latest_fork_usec、rdb_last_cow_size 或 aof_last_cow_size 增大,同时可用内存下降并出现 swap 活动,写入变慢可能是 fork 和内存回收共同作用。此时盲目增加连接数会进一步放大内存压力。
只有一个主节点慢。 如果 3 个主节点中只有一个节点出现高写入 p99,而该节点的 CPU、网络输入、命令量或内存增长也明显更高,应排查热点键,是否大量使用相同哈希标签把多个键固定到同一个槽,客户端是否只连接或偏向某个节点,该节点是否恰好承担了更多 AOF 重写、RDB 快照或副本同步,以及节点间槽位和数据量是否明显不均。
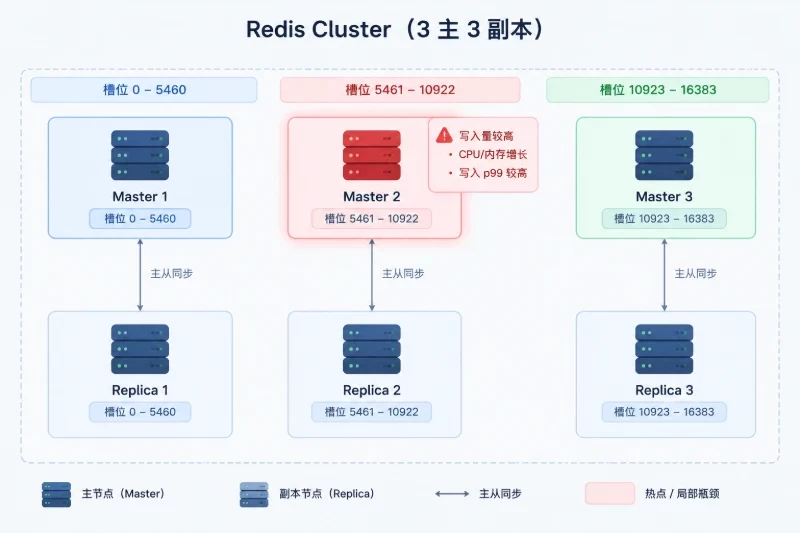
这类现象不能通过统一修改所有节点的 appendfsync 来解决。应先在应用侧记录命令类型、键空间分布和各节点请求量,并单独对热点主节点做验证。
一个常见的平衡配置如下:
appendonly yes
appendfsync everysec
aof-use-rdb-preamble yes

save 900 1
save 300 10
save 60 10000
参数含义和边界如下:
appendonly yes:启用 AOF,适合需要较小数据丢失窗口的场景;appendfsync everysec:通常比 always 更适合持续写入,系统故障时可能丢失最近约一秒左右的 AOF 追加内容;appendfsync always:持久化确认更严格,但每次写入都可能受 fsync 延迟影响;appendfsync no:由操作系统决定刷盘时机,延迟可能较低,但数据安全性依赖操作系统和存储设备;aof-use-rdb-preamble yes:AOF 重写时使用 RDB 前缀,通常有利于缩短重写文件加载时间;no-appendfsync-on-rewrite yes:可降低 AOF 重写期间的 fsync 竞争,但会扩大重写期间的持久化风险窗口,应根据数据安全要求决定,不能作为无条件优化项。修改生产节点前先备份配置:
sudo cp -a /etc/redis/redis.conf \
  "/etc/redis/redis.conf.$(date +%F-%H%M%S).bak"
然后编辑配置并逐节点重启:
sudo editor /etc/redis/redis.conf
sudo systemctl restart redis-server
sudo systemctl status redis-server --no-pager
重启单个节点会使该节点短暂不可用,并可能触发副本接管。确认 Cluster 有健康副本、集群状态为 ok 后再操作;不要同时重启同一主节点及其唯一副本。
重启后检查:
redis-cli -h 10.0.0.11 -p 6379 -a '' ping
redis-cli -h 10.0.0.11 -p 6379 -a '' cluster info
redis-cli -h 10.0.0.11 -p 6379 -a '' info persistence \
  | egrep 'aof_enabled|aof_last_write_status|aof_last_bgrewrite_status|rdb_last_bgsave_status'
如果出现启动失败、AOF 加载错误或权限错误,先查看日志和磁盘状态:
sudo journalctl -u redis-server -n 100 --no-pager
df -h /var/lib/redis
df -i /var/lib/redis
sudo ls -ld /var/lib/redis
不要直接删除 AOF、RDB 或 nodes-6379.conf。如果需要修复 AOF,应先停止对应节点、复制出数据文件,在副本或维护副本上执行检查;直接对唯一数据副本执行修复可能造成不可逆的数据损失。
Cluster 客户端需要能够处理拓扑变化。应用频繁收到 MOVED 却没有更新节点拓扑、每次请求都创建新连接、连接池没有设置最大连接数、连接池等待时间未单独监控、一个连接池只连接单一主节点,或者网络错误后所有请求同时重连,通常都说明客户端配置存在问题。
建议同时记录四类时间:从业务线程发起请求到获得连接的等待时间、Redis 命令在连接上执行的时间、网络往返时间,以及连接创建和认证时间。
如果只有“获取连接等待时间”上升,Redis 端的 connected_clients 可能并不高,问题更可能在客户端池容量或连接泄漏。如果 Redis 服务端命令耗时和磁盘指标同步上升,才应把重点转回持久化和存储。
连接池不应无限扩大。连接数过大可能带来更多内存、文件描述符、上下文切换和网络处理开销。更合理的做法是先根据应用并发设置上限,再通过池等待时间、Redis p99、错误率和 CPU 逐步调整。批量命令和流水线可以减少网络往返,但一次发送过大的批量请求也可能造成单次事件循环占用过久,应结合请求大小和尾延迟验证。
生产环境不要直接通过关闭 AOF、停止 RDB 或大规模压力测试来证明结论。可以按以下顺序复测:
INFO persistence、INFO clients、INFO memory、INFO replication。iostat -xz 1、vmstat 1 和 Redis 进程的磁盘活动。如果必须使用 redis-benchmark,应在测试集群或隔离节点执行,因为它会产生真实读写负载。例如下面的命令只适合测试环境,且会向目标节点写入数据:
redis-benchmark \
  -h 10.0.0.11 \
  -p 6379 \
  -t set \
  -n 20000 \
  -c 20 \
  -P 8
这个测试只覆盖单节点,不代表完整 Cluster 的真实表现,也不能直接推导业务 p99。生产验证应优先使用带有独立测试键空间的业务回放或小比例灰度流量。
如果需要确认存储设备的写入延迟,测试文件必须放在与 Redis 数据目录相同的文件系统中,并且只能在维护窗口执行。直接对 /var/lib/redis 下的 AOF、RDB 或节点配置文件做测试会破坏数据。无论采用何种磁盘测试,都要预留删除测试文件和恢复磁盘空间的步骤,避免测试本身把磁盘写满。
cluster_state:fail。 优先检查集群总线 16379、cluster-announce-ip、节点间防火墙和节点时间。客户端端口 6379 可访问,并不代表 Cluster 总线正常。
AOF 或 RDB 状态为失败。 检查磁盘空间、inode、目录权限和系统日志。空间不足时不要直接删除旧文件,应先确认当前加载的数据文件、AOF 重写状态和副本可用性,再制定清理或扩容方案。
连接数正常但写入仍慢。 继续检查 SLOWLOG、LATENCY LATEST、客户端连接池等待时间、MOVED/ASK 计数、单节点热点和应用发送的数据大小。连接数不高只能排除部分连接风暴,不能排除命令执行慢、网络排队或持久化影响。
Redis 重启后数据加载时间很长。 查看 AOF 文件大小、RDB 前缀、磁盘顺序读延迟和可用内存。重启加载阶段不要反复强制重启,这可能延长恢复过程。若怀疑文件损坏,先复制数据文件再检查,不要在唯一生产副本上直接执行修复命令。
Sentinel 状态正常但 Cluster 仍然异常。 这是预期边界:Sentinel 的健康状态不能证明 Cluster 槽位、Cluster 总线和主从复制正常。Cluster 应检查 CLUSTER INFO、CLUSTER NODES 和 redis-cli --cluster check;独立 Sentinel 服务则检查 SENTINEL masters、SENTINEL replicas 和其自身的仲裁状态。
下一次遇到写入延迟抖动时,应把下面这一组指标放在同一时间轴上观察,而不是只截取一个指标:业务写入 p95/p99、超时率、每个主节点的请求量、connected_clients 与新建连接速率、AOF/RDB 状态、latest_fork_usec、aof_pending_bio_fsync、磁盘 await、I/O 队列、CPU、可用内存、swap、复制延迟以及 MOVED/ASK 数量。只有当这些指标的变化方向和时间关系能够互相印证,才能确定是持久化、磁盘 I/O、连接池,还是单节点热点导致了 Ubuntu 香港服务器上的 Redis Cluster 写入变慢。


