

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


最直接的答案是:在 Ubuntu 香港服务器上部署 Redis Cluster 后,不应再让 Sentinel 作为 Cluster 的故障切换控制器。Redis Cluster 通过节点间的 Cluster Bus 发现主节点故障,并从对应副本中选出新主节点;RDB/AOF 负责保存和恢复数据;Sentinel 主要服务于非 Cluster 模式下的主从架构。三者不是“Sentinel 调用持久化完成切换”的关系。
正确的故障处理链路是:Redis Cluster 负责分片和节点级故障切换,AOF/RDB 负责数据恢复,Sentinel 不参与 Cluster 的自动选主。如果 Sentinel 仍然监控着 7000、7001 这类 Cluster 节点,不要把 SENTINEL failover 当成 Redis Cluster 的切换命令,否则可能出现 Sentinel 看到的主节点角色与 Cluster 拓扑不一致。
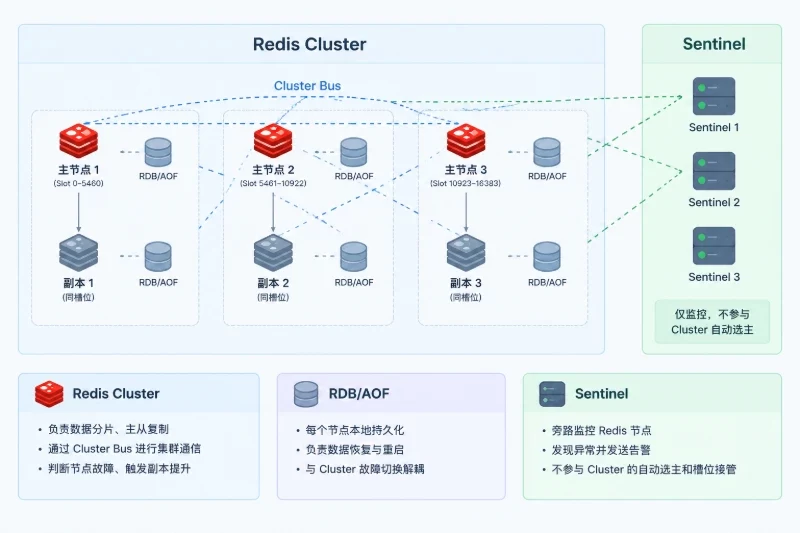
Redis Cluster 和 Sentinel 都能提供一定程度的高可用,但解决的问题不同。
| 能力 | Redis Cluster | Sentinel |
|---|---|---|
| 数据分片 | 支持,16384 个槽位分布在多个主节点 | 不支持 |
| 主从复制 | 支持 | 支持 |
| 主节点故障切换 | 由 Cluster Bus 和 Cluster 节点选举完成 | 由 Sentinel 仲裁并提升副本 |
| 客户端发现主节点 | 通过 Cluster 拓扑、MOVED、ASK 响应 | 通过 Sentinel 查询主节点地址 |
| 持久化 | 每个节点独立保存 RDB/AOF | 不负责保存业务数据 |
| 适用架构 | 分片集群 | 非分片主从架构 |
在 Cluster 中,主节点宕机后,其他节点会通过 Cluster Bus 判断它是否失联。如果对应副本满足复制状态、故障判断和投票条件,副本会被提升为新主节点,并接管原主节点负责的槽位。
持久化发挥作用的地方有两个:
因此,AOF 或 RDB 不会主动选择新主节点,也不会代替 Cluster 完成投票。即使 AOF 配置正常,如果 Cluster Bus 不通、副本没有完成同步或槽位覆盖不完整,故障切换仍然可能失败。
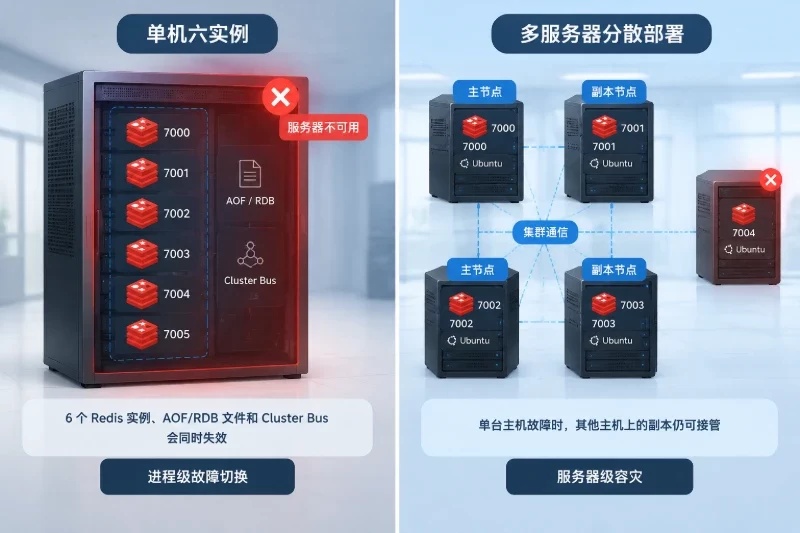
一个常见的 Cluster 实验拓扑是 3 个主节点加 3 个副本,例如:
如果这六个实例全部运行在同一台 Ubuntu 香港服务器上,只能验证 Redis 进程级故障切换,无法防护服务器本身断电、系统故障或整机不可用。服务器级高可用需要把主节点和副本节点分散到不同的 Ubuntu 服务器,并保证各节点之间可以访问客户端端口和 Cluster Bus 端口。
先确认系统和 Redis 版本,不要直接假设 Ubuntu 软件源中的版本:
sudo apt update
sudo apt install -y redis-server redis-tools

redis-server --version
redis-cli --version
command -v redis-server
command -v redis-cli
如果系统自带的 redis-server 已经监听 6379 端口,应先确认该实例没有承载业务。下面的停止操作只适用于准备重新建立实例的场景,执行前应备份原配置和数据目录:
sudo cp -a /etc/redis/redis.conf \
  /etc/redis/redis.conf.bak.$(date +%F-%H%M%S)

sudo systemctl status redis-server --no-pager
确认可以停止后执行:
sudo systemctl stop redis-server
sudo systemctl disable redis-server
这会停止系统默认的 Redis 服务,不会自动删除数据。若需要回滚,可执行:
sudo systemctl enable --now redis-server
每个 Redis 实例必须拥有独立的数据目录和独立的 nodes.conf。不要把一个实例生成的 nodes.conf 复制给其他实例,否则节点身份可能冲突。
下面配置适合单机运行六个实例的测试环境。生产环境中需要把 bind 和 cluster-announce-ip 替换为各服务器之间可互通的内网地址,并限制访问来源。
先准备目录:
for port in 7000 7001 7002 7003 7004 7005; do
    sudo install -d -o redis -g redis -m 750 "/var/lib/redis/${port}"
done
为每个实例生成配置。CHANGE_ME_STRONG_PASSWORD 必须替换为实际的高强度密码,所有 Cluster 节点的 requirepass 和 masterauth 应保持一致:
REDIS_PASS='CHANGE_ME_STRONG_PASSWORD'

for port in 7000 7001 7002 7003 7004 7005; do
    bus_port=$((port + 10000))

    sudo tee "/etc/redis/${port}.conf" >/dev/null <
这里同时启用了 RDB 和 AOF:
appendfsync everysec 通常能在数据安全与写入延迟之间取得平衡。everysec 不是零数据丢失保证。服务器突然断电时,最近一次尚未完成 fsync 的写入可能丢失,实际范围取决于写入速度、磁盘和故障时机。检查配置时,重点确认每个实例的 dir 不同,port、cluster-announce-port 和 cluster-announce-bus-port 不重复。
创建模板服务:
sudo tee /etc/systemd/system/redis-cluster@.service >/dev/null <<'EOF'
[Unit]
Description=Redis Cluster instance on port %i
After=network-online.target
Wants=network-online.target

[Service]
Type=simple
User=redis
Group=redis
ExecStart=/usr/bin/redis-server /etc/redis/%i.conf
Restart=on-failure
RestartSec=2
LimitNOFILE=10032

[Install]
WantedBy=multi-user.target
EOF
如果 command -v redis-server 返回的路径不是 /usr/bin/redis-server,应修改 ExecStart,不要直接启动错误路径。
加载并启动实例:
sudo systemctl daemon-reload

for port in 7000 7001 7002 7003 7004 7005; do
    sudo systemctl enable --now "redis-cluster@${port}"
done
查看监听状态:
sudo ss -lntp | grep -E ':(7000|7001|7002|7003|7004|7005|17000|17001|17002|17003|17004|17005)\b'
如果某个端口没有监听,先查看对应日志:
sudo journalctl -u redis-cluster@7000 -n 80 --no-pager
将 7000 替换为实际故障实例。常见原因包括配置文件权限错误、目录不存在、密码配置格式错误以及端口已经被其他进程占用。
先设置客户端认证环境变量,避免把密码直接写在每条命令的参数中:
export REDISCLI_AUTH='CHANGE_ME_STRONG_PASSWORD'
逐个测试实例:
for port in 7000 7001 7002 7003 7004 7005; do
    printf 'port %s: ' "$port"
    redis-cli -p "$port" ping
done
六个实例都返回 PONG 后,创建 3 主 3 副本的 Cluster:
redis-cli --cluster create \
  127.0.0.1:7000 \
  127.0.0.1:7001 \
  127.0.0.1:7002 \
  127.0.0.1:7003 \
  127.0.0.1:7004 \
  127.0.0.1:7005 \
  --cluster-replicas 1 \
  --cluster-yes
验证 Cluster 状态:
redis-cli -p 7000 cluster info
redis-cli -p 7000 cluster nodes
正常情况下,cluster info 中应看到类似结果:
cluster_state:ok
cluster_slots_assigned:16384
cluster_slots_ok:16384
cluster_known_nodes:6
cluster_size:3
cluster nodes 中应当有 3 个 master 和 3 个 slave。节点状态中的 connected 表示 Cluster Bus 正常连接;如果出现 fail、handshake 或节点数量少于 6,应先解决网络、端口或节点配置问题。
继续检查持久化状态:
for port in 7000 7001 7002 7003 7004 7005; do
    echo "===== Redis ${port} ====="
    redis-cli -p "$port" info persistence | \
      egrep 'aof_enabled|aof_last_write_status|aof_last_bgrewrite_status|rdb_last_bgsave_status|rdb_last_save_time'
done
重点关注:
aof_enabled:1:AOF 已启用。aof_last_write_status:ok:最近一次 AOF 写入正常。aof_last_bgrewrite_status:ok:最近一次 AOF 重写正常。rdb_last_bgsave_status:ok:最近一次 RDB 后台保存正常。err,应立即检查磁盘容量、磁盘 inode、目录权限和系统日志。不要在 Redis 运行期间直接删除 appendonly.aof、AOF 目录、dump.rdb 或 nodes.conf。这些文件分别关系到数据恢复和节点身份。确需清理或重建时,应先备份、停止对应实例,并确认影响范围;回滚时恢复原目录和配置后再启动。
如果服务器上已经安装或运行 Sentinel,可以先只读查看它的状态:
sudo systemctl status redis-sentinel --no-pager
redis-cli -p 26379 ping
redis-cli -p 26379 sentinel masters
如果 Sentinel 的监控目标包含 127.0.0.1:7000、127.0.0.1:7001 等 Cluster 节点,不要执行下面这类操作:
redis-cli -p 26379 sentinel failover
原因是 Sentinel 的视角是“某个主从组需要提升副本”,而 Redis Cluster 的视角是“某个节点负责的槽位需要由 Cluster 成员重新接管”。Sentinel 直接提升节点后,未必能同步完成 Cluster 的槽位状态、节点配置和故障纪元,客户端仍可能收到错误拓扑,或者出现两个控制面同时尝试改变角色的情况。
如果 Sentinel 只是历史遗留服务,并且确认不再监控业务实例,可以先备份配置,再停止它。停止 Sentinel 只影响 Sentinel 监控和告警,不会删除 Redis 数据:
sudo cp -a /etc/redis/sentinel.conf \
  /etc/redis/sentinel.conf.bak.$(date +%F-%H%M%S)

sudo systemctl stop redis-sentinel
sudo systemctl disable redis-sentinel
需要回滚时:
sudo systemctl enable --now redis-sentinel
如果业务客户端只支持 Sentinel 的主节点发现方式,却不支持 Redis Cluster 的 MOVED 和 ASK 响应,那么问题不在持久化参数,而在架构和客户端能力不匹配。Cluster 客户端应使用多个 Cluster 启动节点,并启用 Cluster 模式;不能只连接一个端口,再期待 Sentinel 替客户端完成分片路由。
先从 Redis 进程和监听端口开始检查:
sudo ss -lntp | grep -E ':(7000|7001|7002|7003|7004|7005|17000|17001|17002|17003|17004|17005)\b'

redis-cli -p 7000 ping
redis-cli -p 7000 cluster info
结果可以这样判断:
| 检查结果 | 含义 | 处理方向 |
|---|---|---|
PONG,但 cluster_state:fail | Redis 进程存活,Cluster 拓扑异常 | 检查节点数量、槽位覆盖和 Cluster Bus |
| 客户端端口不通 | Redis 未启动或监听地址错误 | 查看 systemd 和 Redis 日志 |
| 客户端端口通,但 Bus 端口不通 | 节点无法完成故障判断和选举 | 检查 17000 至 17005 及防火墙 |
cluster_known_nodes 少于 6 | 节点未加入或节点配置冲突 | 检查 nodes.conf 和启动日志 |
多服务器部署时,应只允许 Cluster 成员之间访问客户端端口和 Bus 端口,不要把这些端口无条件暴露给公网。修改防火墙前应备份当前规则,并记录新增规则;测试失败时只回滚对应规则,不要直接清空整套防火墙配置。
查看某个实例的复制状态:
redis-cli -p 7003 info replication
redis-cli -p 7003 role
重点检查:
role:slave
master_link_status:up
master_sync_in_progress:0
如果 master_link_status:down,说明副本没有与主节点保持正常复制。常见原因是主从认证不一致、Bus 或客户端端口不通、磁盘写满,或者副本仍处于初次全量同步。
如果 master_sync_in_progress:1,表示正在进行全量同步,此时不要立即停止主节点测试故障切换。等待同步完成后,再查看复制偏移量是否持续变化。
redis-cli -p 7000 cluster slots
redis-cli -p 7000 cluster info
正常状态应为:
cluster_slots_assigned:16384
cluster_slots_ok:16384
cluster_state:ok
如果已分配槽位少于 16384,或者 cluster_state:fail,即使 Sentinel 显示某个副本可以提升,Cluster 客户端仍可能无法访问全部数据。此时不要先执行 Sentinel 故障切换,应先修复节点加入、槽位分配和副本关系。
检查磁盘和 inode:
df -h /var/lib/redis
df -i /var/lib/redis
再检查 AOF、RDB 状态:
redis-cli -p 7000 info persistence | \
  egrep 'aof_enabled|aof_last_write_status|aof_last_bgrewrite_status|rdb_last_bgsave_status|rdb_last_save_time'

sudo journalctl -u redis-cluster@7000 -n 100 --no-pager
如果出现 aof_last_write_status:err、rdb_last_bgsave_status:err,先处理磁盘容量、权限或文件系统错误。不要通过删除持久化文件来“恢复正常”,否则可能扩大数据丢失范围。
先写入一个测试键。必须使用 -c,这样客户端才能自动处理槽位跳转:
redis-cli -c -p 7000 set ha:probe "$(date +%s)"
redis-cli -c -p 7000 get ha:probe
从 cluster nodes 中确认 7000 当前确实是一个主节点后,再停止它。停止操作会影响该主节点负责的槽位,生产环境只能在维护窗口或明确的演练范围内执行:
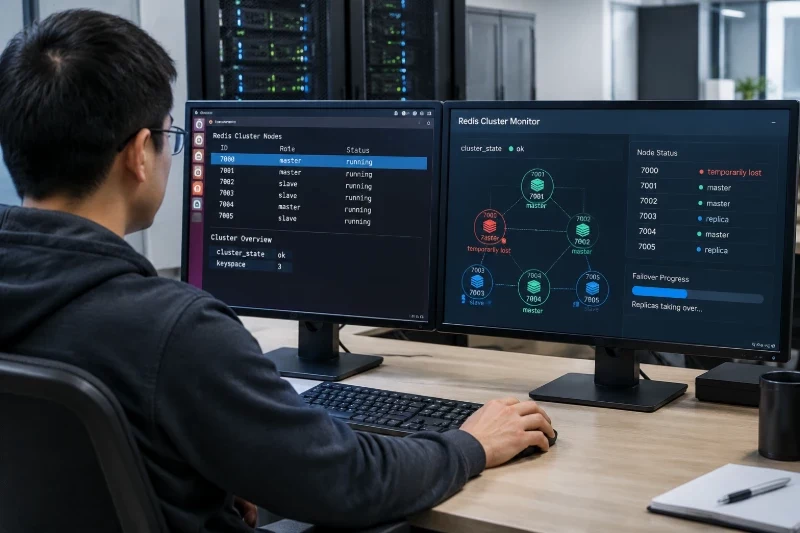
sudo systemctl stop redis-cluster@7000
等待超过 cluster-node-timeout,再从其他节点查看状态:
sleep 8

redis-cli -p 7001 cluster info
redis-cli -p 7001 cluster nodes
redis-cli -c -p 7001 get ha:probe
成功时通常表现为:
cluster_state:ok;master;ha:probe 仍然可以读取;MOVED 跳转找到新的主节点。这个等待时间只是由 cluster-node-timeout 5000 推导出的典型观察值,不代表每次切换都固定在 8 秒完成。实际时间还受到选举、复制状态、系统负载和客户端重连策略影响。
演练结束后重新启动原实例:
sudo systemctl start redis-cluster@7000
sudo systemctl status redis-cluster@7000 --no-pager
再次检查:
redis-cli -p 7001 cluster info
redis-cli -p 7001 cluster nodes
redis-cli -c -p 7001 get ha:probe
原 7000 节点重启后不一定立即恢复为主节点,它可能先以副本身份同步当前主节点,这是正常现象。只要槽位完整、节点状态恢复为 connected、数据可以读取,说明故障切换和回归同步链路基本正常。
如果停止一个主节点后 cluster_state 仍然是 fail,优先检查对应副本是否在线、是否完成同步,以及三个主节点是否仍能互相通信。若同时停止多个主节点,可能出现部分槽位没有可用副本,Cluster 会为了避免返回错误数据而拒绝提供完整服务。
如果 Sentinel 显示的主节点地址与 cluster nodes 不一致,应以 Redis Cluster 的拓扑为准。Sentinel 的 SENTINEL get-master-addr-by-name 结果不能替代 Cluster 节点发现。
如果只有一台 Ubuntu 香港服务器,即使运行六个 Redis 进程,也无法验证整机级容灾。服务器宕机时,六个实例、AOF/RDB 文件和 Cluster Bus 会同时不可用。此时应把“进程故障切换”与“服务器故障切换”分开评估,并为不同节点准备独立的数据目录、节点身份和可恢复备份。
如果业务更看重极低的数据丢失窗口,可以评估 appendfsync always,但它通常会增加写入延迟和磁盘压力;如果更看重吞吐量,则应在确认磁盘、AOF 重写和备份策略后再调整,不能只靠 Sentinel 弥补持久化配置不足。
完成配置后,真正需要确认的最后一个问题是:关闭一个正在承载槽位的主节点时,Cluster 是否能由已同步的副本接管、持久化状态是否保持正常,以及业务客户端是否能自动跟随新的 Cluster 拓扑?


