

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


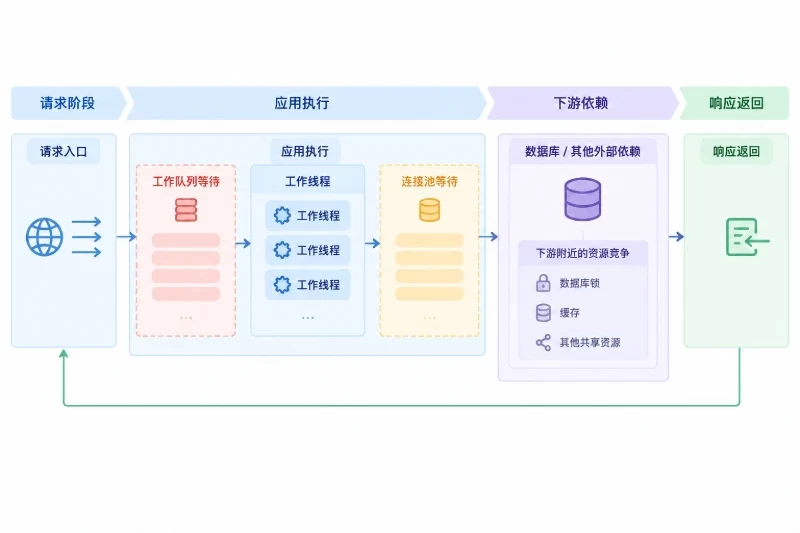
高并发时,CPU不高不代表应用有余量,连接数很多也不一定说明连接池太小。请求可能正在等待数据库连接、排队等待工作线程,或争用缓存、锁等共享资源。排查时应把请求路径拆成几段:入口接收、应用执行、外部依赖调用和响应返回,再结合请求耗时、队列等待时间、连接池占用与等待、线程状态、CPU和数据库指标判断。先定位等待发生在哪一段,再调整对应资源;不要一上来就增加进程数或连接池上限。
测试应在可控环境中进行,记录应用版本、进程与线程配置、连接池参数、依赖服务状态和负载发生器配置。以逐步增加并发的方式观察指标,并在负载停止后确认积压是否消退。若测试流量会触及生产数据或第三方依赖,应先明确影响范围,使用隔离环境或经过批准的测试数据。
连接池复用已经建立的数据库或其他服务连接,避免每个请求都重复创建和释放连接。池太小,应用线程可能等待可用连接;池过大,则可能把压力转移给数据库,让数据库连接数、内存和调度开销上升。连接池不是越大越快,其容量必须与下游服务的承载能力一起评估。
工作队列则用于暂存尚未执行的任务。请求进入应用后,如果可用工作线程不足,任务可能等待队列中的空位或排队执行。队列可以吸收短时流量尖峰,却不能提高持续处理能力:当到达速度长期超过处理速度,队列会持续增长,延迟和超时也会随之增加。
可以把两者理解为两种不同的等待:
实际系统中,等待可能逐层传递。例如线程占满后,任务进入队列;线程开始执行后,又因连接池耗尽而阻塞。只看队列长度会把下游连接问题误判为线程不足,因此应同时观察各层等待时间。
进程与线程模型决定应用能同时执行多少工作。多进程可以隔离部分故障、利用多个处理单元,但也会带来进程间内存占用和连接池总量放大的问题。多线程共享进程资源,管理成本相对集中,但线程若大量阻塞在数据库或锁上,增加线程并不能让请求更快完成。异步模型也不是不受限:事件循环中的阻塞操作仍会拖慢同一执行单元上的其他任务。
因此,连接池上限要按应用实例总量计算,而不只是看单个进程的配置。例如,若每个进程都各自创建连接池,实例数和进程数变化后,数据库看到的连接总量可能远高于单池上限。应核对连接池监控数据和数据库侧的实际连接数,确认所有应用副本、后台任务和其他调用方都已计入。
请求的资源消耗也影响并发。短小、计算量低的请求与包含复杂查询、文件处理或多个外部调用的请求,不能用同一个并发阈值判断。应按接口或任务类型分组统计,否则少量慢请求可能拉高整体耗时,掩盖其他请求的正常表现。
共享资源竞争常表现为CPU并不满、吞吐却上不去。可能的等待点包括数据库锁、应用内互斥锁、缓存访问、磁盘读写或下游限流。若线程大量处于等待状态,同时队列增长,继续扩大工作线程池通常只会增加争用。需要结合应用追踪、数据库等待事件或运行时线程分析,确认线程具体卡在哪里。
测试前先建立基线:在低负载下记录接口延迟、错误率和各池的占用情况,再逐步提高到预定并发。每个阶段应保持足够时间,直到吞吐和等待指标相对稳定;若请求量仍在增加、队列仍持续变长,该阶段不能视为稳定结果。测试过程中尽量固定应用配置、数据规模和下游状态,一次只改一个关键参数,避免无法判断变化来自哪里。
建议至少采集以下指标:
| 观察项 | 重点看什么 | 常见解释 |
|---|---|---|
| 请求吞吐与延迟分位数 | 吞吐是否继续增加,较慢请求是否显著变多 | 吞吐停滞而延迟上升,说明系统接近或超过当前处理能力 |
| 错误率与超时数 | 是否随并发上升 | 可能是队列、连接等待或下游处理时间超过超时边界 |
| 工作队列长度与等待时间 | 是否持续增长,负载降低后能否回落 | 长期不回落通常说明处理速率不足或存在阻塞 |
| 连接池活动数、空闲数与等待数 | 是否经常打满,等待持续多久 | 有等待时需继续核对数据库能力与连接持有时间 |
| 线程状态与进程资源 | 活跃、阻塞线程,CPU和内存趋势 | 线程多但CPU低,可能在等待;CPU持续饱和则需判断计算负载 |
| 下游服务指标 | 响应时间、连接数、锁等待或限流情况 | 应用侧拥塞可能由下游先达到上限引起 |
Linux环境下,可用下列命令观察主机层面的连接和资源概况。命令只读取状态,不会修改配置;输出仍需结合应用自身监控解释。
ss -s
vmstat 1
ss -s显示网络套接字的汇总信息,不能直接代替应用连接池指标;vmstat 1按秒输出系统资源概况,重点关注运行队列、CPU空闲情况和等待情况。若要检查特定进程,应先通过系统进程工具确认进程号,再查看该进程的线程和资源数据。不同发行版及工具版本的参数可能不同,执行前可用 命令名 --help 核实。
先确认连接是否被慢查询或长事务长时间占用,并检查数据库侧是否已经繁忙。若数据库响应变慢,直接扩大连接池可能让更多请求同时进入下游,加重争用。应先缩短不必要的连接持有时间、排查慢查询或锁等待,并确认连接是否按预期归还。只有在数据库仍有明确余量、应用确实因池容量限制而等待时,才适合小幅调整池上限,并同步监控数据库连接数和延迟。
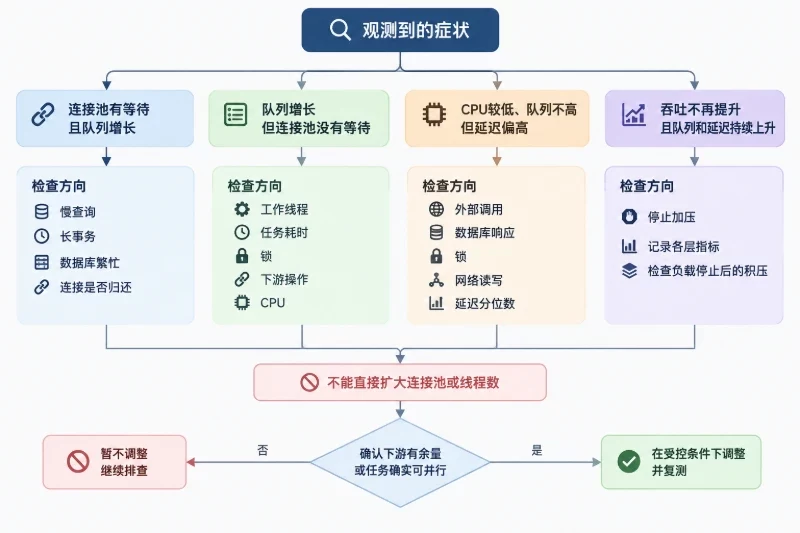
可能是工作线程不足、单个任务耗时过长,或应用在计算和共享资源上阻塞。查看线程状态和请求分段耗时:若线程主要等待某个锁或下游操作,优先定位等待点;若线程在执行计算且CPU持续饱和,增加线程未必有效。若任务确实可以并行处理,再在受控测试中调整工作线程数,观察吞吐、延迟和CPU是否同时改善。
检查请求是否花时间等待外部调用、数据库响应、锁或网络读写。平均延迟可能掩盖少数慢请求,应同时看分位数和按接口拆分的数据。若应用内部等待不明显,则需对照下游响应时间;若连接池、线程监控均正常,也不应仅凭主机CPU空闲就判定服务器配置不足。
这是已经越过当前稳定处理能力的信号。测试应及时停止继续加压,记录此时各层指标,并检查负载停止后队列是否排空、错误率是否恢复。若停止负载后仍有积压,需排查未完成任务、连接未释放或后台处理速度不足,再以较低负载复测。
每次测试只改变一个变量,例如工作线程上限或连接池容量,保留原参数和基线结果,避免同时改池大小、队列容量和超时设置。调整后重复相同的负载阶段,比较吞吐、延迟分位数、错误率、连接等待、队列等待及下游状态。若吞吐增加但延迟和错误率明显恶化,不能简单视为优化成功;如果池等待减少而数据库延迟升高,瓶颈可能只是被推到了下游。
队列容量尤其需要谨慎。增大队列可以减少瞬时拒绝,但也会让更多请求等待更久,占用内存,并可能使过期请求仍在排队执行。应结合业务超时和任务可丢弃性设定边界,并确认队列满时系统采取的是明确的拒绝、降级还是其他可观测行为。对于不能长时间等待的交互请求,持续积压通常比尽早返回可识别错误更难处理。
复测时还要保证负载发生器没有先成为瓶颈,测试数据和缓存状态保持可比,并记录每次变更的时间与参数。若负载停止后指标不能恢复到基线附近,先处理残留任务或资源未释放问题,再进行下一轮。只有在相同测试条件下,多次观察到瓶颈指标改善、错误率可控、下游仍有余量,才能把该调整视为有效;这一结论只适用于已测的请求类型、数据规模和运行配置,负载模式变化后应重新验证。


