

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


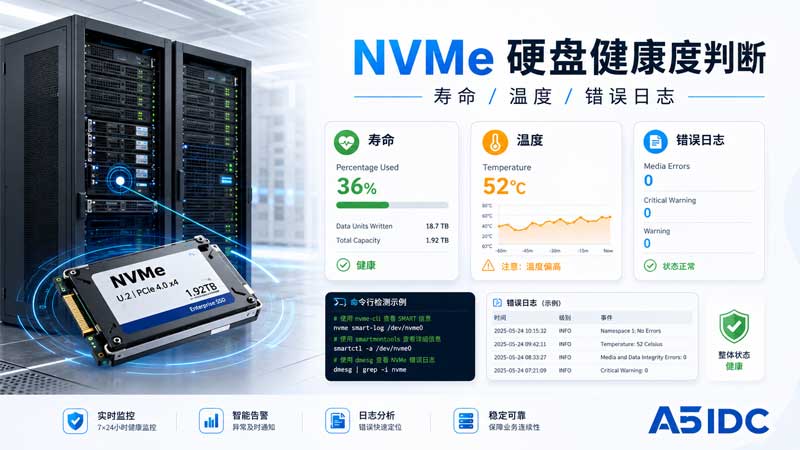
服务器运行久了以后,CPU、内存、带宽问题通常比较容易被发现,但硬盘健康度反而容易被忽略。尤其是 NVMe SSD,平时读写速度很快,业务也不一定马上报错,等到出现数据库卡顿、网站写入失败、系统突然只读、RAID 阵列降级时,往往已经比较被动。
在实际运维中,我一般不会只看“硬盘还能不能识别”,而是重点看三个指标:寿命消耗、温度状态、错误日志。这三个方向基本可以判断一块 NVMe 硬盘是正常服役、需要观察,还是应该提前更换。
NVMe SSD 和普通 SATA SSD 最大的区别,是它直接走 PCIe 通道,延迟更低、并发能力更强,非常适合数据库、虚拟化、缓存、高并发网站、日志写入等场景。
例如一台常见的香港高性能业务服务器可以这样配置:
| 项目 | 配置示例 |
|---|---|
| CPU | Intel Xeon E-2434 / AMD EPYC 7402P |
| 内存 | 32GB / 64GB DDR4 ECC |
| 硬盘 | 960GB NVMe SSD / 2 × 960GB U.2 NVMe |
| 网络 | 100M BGP + 25M CN2 / CMIN2 / CU 优化线路 |
| 系统 | Ubuntu 22.04 / Debian 12 / CentOS 7.x |
| 适用场景 | 企业官网、跨境电商、数据库、后台系统、API 服务 |
这类服务器里,NVMe 硬盘通常承担系统盘、数据库盘、日志盘或缓存盘。如果硬盘状态异常,可能不是简单的“坏了换盘”,而是会直接影响 MySQL、Redis、Elasticsearch、Docker、虚拟化平台等服务。
判断 NVMe 健康度,不需要一开始就看特别复杂的参数。基础判断主要看下面这些:
| 指标 | 重点含义 | 判断方向 |
|---|---|---|
| Percentage Used | 寿命消耗比例 | 判断硬盘写入寿命是否接近上限 |
| Temperature | 当前温度 | 判断是否过热降速或影响寿命 |
| Critical Warning | 严重警告 | 有非 0 值就要重点排查 |
| Media Errors | 介质错误 | 判断是否有硬盘底层读写错误 |
| Error Log Entries | 错误日志数量 | 判断是否频繁出现异常 |
| Available Spare | 备用空间 | 备用块是否接近耗尽 |
| Unsafe Shutdowns | 非正常断电次数 | 判断是否有断电、强制重启风险 |
| Data Units Written | 累计写入量 | 判断业务写入压力是否过大 |
其中最常用的是:寿命、温度、错误日志。
在 Linux 服务器上,建议安装两个工具:
apt install -y nvme-cli smartmontoolsCentOS 7.x 可以使用:
yum install -y nvme-cli smartmontools先查看服务器上有哪些 NVMe 盘:
nvme list常见输出类似:
Node             Model                 Namespace Usage
/dev/nvme0n1     Samsung PM9A3 NVMe     1         960GB
/dev/nvme1n1     Samsung PM9A3 NVMe     1         960GB
查看健康状态:
nvme smart-log /dev/nvme0n1也可以用 smartctl 查看:
smartctl -a /dev/nvme0n1如果系统识别设备名不同,也可能是:
nvme smart-log /dev/nvme0
smartctl -a /dev/nvme0NVMe 里最直观的寿命指标是:
percentage_used它不是简单的“剩余百分比”,而是表示厂商根据写入量、擦写次数等估算出来的寿命消耗。
大致可以这样判断:
| Percentage Used | 状态判断 | 建议 |
|---|---|---|
| 0% - 50% | 正常 | 定期巡检即可 |
| 50% - 80% | 有一定消耗 | 关注写入量和业务负载 |
| 80% - 100% | 接近寿命设计值 | 建议安排更换计划 |
| ≥ 100% | 已超过设计寿命 | 不建议继续作为核心业务盘 |
需要注意,超过 100% 不代表硬盘立刻坏掉,但代表它已经超出厂商设计写入寿命。对于普通测试机可以继续观察,但如果是数据库服务器、客户业务服务器、财务系统、订单系统,就不建议冒险。
例如:
percentage_used : 86%这类盘如果还在承载 MySQL 数据库、订单系统或高频日志写入,建议尽快迁移数据并安排换盘。
NVMe 硬盘速度快,但温度也更敏感。很多服务器故障不是硬盘直接损坏,而是 NVMe 长期高温后性能下降、延迟升高,甚至出现异常重置。
常见温度判断可以参考:
| 温度范围 | 状态 | 建议 |
|---|---|---|
| 30℃ - 55℃ | 理想范围 | 正常运行 |
| 55℃ - 65℃ | 偏高 | 观察机箱风道和负载 |
| 65℃ - 75℃ | 高温 | 建议优化散热 |
| 75℃ 以上 | 风险较高 | 需要立即处理 |
查看温度时,重点看:
temperature
warning_temp_time
critical_comp_time
如果输出中出现类似:
temperature : 72 C
warning_temp_time : 125
critical_comp_time : 8
说明硬盘不仅当前温度偏高,而且曾经进入过警告温度甚至临界温度状态。这种情况不能只看“现在还能用”,需要检查服务器风道、硬盘位置、散热片、机柜进风温度。
对于 1U / 2U 服务器,如果 NVMe 盘位靠近 CPU、GPU 或 RAID 卡,温度更容易升高。尤其是 AI 推理服务器、数据库服务器、虚拟化宿主机,NVMe 长期满负载写入时,温度问题更明显。
NVMe 健康判断中,错误日志非常重要。重点看两个字段:
media_errors
num_err_log_entriesmedia_errors 表示介质层面的错误,简单理解就是硬盘在读写数据时出现过底层异常。
如果是:
media_errors : 0通常比较正常。
如果出现:
media_errors : 3即使数量不大,也建议继续观察。如果这个数值持续增长,就要尽快备份和换盘。
num_err_log_entries 表示错误日志条目数量。这个数值不一定代表硬盘马上损坏,但如果它持续增长,就说明设备层面出现过异常。
例如:
num_err_log_entries : 120这种情况需要结合系统日志继续排查:
dmesg | grep -i nvme
journalctl -k | grep -i nvme
如果看到类似信息:
nvme0: I/O timeout
nvme0: reset controller
blk_update_request: I/O error
就说明系统层面已经感知到 NVMe 异常,不能只看业务是否还在运行。
critical_warning 是 NVMe 健康状态里非常关键的字段。
正常情况下通常是:
critical_warning : 0如果不是 0,就要重点排查。它可能代表备用空间不足、温度异常、可靠性下降、介质进入只读等问题。
常见风险包括:
| 情况 | 可能影响 |
|---|---|
| 备用空间低于阈值 | 硬盘可替换块不足 |
| 温度超过阈值 | 可能降速或异常 |
| 可靠性下降 | 数据风险增加 |
| 介质只读 | 系统可能无法写入 |
| 易失性内存备份失败 | 企业级盘缓存保护异常 |
在生产服务器上,只要 critical_warning 不是 0,就不建议继续观望太久,至少要先完成数据备份。
硬盘健康度不能孤立判断,要结合业务场景。
如果只是企业官网、WordPress、图片较少、写入不频繁,NVMe 寿命消耗通常比较慢。重点关注温度和系统日志即可。
推荐配置:
| 项目 | 配置 |
|---|---|
| CPU | E3-1270 V6 / E-2334 |
| 内存 | 16GB - 32GB |
| 硬盘 | 480GB / 960GB NVMe SSD |
| 带宽 | 100M BGP + 15M / 25M CN2 |
| 适合 | 企业官网、博客、小型后台 |
数据库服务器更关注写入量和错误日志。MySQL binlog、redo log、临时表、慢查询日志都会产生持续写入。
建议关注:
percentage_used
data_units_written
media_errors
num_err_log_entries
如果数据库盘 percentage_used 已经超过 80%,就要准备迁移,不能等到业务报错。
虚拟化宿主机的 NVMe 压力更复杂,因为多个 VPS、数据库、日志、缓存都在同一块盘或同一组盘上。
建议至少使用:
2 × U.2 NVMe RAID1或者业务数据盘和系统盘分离,避免单盘承载所有读写压力。
AI 推理服务器虽然主要压力在 GPU,但模型文件加载、缓存、日志、数据集读取都会使用 NVMe。尤其是大模型、多实例部署时,NVMe 温度和持续读取性能需要关注。
推荐配置示例:
| 项目 | 配置 |
|---|---|
| CPU | AMD EPYC 7402P / EPYC 9554 |
| 内存 | 128GB - 256GB |
| GPU | RTX 4090 / A100 80GB |
| 硬盘 | 1.92TB / 3.84TB NVMe SSD |
| 网络 | 100M - 1G BGP |
| 重点 | 模型加载、缓存盘、日志盘健康度 |
对于线上服务器,建议不要等故障发生后才查 NVMe 状态。可以做一个简单巡检流程。
nvme smart-log /dev/nvme0n1重点记录:
percentage_used
temperature
critical_warning
media_errors
num_err_log_entries
available_spare
unsafe_shutdowns如果一个月内 percentage_used 增长很快,说明业务写入量偏大。
例如:
1月:percentage_used 32%
2月:percentage_used 38%
3月:percentage_used 45%
这种增长速度就要注意,可能是日志、缓存、数据库写入过高。
如果 media_errors 或 num_err_log_entries 持续增长,不建议只重启服务器。应该先做三件事:
第一步:立即备份核心数据
第二步:查看 dmesg / journalctl 系统日志
第三步:安排业务迁移或更换硬盘不同异常对应的处理方式不同。
| 异常情况 | 处理建议 |
|---|---|
| 温度长期超过 65℃ | 优化风道、检查机柜温度、调整硬盘位置 |
| Percentage Used 超过 80% | 准备换盘计划,降低写入压力 |
| Critical Warning 非 0 | 立即备份,评估是否更换 |
| Media Errors 增长 | 尽快迁移业务,不建议继续承载核心数据 |
| Error Log Entries 持续增加 | 结合系统日志排查控制器、固件、供电、主板问题 |
| Unsafe Shutdowns 很高 | 检查电源、系统崩溃、强制重启记录 |
如果是 RAID1 或多盘阵列,不能因为“还有一块盘正常”就忽略问题。NVMe 异常盘继续在线运行,可能导致阵列重建风险增加,甚至影响整机 I/O 性能。
如果时间有限,我一般会用下面这套方式快速判断:
nvme smart-log /dev/nvme0n1
dmesg | grep -i nvme
journalctl -k | grep -i "nvme\|I/O error\|timeout"
然后重点看:
critical_warning 是否为 0
percentage_used 是否超过 80%
temperature 是否长期超过 65℃
media_errors 是否大于 0 且继续增长
num_err_log_entries 是否持续增加
系统日志是否出现 I/O timeout 或 reset controller
只要满足下面任意一种情况,就建议提前处理:
Critical Warning 非 0
Media Errors 持续增长
Percentage Used 接近或超过 100%
NVMe 经常出现 timeout / reset
数据库或系统出现只读、卡顿、写入失败NVMe 硬盘健康度判断并不复杂,真正重要的是不要只看“服务器还能不能开机”或者“硬盘还能不能识别”。对于生产服务器来说,寿命、温度、错误日志才是更有价值的判断依据。
如果是一台普通测试机,部分指标轻微异常可以继续观察;但如果是跨境电商网站、企业官网、数据库、财务系统、API 服务、虚拟化平台,就应该更保守一些。NVMe 硬盘一旦开始出现介质错误、严重警告或系统 I/O 异常,最稳妥的做法不是反复重启,而是先备份、再迁移、最后更换。
服务器硬盘的稳定性,很多时候不是等它坏了才处理,而是在它“开始不对劲”的时候就提前把风险消化掉。


