

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


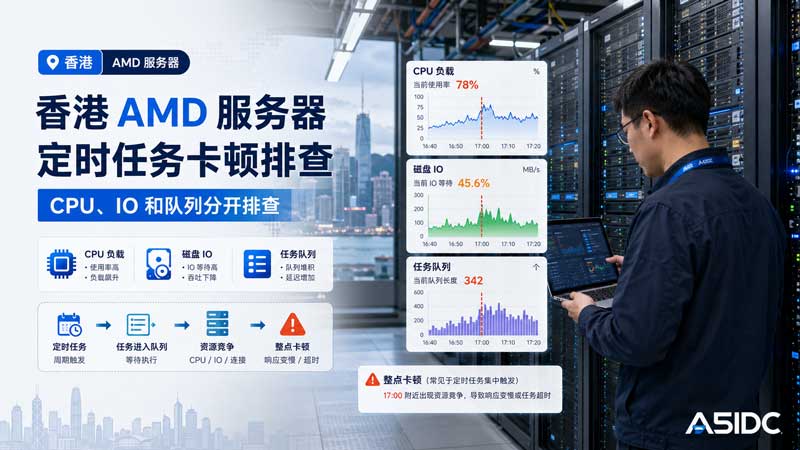
定时任务卡顿,表面上看是“服务器不够快”,但在真实运维里,它往往不是单一问题。
有些香港服务器 CPU 看起来还没跑满,后台却开始变慢;有些机器 load average 很高,但真正卡住的是磁盘 IO;还有些业务把所有任务都塞进 crontab,结果每到整点,PHP、Python、Node、数据库、Redis、备份脚本一起启动,服务器瞬间像被“踩了一脚刹车”。
尤其是企业后台、跨境电商系统、订单同步、库存同步、站群采集、消息推送、报表统计这类业务,定时任务一多,香港 AMD 服务器的 CPU、内存、磁盘、数据库连接、队列消费速度都会被牵扯进去。排查这类问题,不能只看“CPU 使用率”,而要把 CPU、IO、队列、数据库、任务调度方式 分开看。
下面我按真实运维排查思路,拆开讲清楚。
大量定时任务造成卡顿,常见表现有几种:
| 现象 | 常见原因 |
|---|---|
| 每到整点后台明显变慢 | 大量任务集中在同一时间执行 |
| CPU 使用率高,load average 飙升 | 多进程并发任务太多,CPU 上下文切换严重 |
| CPU 不高,但系统很慢 | 磁盘 IO wait 高,数据库或日志写入阻塞 |
| 队列任务越积越多 | 消费进程不足,或者单个任务执行太慢 |
| 数据库连接数暴涨 | 定时任务并发连接数据库,拖慢前台请求 |
| PHP-FPM / Web 后台变慢 | 定时任务和 Web 请求抢 CPU、内存、数据库资源 |
| 任务重复执行 | 上一次任务没跑完,下一次又开始了 |
这里有一个关键点:定时任务卡顿,不一定是 AMD 服务器性能不够,更多时候是任务没有分层、没有限流、没有队列化。
如果只是简单加 CPU,不拆任务结构,短期可能缓解,后面任务量一上来还是会卡。
如果业务里有大量计划任务,不能只看“几核几线程”,还要同时看 CPU 单核性能、内存容量、NVMe 磁盘 IO、线路稳定性。
下面用几个典型配置做参考。
| 服务器类型 | 典型配置 | 适合业务 |
|---|---|---|
| 香港 AMD 高主频型 | AMD EPYC 4584PX / 4585PX,16核32线程,64GB DDR5,960GB NVMe SSD,100M BGP + 直连 CN2 带宽 | 企业后台、API 服务、CRM、ERP、小型订单同步、轻中量队列任务 |
| 香港 AMD 大内存型 | AMD EPYC 4584PX / 4585PX,16核32线程,128GB DDR5,960GB / 1.92TB NVMe SSD | 多站点后台、Redis 缓存、较多 PHP Worker、较多并发定时任务 |
| 香港 AMD 多核心型 | AMD EPYC 9554,64核128线程,256GB DDR5,NVMe SSD | 批量计算、报表生成、采集任务、数据清洗、多队列并行消费 |
| 香港 AMD 虚拟化 / 多业务型 | 双路 AMD EPYC 7713,128核256线程,256GB / 512GB 内存,多块 NVMe SSD | 多业务隔离、多个项目共用、虚拟机/容器化部署、大量后台任务拆分运行 |
如果只是企业官网、轻量后台,E3 或普通 E5 也能跑;但如果你的业务包含订单同步、接口轮询、定时报表、数据采集、消息推送、库存更新、缓存预热,建议优先选择 AMD EPYC + NVMe SSD 的香港服务器。
原因很简单:这类任务不是单纯吃带宽,而是同时吃 CPU 调度能力、磁盘随机读写、数据库响应速度和队列消费能力。
香港服务器用户有时看到后台慢,会第一时间怀疑线路。但是定时任务导致的卡顿,多数发生在服务器内部资源层面。
可以先执行:
top重点看几个指标:
%Cpu(s): 70.0 us, 10.0 sy, 0.0 ni, 5.0 id, 15.0 wa这里不要只看 CPU 总使用率,要看:
| 指标 | 含义 | 怎么判断 |
|---|---|---|
| us | 用户态 CPU 使用率 | PHP、Python、Node、Java 任务计算消耗 |
| sy | 系统态 CPU 使用率 | 进程调度、系统调用、网络/磁盘操作 |
| id | 空闲 CPU | 越低说明 CPU 越忙 |
| wa | IO wait | 高说明 CPU 在等磁盘,不一定是 CPU 不够 |
| load average | 系统负载 | 要结合 CPU 核心数看 |
比如一台 16核32线程的 AMD EPYC 服务器,load average 长时间在 40、60 以上,就要注意了。
但如果 CPU 使用率不高,wa 却很高,说明瓶颈可能不是 CPU,而是磁盘 IO 或数据库写入。
进一步看每个进程:
pidstat -u 1或者:
htop重点找这些进程:
php artisan schedule:run
php artisan queue:work
python task.py
node worker.js
mysqld
redis-server
rsync
tar
gzip
如果你发现每到整点同时冒出几十个 php 或 python 进程,基本可以判断:任务并发过高,调度方式有问题。
大量定时任务经常会做这些动作:
这些操作会把磁盘 IO 打满。
检查磁盘 IO:
iostat -x 1重点看:
| 指标 | 含义 | 风险 |
|---|---|---|
%util |
磁盘繁忙程度 | 长期接近 100%,说明磁盘被打满 |
await |
IO 请求平均等待时间 | 高说明读写排队严重 |
r/s |
每秒读请求 | 读任务多 |
w/s |
每秒写请求 | 写任务多 |
rkB/s |
每秒读取量 | 大量读文件或数据库扫描 |
wkB/s |
每秒写入量 | 日志、备份、数据库写入多 |
如果看到类似情况:
%util  98.00
await  120.00
这时候就算 CPU 还有空闲,系统也会卡。因为进程都在等磁盘返回结果。
再看是谁在写磁盘:
iotop -oPa常见罪魁祸首包括:
mysqld
php
python
rsync
tar
gzip
logrotate
backup.sh
如果你的定时任务里有备份、压缩、导出、日志清理,建议不要和业务任务放在同一个时间段。
例如错误做法:
0 * * * * php /www/project/artisan schedule:run
0 * * * * sh /root/backup.sh
0 * * * * python /www/project/sync_order.py
0 * * * * php /www/project/report.php
这会导致整点所有任务一起打服务器。
更合理的方式:
*/1 * * * * php /www/project/artisan schedule:run >> /dev/null 2>&1
3 * * * * sh /root/light-clean.sh
17 * * * * python /www/project/sync_order.py
35 2 * * * sh /root/backup.sh
45 3 * * * sh /root/compress-log.sh核心思路是:业务任务、同步任务、备份任务、压缩任务不要挤在同一分钟。
大量卡顿不是因为任务多,而是因为任务“重叠”。
比如一个任务计划每分钟执行一次,但它实际需要 3 分钟才能跑完。结果第一轮没结束,第二轮又开始,第三轮又叠上来,最后服务器上挂满同一个任务。
可以用:
ps aux | grep artisan
ps aux | grep sync_order
ps aux | grep report
如果看到同一个任务同时存在很多个,就要加锁。
* * * * * flock -n /tmp/order_sync.lock php /www/project/order_sync.php >> /var/log/order_sync.log 2>&1含义是:
如果上一轮任务还没执行完,下一轮直接跳过,不再重复启动。
如果是 Laravel 项目,可以这样写:
$schedule->command('orders:sync')
    ->everyMinute()
    ->withoutOverlapping()
    ->runInBackground();
对于执行时间长的任务,可以设置过期时间:
$schedule->command('report:generate')
    ->hourly()
    ->withoutOverlapping(60);
这样可以避免任务异常退出后锁一直存在。
例如库存同步、订单同步、退款状态同步、支付状态同步,这类任务不建议无限并发。
宁愿慢一点,也不要重复执行造成数据错乱。
很多项目卡顿,是因为把所有业务逻辑都直接写进 crontab。
例如:
* * * * * php sync_orders.php
* * * * * php sync_stock.php
* * * * * php push_message.php
* * * * * php generate_report.php
* * * * * php clean_cache.php
这种写法的问题是:
crontab 只负责按时间启动任务,它不懂任务优先级,也不懂队列长度,更不会根据服务器负载自动限流。
更合理的架构应该是:
crontab / schedule
        ↓
只负责投递任务
        ↓
Redis / RabbitMQ / Beanstalkd 队列
        ↓
queue worker 分批消费
        ↓
数据库 / 外部接口 / 文件系统
也就是说,定时任务不要直接做重活,而是先把任务拆成小块,放进队列里慢慢消费。
例如订单同步:
错误方式:
每分钟直接同步 5000 个订单优化方式:
每分钟扫描需要同步的订单
每 100 个订单生成一个队列任务
多个 worker 分批消费
失败任务自动重试
高峰期限制消费速度
这样服务器不会被一个大任务瞬间打满。
如果你用了 Redis 队列、Laravel Queue、Horizon、RabbitMQ 或其他任务队列,卡顿时要看队列是否堆积。
Redis 队列可以看长度:
redis-cli llen queues:default
redis-cli llen queues:high
redis-cli llen queues:low
如果队列长度一直上涨,说明:
任务进入队列的速度 > worker 消费速度这时候不要盲目加 worker,要先看单个任务为什么慢。
常见原因:
| 问题 | 表现 | 解决方式 |
|---|---|---|
| 单个任务逻辑太重 | 一个 job 跑几十秒 | 拆小任务 |
| worker 数太少 | 队列堆积但服务器资源空闲 | 增加 worker |
| worker 太多 | CPU / DB / Redis 被打满 | 限制并发 |
| 外部接口慢 | 大量任务卡在 API 请求 | 加超时、重试、降级 |
| 数据库慢查询 | worker 大量等待 SQL | 优化索引和 SQL |
| 失败任务反复重试 | 队列越跑越乱 | 设置 retry/backoff |
Laravel Supervisor 示例:
[program:laravel-worker-default]
process_name=%(program_name)s_%(process_num)02d
command=php /www/project/artisan queue:work redis --queue=default --sleep=3 --tries=3 --timeout=120
autostart=true
autorestart=true
numprocs=4
redirect_stderr=true
stdout_logfile=/www/project/storage/logs/worker-default.log
如果是 16核32线程的香港 AMD EPYC 服务器,初期可以这样分配:
| 队列 | worker 数量 | 说明 |
|---|---|---|
| high | 2-4 | 支付回调、订单状态、重要通知 |
| default | 4-8 | 常规同步任务 |
| low | 1-2 | 报表、清理、统计、非实时任务 |
不要一上来就开几十个 worker。
worker 太多,可能不是提升速度,而是把 MySQL、Redis、磁盘 IO 一起拖垮。
大量定时任务通常离不开数据库。
如果任务同时扫描大表、更新状态、写日志、生成报表,MySQL 很容易成为瓶颈。
先看当前数据库连接:
SHOW PROCESSLIST;如果看到大量:
Sending data
Copying to tmp table
Creating sort index
Waiting for table lock
说明 SQL 或索引可能有问题。
开启慢查询日志:
slow_query_log = 1
long_query_time = 1
slow_query_log_file = /var/log/mysql/mysql-slow.log
然后分析慢 SQL:
mysqldumpslow -s t -t 20 /var/log/mysql/mysql-slow.log常见优化方向:
| 慢查询问题 | 优化方式 |
|---|---|
| 定时任务全表扫描 | 给状态字段、时间字段、订单号加索引 |
| 一次查询几万行 | 改成分页批处理 |
| 大量 update 单条执行 | 改成批量更新或分批事务 |
| 统计报表实时计算 | 改成中间表或预计算 |
| 查询和写入都打主库 | 读写分离或报表库 |
| 任务和前台共用连接池 | 限制定时任务连接数 |
例如订单同步,不建议这样:
SELECT * FROM orders WHERE status = 'pending';如果订单表很大,应该加时间范围和分页:
SELECT id, order_no, status
FROM orders
WHERE status = 'pending'
  AND updated_at >= '2026-05-01 00:00:00'
ORDER BY id ASC
LIMIT 500;
并确保有组合索引:
CREATE INDEX idx_status_updated_id ON orders(status, updated_at, id);这类优化比单纯升级 CPU 更关键。
有些项目卡顿,不是业务逻辑慢,而是日志写太多。
例如每处理一条订单都写一行日志:
订单 10001 同步开始
订单 10001 请求接口
订单 10001 返回结果
订单 10001 写入数据库
订单 10001 同步完成
如果一分钟处理几万条,日志文件会疯狂写入磁盘。
在 SATA SSD 或机械盘上尤其明显,即使用 NVMe,也会增加 IO 压力。
建议:
检查日志写入:
du -sh /www/project/storage/logs/*
du -sh /var/log/*
如果单个日志文件几十 GB,任务执行时还频繁写入,系统变慢很正常。
大量定时任务应该分成三类。
| 类型 | 示例 | 处理策略 |
|---|---|---|
| 高优先级 | 支付状态、订单状态、库存扣减、用户通知 | 小批量、高频率、优先队列 |
| 中优先级 | 商品同步、CRM 同步、接口轮询 | 队列化、限制并发 |
| 低优先级 | 报表、统计、备份、日志压缩、缓存预热 | 夜间执行、限速、低优先级 |
可以用 nice 降低低优先级任务的 CPU 抢占:
nice -n 10 php /www/project/report.php可以用 ionice 限制低优先级任务的磁盘 IO:
ionice -c2 -n7 php /www/project/report.php备份脚本尤其建议加:
ionice -c2 -n7 nice -n 10 sh /root/backup.sh这样即使备份在跑,也不会严重影响前台业务。
如果你的业务已经不是几个简单 crontab,而是几十个、上百个定时任务,建议按下面方式设计。
Nginx / PHP-FPM / Web 后台
        ↓
业务数据库 MySQL
        ↓
Redis 队列
        ↓
Supervisor 管理 Worker
        ↓
高优先级队列 / 默认队列 / 低优先级队列
        ↓
监控 CPU、IO、队列长度、失败任务、慢查询| 模块 | 建议 |
|---|---|
| Web 服务 | Nginx + PHP-FPM,限制 PHP-FPM 最大进程数 |
| 队列服务 | Redis 独立运行,避免和 MySQL 争资源 |
| Worker 管理 | Supervisor 或 systemd |
| 定时调度 | crontab 只启动 schedule,不直接堆业务脚本 |
| 数据库 | 开启慢查询日志,关键表加索引 |
| 日志 | 按模块分文件,定期切割 |
| 备份 | 放在低峰期,使用 ionice/nice 限制资源 |
| 监控 | CPU、load、iowait、磁盘 util、Redis 队列长度、MySQL 慢查询 |
推荐配置:
CPU:AMD EPYC 4584PX / 4585PX,16核32线程
内存:64GB DDR5
硬盘:960GB NVMe SSD
带宽:100M BGP + 直连 CN2
适合:
优化重点:
推荐配置:
CPU:AMD EPYC 4584PX / 4585PX,16核32线程
内存:128GB DDR5
硬盘:960GB / 1.92TB NVMe SSD
带宽:100M BGP + 25M CN2 或更高优化线路
适合:
优化重点:
推荐配置:
CPU:AMD EPYC 9554,64核128线程
内存:256GB DDR5
硬盘:NVMe SSD
带宽:根据采集源和回源方向选择 BGP / CN2 / 三网优化线路
适合:
优化重点:
推荐配置:
CPU:双路 AMD EPYC 7713,128核256线程
内存:256GB / 512GB
硬盘:多块 NVMe SSD
用途:虚拟化、多业务隔离、多项目队列分开部署
适合:
优化重点:
假设一台香港 AMD EPYC 16核32线程服务器,每到整点后台打开变慢,订单同步也延迟。
可以按这个顺序查。
uptime
top
如果 load average 高,比如:
load average: 45.20, 38.10, 22.80说明系统压力明显偏高。
mpstat 1如果看到:
%iowait 35.00说明不是纯 CPU 问题,而是大量任务在等磁盘。
iostat -x 1如果 %util 长时间接近 100%,说明磁盘已经成为瓶颈。
ps aux --sort=-%cpu | head
ps aux --sort=-%mem | head
如果发现大量 php artisan、python sync、backup.sh 同时跑,就说明任务调度过密。
crontab -l
ls /etc/cron.d/
重点看是不是大量任务集中在:
0 * * * *
*/5 * * * *
0 0 * * *SHOW PROCESSLIST;如果大量 SQL 卡在 Sending data、Copying to tmp table,就要优化 SQL 和索引。
redis-cli llen queues:default如果队列持续增长,就要看 worker 是否不足,或者任务本身太慢。
大量定时任务不是不能放在香港 AMD 服务器上跑,关键是要把结构做好。
不要所有任务都放在整点。
错误:
0 * * * * task-a
0 * * * * task-b
0 * * * * task-c
0 * * * * task-d
优化:
2 * * * * task-a
11 * * * * task-b
23 * * * * task-c
41 * * * * task-d不要一次处理 10 万条数据。
可以拆成每批 500 条、1000 条。
Order::where('status', 'pending')
    ->orderBy('id')
    ->chunkById(500, function ($orders) {
        foreach ($orders as $order) {
            dispatch(new SyncOrderJob($order->id));
        }
});high:订单、支付、库存
default:同步、通知、接口任务
low:报表、统计、清理、备份高优先级任务优先消费,低优先级任务不影响核心业务。
worker 不是越多越好。
如果 MySQL 最多只能稳定承受 100 个连接,你开 200 个 worker 只会让数据库崩得更快。
建议先从少量开始:
high:2-4 个
default:4-8 个
low:1-2 个
根据 CPU、IO、MySQL 连接数慢慢调。
备份、压缩、日志清理不要和业务任务同时跑。
30 3 * * * ionice -c2 -n7 nice -n 10 sh /root/backup.sh外部 API 不稳定时,如果没有超时,worker 会一直卡住。
建议:
连接超时:3-5 秒
读取超时:10-30 秒
失败重试:指数退避
最大重试:3 次左右失败任务无限重试会把队列拖死。
建议设置:
tries:3
backoff:60 / 300 / 900 秒
失败进入 failed_jobs 表
人工或后台重新处理不是所有卡顿都要升级服务器,也不是所有问题靠优化能解决。
| 情况 | 建议 |
|---|---|
| CPU 没跑满,但 IO wait 很高 | 优化磁盘写入、SQL、日志、备份 |
| 同一个任务重复出现很多进程 | 加锁,防止重叠执行 |
| 整点卡顿 | 定时任务错峰 |
| 队列堆积但 CPU 空闲 | 增加 worker 或优化任务逻辑 |
| 数据库慢查询多 | 加索引、分页、拆表、预计算 |
| 低优先级任务影响前台 | 分队列、降优先级、限速 |
| 情况 | 建议 |
|---|---|
| CPU 长期 80% 以上 | 升级更高核心或更高主频 AMD EPYC |
| 内存长期不足,频繁 swap | 增加内存到 128GB / 256GB |
NVMe %util 长期接近 100% |
升级更强 NVMe 或拆分数据库/日志盘 |
| 队列任务量持续增长 | 升级多核心 AMD 或拆分任务服务器 |
| 多项目互相影响 | 使用更高规格服务器做虚拟化隔离 |
| 数据库和任务抢资源 | 数据库独立部署或使用更高配置 |
一句话:
如果是任务设计问题,先优化;如果是业务规模真的上来了,再升级。
如果让我给一个比较稳的部署方案,我会这样设计:
香港 AMD EPYC 服务器
├── Nginx / PHP-FPM:负责前台和后台访问
├── MySQL:业务数据库,开启慢查询
├── Redis:缓存 + 队列
├── Supervisor:管理 queue worker
├── Crontab:只负责调度,不直接跑大任务
├── high 队列:订单、支付、库存
├── default 队列:同步、接口、通知
├── low 队列:报表、统计、清理
└── backup:凌晨低峰,限速执行
如果是中小型企业后台,16核32线程 AMD EPYC + 64GB / 128GB 内存 + NVMe SSD 已经很合适。
如果是大量采集、报表、批处理、队列消费,建议直接考虑 64核128线程以上的 AMD EPYC 平台。
如果是多套业务混跑,就不要把所有任务堆在一个系统里,应该通过虚拟化、容器或独立服务器拆开。
香港 AMD 服务器跑大量定时任务,真正要解决的不是“能不能跑”,而是“怎么稳定跑”。
CPU 卡顿,要看核心数、单核性能、进程数量和上下文切换;
IO 卡顿,要看 NVMe 读写、MySQL、日志、备份和压缩任务;
队列卡顿,要看任务生产速度、worker 消费速度、失败重试和任务优先级;
数据库卡顿,要看慢查询、索引、连接数和大表扫描。
如果只是把所有任务堆进 crontab,再强的服务器也会在某个整点被打满。
真正稳定的方案,是把任务拆小、错峰、队列化、限流、监控,再结合合适的香港 AMD EPYC 服务器配置。这样既能发挥 AMD 多核心和高性能 NVMe 的优势,也能避免定时任务把前台业务、后台系统和数据库一起拖慢。


