

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


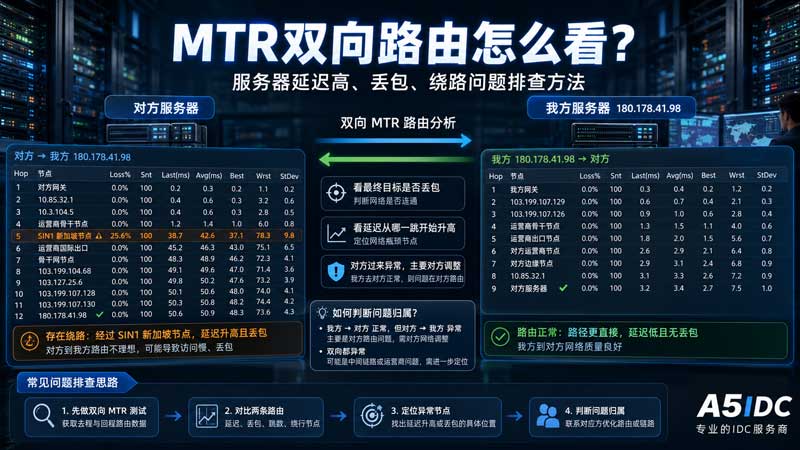
客户反馈“服务器延迟高”“访问慢”“跨机房连接不稳定”时,很多人第一反应是看 Ping。但在真实运维场景里,单纯 Ping 一个 IP 只能看到最终延迟,看不出数据包到底从哪里走、在哪一跳变慢、是不是中间绕了新加坡、日本、美国等节点。
这类问题更适合用 MTR 双向路由 来分析。所谓双向,就是不仅要测:
我们服务器 → 客户服务器还要测:
客户服务器 → 我们服务器因为互联网路由并不是来回同一条路。很多故障表面看是“服务器慢”,实际可能是对方过来的路由绕路,也可能是我们出去的路由不佳,还可能只是中间路由器禁用了 ICMP,并不是真丢包。
这篇文章我会按照真实 IDC 运维排查思路,把 MTR 双向路由怎么看、常见故障怎么判断、问题应该由谁调整、如何给上游提交工单讲清楚。
在服务器租用和托管业务中,客户经常会这样反馈:
我访问你们服务器延迟很高。
我这边 Ping 你们 IP 有 30ms。
我这边 MTR 中间有丢包。
我访问业务端口很卡,是不是你们网络有问题?
如果只是看 Ping,确实很容易误判。
比如客户 Ping 我们香港服务器显示 33ms,有人会直接认为:
“香港服务器怎么会 33ms?肯定是机房网络问题。”
但真实情况不一定。
因为 33ms 可能来自很多原因:
1. 客户服务器并不在香港;
2. 客户到我们服务器的路由绕了新加坡;
3. 双方网络没有本地互联,走了国际上游;
4. 中间节点 ICMP 回包慢,但业务流量正常;
5. 我们出去正常,但对方过来异常;
6. 对方出去正常,但我们过去异常;
7. 业务端口慢,但 ICMP 路由正常。
所以排查延迟问题,不能只问“Ping 多少”,而是要问:
从哪里测到哪里?
测的是 ICMP 还是 TCP?
最后一跳有没有丢包?
延迟是从哪一跳开始升高?
是否出现 hkg、sin、nrt、lax 等跨区域节点?
双向路由是否一致?
问题方向是谁发起的?
这就是为什么我们在处理跨机房、跨运营商、跨地区访问问题时,通常会优先要求客户提供 双向 MTR。
MTR 可以理解为 Ping 和 Traceroute 的结合版。
它既能看到数据包经过哪些路由节点,也能持续统计每一跳的延迟、丢包和抖动。
假设有两台服务器:
A:我们的服务器
B:客户的服务器
那么双向 MTR 至少要包含两份数据:
A → B:我们服务器访问客户服务器
B → A:客户服务器访问我们服务器
很多新手会以为:
A 到 B 延迟高,就一定是 A 的问题;
B 到 A 延迟高,就一定是 B 的问题。
这个理解还不够准确。
更严谨的判断应该是:
谁发起访问,就先看谁的出向路由;
哪一边的方向绕路,哪一边先找自己的服务商调整;
我们只能直接调整我们服务器出去的方向;
客户过来的方向,主要需要客户服务商调整。
这句话在实际售后沟通里非常重要。
常见 MTR 结果里,通常会看到这些字段:
| 字段 | 含义 | 排查重点 |
|---|---|---|
| Hostname | 路由节点 IP 或主机名 | 看运营商、城市代码、上游网络 |
| Loss% | 当前跳回应丢包率 | 不要只看单跳,要看是否持续到最终目标 |
| Snt / Sent | 发送包数量 | 建议至少 100 个,最好 200 个以上 |
| Last | 最后一次延迟 | 参考价值较低,容易受瞬时波动影响 |
| Avg | 平均延迟 | 最重要的延迟参考值 |
| Best | 最低延迟 | 判断链路理论最优值 |
| Wrst / Worst | 最高延迟 | 判断是否有抖动、拥塞 |
| StDev | 标准差/波动 | 越大说明延迟越不稳定 |
实际分析时,我一般按照这个优先级看:
第一,看最终目标有没有丢包;
第二,看丢包是否从某一跳开始持续;
第三,看延迟是否从某一跳开始持续升高;
第四,看节点名称里有没有地区代码;
第五,再结合双向 MTR 判断责任方向。
不要一上来就盯着中间某一跳的 100% Loss,那样很容易误判。
MTR 分析的第一步,不是看中间节点,而是看最后一跳。
比如:
目标 IP:Loss 0%
Avg:33ms
Worst:34ms
这种情况说明:
最终目标没有丢包;
延迟稳定;
问题更像是路由距离、绕路或互联路径不理想;
不太像链路质量严重故障。
如果最后一跳是这样:
目标 IP:Loss 20%
Avg:80ms
Worst:300ms
那就要重视了。
因为最终目标出现持续丢包,说明这个丢包可能真的影响业务。
然后继续往上找:
丢包是从哪一跳开始出现的?
后面的节点是不是也跟着丢?
最终目标是不是也丢?
判断标准很简单:
如果只有中间某一跳丢包,后面不丢,通常不是问题;
如果从某一跳开始,后面每一跳都丢,最终目标也丢,这才是真问题。这是 MTR 最容易误判的地方。
有些路由器会限制 ICMP 响应,或者把 ICMP 回包优先级调得很低。它可能不回复你的 MTR 请求,但仍然正常转发业务流量。
例如:
4  10.10.10.1              0% loss
5  No response from host   100% loss
6  103.x.x.x               0% loss
7  目标 IP                 0% loss
这种情况下,第 5 跳虽然显示 100% 丢包,但第 6 跳和最终目标都正常,说明第 5 跳只是“不回你”,不是“不转发”。
所以不能直接对客户说:
“中间 100% 丢包,所以线路有问题。”
正确判断应该是:
“该中间节点可能限制 ICMP 响应,后续节点和最终目标正常,暂不能作为真实丢包依据。”
同样,如果某一跳延迟特别高,但后面又恢复正常,也不一定是业务问题。
例如:
4  3ms
5  200ms
6  4ms
7  5ms
目标 5ms
这种一般也是该节点本身 ICMP 回应慢,不代表业务流量在这里慢。
真正需要关注的是这种情况:
4  3ms
5  4ms
6  35ms
7  36ms
8  35ms
目标 35ms
从第 6 跳开始,后面一直高,这才说明延迟在第 5 到第 6 跳之间开始被拉高。
这是判断绕路和跨区域的关键。
比如香港服务器到香港服务器,正常情况下,如果双方有较好的本地互联,常见延迟可能在几毫秒到十几毫秒之间。
但如果 MTR 里出现类似情况:
1  _gateway              2ms
2  103.x.x.x             2ms
3  103.x.x.x             1ms
4  hkg.example.net       3ms
5  hkg.example.net       4ms
6  sin1.example.net      33ms
7  hkg.peer.net          34ms
8  目标 IP               33ms
这里重点不是最终 33ms,而是:
hkg → sin1 → hkghkg 一般代表香港,sin 或 sg 通常代表新加坡。
如果双方都在香港,但路由从香港绕到新加坡,再回香港,那 33ms 就很正常了,因为物理路径被拉长了。
常见节点代码可以这样判断:
| 节点代码 | 可能地区 |
|---|---|
| hkg / hk | 香港 |
| sin / sg | 新加坡 |
| nrt / tyo | 日本东京 |
| lax | 洛杉矶 |
| sjc | 圣何塞 |
| sea | 西雅图 |
| tpe | 台湾 |
| fra | 法兰克福 |
| lhr / lon | 伦敦 |
但要注意,主机名只是参考,有些运营商命名不规范,所以最好结合 IP whois、上游 ASN、实际延迟一起判断。
这是客户沟通中最关键的一点。
假设我们服务器 IP 是:
180.178.41.98客户服务器 IP 是:
103.67.52.xxx如果客户从他的服务器 MTR 到我们服务器时,路由出现:
客户服务器
  ↓
香港节点
  ↓
新加坡节点 sin1
  ↓
再回香港
  ↓
我们的服务器 180.178.41.98
那说明异常主要出现在:
客户服务器 → 我们服务器这个方向。
这个方向的出向路由,通常由客户服务器所在机房和客户的上游网络控制。
也就是说,客户需要联系自己的服务器服务商,要求优化到我们 IP 段的出向路由。
我们这边可以协助提供反向 MTR,但我们不能直接控制客户网络怎么出站。
反过来,如果是:
我们的服务器 → 客户服务器这个方向绕路,那我们就可以找自己的上游或机房调整。
可以简单记成一句话:
对方过来绕路,主要让对方调整;
我们过去绕路,主要由我们找上游调整。
这个原则非常实用。
我们之前遇到过一个典型案例。
客户反馈从他的服务器访问我们的香港服务器,延迟稳定在 33ms 左右,认为是我们服务器线路问题。
当时我们做了双向 MTR。
方向是:
客户服务器 → 我们香港服务器最终目标没有丢包,延迟稳定在 33ms 左右。
但中间路由出现了类似:
hkg1
sin1
也就是香港节点后出现了新加坡节点。
如果客户服务器和我们的服务器都在香港,这条路径就明显不是本地最优互联,而是绕到了新加坡。
这时可以判断:
客户访问我们这个方向存在绕路;
问题不在我们服务器本机;
也不能简单说是我们机房出口故障;
更大概率是客户服务商到我们 IP 段的出向路由不佳。方向是:
我们香港服务器 → 客户服务器前几跳延迟基本在 1ms 到 5ms 之间,本地网关和机房出口正常,没有看到明显的新加坡绕路节点。
这说明:
我们服务器本地网络正常;
我们机房出口前段正常;
至少不能证明是我们这边服务器或接入口故障。这类问题最准确的表达不是“客户服务器坏了”,而是:
客户服务器访问我们服务器的出向路由存在绕路,需要客户联系其服务商优化到我们 IP 段的路由。
我们可以给客户提供这样的回复:
从双向 MTR 看,我方服务器本地网关和上游前段延迟正常,暂未发现我方服务器本机或机房出口异常。当前异常主要出现在贵方服务器访问我方 IP 的方向,路由中出现 sin1 节点,疑似经过新加坡转接。如果双方服务器均在香港,该路径并非最优本地互联,建议贵方联系服务器服务商,检查并优化到我方 IP 段的出向路由。这样的说法既专业,也不会显得在推卸责任。
MTR 是网络排查工具,但服务器配置也会影响最终业务体验。
我们在实际处理客户问题时,通常会结合服务器配置、业务端口和带宽模型一起判断。
下面是几个常见场景。
适合企业站、WordPress、ZBlog、外贸展示站、小型后台系统。
参考配置:
| 项目 | 配置建议 |
|---|---|
| CPU | Intel Xeon E3-1271 V3 或同级别 |
| 内存 | 16GB - 32GB |
| 硬盘 | 480GB / 960GB SSD |
| 带宽 | 100M BGP + 15M/25M CN2 直连 |
| 系统 | Ubuntu 22.04 / Debian 12 / Windows Server 2022 |
| 适用业务 | 企业站、博客、轻量接口、后台管理系统 |
这种配置下,如果客户反馈“访问慢”,不能只看 MTR。
还要看:
TTFB 是否高;
PHP-FPM 是否排队;
MySQL 查询是否慢;
磁盘 IO 是否高;
带宽是否跑满;
是否有爬虫或攻击流量。
如果 MTR 最终目标不丢包,延迟稳定,但网页打开慢,问题多半在 Web 服务或数据库。
适合高并发接口、游戏后端、数据库、私有化部署、跨境电商系统。
参考配置:
| 项目 | 配置建议 |
|---|---|
| CPU | AMD EPYC 4584PX / EPYC 4585PX |
| 核心线程 | 16 核 32 线程 |
| 内存 | 64GB - 128GB |
| 硬盘 | 960GB NVMe SSD / U.2 NVMe |
| 带宽 | 100M BGP + 25M CN2,或 1G 三网直连 |
| 系统 | Ubuntu 22.04 / CentOS 7.x / Windows Server 2022 |
| 适用业务 | API、高并发网站、游戏逻辑服、数据库主从 |
这种配置 CPU 和磁盘性能比较强,如果 MTR 正常但业务慢,需要重点看应用层:
top
htop
iostat -x 1
sar -n DEV 1 10
ss -s
netstat -antp
如果网络不丢包,但 load average 很高、磁盘 %util 长期接近 100%、MySQL 慢查询严重,那就不是线路问题。
适合图片站、下载站、短视频分发、直播回源、海外业务加速节点。
参考配置:
| 项目 | 配置建议 |
|---|---|
| CPU | Intel Xeon Gold 6138 / AMD EPYC 系列 |
| 内存 | 64GB - 256GB |
| 硬盘 | NVMe SSD / 多盘 RAID |
| 带宽 | 1G 三网直连回国 / 3G 国际带宽 |
| 端口 | 1G / 10G 端口 |
| 适用业务 | 下载、视频、对象存储、CDN 回源、文件分发 |
这种业务经常不是“延迟问题”,而是“吞吐问题”。
排查时除了 MTR,还要看:
单线程下载速度;
多线程下载速度;
不同地区下载速度;
晚高峰是否拥塞;
出网带宽是否跑满;
是否被单个大客户或爬虫占满连接。
测试命令可以使用:
wget -O /dev/null http://测试文件地址
curl -o /dev/null http://测试文件地址
iperf3 -c 目标IP -P 8
如果 MTR 延迟正常,但下载速度很慢,就要继续分析 TCP 窗口、单线程瓶颈、跨区域运营商质量和带宽占用。
适合海外业务、跨境电商、AI 应用、下载分发、海外用户访问。
参考配置:
| 项目 | 配置建议 |
|---|---|
| CPU | AMD EPYC 9554 / EPYC 9754 / Intel Xeon Gold |
| 内存 | 128GB - 512GB |
| 硬盘 | NVMe SSD |
| 带宽 | 1G 三网直连 / 3G 国际带宽 / 10G 独享带宽 |
| 线路 | CN2 GIA + 9929 + CMIN2,或国际 BGP |
| 适用业务 | 海外 AI、下载、跨境电商、游戏、视频分发 |
美国服务器到中国大陆用户的延迟本来就不可能像香港一样低。
所以排查时不能只看“延迟高不高”,而要看是否符合物理距离和线路类型。
例如:
美国西海岸到中国大陆 130ms - 180ms:不一定异常;
美国东海岸到中国大陆 200ms+:也可能正常;
美国绕欧洲再回中国:这才是明显异常;
CN2 GIA 晚高峰丢包:需要重点查上游拥塞;
国际 BGP 便宜带宽波动大:属于线路属性问题。
所以不同地区的服务器,MTR 判断标准不能完全一样。
下面这个表可以作为日常排查模板。
| MTR 现象 | 可能原因 | 判断方法 | 处理方向 |
|---|---|---|---|
| 中间某一跳 100% Loss,最终 0% Loss | 中间路由器禁 ICMP | 后续节点正常 | 忽略该跳 |
| 中间某一跳延迟很高,后面恢复正常 | ICMP 回包低优先级 | 高延迟未持续 | 忽略该跳 |
| 从某一跳开始延迟持续升高 | 跨区域、绕路、上游互联不佳 | 后续节点都高 | 查该跳城市和运营商 |
| 从某一跳开始丢包并持续到最终 | 真实链路丢包 | 最终目标也丢 | 找该跳所属网络处理 |
| 第一跳就丢包 | 本机网卡、交换机、网关问题 | 第 1 跳异常 | 查服务器和机房接入 |
| 最后一跳丢包,前面不丢 | 目标服务器限 ICMP、防火墙、负载高 | 测 TCP 端口 | 查目标主机 |
| ICMP 正常,业务慢 | 应用层问题 | 测 TCP、HTTP、TTFB | 查 Web、数据库、磁盘 |
| A 到 B 正常,B 到 A 异常 | B 方出向路由问题 | 双向对比 | B 方找服务商 |
| 晚高峰明显变差 | 上游拥塞 | 分时段 MTR | 找上游优化线路 |
| 只有某运营商慢 | 单运营商路由问题 | 电信/联通/移动分别测 | 优化对应运营商线路 |
一般出现下面几类情况,才更倾向于我们服务器或我们机房出口问题。
如果 MTR 显示:
1  _gateway  Loss 10%  Avg 50ms
2  上游节点   Loss 10%  Avg 60ms
3  后续节点   Loss 10%  Avg 70ms
这说明问题从本地网关附近就开始了。
需要检查:
服务器网卡是否丢包;
交换机端口是否异常;
网线、光模块是否有错误包;
服务器负载是否过高;
网卡速率和双工是否异常;
bond 配置是否正常;
机房网关是否拥塞。
Linux 可以执行:
ip -s link
ethtool eth0
dmesg | grep -i eth
sar -n DEV 1 10
iostat -x 1
如果看到网卡大量 errors、dropped、overruns,就要联系机房检查接入口。
如果我们的服务器访问:
8.8.8.8
1.1.1.1
香港其他 IP
国内电信 IP
国内联通 IP
国内移动 IP
客户服务器 IP
都出现高延迟或丢包,那问题就不是某一个客户网络,而更像我们服务器出口或上游异常。
这时要检查:
服务器是否被攻击;
出口带宽是否跑满;
上游是否拥塞;
路由策略是否变更;
是否有异常大流量连接;
是否有防火墙清洗策略影响。如果只有一个客户说慢,可能是单点路由问题。
但如果多个地区、多个运营商客户同时反馈访问我们慢,那就要重点查我们这边。
尤其是:
电信用户慢;
联通用户慢;
移动用户慢;
海外用户也慢;
所有方向都有丢包。
这类情况通常不是单个客户网络问题,而要排查服务器、带宽、上游线路和清洗设备。
下面这些情况,更像对方服务商或对方上游需要处理。
其他客户访问我们正常,只有某一个对方服务器访问我们延迟高。
这种情况下,优先怀疑双方之间的路由互联,而不是我们服务器整体故障。
例如:
对方服务器 → 香港节点 → 新加坡节点 → 我们服务器如果双方都是香港服务器,这就是明显绕路。
这条路由是对方发起的,通常需要对方联系服务商优化出向路由。
如果我们到其他香港、国内、海外 IP 都正常,只到对方 IP 延迟高或绕路,那一般不是我们整体出口问题,而是到对方 IP 段的特定路由不佳。
这时可以两边一起处理:
我们找上游检查:我们 → 对方;
对方找服务商检查:对方 → 我们。很多客户反馈的不是 Ping 慢,而是:
网站打开慢;
游戏端口卡;
API 请求超时;
SSH 卡顿;
远程桌面不稳定;
数据库跨机房同步慢。
这些业务都是 TCP 或 UDP 流量。
ICMP MTR 正常,只能说明 Ping 层面大致正常,不代表业务端口一定正常。
所以实际排查时,还要测 TCP MTR。
mtr -rwzc 200 目标IPmtr -T -P 443 -rwzc 200 目标IPmtr -T -P 80 -rwzc 200 目标IPmtr -T -P 22 -rwzc 200 目标IP例如游戏端口是 27015:
mtr -T -P 27015 -rwzc 200 目标IPWindows 可以用:
tracert 目标IP
pathping 目标IP
Test-NetConnection 目标IP -Port 443
如果有 tcping,也可以测:
tcping 目标IP 443如果 ICMP 正常,但 TCP 443 丢包或延迟高,就要重点查防火墙、业务端口、清洗策略、WAF、连接数限制等问题。
有些客户会说:
“我 Ping 你们服务器只有 30ms,但网站打开要 5 秒。”
这时候就不能继续盯着 MTR 看了。
因为网络层可能没问题,真正慢的是应用层。
可以用 curl 测网站各阶段耗时:
curl -o /dev/null -s -w "DNS:%{time_namelookup} TCP:%{time_connect} TLS:%{time_appconnect} TTFB:%{time_starttransfer} Total:%{time_total}\n" https://域名输出可能类似:
DNS:0.012 TCP:0.035 TLS:0.082 TTFB:1.856 Total:2.314这里如果 TCP 很低,说明网络连接不慢。
但 TTFB 很高,说明服务器后端响应慢,可能是:
PHP 执行慢;
数据库查询慢;
缓存没有命中;
磁盘 IO 高;
程序接口阻塞;
后端连接池不够;
WordPress 插件过多;
MySQL 慢查询严重。
所以 MTR 只是网络层排查工具,不能代替应用层诊断。
不要只说:
客户反馈慢,请处理。这种工单上游很难判断。
建议按固定格式提交:
源 IP:
目标 IP:
测试方向:
测试时间:
测试协议:ICMP / TCP 443 / TCP 业务端口
MTR 包数:100 或 200
异常表现:延迟高 / 丢包 / 绕路
异常节点:
期望优化方向:
完整 MTR 截图或文本:
例如对方到我们绕新加坡,可以这样写:
源 IP:103.67.52.xxx
目标 IP:180.178.41.98
方向:客户服务器访问我方服务器
现象:路由中出现 sin1 节点,疑似绕新加坡
结果:最终延迟约 33ms,无明显丢包
判断:如双方服务器均在香港,该路径不是最优本地互联
建议:请客户联系其服务商优化到 180.178.41.98 的出向路由,尽量走香港本地互联
如果是我们到客户方向异常,可以给我们上游这样提交:
源 IP:180.178.41.98
目标 IP:103.67.52.xxx
方向:我方服务器访问客户服务器
现象:从某某节点后延迟升高,疑似上游互联绕路
诉求:请协助检查我方到该目标 IP 段的出向路由,是否可以优化为更优香港本地互联路径
提交的数据越完整,上游越容易处理。
以后遇到客户反馈“延迟高、丢包、访问慢”,可以按下面流程处理。
先问清楚:
客户源 IP 是什么?
访问目标 IP 是什么?
双方服务器分别在哪个地区?
客户反馈的是 Ping 慢,还是业务端口慢?
业务端口是多少?
是否所有地区都慢,还是只有某个地区慢?
问题是一直存在,还是晚高峰才出现?我们服务器执行:
mtr -rwzc 200 客户IP客户服务器执行:
mtr -rwzc 200 我们IP如果是网站或业务端口,继续测 TCP:
mtr -T -P 443 -rwzc 200 目标IP判断最终目标是否丢包:
最终目标 0% Loss:重点看延迟和绕路;
最终目标持续丢包:重点找丢包从哪一跳开始;
最终目标不响应:改测 TCP 业务端口。单跳丢包,后面正常:通常忽略;
单跳高延迟,后面恢复:通常忽略;
从某一跳开始持续升高:重点分析;
从某一跳开始持续丢包到最终:重点处理。我们 → 客户 异常:我们找上游优化;
客户 → 我们 异常:客户找其服务商优化;
双方都异常:两边同时提交路由优化。测 TCP 端口;
测 curl TTFB;
查 CPU、内存、磁盘 IO;
查 Web 日志;
查数据库慢查询;
查防火墙和连接数。表现:
香港到香港出现 sin、nrt、lax 等节点;
延迟从几毫秒升到几十毫秒甚至上百毫秒;
最终目标不一定丢包。
处理方式:
确认双方服务器实际地区;
确认异常方向;
发起方向找自己的服务商优化出向路由;
要求尽量走本地互联、HKIX、本地 peer 或更优上游;
如果是我们方向异常,我们提交给上游处理。表现:
最终目标 Loss 10% - 30%;
业务访问明显卡顿;
MTR 后几跳也持续丢包。
处理方式:
定位丢包开始的节点;
如果从本地前几跳开始,查服务器和机房接入;
如果从上游骨干开始,提交上游;
如果只有目标最后一跳丢,查目标服务器防火墙、负载和 ICMP 限制。表现:
白天正常;
晚上 8 点到 11 点延迟升高或丢包;
部分运营商明显变差。
处理方式:
分时段保留 MTR;
记录白天和晚高峰对比;
提交给上游判断是否拥塞;
必要时切换 CN2、CMIN2、9929 或其他精品线路。表现:
Ping 正常;
MTR 不丢包;
网页打开慢;
TTFB 很高。
处理方式:
查 Web 服务;
查数据库;
查缓存;
查 PHP-FPM;
查磁盘 IO;
查 CDN 回源;
查 SSL 握手;
查程序接口耗时。表现:
wget 单线程速度慢;
多线程下载速度明显提高;
MTR 延迟正常。
处理方式:
检查 TCP 窗口;
检查跨境链路质量;
增加多线程下载策略;
优化 CDN 分发;
根据业务选择更适合的大带宽线路。MTR 排查是发现问题的方法,但更重要的是前期选对服务器和线路。
建议优先考虑:
香港 CN2 服务器;
香港 BGP + CN2 直连;
美国 CN2 GIA + 9929 + CMIN2 精品线路。
如果预算有限,可以选择:
100M BGP + 15M/25M CN2如果业务对速度要求高,可以选择:
30M 三网精品线路;
1G 三网直连回国;
CN2 GIA + 9929 + CMIN2 组合线路。如果用户主要在海外,未必一定要选 CN2。
这类业务更看重国际出口、带宽容量和目标地区覆盖。
可以考虑:
美国 1G / 3G 国际带宽服务器;
美国 10G 大带宽服务器;
香港 3G 国际带宽服务器;
日本本地大带宽服务器。这类业务不只看平均延迟,更看:
抖动;
丢包;
晚高峰稳定性;
回程质量;
跨运营商表现。
建议选择:
低延迟 BGP;
精品回国线路;
CN2 / 9929 / CMIN2;
足够的带宽冗余;
独立物理服务器。这类业务更关注吞吐能力:
端口大小;
独享带宽;
磁盘 IO;
多线程下载;
CDN 回源;
缓存命中率。
建议选择:
1G 三网直连;
3G 国际带宽;
10G 端口;
NVMe SSD;
大内存缓存;
必要时配合 CDN。服务器延迟高,不一定就是服务器问题。
MTR 也不是看一眼中间丢包就能下结论。
真正专业的排查思路应该是:
先看最终目标是否丢包;
再看丢包是否持续到最终;
再看延迟是否从某一跳开始持续升高;
再看节点是否存在跨区域绕路;
最后结合双向 MTR 判断责任方向。
最关键的一句话是:
对方过来异常,主要对方调整;
我们过去异常,主要我们调整;
双向都异常,两边一起找上游优化。
对于 IDC 服务商来说,MTR 的价值不只是“证明谁的问题”,更重要的是把故障定位清楚:
是本机网卡问题?
是机房网关问题?
是上游出口问题?
是国际绕路问题?
是对方服务商出向路由问题?
还是业务层程序慢?
只有把问题分清楚,后面的处理才不会乱。
在我们日常运维中,很多客户反馈的“服务器慢”,最后并不是服务器配置不够,也不是机器本身故障,而是线路方向、上游互联、跨区域绕路、业务端口或应用层响应造成的。
所以遇到延迟高、丢包、访问慢的问题,不建议只看一张 Ping 截图就下结论。更可靠的方式是做双向 MTR,再结合 TCP 端口、业务响应时间、服务器负载和带宽使用率一起判断。
如果业务对网络质量要求比较高,例如跨境电商、游戏后端、直播回源、海外 API、下载分发、AI 应用访问等,建议在选择服务器时就提前确认线路类型、回程质量、带宽模型和目标用户地区。这样后期遇到网络问题时,才有更清晰的优化空间


