

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


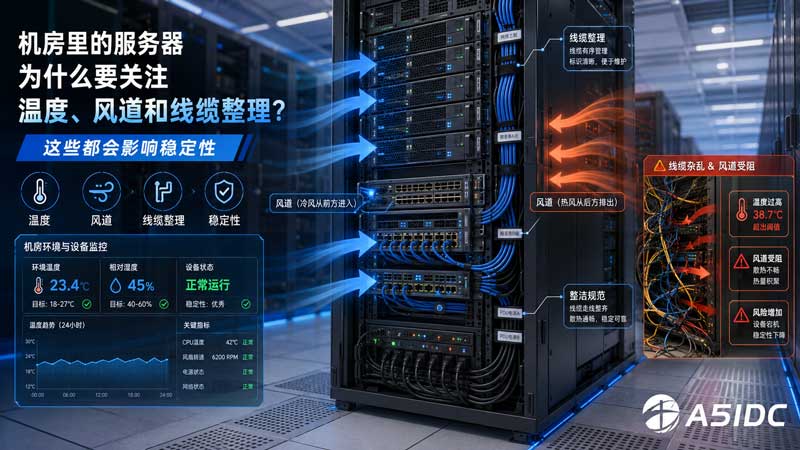
很多用户租用香港服务器、美国服务器时,最关心的是 CPU、内存、硬盘、带宽和线路,比如是不是 CN2、是不是 BGP、多大带宽、NVMe 还是机械盘。但真正到了机房运维现场,我反而越来越重视一些“看起来不高级”的细节:温度、风道、线缆整理、机柜布线、电源冗余。
这些东西平时不显眼,机器正常跑的时候,客户也很少会问。但一旦服务器出现随机重启、硬盘掉线、网卡闪断、CPU 降频、业务晚高峰卡顿,最后排查下来,经常不是系统装错了,也不是网站代码突然变差了,而是机房环境和服务器物理状态出了问题。
这篇文章我就从真实运维角度说清楚:为什么机房里的服务器必须关注温度、风道和线缆整理,它们到底怎么影响稳定性,又应该怎么检查和整改。
我之前遇到过一台香港物理服务器,配置并不低:
| 项目 | 配置 |
|---|---|
| CPU | Intel Xeon Gold 6138,20核40线程 |
| 内存 | 64GB DDR4 ECC |
| 系统盘 | 960GB NVMe SSD |
| 数据盘 | 2 × 2TB SSD |
| 带宽 | 100M BGP,含 25M CN2 优化带宽 |
| 系统 | Ubuntu 22.04 LTS |
| 业务 | 跨境电商独立站 + 后台订单系统 |
客户反馈的问题很模糊:
“网站不是完全打不开,就是有时候后台特别慢,晚上偶尔 502,重启 Nginx 又好了。”
一开始从系统层面看,CPU 使用率并不高,内存也够,磁盘空间正常,Nginx 和 PHP-FPM 配置也没有明显错误。但继续查日志时发现,问题集中在晚上访问高峰期,同时服务器风扇转速明显变高,BMC 传感器里 CPU 温度、NVMe 温度都接近告警线。
这类问题最容易误判。因为它不像硬盘坏道那样直接报错,也不像带宽打满那样一眼能看出来。温度异常往往表现为:
所以我经常说,服务器稳定性不是只看“配置够不够”,还要看这台机器能不能在机房里长期、稳定、低风险地跑起来。
很多人一听服务器温度,就以为只要机房空调温度足够低就可以。实际上,服务器散热看的不是“机房冷不冷”,而是:
冷空气有没有进到服务器前面板,热空气有没有顺利从后面排出去。
一台服务器内部一般是前进风、后出风。冷空气从硬盘位、前面板进入,经过 CPU 散热器、内存、主板芯片组、PCIe 设备、电源模块,再从后部排出。如果前面吸不到冷风,或者后面的热风又被卷回前面,温度就会异常。
在实际运维中,我比较关注这些温度范围:
| 部件 | 建议关注范围 | 风险表现 |
|---|---|---|
| CPU | 长期尽量控制在 70℃以内,高负载不建议长期接近 85℃ | 降频、重启、性能波动 |
| NVMe SSD | 建议长期低于 60℃,高于 70℃要重点关注 | 写入降速、I/O 延迟升高 |
| 机械硬盘 | 建议 30℃-45℃较理想,长期超过 50℃风险增加 | 坏道、重映射、掉盘 |
| 内存 DIMM | 长期高温会增加 ECC 纠错和不稳定风险 | 进程崩溃、系统异常 |
| 网卡 / 光模块 | 高温可能导致链路 flap | 网络闪断、丢包 |
| 电源模块 | 高温会降低冗余可靠性 | 电源告警、意外断电 |
这里有个重点:
不是温度偶尔高一下就一定有问题,而是温度长期高、波动大、局部温度明显异常,才是最危险的。
比如一台服务器 CPU 60℃,另一台 CPU 72℃,不一定说明后者马上有故障。但如果同一排机柜里,只有某一台机器 CPU 长期比旁边高 15℃,那就要查风道、灰尘、散热器、硅脂、风扇和机柜位置了。
有些服务器配置很好,比如:
| 项目 | 配置 |
|---|---|
| CPU | AMD EPYC 7402P,24核48线程 |
| 内存 | 128GB DDR4 ECC |
| 硬盘 | 2 × 960GB NVMe SSD |
| 网卡 | 双口万兆网卡 |
| 带宽 | 1Gbps 国际带宽 / 或 100M BGP + CN2 优化 |
| 业务 | API 接口、高并发 Web、数据同步服务 |
这种机器本身算力不弱,但如果机柜风道不好,高负载下就很容易出现“配置很强,但体验不稳定”的情况。
机房风道常见问题有几个。
标准机房一般会做冷通道和热通道。服务器前面吸冷风,后面排热风。如果机柜摆放、挡板、地板风口设计不好,就会出现热风回流。
热风回流以后,服务器前面吸进去的不是 22℃ 的冷空气,而可能是 30℃ 甚至更高的混合热空气。这样服务器风扇会一直拉高转速,但效果并不理想。
很多人觉得机柜中间空几个 U 位没关系。实际上,空 U 位如果不加盲板,热风会从空位回流到前方冷通道,破坏整个机柜的风压。
这种问题在高密度机柜中特别明显。尤其是双路 CPU、GPU 服务器、存储服务器集中上架时,空 U 位不封堵,会让局部温度明显升高。
有些临时维护后,网线、电源线、标签、扎带头可能挡在服务器前面板附近。看起来只是“线有点乱”,但它可能直接影响进风。
尤其是 1U 服务器,本身内部空间就紧凑,风扇小而密,前面一旦被挡住,CPU、内存、硬盘温度都会跟着上升。
机柜后部如果电源线、网线、光纤线、DAC 线缆全部堆在服务器出风口附近,热风排不出去,也会造成局部积热。
这类问题在万兆网卡、多盘位存储服务器上比较常见。看起来线缆只是乱,实际上已经影响散热。
线缆整理很多人以为只是机房形象问题,其实它和稳定性关系非常大。
尤其是香港服务器、美国服务器这类面向跨境电商、游戏、直播、短视频业务的机器,网络稳定性非常关键。线路再好,如果机柜内部线缆压弯、松动、受热、标签混乱,也可能导致排查困难甚至业务中断。
常见线缆问题包括:
| 问题 | 可能后果 |
|---|---|
| 网线过度弯折 | 千兆/万兆链路误码、协商异常 |
| 光纤弯曲半径过小 | 光衰增加、链路不稳定 |
| DAC 线缆压在出风口 | 影响散热,线材受热老化 |
| 电源线和网线混杂 | 维护困难,误拔风险高 |
| 没有标签 | 故障时无法快速定位端口 |
| 线缆过长堆叠 | 阻挡风道,形成热区 |
| 临时跳线未固定 | 震动或维护时可能松动 |
我见过最典型的问题是:服务器偶发网络中断,系统日志里看到网卡 link down / link up,客户以为是运营商线路问题。但最后到机柜现场检查,发现是网线水晶头接触不稳,线缆还被其他电源线压着。换线、重新固定后,问题直接消失。
所以机房里“线缆整齐”不是形式主义,而是为了:
不是所有服务器对散热的要求都一样。配置越高、功耗越大、硬盘越密集、PCIe 设备越多,对机房风道和线缆整理越敏感。
适合企业官网、轻量 WordPress、展示站、小型后台。
| 项目 | 示例配置 |
|---|---|
| CPU | E3-1271 V3 / E3-1270 V6 |
| 内存 | 16GB / 32GB ECC |
| 硬盘 | 240GB SSD / 480GB SSD |
| 带宽 | 100M BGP,含 25M CN2 |
| 系统 | CentOS 7.x / Ubuntu 22.04 |
这类机器功耗不高,散热压力相对小。但如果机柜环境差,也会出现硬盘温度偏高、风扇异常、网卡掉线等问题。
重点关注:
适合跨境电商、API 接口、订单系统、会员系统。
| 项目 | 示例配置 |
|---|---|
| CPU | Intel Xeon Gold 6138 / AMD EPYC 7402P |
| 内存 | 64GB / 128GB ECC |
| 硬盘 | 960GB NVMe SSD / RAID 1 SSD |
| 带宽 | 100M BGP + 25M CN2 / 1Gbps 国际带宽 |
| 系统 | Ubuntu 22.04 LTS |
这类机器高峰期 CPU、内存、磁盘 I/O 都会明显上升。温度一旦不稳定,最容易出现“白天正常,晚上卡顿”的问题。
重点关注:
适合备份、图片站、下载站、日志归档、对象存储。
| 项目 | 示例配置 |
|---|---|
| CPU | Intel Xeon Silver / AMD EPYC |
| 内存 | 64GB ECC |
| 硬盘 | 4 × 14TB HDD |
| RAID | RAID 5 / RAID 10 |
| 带宽 | 100M-1Gbps |
| 系统 | Ubuntu 22.04 / Debian |
存储服务器最怕硬盘长期高温。机械盘不是不能跑热,而是长期高温会增加坏道、重映射、掉盘和阵列降级风险。
重点关注:
适合大模型推理、视频转码、图像处理、AI 业务。
| 项目 | 示例配置 |
|---|---|
| CPU | AMD EPYC / Intel Xeon Gold |
| 内存 | 128GB / 256GB ECC |
| GPU | RTX 4090 / A100 80GB |
| 硬盘 | 1.92TB NVMe SSD |
| 带宽 | 1Gbps / 10Gbps |
| 系统 | Ubuntu 22.04 + CUDA |
GPU 服务器对风道非常敏感。GPU 卡本身发热高,如果机箱风道、PCIe 位置、线缆布局不合理,很容易出现 GPU 温度高、显存温度高、风扇满转、推理性能波动。
重点关注:
服务器稳定性排查不能只看 top 和 df -h,还要把硬件状态一起看。
ipmitool sensor重点看:
CPU Temp
System Temp
Inlet Temp
Exhaust Temp
Fan Speed
PSU Status
DIMM Temp
如果有 BMC 面板,也可以直接在远程管理里看温度曲线、风扇转速、电源状态和历史告警。
lscpu
cat /proc/cpuinfo | grep MHz | head
cpupower frequency-info
如果高负载时 CPU 频率明显低于标称频率,就要判断是否因为温度、功耗墙或 BIOS 策略导致降频。
nvme smart-log /dev/nvme0重点看:
temperature
warning_temp_time
critical_comp_time
media_errors
num_err_log_entries
如果 NVMe 长期接近 70℃,即使还没坏,也可能已经影响写入性能。
smartctl -a /dev/sda重点看:
Temperature_Celsius
Reallocated_Sector_Ct
Current_Pending_Sector
Offline_Uncorrectable
UDMA_CRC_Error_Count
如果 UDMA_CRC_Error_Count 增加,不一定是硬盘坏,也可能是线缆、背板、控制器接触问题。
dmesg | grep -i eth
dmesg | grep -i link
ethtool eth0
ethtool -S eth0
重点看:
link down
link up
rx_errors
tx_errors
crc_errors
dropped
如果 CRC 错误增加,要重点检查网线、光模块、交换机端口和线缆弯折情况。
journalctl -k | grep -i error
journalctl -k | grep -i thermal
journalctl -k | grep -i mce
建议安装:
apt install rasdaemon
systemctl enable --now rasdaemon
ras-mc-ctl --summary
它可以帮助观察内存 ECC、MCE 等硬件层面的异常。
很多温度问题,不能只靠降低空调温度解决。空调温度再低,如果风道混乱,冷空气进不到服务器,问题依然存在。
重点动作:
如果是高密度机柜,可以把 GPU 服务器、双路 CPU 服务器、存储服务器分散摆放,避免局部热量过高。
重点动作:
很多服务器内部风道是经过设计的,机箱盖板打开后,气流反而会乱,温度不一定更低。
线缆整理建议按类型分区:
| 线缆类型 | 整理建议 |
|---|---|
| 电源线 | 单独走线,避免压住网线和光纤 |
| 网线 | 按服务器编号和交换机端口打标签 |
| 光纤 | 保持合理弯曲半径,避免硬折 |
| DAC 线 | 不要压在服务器出风口 |
| 管理口线缆 | 独立标记,便于远程维护 |
| 临时跳线 | 使用后及时拆除或正式固定 |
一台服务器建议至少标清楚:
服务器编号
公网网口
内网网口
IPMI 管理口
交换机端口
电源 A 路
电源 B 路
这样后期维护时,工程师不会靠猜,也不容易误拔。
建议给不同级别设置告警:
| 告警级别 | 条件示例 | 处理动作 |
|---|---|---|
| 提醒 | CPU 长期超过 70℃ | 观察趋势 |
| 警告 | NVMe 超过 65℃ | 检查风道 |
| 严重 | 硬盘超过 50℃ | 立即检查硬盘位进风 |
| 紧急 | 风扇故障 / PSU 故障 | 安排现场处理 |
| 紧急 | 网卡频繁 link down | 查线缆、端口、光模块 |
监控不要只看当前值,还要看趋势。比如某块硬盘温度从 38℃ 慢慢升到 48℃,虽然还没报错,但已经说明散热环境在变差。
服务器上架后,不建议只装完系统就交付。尤其是高并发 Web、数据库、GPU、存储业务,最好做一次基础压力验证。
例如 Web / 数据库服务器可以观察:
stress-ng --cpu 16 --timeout 600s
iostat -x 1
vmstat 1
NVMe 可以做短时间 I/O 测试:
fio --name=test --filename=/data/testfile --size=10G --rw=randread --bs=4k --iodepth=32 --numjobs=4 --runtime=300 --time_based --group_reportingGPU 服务器可以观察:
nvidia-smi -l 1重点不是为了跑出多漂亮的分数,而是观察:
推荐配置示例:
CPU:Intel Xeon Gold 6138 / AMD EPYC 7402P
内存:64GB ECC
硬盘:960GB NVMe SSD
带宽:100M BGP + 25M CN2 优化
系统:Ubuntu 22.04 LTS
环境:Nginx + PHP-FPM + MySQL / Redis
关注点:
跨境电商站最怕“偶发慢”。用户打不开一次,可能订单就丢了。所以这类业务不能只看平均延迟,还要看高峰期的稳定性。
推荐配置示例:
CPU:Intel Xeon Silver / AMD EPYC
内存:64GB ECC
硬盘:4 × 14TB HDD
阵列:RAID 10 优先,容量优先可选 RAID 5
带宽:1Gbps 国际带宽
系统:Debian / Ubuntu
关注点:
存储服务器不怕 CPU 高,怕的是硬盘长期在高温下跑,再叠加 RAID 重建,风险会成倍增加。
推荐配置示例:
CPU:高主频 Xeon / AMD EPYC
内存:64GB-128GB ECC
硬盘:NVMe SSD
带宽:CN2 / BGP 多线优化
系统:Ubuntu 22.04
关注点:
游戏和 API 场景对延迟抖动非常敏感。哪怕服务器没有宕机,只要链路误码、CPU 降频、网卡闪断,都可能让用户感觉“卡”“掉线”“请求超时”。
推荐配置示例:
CPU:AMD EPYC / Intel Xeon Gold
内存:128GB-256GB ECC
GPU:RTX 4090 / A100 80GB
硬盘:1.92TB NVMe SSD
带宽:1Gbps / 10Gbps
系统:Ubuntu 22.04 + NVIDIA Driver + CUDA
关注点:
GPU 服务器最不能忽略风道。GPU 本身发热高,如果出风口被线缆挡住,或者机柜热风回流,性能会明显波动。
如果你已经租用了一台物理服务器,可以按下面这个思路检查。
uptime
top
free -h
df -h
iostat -x 1
journalctl -p err -n 100
看 CPU、内存、磁盘、系统错误日志。
ipmitool sensor
smartctl -a /dev/sda
nvme smart-log /dev/nvme0
dmesg | grep -i error
看温度、硬盘健康、NVMe 状态、硬件错误。
ethtool eth0
ethtool -S eth0
mtr -rw 目标IP
ping 目标IP
看链路速率、错误包、丢包、延迟抖动。
curl -o /dev/null -s -w "%{time_connect} %{time_starttransfer} %{time_total}\n" https://www.example.com重点看:
time_connect       连接耗时
time_starttransfer 首字节时间 TTFB
time_total         总耗时
如果系统负载不高,但 TTFB 高,要继续查数据库、PHP、缓存、网络和硬件温度是否存在关联。
对于服务器租用服务商来说,稳定性不是一句“硬件配置高”就能解决的。真正负责的交付应该包括:
对于客户来说,服务器稳定不仅仅取决于买了什么 CPU,也取决于服务商是否真的懂机房、懂硬件、懂线路、懂运维现场。
很多服务器故障,在用户眼里是“网站慢了”“后台卡了”“服务器不稳定”。但从机房现场看,背后可能是:
所以,机房里的温度、风道和线缆整理,绝不是“看起来整齐一点”这么简单。它们直接决定服务器能不能在高负载、长时间、复杂网络环境下稳定运行。
对于跨境电商、游戏、视频、下载站、数据库、AI 推理这类业务来说,服务器稳定性不是单点配置决定的,而是由硬件配置、机房环境、线路质量、风道设计、线缆管理、监控告警和运维经验共同决定的。
真正稳定的服务器,不只是参数表上好看,而是放进机房之后,温度压得住,风道走得顺,线缆理得清,故障能提前发现,维护能快速定位。这样的服务器,才适合长期承载业务。


