

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


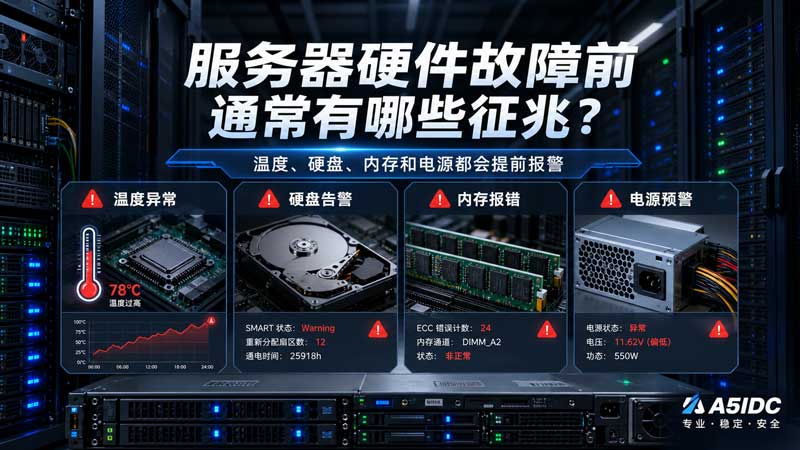
在机房运维里,我一直有个很深的感受:服务器硬件故障真正“毫无征兆”的情况并不多。更多时候,它在坏之前已经给过很多信号,只是这些信号不一定会直接表现成“网站打不开”。
比如:
真正危险的不是硬件会坏,而是硬件已经在报警,我们还把它当成“服务器偶尔卡一下”“凌晨负载有点高”“硬盘读写慢一点”。
这篇文章不讲太多空泛概念,而是站在香港服务器、跨境电商、游戏后端、企业网站、存储服务器这些真实业务场景下,拆一下服务器硬件故障前通常会出现哪些征兆,以及该怎么提前发现、提前处理。
A5IDC 官网当前产品体系中,香港服务器覆盖热销服务器、AMD EPYC 高性能服务器、GPU 服务器、存储服务器、站群服务器和大带宽服务器等类型;部分香港服务器支持 CN2/GIA+BGP、100Mbps-10Gbps 带宽、NVMe SSD、企业级大容量硬盘等配置,可根据业务场景组合使用。
硬件故障排查不能只说“CPU、内存、硬盘、电源”,因为不同服务器配置的风险点并不一样。
下面用几类常见香港服务器配置举例。
| 业务类型 | 推荐配置示例 | 重点关注硬件 |
|---|---|---|
| 企业官网 / WordPress / 小型电商 | E3-1271 V3 / 16G 内存 / SSD / 100M BGP + 25M CN2 | SSD 健康度、CPU 温度、单电源稳定性 |
| 中大型网站 / API / 游戏后台 | Xeon Gold 6138 / 64G 内存 / 960G NVMe SSD / CN2+BGP | NVMe 温度、内存 ECC、风扇、BMC 日志 |
| 高并发业务 / 虚拟化 / 多容器部署 | AMD EPYC 9554 / DDR5 内存 / NVMe SSD / 大带宽 | CPU Package 温度、内存通道、NVMe 磨损、供电 |
| 图片站 / 下载站 / 备份业务 | 4 × 14TB 企业级硬盘 / RAID 5 或 RAID 10 | SMART 坏道、RAID 重建风险、硬盘温度 |
| AI 推理 / 视频转码 | A100 80GB 或 RTX 4090 48GB / 高性能 CPU / NVMe | GPU 温度、PCIe 报错、电源冗余、机箱散热 |
A5IDC 香港产品页中也能看到类似的产品方向,例如香港 AMD 服务器适合高并发和虚拟化场景,香港 GPU 服务器可选 A100 80GB / RTX 4090 48GB,香港存储服务器支持 4 × 企业级 14TB 或更大规模硬盘阵列。
这也说明一个问题:
服务器配置越高,越不能只监控 CPU 使用率和带宽流量。
高性能 CPU、NVMe、RAID 阵列、GPU、电源模块、风扇、温度传感器,都应该纳入硬件巡检体系。
服务器温度问题很少一开始就让机器宕机,它更多表现为性能波动、频率下降、风扇狂转、硬盘变慢,最后才可能演变成硬件损坏。
CPU 温度异常常见表现:
| 征兆 | 可能原因 |
|---|---|
| 业务高峰期响应变慢 | CPU 降频保护 |
| load average 升高,但 CPU 使用率不算特别高 | 线程等待、频率下降、I/O 被拖慢 |
| 风扇长期高转速 | 散热压力大或风道异常 |
| BMC 出现 Thermal Warning | CPU、主板或机箱温度接近阈值 |
| 服务器突然重启 | 过热保护或电源联动保护 |
在高并发 Web、游戏后端、API 服务里,CPU 温度高不一定表现为 CPU 100%,而是表现为“同样的访问量,响应时间变长了”。
比如一台 AMD EPYC 9554 或 Xeon Gold 6138 服务器,平时 CPU Package 温度在 55℃-70℃之间比较正常。如果长期接近 85℃甚至更高,就要排查散热器、硅脂、风扇、机房冷通道、进风口灰尘和机柜风道。
很多人只盯 CPU 温度,却忘了 NVMe SSD 也会过热降速。
NVMe 在高并发数据库、日志写入、缓存盘、图片站缩略图生成场景下,会持续写入。如果盘温长期超过 70℃,就可能出现:
dmesg 里出现 NVMe reset 或 timeout;可以用:
nvme smart-log /dev/nvme0重点看:
temperature
available_spare
percentage_used
media_errors
num_err_log_entries
如果是 SATA SSD 或机械盘,可以用:
smartctl -a /dev/sda硬盘故障是服务器最常见、也是最容易被低估的硬件问题。
尤其是香港存储服务器、图片站、下载站、备份服务器,如果用了 4 × 14TB 企业级硬盘做 RAID 5 或 RAID 10,就不能只看“磁盘还能不能挂载”。
重点看这些字段:
| SMART 字段 | 含义 | 风险判断 |
|---|---|---|
| Reallocated_Sector_Ct | 已重映射扇区 | 出现增长就要关注 |
| Current_Pending_Sector | 待映射坏扇区 | 非常危险,建议尽快换盘 |
| Offline_Uncorrectable | 离线不可修复扇区 | 数据风险较高 |
| UDMA_CRC_Error_Count | 传输错误 | 可能是硬盘线、背板或接口问题 |
| Power_On_Hours | 通电时间 | 结合盘龄判断老化 |
| Temperature_Celsius | 硬盘温度 | 长期过高会加速损耗 |
检查命令:
smartctl -a /dev/sda
smartctl -a /dev/sdb
smartctl -a /dev/sdc
smartctl -a /dev/sdd
如果看到:
Current_Pending_Sector = 8
Offline_Uncorrectable = 2
不要等 RAID 掉盘。这个时候就应该安排更换硬盘,并检查备份是否完整。
很多用户觉得 RAID 5 有容错,坏一块盘没关系。问题在于:
真正危险的是 RAID 重建过程。
比如 4 块 14TB 机械盘做 RAID 5:
如果业务是备份归档、冷数据、低频读取,RAID 5 可以考虑。
但如果是图片站、下载站、企业资料库、高频访问文件服务,RAID 10 更稳。
| 报警情况 | 建议动作 |
|---|---|
| SMART 偶发 CRC Error | 先检查线缆、背板、硬盘槽位 |
| Pending Sector 增长 | 尽快备份并换盘 |
| RAID 出现 Degraded | 不要重启乱操作,先确认阵列状态 |
| 多块盘 SMART 异常 | 优先备份,不要立即强制重建 |
| NVMe Media Error | 评估更换,避免数据库继续写入 |
RAID 状态可根据控制器使用:
storcli /c0 show
storcli /c0 /eall /sall show
或:
megacli -AdpAllInfo -aALL
megacli -PDList -aALL内存问题比硬盘更隐蔽。
硬盘坏了,通常有 SMART、RAID、I/O 报错;
内存坏了,可能只是偶尔程序崩溃、数据库异常、系统重启、容器莫名退出。
服务器一般使用 ECC 内存。ECC 的价值不是让内存永远不出错,而是能发现并纠正一部分错误。
内存错误常见分为:
| 类型 | 说明 | 风险 |
|---|---|---|
| Corrected Error | 已纠正错误 | 偶发可观察,持续增长要处理 |
| Uncorrected Error | 无法纠正错误 | 高危,可能导致宕机或数据损坏 |
| DIMM Slot Error | 某条内存槽位异常 | 需要定位内存条或主板插槽 |
| MCE Error | CPU/内存控制器机器检查异常 | 需要结合日志判断 |
检查命令:
dmesg | grep -i -E "edac|mce|memory|ecc"
journalctl -k | grep -i -E "edac|mce|ecc"
安装 rasdaemon:
apt install rasdaemon -y
systemctl enable --now rasdaemon
ras-mc-ctl --summary
ras-mc-ctl --errors内存故障不一定立刻蓝屏或宕机,它可能表现为:
如果是高并发香港服务器,比如 AMD EPYC 9554 + DDR5 内存,用来跑虚拟化、容器集群、数据库、多站点业务,内存稳定性非常关键。
一条内存有问题,影响的不是一个网站,而可能是一整批业务。
| 情况 | 建议 |
|---|---|
| 偶发 Corrected Error | 记录 DIMM 槽位,持续观察 |
| Corrected Error 持续增长 | 计划维护窗口更换内存 |
| Uncorrected Error | 尽快下线迁移业务 |
| 某个 DIMM 反复报错 | 优先更换该条内存 |
| 换内存后仍报同槽位 | 检查主板插槽或 CPU 内存控制器 |
很多人只有在服务器断电后才想到电源问题。实际上,服务器电源故障前也会有征兆。
尤其是 GPU 服务器、高核心 CPU 服务器、大硬盘存储服务器,功耗更高,对电源冗余和稳定性要求更高。
| 征兆 | 可能原因 |
|---|---|
| BMC 记录 PSU Lost / PSU Failure | 电源模块异常 |
| 服务器偶尔自动重启 | 电源瞬断、电压波动、过载保护 |
| GPU 高负载时重启 | 电源功率不足或供电不稳 |
| 多硬盘同时掉线 | 背板供电或电源输出异常 |
| 风扇、电源状态灯异常 | 冗余电源或机箱供电模块故障 |
查看 BMC / IPMI 传感器:
ipmitool sdr
ipmitool sensor
ipmitool sel list
重点关注:
Power Supply
PSU
Voltage
Fan
Temp
如果看到类似:
Power Supply 1 | Failure detected
Voltage 12V | Lower Critical
就不能只重启服务器解决。电源异常可能影响硬盘、主板、网卡、GPU,甚至造成数据写入损坏。
如果是 A100 80GB、RTX 4090 48GB 这类 GPU 服务器,电源问题更要重视。
典型风险包括:
nvidia-smi 显示 GPU 掉卡;检查 GPU 状态:
nvidia-smi
nvidia-smi -q
dmesg | grep -i -E "nvrm|pcie|aer|xid"
如果出现 NVIDIA Xid 错误,需要结合 GPU 温度、电源、驱动、PCIe 插槽一起排查,不能简单判断为“显卡坏了”。
Linux 系统日志能看到很多问题,但硬件层面的温度、电源、风扇、ECC、主板事件,很多时候要看 BMC/IPMI。
ipmitool sel list
ipmitool sel elist
ipmitool sensor
ipmitool sdr
常见高危日志:
| 日志关键词 | 说明 |
|---|---|
| Thermal Trip | 温度触发保护 |
| CPU Temp Upper Critical | CPU 温度超过临界值 |
| Fan Failure | 风扇故障 |
| Power Supply Failure | 电源模块故障 |
| Voltage Lower Critical | 电压低于阈值 |
| Memory ECC Error | 内存 ECC 报错 |
| Drive Fault | 硬盘故障 |
| Watchdog Reset | 看门狗触发重启 |
很多客户反馈“服务器昨天凌晨自己重启了”,系统里可能只看到一次 reboot。
但 IPMI SEL 里可能已经清楚记录了:
Voltage Lower Critical
Power Unit Failure
System Restart
这就是判断硬件故障和系统故障的关键区别。
推荐关注:
适合配置:
E3-1271 V3 / 16G 内存 / SSD / 100M BGP + 25M CN2这种配置成本可控,适合企业官网、博客、轻量 WordPress、展示型网站。
但建议至少开启硬盘 SMART 定期检查,不要只看网站是否能访问。
推荐关注:
适合配置:
Xeon Gold 6138 / 64G 内存 / 960G NVMe SSD / CN2+BGP 线路这类业务一旦硬盘延迟上升,表现出来就是支付接口慢、后台订单加载慢、游戏接口超时。
所以不能等硬盘坏了才换,要在 SMART、NVMe Error Log、I/O 延迟开始异常时就处理。
推荐关注:
适合配置:
AMD EPYC 9554 / DDR5 内存 / NVMe SSD / 100M-10Gbps 带宽这种服务器核心数多、内存容量大、I/O 能力强,非常适合高并发 API、SaaS 平台、虚拟化节点、多容器部署。
但它的巡检标准也要更高,不能再用“top 看一下 CPU,df 看一下硬盘”的老办法。
推荐关注:
适合配置:
4 × 企业级 14TB 硬盘 / RAID 5 或 RAID 10 / 香港 BGP 或 CN2 线路如果是图片站、素材站、下载站,建议优先 RAID 10。
如果是备份归档、冷数据存储,可以考虑 RAID 5,但必须有异地备份。
记住一句话:
RAID 不是备份,RAID 只是提高可用性。
建议每天跑一次基础巡检:
#!/bin/bash

echo "===== Disk SMART ====="
smartctl -H /dev/sda
smartctl -H /dev/sdb

echo "===== NVMe SMART ====="
nvme smart-log /dev/nvme0 2>/dev/null

echo "===== IPMI Sensor ====="
ipmitool sensor

echo "===== Kernel Hardware Error ====="
dmesg | grep -i -E "mce|edac|ecc|nvme|reset|error|fail" | tail -50

echo "===== RAID Status ====="
storcli /c0 show 2>/dev/null
可以配合 crontab:
0 8 * * * /root/check_hardware.sh >> /var/log/hardware_check.log 2>&1每周至少看一次:
ipmitool sel list
smartctl -a /dev/sda
smartctl -a /dev/sdb
journalctl -k --since "7 days ago"
重点不是看一次,而是看趋势:
如果服务器数量超过 3 台,建议不要靠人工巡检。
可以采用:
| 工具 | 用途 |
|---|---|
| Prometheus + Grafana | 指标采集和可视化 |
| node_exporter | CPU、内存、磁盘、网络 |
| smartmon_exporter | 硬盘 SMART |
| ipmi_exporter | 温度、电源、风扇 |
| blackbox_exporter | 端口、HTTP、Ping 探测 |
| Zabbix | 传统 IDC 运维监控 |
| Alertmanager | 微信、邮件、Webhook 告警 |
告警阈值可以参考:
| 项目 | 建议告警条件 |
|---|---|
| CPU 温度 | 连续 5 分钟超过 85℃ |
| NVMe 温度 | 连续 5 分钟超过 70℃ |
| HDD 温度 | 长期超过 50℃ |
| Pending Sector | 大于 0 即告警 |
| ECC Corrected Error | 同一 DIMM 持续增长 |
| PSU Failure | 立即告警 |
| Fan Failure | 立即告警 |
| RAID Degraded | 立即告警 |
很多硬件故障最怕用户第一反应就是重启。
比如:
正确顺序应该是:
先保留现场日志
→ 判断业务是否需要迁移
→ 检查备份是否完整
→ 再决定更换硬件或维护
建议先执行:
dmesg -T > /root/dmesg_before_repair.log
journalctl -k > /root/kernel_before_repair.log
ipmitool sel list > /root/ipmi_sel_before_repair.log
smartctl -a /dev/sda > /root/sda_smart_before_repair.log如果用户在 A5IDC 租用香港服务器,可以按业务类型建立不同巡检策略。
适合:
建议配置:
E3-1271 V3 / 16G 内存 / SSD / 100M BGP + 25M CN2巡检重点:
适合:
建议配置:
Xeon Gold 6138 / 64G 内存 / NVMe SSD
或
AMD EPYC 9554 / DDR5 内存 / NVMe SSD
巡检重点:
适合:
建议配置:
4 × 企业级 14TB 硬盘 / RAID 10如果更重视容量,可以考虑 RAID 5;如果更重视稳定性和重建安全,建议 RAID 10。
巡检重点:
适合:
建议配置:
A100 80GB 或 RTX 4090 48GB
搭配高性能 CPU、NVMe SSD 和冗余电源
巡检重点:
服务器硬件一定会老化,硬盘会坏,内存会报错,风扇会磨损,电源模块也可能异常。真正体现运维能力的,不是保证硬件永远不坏,而是能不能在故障变成事故前提前发现。
对香港服务器用户来说,尤其是跨境电商、游戏后端、企业官网、存储备份、AI 推理这类业务,硬件巡检不应该只停留在“服务器还能不能访问”。
更应该定期看:
温度有没有异常
硬盘 SMART 有没有坏块
内存 ECC 有没有增长
电源有没有告警
风扇有没有异常
BMC 日志有没有硬件事件
RAID 状态是否健康
NVMe 是否出现错误日志
如果这些信号都能提前发现,很多所谓的“服务器突然宕机”,其实都可以变成一次有计划的维护。
这才是企业使用香港服务器时真正需要重视的稳定性建设


