香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


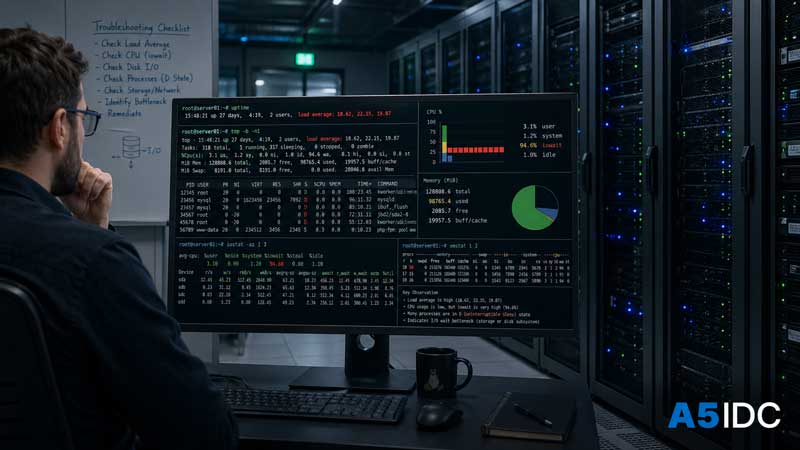
在服务器运维现场,我经常遇到一种很典型的情况:
网站打开变慢,SSH 登录也有点卡,uptime 一看:
load average: <span class="ͼb">18</span>.62, <span class="ͼb">22</span>.15, <span class="ͼb">19</span>.87<span class="ͼd">top</span>很多人第一反应是:“是不是 CPU 不够了?要不要直接换高配机器?”
但实际上,Linux 服务器 load average 高,不一定代表 CPU 被打满。
它更像是一个“系统排队压力指标”,不只统计正在抢 CPU 的进程,还会把一部分处于 不可中断睡眠状态,也就是 D 状态 的进程算进去。
所以这类问题的关键不是马上升级 CPU,而是先判断:
服务器到底是在等 CPU,还是在等磁盘、网络、数据库、文件系统、内核资源?
这篇文章我就按一次真实服务器排查思路,把“load 高但 CPU 不高”的排查过程讲清楚。
Linux 的 load average 通常有三个值:
load average: <span class="ͼb">8</span>.20, <span class="ͼb">12</span>.35, <span class="ͼb">15</span>.67| 指标 | 含义 |
|---|---|
| 1 分钟 load | 最近 1 分钟系统平均负载 |
| 5 分钟 load | 最近 5 分钟系统平均负载 |
| 15 分钟 load | 最近 15 分钟系统平均负载 |
很多人误以为 load 就是 CPU 使用率,其实不是。
在 Linux 中,load average 主要统计两类进程:
所以会出现这种情况:
CPU idle <span class="ͼb">70</span>%<br>load average <span class="ͼb">30</span><span class="ͼ8">+</span>CPU 没有忙死,但系统里有大量进程卡在 I/O、磁盘、文件系统、数据库锁、网络存储或内核等待上。
不要看到 load 是 8、10、20 就立刻紧张,要结合 CPU 核心数看。
查看 CPU 核心数:
nproclscpuCPU(s): <span class="ͼb">16</span>| load 数值 | 判断 |
|---|---|
| load 4 | 对 16 核来说不高 |
| load 16 | 接近满负载,需要关注 |
| load 32 | 压力明显偏高 |
| load 60 | 通常已经有阻塞或排队问题 |
如果是一台 4 核服务器,load 16 就很危险;
但如果是一台 32 核服务器,load 16 可能还没到严重程度。
所以第一句话要记住:
load 要和 CPU 核心数一起看,不能孤立看数字。
以香港服务器业务场景举例,不同硬件配置对 load 的承受能力不同。
| 服务器类型 | 示例配置 | 适合业务 | load 判断重点 |
|---|---|---|---|
| 入门型香港服务器 | 4 核 / 8G / SSD / 100M BGP | 企业官网、小型 WordPress、轻量 API | load 超过 4 就要关注 |
| 中高性能香港服务器 | AMD EPYC 16 核 32 线程 / 64G / NVMe SSD / 100M BGP + 25M CN2 | 外贸站、跨境电商、接口服务 | load 超过 20 才算明显偏高 |
| 数据库型服务器 | AMD EPYC 24 核 48 线程 / 128G / NVMe RAID / 独享带宽 | MySQL、Redis、订单系统 | 更关注 I/O wait、磁盘延迟、锁等待 |
| 大带宽下载 / 图片业务服务器 | 多核 CPU / 64G+ 内存 / NVMe 或 SSD 阵列 / 1G 带宽 | 下载站、图片站、视频分发 | 更关注磁盘吞吐、网卡队列、连接数 |
如果是普通云服务器,CPU 低但 load 高,可能是磁盘性能或虚拟化资源限制。
如果是物理服务器,尤其是香港独立服务器,更多要关注磁盘 I/O、数据库、备份任务、网络文件系统和异常进程。
遇到 load 高但 CPU 不高,我一般按这个顺序排查:
1. 看 CPU 核心数和 load 是否匹配<br>2. 看 top 里的 wa、id、st<br>3. 找 R 状态和 D 状态进程<br>4. 查磁盘 I/O 是否堵塞<br>5. 查内存和 swap 是否异常<br>6. 查数据库、Web 服务、PHP-FPM 是否排队<br>7. 查网络连接和文件系统<br>8. 查硬件、内核、磁盘错误<br>9. 最后再决定是优化,还是升级服务器配置执行:
<span class="ͼd">top</span>%Cpu(s): <span class="ͼb">8</span>.0 us, <span class="ͼb">3</span>.0 sy, <span class="ͼb">0</span>.0 ni, <span class="ͼb">70</span>.0 id, <span class="ͼb">18</span>.0 wa, <span class="ͼb">0</span>.0 hi, <span class="ͼb">1</span>.0 si, <span class="ͼb">0</span>.0 st| 字段 | 含义 | 重点判断 |
|---|---|---|
| us | 用户态 CPU 使用率 | 应用程序消耗 CPU |
| sy | 内核态 CPU 使用率 | 系统调用、网络、文件系统开销 |
| id | CPU 空闲率 | id 很高但 load 高,要重点查阻塞 |
| wa | I/O wait | 磁盘或块设备等待 |
| st | steal time | 虚拟化环境中被宿主机抢走 CPU |
如果你看到:
id <span class="ͼb">70</span>%<br>wa <span class="ͼb">25</span>%CPU 不是瓶颈,磁盘 I/O 或存储层大概率有问题。
如果你看到:
id <span class="ͼb">80</span>%<br>wa <span class="ͼb">0</span>%<br>st <span class="ͼb">15</span>%如果是独立物理服务器,st 一般不会明显偏高。
执行:
<span class="ͼd">ps</span> <span class="ͼf">-eo</span> state,pid,ppid,cmd,wchan:32 <span class="ͼf">--sort</span><span class="ͼ8">=</span>state | <span class="ͼd">grep</span> <span class="ͼc">'^D'</span>D <span class="ͼb">2314</span> <span class="ͼb">1208</span> mysqld io_schedule<br>D <span class="ͼb">4412</span> <span class="ͼb">2211</span> php-fpm ext4_file_read_iter<br>D <span class="ͼb">5580</span> <span class="ͼb">1</span> rsync wait_on_page_bit_common<br>D <span class="ͼb">6122</span> <span class="ͼb">1</span> tar blk_mq_get_tag常见原因包括:
| D 状态来源 | 可能问题 |
|---|---|
| mysqld | 数据库磁盘 I/O 慢、锁等待、临时表落盘 |
| php-fpm | 读取文件慢、访问数据库慢、NFS 卡顿 |
| rsync / tar | 备份任务压垮磁盘 |
| nginx | 静态文件读取慢、日志写入慢 |
| java / node | 日志、缓存、数据库连接阻塞 |
| mount / nfs | 网络文件系统无响应 |
也可以统计一下 D 状态数量:
<span class="ͼd">ps</span> <span class="ͼf">-eo</span> state | <span class="ͼd">grep</span> <span class="ͼf">-c</span> D安装工具:
apt install sysstat iotop <span class="ͼf">-y</span>yum install sysstat iotop <span class="ͼf">-y</span>iostat <span class="ͼf">-xz</span> <span class="ͼb">1</span> <span class="ͼb">5</span>| 字段 | 含义 | 异常表现 |
|---|---|---|
| %util | 磁盘忙碌程度 | 长期接近 100% 说明磁盘打满 |
| await | I/O 平均等待时间 | SSD 超过几十 ms 就要关注 |
| r/s、w/s | 每秒读写次数 | 小文件高并发时会很高 |
| rkB/s、wkB/s | 每秒读写吞吐 | 大文件下载、备份时明显升高 |
| aqu-sz | 队列长度 | 队列越长,等待越严重 |
例如:
Device r/s w/s await %util<br>sda <span class="ͼb">5</span>.0 <span class="ͼb">320</span>.0 <span class="ͼb">85</span>.3 <span class="ͼb">99</span>.8磁盘已经接近满负载,进程大量等待 I/O,load 自然升高。
继续查是谁在读写:
iotop <span class="ͼf">-oPa</span>pidstat <span class="ͼf">-d</span> <span class="ͼb">1</span>mysqld<br>rsync<br>tar<br>gzip<br>php-fpm<br>java<br>nginx<br>updatedb<br>backup.sh<br>logrotate查看内存:
free <span class="ͼf">-h</span>swapon <span class="ͼf">--show</span>vmstat <span class="ͼb">1</span>si sosi、so 长时间不为 0,说明系统正在频繁使用 swap。例如:
procs <span class="ͼf">-----------memory----------</span> <span class="ͼf">---swap--</span><br> r b swpd free buff cache si so<br> <span class="ͼb">1</span> <span class="ͼb">18</span> 4096M 300M 200M <span class="ͼb">1</span>.2G <span class="ͼb">25</span> <span class="ͼb">40</span>b 代表阻塞进程数量,si/so 代表 swap in / swap out。这种情况通常说明:
服务器内存不足,进程被迫频繁换页,磁盘 I/O 被拖慢,load 被拉高。
常见于:
如果服务器跑的是 NGINX + PHP-FPM,可以先看连接数:
ss <span class="ͼf">-s</span>ss <span class="ͼf">-ant</span> | <span class="ͼd">awk</span> <span class="ͼc">'{print $1}'</span> | <span class="ͼd">sort</span> | uniq <span class="ͼf">-c</span>ESTAB<br>SYN-RECV<br>TIME-WAIT<br>CLOSE-WAITSYN-RECV 很多,可能是攻击、半连接过多或前端防护不足。CLOSE-WAIT 很多,可能是应用没有正确关闭连接。ESTAB 很多,说明业务并发较高,需要结合 NGINX、PHP-FPM、数据库一起看。查看 PHP-FPM 进程:
<span class="ͼd">ps</span> <span class="ͼf">-ylC</span> php-fpm <span class="ͼf">--sort</span>:rssPHP-FPM 常见优化方向:
pm = dynamic<br>pm.max_children = 50<br>pm.start_servers = 8<br>pm.min_spare_servers = 8<br>pm.max_spare_servers = 20<br>pm.max_requests = 500比如:
服务器内存:16GB<br>系统和 MySQL 预留:8GB<br>可给 PHP-FPM:8GB<br>单个 PHP-FPM 平均占用:120MB<br>合理 max_children ≈ 8000 / 120 = 66如果服务器上跑 MySQL,load 高但 CPU 不高,很常见的原因是:
查看 MySQL 当前连接:
mysqladmin processlistSHOW <span class="ͼ8">FULL</span> PROCESSLIST;SHOW ENGINE INNODB STATUS\GLATEST DETECTED DEADLOCK<br>TRANSACTIONS<br>FILE I/O<br>ROW OPERATIONS<br>BUFFER POOL AND MEMORYSHOW VARIABLES <span class="ͼ8">LIKE</span> <span class="ͼc">'slow_query_log'</span>;<br>SHOW VARIABLES <span class="ͼ8">LIKE</span> <span class="ͼc">'long_query_time'</span>;slow_query_log = 1<br>long_query_time = 1<br>log_queries_not_using_indexes = 1这种时候真正的问题不是 Web 服务,而是数据库响应变慢。
我在香港服务器上见过很多类似情况:
白天业务正常,晚上 load 突然升高。
一查发现是:
tar <span class="ͼf">-zcf</span> backup.tar.gz /www/wwwroot<br>mysqldump <span class="ͼf">--all-databases</span><br>rsync <span class="ͼf">-avz</span> /data remote:/backup建议备份时加限制。
例如 rsync 限速:
rsync <span class="ͼf">-avz</span> <span class="ͼf">--bwlimit</span><span class="ͼ8">=</span><span class="ͼb">20000</span> /data/ backup@remote:/backup/ionice 降低 I/O 优先级:
ionice <span class="ͼf">-c2</span> <span class="ͼf">-n7</span> tar <span class="ͼf">-zcf</span> backup.tar.gz /datanice 降低 CPU 优先级:
nice <span class="ͼf">-n</span> <span class="ͼb">19</span> ionice <span class="ͼf">-c2</span> <span class="ͼf">-n7</span> ./backup.sh如果是数据库备份,尽量避免在业务高峰直接 mysqldump 大库,可以考虑:
如果 load 很高、D 状态很多、iowait 高,同时系统日志里有磁盘错误,就要小心硬件问题。
查看内核日志:
dmesg <span class="ͼf">-T</span> | egrep <span class="ͼf">-i</span> <span class="ͼc">"error|fail|reset|timeout|ext4|xfs|nvme|ata|scsi"</span>journalctl <span class="ͼf">-k</span> <span class="ͼf">-p</span> warningsmartctl <span class="ͼf">-a</span> /dev/sdasmartctl <span class="ͼf">-a</span> /dev/nvme0n1Reallocated_Sector_Ct<br>Current_Pending_Sector<br>Offline_Uncorrectable<br>Media and Data Integrity Errors<br>Error Information Log Entries这种情况不要只重启服务,要尽快备份数据并检查硬件。
如果业务跑在 Docker、K8s 或容器环境里,还要查 CPU quota。
容器内看 CPU 可能不高,但实际上已经被限制了。
查看容器资源:
docker stats<span class="ͼd">cat</span> /sys/fs/cgroup/cpu.statnr_throttled 持续增加,说明进程被 CPU quota 限流。这种情况表现可能是:
宿主机 CPU 不高<br>容器内业务响应慢<br>load 偏高<br>应用线程排队下面这组命令适合现场快速排查:
uptime<br>nproc<br><span class="ͼd">top</span><span class="ͼd">ps</span> <span class="ͼf">-eo</span> state,pid,ppid,cmd,wchan:32 <span class="ͼf">--sort</span><span class="ͼ8">=</span>state | <span class="ͼd">grep</span> <span class="ͼc">'^D'</span><br><span class="ͼd">ps</span> <span class="ͼf">-eo</span> state | <span class="ͼd">grep</span> <span class="ͼf">-c</span> Dvmstat <span class="ͼb">1</span>iostat <span class="ͼf">-xz</span> <span class="ͼb">1</span> <span class="ͼb">5</span>iotop <span class="ͼf">-oPa</span><br>pidstat <span class="ͼf">-d</span> <span class="ͼb">1</span>free <span class="ͼf">-h</span><br>swapon <span class="ͼf">--show</span>ss <span class="ͼf">-s</span><br>ss <span class="ͼf">-ant</span> | <span class="ͼd">awk</span> <span class="ͼc">'{print $1}'</span> | <span class="ͼd">sort</span> | uniq <span class="ͼf">-c</span>dmesg <span class="ͼf">-T</span> | egrep <span class="ͼf">-i</span> <span class="ͼc">"error|fail|timeout|reset|nvme|ata|scsi|ext4|xfs"</span>mysqladmin processlist表现:
CPU idle 高<br>load 高<br>iowait 高<br>D 状态进程多<br>iostat %util 接近 100%ionice 和限速。适合升级方向:
AMD EPYC 多核 CPU<br>64G / 128G 内存<br>960GB NVMe PCIe Gen4 SSD<br>业务盘 + 备份盘分离表现:
free 可用内存低<br>swap 使用高<br>vmstat si/so 持续不为 0<br>load 高但 CPU 不高配置建议:
普通企业站:16G 内存起步<br>WordPress + MySQL:32G 更稳<br>跨境电商 / 订单系统:64G 起步<br>数据库独立部署:建议 64G / 128G表现:
Web 进程很多<br>MySQL CPU 不一定高<br>请求响应慢<br>load 持续升高<br>SHOW PROCESSLIST 有大量 Query / Locked / Sending data配置建议:
Web 服务器:16 核 / 32G / NVMe<br>数据库服务器:24 核 / 64G 或 128G / NVMe RAID<br>数据库尽量不要和备份、日志、大文件下载混跑表现:
凌晨 load 高<br>tar / gzip / rsync / mysqldump 占用 I/O<br>iowait 高<br>业务访问变慢ionice 降低 I/O 优先级。表现:
D 状态进程很多<br>wchan 显示 nfs / fuse / wait_on_page<br>本地 CPU 和磁盘都不高<br>访问挂载目录很慢不是所有 load 高都要升级,但出现下面情况时,就要认真考虑换配置。
如果业务高峰期:
iostat %util 长期 90%+<br>await 持续偏高<br>D 状态进程持续增加推荐方向:
AMD EPYC 16 核 32 线程<br>64G DDR4<br>960GB NVMe PCIe Gen4 SSD<br>100M BGP + 25M CN2 直连WordPress 外贸站<br>跨境电商独立站<br>中等访问量 API<br>企业官网集群节点如果一台服务器同时跑:
NGINX<br>PHP-FPM<br>MySQL<br>Redis<br>备份任务<br>图片处理<br>日志分析建议拆分为:
Web 前端服务器<br>数据库服务器<br>缓存服务器<br>备份服务器AMD EPYC 24 核 48 线程<br>64G / 128G DDR4<br>NVMe SSD<br>独立内网连接比如原来每天几千 IP,现在增长到几万 IP;
原来只是企业官网,现在变成跨境电商、接口服务、会员系统。
这时候 load 高可能不是故障,而是服务器配置已经接近上限。
升级建议:
| 业务类型 | 推荐配置 |
|---|---|
| 普通企业站 | 4 核 / 8G / SSD |
| WordPress 外贸站 | 8 核 / 16G / SSD 或 NVMe |
| 跨境电商独立站 | 16 核 / 32G 或 64G / NVMe |
| 数据库业务 | 24 核 / 64G 或 128G / NVMe |
| 下载 / 图片业务 | 多核 CPU / 大内存 / NVMe / 1G 带宽 |
| 高并发 API | 多台 Web + 独立 DB + Redis |
有一次,一台香港服务器出现访问卡顿。
服务器配置大概是:
CPU:AMD EPYC 16 核 32 线程<br>内存:64GB DDR4<br>硬盘:960GB NVMe SSD<br>带宽:100M BGP,含 25M CN2 直连<br>系统:Ubuntu 22.04<br>业务:WordPress + WooCommerce + MySQL现场看到:
load average: <span class="ͼb">38</span>.21, <span class="ͼb">42</span>.16, <span class="ͼb">36</span>.80top 里 CPU 并不高:us 12%<br>sy 5%<br>id 58%<br>wa 24%<span class="ͼd">ps</span> <span class="ͼf">-eo</span> state,pid,cmd,wchan:32 | <span class="ͼd">grep</span> <span class="ͼc">'^D'</span>php-fpm<br>mysqld<br>rsynciostat <span class="ͼf">-xz</span> <span class="ͼb">1</span> <span class="ͼb">5</span>%util 99%<br>await 80ms+凌晨备份脚本没有结束<br>rsync 正在同步大量图片<br>同时 mysqldump 还在导出数据库<br>WooCommerce 后台又在生成报表处理方式:
--bwlimit。ionice。处理后:
load 从 40+ 降到 5-8<br>CPU 使用率保持 20%-35%<br>网站后台恢复正常load 高不一定是 CPU 不够,很多时候是磁盘、数据库和备份任务在互相抢资源。
遇到 Linux 服务器 load average 很高但 CPU 不高,可以按这个逻辑判断:
CPU 不高 + iowait 高 = 优先查磁盘 I/O<br>CPU 不高 + D 状态多 = 查阻塞进程和文件系统<br>CPU 不高 + swap 高 = 查内存不足<br>CPU 不高 + MySQL 连接堆积 = 查慢 SQL 和锁等待<br>CPU 不高 + 夜间异常 = 查备份、日志、定时任务<br>CPU 不高 + 容器环境 = 查 cgroup 限制<br>CPU 不高 + dmesg 报错 = 查硬盘、RAID、文件系统Linux 的 load average 很像服务器的“排队长度”。
CPU 不高但 load 高,往往说明服务器不是算不动,而是某些资源被卡住了。
对于网站、数据库、跨境电商、API 服务来说,真正影响稳定性的通常不是单一 CPU 指标,而是:
CPU 调度<br>磁盘 I/O<br>内存和 swap<br>数据库锁<br>PHP-FPM 队列<br>备份任务<br>文件系统<br>网络连接<br>硬件健康服务器优化的核心不是盲目升级,而是先判断瓶颈在哪里。
该优化 SQL 就优化 SQL,该换 NVMe 就换 NVMe,该拆数据库就拆数据库,该升级多核高内存物理服务器时也不要硬撑。
这样处理,才能真正让 Linux 服务器稳定下来
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/1527.html