香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


那是一个普通的凌晨,我像往常一样在监控系统中查看香港服务器状态,突然间,屏幕上弹出了一条告警:RAID1 阵列进入了 degraded 状态!我知道,这意味着其中一块硬盘出了问题,而这台服务器正支撑着跨境电商和短视频直播业务,一旦出问题,后果不堪设想。
我赶紧远程登录服务器,发现两块 3TB 的企业级硬盘之一(/dev/sdb)已经从 RAID 阵列中被移除,数据丢失的风险陡然升高。赶紧调出 RAID 的详细信息,确认另一块盘仍在正常工作,但我深知,单盘运行的 RAID1 不等于安全,必须马上恢复。我记得自己也在心里默默祈祷:“千万不要再出什么意外。”
这台服务器配置了 AMD EPYC 7402P 处理器、256GB 内存和两块 3TB HDD,一直是我们平台的核心支撑。那一刻,我只能按下冷静的按钮,按照既定的恢复流程,逐步排查故障原因、替换硬盘并重建 RAID 阵列。在恢复过程中,我不仅解决了硬盘故障,还从中总结了不少现场运维的教训。
今天,站在这台恢复过来的机器面前,我决定把整个过程写下来,希望我的经历能帮助你们在遇到类似问题时,少走些弯路,多一些应对的信心和方法。
我是A5数据香港服务器租用托管公司一线运维,负责的这台机器规格如下:
| 项目 | 规格 | 说明 |
|---|---|---|
| 处理器 | AMD EPYC 7402P(24 核/48 线程,2.8 GHz 基础,最高可达 3.35 GHz) | 单插槽服务器平台,适合高并发电商/游戏/直播部署 |
| 内存 | 256 GB DDR4 ECC Registered | 用于电商/独立站+直播业务,内存充裕保证缓存、并发充裕 |
| 硬盘 | * 两块 HDD,每块 3 TB | 做软件 RAID1 以保证冗余 |
| 操作系统 | Ubuntu 22.04 LTS | 选择较稳定的长期支持版,适合生产环境 |
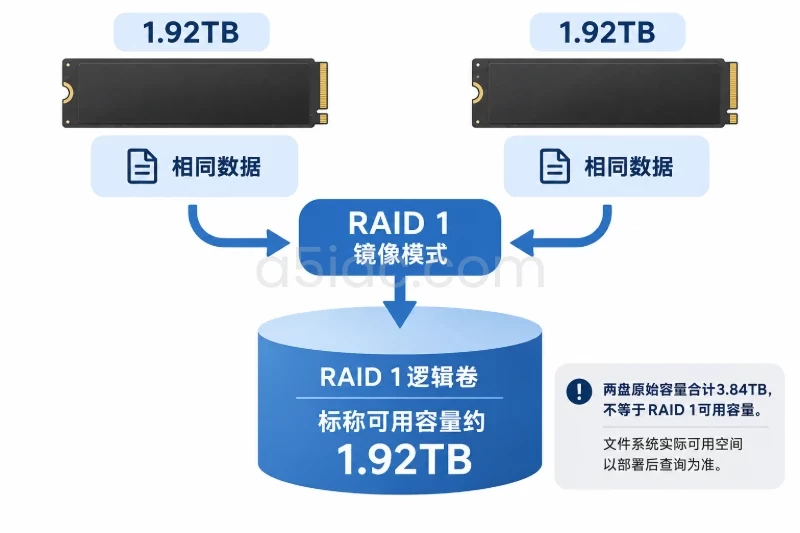
| 存储方案 | 软件 RAID1(两块3TB盘镜像)通过 mdadm 实现 |
方便主流 Linux 环境,便于日常运维管理 |
当时在香港机房(机柜 + 冗余 UPS +双路电源环境)我们将该机器用于“跨境电商 +短视频直播支撑”场景,数据盘使用两块 3 TB HDD(品牌、型号略)组成软件镜像(RAID1)以保证即便一块盘损坏也能继续运行。用 `mdadm` 工具初始化 RAID,安装 Ubuntu 22.04,配置 LVM/扩容、设定定期快照等。
在最初几个月运行顺利。但某日凌晨监控告警:系统提示 `/dev/md0` 进入 degraded 状态,且部分数据访问报错。下面就是我当时从现场开始的故障排查、原因定位、恢复过程。
在凌晨 02:17,我收到了监控邮件:“RAID device /dev/md0 degraded – only one member active”。我立即通过远程 SSH 登录服务器。执行:
sudo mdadm --detail /dev/md0结果显示:
/dev/md0:
  Version : 1.2
  Creation Time : 2024‑07‑15 10:12:00
  Raid Level : raid1
  Array Size : 2799696128 (2669.0 GiB  – approx 3 TB)
  Used Dev Size : 2799696128 (2669.0 GiB)
  Raid Devices : 2
  Total Devices : 2
  Active Devices : 1
  Working Devices : 1
  Failed Devices : 1
  Spare Devices : 0

  State : clean, degraded
  …
  /dev/sda1  active sync   1340G  …
  /dev/sdb1  removed
也发现 `/dev/sdb1` 被标记 removed。
与此同时,系统日志(`dmesg`、`/var/log/syslog`)出现多条类似:
[  512.123456] ata2.00: exception Emask 0x0 SAct 0x0 SErr 0x0 action 0x6 frozen
[  512.123562] ata2.00: failed command: READ FPDMA QUEUED
[  512.123845] ata2.00: status: { DRDY ERR }
[  512.124012] ata2.00: error: { UNC }
[  512.124210] ata2.00: configured for UDMA/133
表明 `sdb` 连接的那块盘出现读写错误,操作系统已将其从 RAID 中移除。
当时我先做了以下操作:
将 `sdb` 从 RAID 中剔除:
sudo mdadm /dev/md0 --fail /dev/sdb1 --remove /dev/sdb1暂时让阵列继续以单盘模式(degraded)运行,保证业务继续在线。
在香港机房现场登录 iDRAC 或 IPMI(根据服务器品牌)确认硬盘指示灯、故障码。
硬盘 `sdb` 型号为 “某品牌 3 TB HGST/WesternDigital 企业级 7200rpm SATA” (因为部署已两年,大约满负荷运行跨境电商/直播业务)。查看 SMART 信息:
sudo smartctl -a /dev/sdb发现如下关键字段:
Reallocated_Sector_Ct: 非零(数十)
Current_Pending_Sector: 多个
Offline_Uncorrectable: 一些
Device has insufficient spare sectors
说明硬盘已进入坏道转移期,继续运行风险过大。
最终判断:该盘硬件故障(坏道+读错误)引发 RAID1 副本挂掉。此时系统还工作,仅剩一块盘单机模式,隐患较大。
通过现场排查及硬件日志,我总结出这次 RAID1 数据丢失风险的主要原因如下:
`sdb` 出现大量坏道(SMART 报告显示重新映射计数、挂起扇区)
SATA 总线报告 `READ FPDMA QUEUED` 错误、`UNC` (uncorrectable) 错误,表明硬盘读取失败。
硬盘年龄+机房负载(24 × 7 跨境电商+直播)导致磨损加速。
虽然 RAID1 保证一盘坏另一盘还能用,但当剩余一个盘时,所有数据只有一份,若第二盘也出问题就直接掉数据。
在我的场景中,`sda` 还继续运行,但 `sdb` 出错后如果 `sda` 出问题就面临全盘丢失。
虽有定期快照/备份,但最近一次完整快照距今已有 5 天,且增量备份未必包含所有直播片段。
发现故障时,刚好在凌晨,现场响应稍有延迟。
在故障过程中,`sdb` 被移除,若直接将新盘放入而操作不慎,可能误删除元数据或分区表,从而造成“镜像缺失副本”或“RAID无法自动重建”。
我现场还发现 `/etc/mdadm/mdadm.conf` 未及时更新,重建过程中曾短暂出现 “missing superblock” 警告。
总结:硬盘老化 +负载重 +单盘降级期间继续运行风险高 → 引发数据丢失可能。及时响应、换盘、恢复 RAID 是关键。
下面我按“我在香港机房”的真实运维流程,分步骤说明如何从故障状态恢复镜像,并避免数据丢失。假设当前只剩 `/dev/sda1` 正在运行,阵列 `/dev/md0` 为 degraded 状态。
1. 购置一块 3 TB 企业级 SATA HDD(建议同规格或更高,如 HGST/WD 企业级 7200rpm)。
2. 确认服务器已在维护时间内(或有业务降级通知);但因本次为业务关键,我尽量在低峰期(凌晨)操作。
3. 停止或暂停相关服务,避免写入额外数据(虽镜像在运行,但恢复期间建议减少写入)。
4. 在现场断电或热插拔更换硬盘前,确认电源冗余、UPS 状态正常。
在物理机上将故障盘 `/dev/sdb` 下架/隔离。
安装新盘(假设识别为 `/dev/sdb`)。
在 Ubuntu 中确认新盘识别情况:
sudo lsblk -o NAME,SIZE,MODEL,ROTA
sudo fdisk -l /dev/sdb
对新盘进行零值清理(可选,但建议企业级盘也做一次 SMART 自检):
sudo smartctl -a /dev/sdb
sudo smartctl --test=long /dev/sdb为了镜像与原盘一致,我按原来 `/dev/sda1` 分区结构操作。假设原来 `/dev/sda` 上有一整盘 `/dev/sda1` 用于 RAID。现场查看:
sudo parted /dev/sda print得到例如:
Number  Start   End     Size    File system  Name       Flags
 1      1049kB  3000GB  3000GB  ext4         primary    raid
于是我在 `/dev/sdb` 创建相应分区:
sudo parted /dev/sdb mklabel gpt
sudo parted -a optimal /dev/sdb mkpart primary 1049kB 100%
sudo parted /dev/sdb set 1 raid on
然后将新分区格式化为 “reserved for RAID”:
sudo mdadm --zero-superblock /dev/sdb1现场执行:
sudo mdadm /dev/md0 --add /dev/sdb1系统将开始重建镜像。查看状态:
sudo watch -n 30 cat /proc/mdstat例如看到:
md0 : active raid1 sdb1[2] sda1[0]
      2799696128 blocks [2/1] [U_]
      [>....................]  recovery =  0.1% (24032/2799696128) finish=250.0min speed=18000K/sec
重建过程中最好避免业务高写入。重建完成后:
sudo mdadm --detail /dev/md0应显示 “Active Devices: 2 / Working Devices: 2 / State : clean” 等。
更新 `/etc/mdadm/mdadm.conf`:
sudo mdadm --detail --scan >> /etc/mdadm/mdadm.conf
sudo update-initramfs -u
配置监控(如 `mdadm --monitor` 或设置系统告警邮件)防止将来阵列 degraded 未察觉。参考文章中也提到 `mdadm` 在 Ubuntu22.04 的管理方式。
在机房现场确认 RAID 降级告警被清除、SMART 报告新盘健康、硬盘状态指示灯正常。
重启服务,监控业务指标(如跨境电商订单、直播推流帧率、视频存储吞吐)。
在未来 1 周内重点观察该 RAID 是否稳定、有否再降级。
最终在低峰时段测试断开 `sdb` 模拟故障,验证 `sda` 单盘运行是否正常,再插回 `sdb`,验证重建流程是否顺畅。
在此恢复完成后,我立即触发一次 完整快照+备份,将重要数据(如电商数据、直播录制片段)另行同步至异地备份。
我也建议:将 RAID1 调整为 *在线冗余 +定期离线备份模式 —— RAID 防盘损坏但仍不是备份。并且考虑未来升级为 RAID10 或使用 SSD+HDD 混合方案。
这一故障恢复并非一帆风顺,现场有不少坑,以下是我总结的几条,供你在香港服务器环境参考:
| 坑/情境 | 现场表现 | 解决办法 &教训 |
|---|---|---|
| RAID 未及时警报 | 虽然系统监控有 RAID 状态监控,但当晚告警延迟了几分钟 | 建议使用 mdadm --monitor --daemonise --mail=运维@xxx.com 并配合机房 SMS/微信告警 |
| 分区标记不一致 | 新盘刚加入时我忘记用 set raid on,导致 mdadm --add 报 “invalid superblock” 错误 |
必须确保分区类型标记为 “raid” 或者直接用整个盘 /dev/sdb 加入(视设计而定) |
| 重建期间业务受影响 | 在重建期间 IO 增加,导致直播片段写入延迟,短暂出现卡顿 | 建议在低峰期做重建,或限速 echo repair_speed_max=50000 > /proc/sys/dev/raid/speed_limit_min 等控制 IO |
| SMART 监控忽略坏道累计 | 初期硬盘已经有坏道但未触发更换,直到大量挂起扇区才报故障 | 定期检查 smartctl -a 报告中的 Reallocated_Sector_Ct、Current_Pending_Sector,并设门槛(如>100时换盘) |
| mdadm 配置文件未更新 | 重建后如果 /etc/mdadm/mdadm.conf 未更新,下次重启时 RAID 无法自动重建(变为 inactive) |
每次变更后必须运行 mdadm --detail --scan 并更新 initramfs。Ubuntu22.04 对此也有注意事项。 |
通过这次现场恢复,我有几点经验想与大家分享:
经过这次故障恢复,我深刻体会到,硬件故障是不可避免的,尤其是在高负载的环境下,而 RAID 1 虽然提供了冗余,但依然不能代替定期备份的重要性。每一次数据恢复的过程都是对我作为运维工程师的一次挑战,也是一次成长。
回顾整个故障处理过程,从硬盘故障的初步诊断,到 RAID 阵列的修复,再到最终的系统稳定,整个流程虽然充满挑战,但也让我更加意识到如何提前做好故障预防与数据备份,如何快速响应和处理紧急状况。在未来,我将进一步优化我们运维团队的备份策略,加强监控,确保类似问题能在第一时间被发现并处理,避免对业务造成不必要的影响。
希望这篇文章中的经验和教训,能够为你们在面对类似问题时提供一些参考。不论你是在香港的服务器机房,还是其他数据中心,遇到故障时,冷静、耐心地解决问题,才是最重要的。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/1251.html