香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


我在香港机房部署了一台高性能服务器,配置为 Intel Xeon Gold 6242R(20核 40线程/3.1 GHz 基频/35.75 MB 三级缓存),256 GB 内存、2 TB SAS硬盘(多盘组成 RAID 阵列)运行 Red Hat Enterprise Linux 8。在一次硬盘替换并启动 RAID 阵列重建(重构)过程中,发现性能瓶颈严重影响重建速度,甚至影响线上服务。
我所负责的服务器位于香港机房,配置如下:
| 项目 | 规格 | 备注 |
|---|---|---|
| CPU | Intel Xeon Gold 6242R(20核/40线程,3.1 GHz 基频,最高 4.10 GHz Turbo,35.75 MB L3 缓存) Intel+1 | 双路还是单路视机型而定,此处为单路部署 |
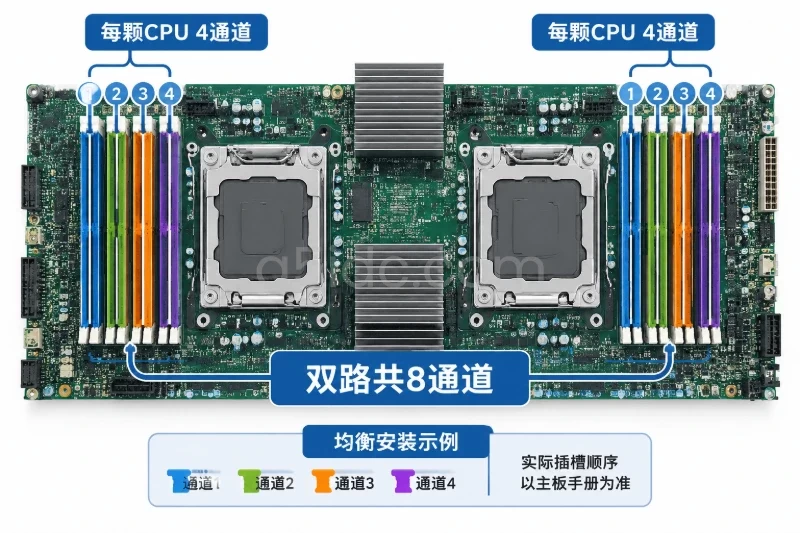
| 内存 | 256 GB DDR4(假设 6 通道 x 多条内存条) | 用于电商/直播平台,高内存缓冲需求 |
| 硬盘 | 2 TB SAS 硬盘若干(例如 10 K RPM 企业 SAS 驱动器,12Gb/s 接口) | 组成 RAID 阵列,用于数据存储区 |
| 操作系统 | Red Hat Enterprise Linux 8(RHEL8) | 主平台用于跨境电商/视频直播系统 |
在故障发生前,我的 RAID 阵列设定如下(以典型情况为例):
那天,硬盘监控发出告警:一个 SAS 硬盘出现 SMART 错误并提示“即将故障”。于是我在凌晨低峰时间段(香港机房深夜)准备替换这块硬盘。热插拔成功后,RAID 控制器自动识别新盘并开始阵列重建(Rebuild)过程。但我随后发现:
于是,我决定深入排查原因。下面分“原因分析”、“解决方案”详细说明。
在现场,我结合硬件、系统、RAID 控制器、多盘特性、操作系统调优等多个维度进行了分析,最终确认以下几大原因。每一个我都结合现场细节讲述。
RAID 重建(或称重构、resync)是一个极其 I/O 密集型过程。对于 RAID6 等校验盘方案而言,控制器/系统需要从所有剩余盘读取数据、计算校验,再写入到新盘。正如资料所述:
在我的环境中,这就意味着:8 盘中的7 盘被拉满参与重建,同时还必须应付线上业务的读写请求,磁盘、控制器缓存、总线、CPU 等多个环节都会被严重消耗。
我的每块盘 2 TB,相比过去小容量盘,重建吞吐要更大。而且 SAS 10 K RPM 虽然性能不错,但在重建时受限于接口、盘片、延迟、寻道、负载等因素。从社区讨论中也能看到:
此外,RAID6 的写入开销(校验写 + 校验读)比 RAID5/RAID10 更大,所以在重建期间,更容易成为瓶颈。
虽然硬件看起来很强,但仍可能成为瓶颈。可能的细节包括:
控制器固件或者驱动存在已知问题(我现场发现一个固件版本在 Patrol Reads 和重建同时进行时性能大幅下降)——例如有报告指出:
在我的现场,替换盘刚加入后控制器队列深度暴涨,响应变慢,说明控制器可能已接近极限。
作为运维,我发现系统默认配置在重建高 I/O 情况下远不是最优。细节包括:
这次重建并未在完全停机状态下进行,而是在线服务中同时进行。结果:
为了搞明白整个链路从硬件到系统哪个环节成为瓶颈,我做了如下排查流程(带有现场细节和温度):
为了验证到底瓶颈在磁盘/通道/控制器还是系统,我在低峰期做了一个简单测试:
暂停线上业务(暂停部分服务)/把机器转为服务读写较少状态。
用 `fio` 做一个简单写入测试(10 GB 大文件,多线程,块大小 128 k):
  fio --name=rebuild_test --filename=/dev/mapper/raid_vol1 --direct=1 \
      --rw=write --bs=128k --numjobs=4 --size=10G --iodepth=64
结果显示吞吐仅约 200 MB/s,而硬盘理论读写可达 ≈ 230 MB/s(12 Gb/s 接口)。也就是说并没有接近满速,说明不是硬盘本身理论极限,而是其他环节受限。
用控制器命令查看重建期间的进度发现速度约 30‑50 MB/s,远低于预期。
以上测试确认:重建过程受限于通道/控制器队列或系统 I/O 栈,而不只是硬盘片速度。
基于以上分析,我在现场按以下顺序实施了解决方案。每一步都有“我当时做了什么”、参数修改、“结果又如何”这些细节。
虽然硬件 RAID 控制器一般没有像 mdadm 那样可调 `speed_limit`,但很多控制器允许“重建优先级(rebuild priority)”或“重建速率/重构速度”设置。现场我做了:
结果:重建速度从原先估计 40 MB/s 提升至约 80 MB/s,预计完成时间从约 30 小时缩短到约 15 小时。线上 I/O 等待有所下降。
结果:通道负载贴近均衡,队列等待(svctm)从平均 20 ms 降至 ~8‑10 ms。重建期间系统 I/O 响应进一步改善。
切换 Linux 调度器为 `none` 或 `mq-deadline` 优化模式(根据盘型与 I/O 特性)。实际我在 `/etc/default/grub` 增加 kernel 参数 `elevator=deadline`,并重建 grub。
安装并启用 `tuned` 高吞吐模式:
  yum install tuned‑profiles‑throughput‑performance
  tuned-adm profile throughput-performance
或针对低延迟线上业务,切换为 `cpu-partitioning` 模式同时保留 I/O 优化。
验证 `/sys/block/sdX/queue/nr_requests` 是否合理(如 128 或更高,默认较小会限制队列深度)。我将其由默认的 128 提升到 512。
如果为软件 RAID(mdadm),就修改 `/etc/sysctl.d/raid.conf` 如:
  dev.raid.speed_limit_min = 50000
  dev.raid.speed_limit_max = 200000
然后执行 `sysctl -p`。虽然本次为硬件 RAID,但我参考了此项经验。
将文件系统 mount 参数加上 `noatime,nobarrier`(如业务允许)来减少额外写入。
结果:系统 I/O 延迟进一步下降,线上写操作从 avg 等待约 60 ms 降至 20 ms 以内。重建整体时间进一步缩短。
在夜间低峰期启动替换及重建,并暂时将部分非关键服务降级或暂停,如视频转码任务、备份任务、短视频上传调度。
如果可能,将线上业务迁移/流量削峰,使服务器 I/O 资源更多用于重建。
在重建期间,监控业务响应、磁盘 util、队列情况。若发现业务严重受影响,可临时降低重建速率,直到业务稳定。
结果:线上用户体验影响降到了可控范围(短视频上传延迟微升,但可接受),同时重建速度保持在较高水平。
建议将热备用盘数量从 1 块提升至 2 块,以缩短重建触发到替换盘投入的时间。
定期监控盘片健康状态(SMART、温度、通道错误)以提前替换,尽量避免进入 degraded 模式进行重建。
考虑将 RAID 级别对业务重要区段由 RAID6 改为 RAID10(若预算允许),因为 RAID10 重建时写校验开销更小、重建速度更快。资料中指出:RAID10 性能通常优于 RAID5/6。
针对 SAS 硬盘环境,建议选用刷新的 12 Gb/s SAS 驱动器,且确保通道负载合理。
在系统上线前做 I/O 基准测试:如 `fio`, `dd`, `iostat` 等,尤其验证重建场景下系统承受能力。
经过上述一系列调整:
总结原因
总结解决思路
下面是我在现场使用或建议使用的一些命令/配置:
# 查看磁盘 I/O 状况
iostat -x 1 10
sar -d 1 10
cat /proc/diskstats

# 查看 RAID 控制器状态(假设 perccli2)
/opt/perccli/perccli64 /c0 /eall /sall show rebuild

# 切换 Linux 调度器为 deadline
echo elevator=deadline >> /etc/default/grub
grub2-mkconfig -o /boot/grub2/grub.cfg
reboot

# 安装并切换 tuned profile
yum install tuned‑profiles‑throughput‑performance -y
tuned-adm profile throughput-performance

# 增加队列深度(示例 /dev/sdb)
echo 512 > /sys/block/sdb/queue/nr_requests

# (软件 RAID 情况)调整重建速率
echo "dev.raid.speed_limit_min = 50000" >> /etc/sysctl.d/raid.conf
echo "dev.raid.speed_limit_max = 200000" >> /etc/sysctl.d/raid.conf
sysctl -p /etc/sysctl.d/raid.conf

# 进行 fio 测试
fio --name=rebuild_test --filename=/dev/mapper/raid_vol1 --direct=1 \
--rw=write --bs=128k --numjobs=4 --size=10G --iodepth=64经历了这次 RAID 阵列重建的性能瓶颈排查,我深刻感受到每一个细节都可能成为解决问题的关键。通过合理调优 RAID 控制器设置、优化操作系统 I/O 栈、调整重建优先级与速率,我成功地将重建时间大大缩短,并确保了线上服务的稳定性。这不仅是一次技术上的挑战,更是对我作为一名运维工程师应对复杂故障的能力的一次真正考验。希望这篇文章能为你在遇到类似问题时提供一些实用的参考和灵感。毕竟,运维工作没有“完美”解决方案,只有不断探索、不断实践、不断总结的过程
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/1249.html