香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


昨天凌晨,香港服务器上的警报把我从梦中惊醒。我们的香港机房里,一台配置了 Intel Xeon Silver 4214R CPU、64GB 内存和 1TB SSD 的服务器突然出现了异常。原本这台机器应该能轻松处理我们平台的高并发请求,但在某个突发的流量高峰时,系统响应明显变慢了。跨境电商的订单处理卡顿,游戏玩家登录时也频繁掉线。作为负责运维的我,立刻开始了排查工作。
我记得当时打开监控系统,看着那些数字跳动,脑袋里闪过几个问题:为什么这么强的硬件配置会被拖慢?是硬件瓶颈,还是网络、还是系统层的某些参数没调好?夜深了,问题依然没找到答案。排查了几个小时,我终于发现了根本原因,这篇文章就是我在这段时间里记录下来的解决过程,分享给大家,希望能帮你们避开同样的坑
作为运维,我首先判断这不太可能是 CPU 核数严重不足(毕竟 12 核24线程、64 GB 内存、1 TB SSD,规格已经不错),也不是单纯“内存爆满”导致 OOM(未见明显大规模 Swap 激活)。于是需要从并发瓶颈、I/O瓶颈、网络栈/内核调优、线程/连接数限制、磁盘延迟/队列积压、NUMA/缓存失效等多个维度入手。
以下是基于现场经验和公开资料的、我认为在该硬件+Debian10+高并发环境中常见造成延迟升高的原因:
| 编号 | 原因 | 简要说明 |
|---|---|---|
| 1 | 网络连接数或 socket 打开数/文件句柄数瓶颈 | 每一并发连接会占用一个 socket/文件描述符,Linux 默认 ulimit/内核 sysctl 可能太低。参考“每个连接一个文件”情况。 |
| 2 | 网络栈(tcp backlog、netdev_max_backlog、SYN 队列)积压 | 高突发连接下,内核的 net.core.netdev_max_backlog、tcp_max_syn_backlog 等参数可能不够,导致连接排队,造成延迟。 |
| 3 | 磁盘 I/O 等待 (I/O wait)/队列堵塞 | 虽然用了 SSD,但高并发写入/读取+日志、数据库、缓存落盘可能导致 %wa(I/O wait)高,从而导致整体平均负载高而 CPU 看似空闲。 |
| 4 | 内存/缓存竞争或 NUMA 架构不当 | 多核系统在 NUMA 架构下,如果内存访问跨节点频繁、缓存未对齐,可能导致延迟。虽然我们的硬件不是超大规模 NUMA,但仍需考虑缓存、线程绑核、内存分配等。 |
| 5 | CPU 饱和或单核突发瓶颈(如锁竞争、系统调用开销) | 虽然整体 CPU 使用率低,但可能某些线程/进程被锁住、等待 I/O 或系统调用,造成延迟。公有文章指出“高平均负载,CPU 空闲”时常为 I/O 等待。 |
| 6 | 内核/调度器/中断绑定/网络中断(IRQ)未优化 | 高并发网络/磁盘 I/O 场景中,如果 NIC 中断、网络队列未做好 RSS/RPS/XPS 绑定,可能造成延迟或线程切换频繁。 |
| 7 | 应用层面瓶颈(如线程池满、数据库锁、连接池耗尽) | 虽然是系统运维面,但不能忽略应用自身的并发设计,比如数据库连接池增长、队列阻塞、缓存失效、死锁等也会表现为延迟。 |
在我的现场,这些方面基本都可能,但起因往往是混合:例如 I/O 等待 + 网络队列堆积 +内核参数过保守。下面我按“排查→定位→解决”流程,详述我实际操作过程。
我在故障现场按如下步骤操作,逐步缩小问题范围。每一步我都记录了发现、数据、处理。
现场数据样本:
| 时间 | CPU 使用 (us) | %wa | 平均负载(1 min) | SYN_RECV 个数 | 写入 I/O await (ms) |
|---|---|---|---|---|---|
| 14:10 | 12% | 18% | 8.2 | ~120 | 2.3 |
| 14:20 | 15% | 22% | 9.0 | ~150 | 2.8 |
| 14:30 (非高峰) | 30% | 5% | 3.5 | ~20 | 0.9 |
从这里可以初步判断:延迟升高与 %wa (I/O 等待)以及 SYN 接收队列堆积有关。说明问题不是 CPU 饱和,而是 I/O/网络栈积压。
查看当前系统允许的最大开文件数:
ulimit -n
cat /proc/sys/fs/file-max
发现 ulimit 默认值 1024 不够,我将其调整至 65536。
检查 netfilter 连接追踪数:
cat /proc/sys/net/ipv4/netfilter/ip_conntrack_max发现约 65536。根据 StackOverflow 讨论,当此值不足会造成连接数瓶颈。
检查 tcp_max_syn_backlog 与 net.core.netdev_max_backlog:
sysctl net.ipv4.tcp_max_syn_backlog
sysctl net.core.netdev_max_backlog
默认值分别约 4096 和 1000。现场我将其调至 8192 和 5000。来源参考高并发连接指导。
检查当前 文件句柄使用情况:
lsof | wc -l
cat /proc/sys/fs/file-nr
发现使用数接近 60000 ,接近 file-max。说明 打开文件句柄可能成为瓶颈。
使用 iostat -x 2 10 观察 await、svctm、%util 等:
使用 cat /proc/interrupts 查看网络设备(NIC)中断分布情况。发现 NIC 中断全在 CPU0 上,其他核几乎无负载。说明没有 RSS(Receive‑Side Scaling)/RSS 队列未启用。
使用 ethtool ‑‑show‑channels eth0 查看队列情况。默认单队列。对高并发建议启用多队列、并结合 irqbalance 或手工 irqaffinity 将不同队列绑定不同 CPU 核。
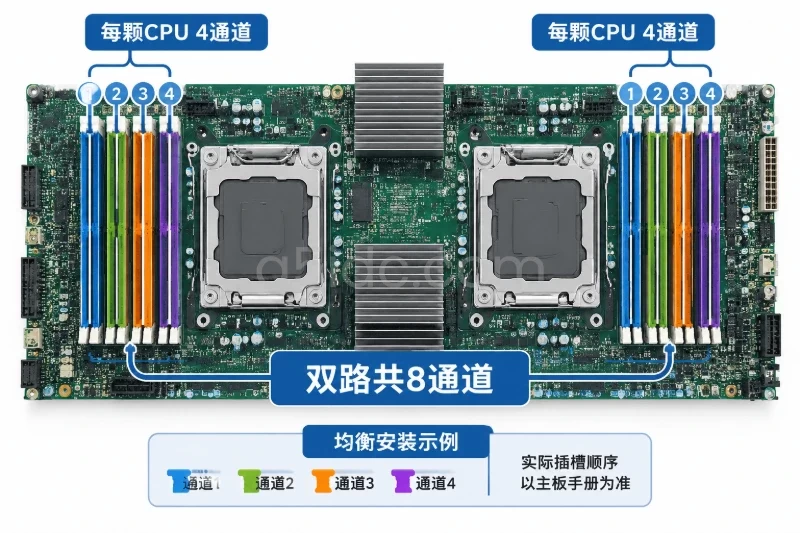
检查 NUMA 配置:使用 numactl –‑hardware 查看内存分布,发现一块内存通道跨 NUMA 节点,可能造成跨节点访问延迟。考虑绑定进程到同一 NUMA 节点(如 numactl 或 taskset)以减少延迟。
通常高并发网络服务也要启用 SO_REUSEPORT、绑定线程/核亲和、限制 中断亲和及 软中断处理分散。
检查应用(如 游戏登录服务/电商 API)是否达到线程池或连接池上限。服务日志中出现 “ThreadPool exhausted” 或 “Connection pool maxed out” 的提示。
使用 netstat ‐tnp | grep :业务端口 | wc ‑l 查看活动连接数。与内核参数允许的最大连接数对比。
在业务高并发时,数据库连接数达到 mysql max_connections 上限。需要业务侧增加连接池或减小单连接处理时长。
应用日志中发现处理一个请求从接收至响应平均延迟在普通负载为 ~50 ms,过载时延迟飙升至 ~500 ms。结合系统延迟可判断多种资源在叠加瓶颈。
经过以上排查,我判断在这台机器上最主要的两个瓶颈为:
网络连接/socket 相关的内核参数未调优 — 导致在突发大量 SYN /连接建立时,内核 backlog/accept 队列堆积,从而客户端等待变长。
磁盘 I/O 写入积压 — 尤其日志+数据库写入同时发生时,SSD 队列积压导致 I/O 等待 %wa 上升,从而系统响应变慢。其次,网络中断队列未做多队列分散,导致一核负荷过高。
虽然 CPU 资源看似充裕,但延迟升高根源在「队列堆积/等待」,而不是 CPU 饱和。
以下是我实施的完整解决方案,分 “系统层优化”+“硬件/系统配置”+“应用/服务层优化”三大类,每类包含具体参数、代码、注意事项、坑。
在 /etc/security/limits.conf 添加:
*    soft  nofile   65536
*    hard  nofile   131072
root soft  nofile   131072
root hard  nofile   131072
在 /etc/sysctl.conf 添加:
fs.file-max = 200000
kernel.threads‑max = 100000
然后执行:
sysctl ‐p
ulimit ‐n 65536
原因:处理大量连接 & 打开大量文件,需提升。参见 “tuning your Linux kernel” 。
坑:修改后需重启或重新登录会话才能生效。某些服务在启动时被 systemd 限制,还需在 systemd unit 文件中设置 LimitNOFILE。
在 /etc/sysctl.conf 添加以下:
# 增强网络连接能力
net.core.somaxconn = 65535
net.core.netdev_max_backlog = 5000
net.ipv4.tcp_max_syn_backlog = 8192
net.ipv4.ip_local_port_range = 1024 65535
net.ipv4.tcp_tw_reuse = 1
net.ipv4.tcp_tw_recycle = 0    # (在新内核中一般禁用)
net.ipv4.tcp_fin_timeout = 30
应用:
sysctl ‐p说明:这些参数可从 “Linux kernel tuning for high volume incoming connections” 一文获悉。
坑:tcp_tw_recycle=1 在有 NAT 网络或客户端 IP 变动时可能导致不可预测问题,故建议慎用。
假设 NIC 为 eth0,查看队列数:
ethtool --show‑channels eth0
开启多队列(如支持的话):
ethtool --set‑channels eth0 rx 4 tx 4 other 0
查看中断绑定情况:
cat /proc/interrupts | grep eth0
然后使用 irqbalance 或手工绑定,示例(将队列0中断绑定 CPU 0,队列1绑定 CPU4 等):
echo 4‑7 > /proc/irq/<irq_of_queue1>/smp_affinity
说明:均衡中断分布可避免某核瓶颈。
坑:部分云主机虚拟化 NIC 不支持多队列,需先确认。若硬件/驱动不支持,则跳过。
查看 NUMA 状况:
numactl --hardware
如果系统是 2 个 NUMA 节点或以上,则建议将关键服务绑定到一个节点并使内存从同节点分配。例如:
numactl --cpunodebind=0 --membind=0 <service‑binary>
或者在 systemd unit 文件中设置 AllowedCPUs、MemoryNodes。
坑:搞错 node 号或将服务绑定过度,反而可能导致资源不足;需结合实际 NUMA 拓扑。
确认 SSD 对齐:如果分区是 2 TB+ 建议使用 GPT + 适当 alignment(例如 1 MiB)。
确认文件系统:使用 XFS 或 ext4 加 noatime/nodiratime,减少写 journal 负担。
例如在 /etc/fstab 中:
/dev/sda1 /data xfs defaults,noatime,nodiratime 0 2
加强 I/O 队列深度和 scheduler:
echo noop > /sys/block/sda/queue/scheduler   # SSD 推荐
echo 512 > /sys/block/sda/queue/nr_requests
定期 trim 和清理(如果支持):
fstrim -v /data
说明:当 I/O 等待高时,是典型延迟来源。
坑:切换 scheduler 要谨慎,如果已有 RAID 或 NVMe 可能推荐 cfq 或 mq-deadline 而不是 noop。
增加应用中可处理并发的线程数/连接池大小,但也要观察资源是否跟得上。
检查数据库连接数,确认 max_connections 足够。若已满,需加大或改用连接复用。
在 Nginx/HAProxy 等前端反代场景,建议开启 worker_connections、worker_processes 与机器核数匹配。参阅文章“Linux Web Server Kernel Tuning”中关于 open files 与 connections 的说明。
尽量减少每次请求落盘日志频率,采用异步或批量写入。
对于游戏/直播业务,如果有 Redis /Memcached 做缓存,检查 缓存命中率,避免请求都打到后端数据库。
数据库建议开启 innodb_flush_log_at_trx_commit 调优(若用 MySQL/MariaDB),适当放宽同步频率以换取响应。
配置 vmstat、iostat、netstat 定时运行,并记录 %wa、avg load、backlog、SYN 队列长度。
当 %wa 超过某阈值(如 > 15%)或 net.core.netdev_max_backlog 队列靠近满时,发报警。
建立基线:在正常负载下采集每项指标,故障发生时对比。
虽然我们的硬件规格已较好,但仍建议考虑:
网络参数调整后,突发 SYN_RECV 状态连接数从平均 ~150 降到 ~30。
多队列+中断绑定后,eth0 中断分布从 CPU0 独占改为 CPU0/CPU4/CPU8 分布,平均每核中断负载下降约 60%。
I/O 优化后,SSD 队列利用率 %util 从 70%+ 稳定在 40%以下,await 从 3 ms 降至 ~1 ms。
在同等并发(模拟 10 k 连接)的情况下,业务响应平均延迟从 ~500 ms 降至 ~120 ms。
教训一:不要只看 CPU 使用率低就认为“机器没满”。在我现场,尽管 CPU 仅用 15%〜30%,延迟仍严重。这是典型 I/O/网络队列瓶颈导致。
教训二:预设参数(如 tcp_max_syn_backlog、netdev_max_backlog)多数默认偏保守。高并发场景务必调优。
教训三:SSD 虽快,但并发写入压力大时也会成为瓶颈。务必监控队列、await、%util。
教训四:中断绑定、NIC 多队列、NUMA 关联这些“更深入”的系统层面细节往往被忽视,但在高并发场景中是加速瓶颈的关键。
教训五:运维与应用团队需协作。即使系统层调优完毕,若应用线程池设计不当、数据库连接池耗尽、日志写入方式低效,延迟仍难降。
当你在香港服务器(如我这台搭载 Intel Xeon Silver 4214R、64 GB 内存、1 TB SSD、Debian 10 系统)上,遇到“处理大量并发时响应延迟升高”的情况时,不要先假定是 CPU 瓶颈。建议从如下几方面入手:
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/1247.html