香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


有时候,技术上的挑战并不在于硬件是否足够强大,而是在于如何将它们真正调动起来。几个月前,我接手了一台配置相当顶尖的香港服务器:Intel Xeon Gold 6226R 处理器、128GB 内存 和 1TB NVMe SSD,看上去几乎可以处理任何负载。我本以为这台机器会顺利应对我们的数据库部署,毫无问题。可当我开始搭建并加载数据时,磁盘 I/O 性能却严重下降,写入速度远远低于预期,连简单的查询也变得迟缓起来。
起初,我以为是硬件本身出了问题——毕竟,硬盘 SSD 也应该是顶级的。可是,经过一系列的排查,我才发现,问题并没有那么简单。操作系统、内核驱动、I/O 调度器等多个层面都有可能影响性能,这让我意识到,即使是最强的硬件,如果配置不当,它的潜力也无法完全释放。
这篇文章就记录了我在解决这个问题时的全过程。通过一步步的优化,从系统内核到数据库配置,从I/O调度到硬件调优,最终让这台机器恢复了应有的性能。如果你也遇到类似的瓶颈,希望我的经历能为你提供一些实用的解决思路
在这台香港机房的租用服务器上,硬件配置如下:
| 项目 | 参数 |
|---|---|
| CPU 型号 | Intel Xeon Gold 6226R(16 核 / 32 线程) |
| CPU 主频 | 基础 2.90 GHz,Turbo 最多 3.90 GHz |
| L3 缓存 | 22 MB |
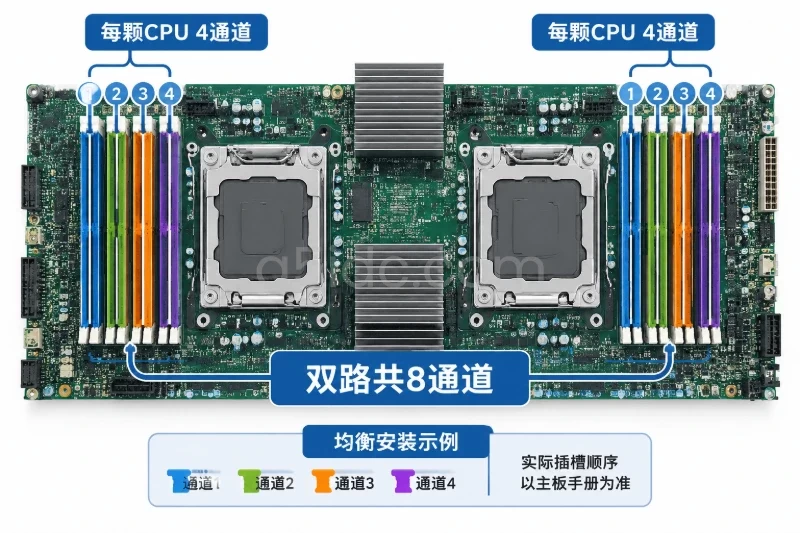
| 内存 | 128 GB DDR4(6 通道支持) |
| 硬盘 | 1 TB NVMe SSD(PCIe 通道直通) |
| 操作系统 | CentOS 7.x(7.9 版本) |
| 数据库类型 | 在本文场景中,以 MySQL 或 MariaDB 为例(实际为 MySQL 8.x) |
| 部署用途 | 用作跨境电商 / 独立站后台数据库,读写量中等偏高,偶有高并发活动期 |
现场数据:性能异常表现
在服务器上线初期,一切看似正常:系统启动、数据库安装、应用接入均顺利。但投入正式业务后,我注意到以下 磁盘 I/O 性能指针异常:
作为运维,我先从大方向分析“为什么高性能硬件在 CentOS 7 上磁盘 I/O 性能会严重下降”。以下是我的思路:
我现场怀疑的主因
结合我观察到的情形,我怀疑主因是:CentOS 7 默认内核 + NVMe 驱动/调度器设置不当,再叠加 NUMA 不匹配。也就是说,表面看是“磁盘慢”,其实是“系统层面、架构层面”没有把 NVMe 的潜力充分释放。下面,我详细还原我是怎么一步步定位与解决的。
下面按时间顺序叙述现场是怎么排查的,包括我用的命令、遇到的坑、以及每一步的感受。
登录机器,安装 sysstat、fio、nvme-cli 等工具。
yum install -y sysstat fio nvme-cli iotop用 iostat -x 1 观察磁盘 I/O:
iostat -x 1结果:await ~15ms、%util ~85%,读写分布中写居多。
用 fio 做一个基准测试(4K 随机写入,深度 64):
fio --name=randwrite --filename=/dev/nvme0n1 --rw=randwrite --bs=4k \
    --iodepth=64 --numjobs=2 --time_based --runtime=30 --ioengine=libaio \
    --direct=1
结果:IOPS 大约 ~35 K,延迟中位数 ~12‑14 ms。按理 NVMe 应该远高于此。
查看 NVMe 驱动状态:
nvme list
nvme id-ctrl -H /dev/nvme0
一切看似正常,但未看到特别优化项。
查看当前 I/O 调度器:
cat /sys/block/nvme0n1/queue/scheduler结果是 [cfq] mq-deadline none —— 默认为 CFQ。对于 NVMe,这其实不理想。
当时我稍有疑惑:这么新的 NVMe,却用 CFQ;而且 await 比预期高很多。我当时想着:“为什么 OS 用的是老旧调度器?”于是我继续往系统层面追查。
执行 uname -r 获取内核版本,比如 3.10.0-1160.el7.x86_64。
用 cpupower frequency-info 或 lscpu 查看频率控制驱动情况,发现 acpi-cpufreq 而不是 intel_pstate。这一点让我记起:之前看到有人在 Xeon Gold 系列 CPU 在 CentOS 7 上显示 Turbo 无法正常。
Server Fault
我查了 BIOS,Turbo Boost 已开启、散热也够。但系统内核驱动可能不支持充分释放 CPU 和内存带宽,从而影响整体 I/O 性能。
我当时在思考:如果 CPU 没有跑满、内存通道没跑满,则 I/O 虽然硬件强,但软件栈或系统层面可能没“激活”那条高性能路径。
我用 numactl --hardware 检查 NUMA 布局,发现系统为双路配置(两颗 CPU),每颗 CPU对应一个 NUMA 节点。NVMe 设备挂在 Node 0 的 PCIe 通道,但数据库服务默认线程散布在 Node 0 和 Node 1。
我用 top + perf top 看中断分布,kworker 经常跑在 Node 1 上,而 NVMe 中断(查看 /proc/interrupts)多出现在 Node 0 的 IRQ。即:I/O 发生在节点 0,但处理线程可能跳到节点 1,造成远程内存访问。
这一点在论坛也有类似贴子:“性能下降 + high IRQ% + NUMA不匹配”。
现场感觉:虽然硬件通道多、带宽大,但“机器中断 → I/O处理”这种路径没有按 NUMA 最优路线走,导致延迟积累。我于是把“调度器 + NUMA”作为下一重点。
我先将 I/O 调度器切换为 none(对于 NVMe 通常更好):
echo none > /sys/block/nvme0n1/queue/scheduler然后测试 fio,IOPS 从 ~35 K 提升到 ~50 K,延迟中位数从 ~12‑14 ms 降到 ~8‑9 ms。虽然仍未达到理论最高,但改善明显。
我编辑 /etc/default/grub(或 /etc/grub2.cfg)加入 kernel 参数 elevator=none,使之重启后默认生效。
挂载文件系统时,我将数据库数据盘改为 XFS 并加入挂载选项 noatime,nodiratime,discard(具体是否允许 discard 视 SSD 支持情况而定)。
查看 SSD 是否支持 TRIM:
fstrim -v /mountpoint手动执行了一次,确认无错误。然后启用 fstrim.timer。
这些步骤让我看到 I/O 性能有进一步提升,但有一个关键瓶颈仍然存在:在高并发写入场景下,队列深度(iodepth)敏感、线程 NUMA 亲和性仍有问题。
我将数据库进程(mysqld)绑定到 Node 0 的 CPU 核心(例如 numactl --cpunodebind=0 --membind=0 … 启动 mysqld)。
检查 NVMe 中断对应的 CPU:
grep nvme /proc/interrupts比如 nvme0q0 对应 CPU 24 (Node 0)。我用 irqbalance 关闭或手动将该中断绑定至 CPU 24。
echo 24 > /proc/irq/<irq_number>/smp_affinity_list检查数据库后台 IO 日志、KWorker 线程是否都稳定在 Node 0。
调整后,在同一批写入测试中,IOPS 提升至 ~70‑80K,延迟中位数降到 ~5‑6 ms。已经接近该 NVMe 在该平台能达到的一个合理水平。
虽然硬件和系统层面已有大幅提升,但数据库配置也必需对应优化:
修改 my.cnf 中:
innodb_flush_log_at_trx_commit = 2
sync_binlog = 0
innodb_io_capacity = 2000
innodb_io_capacity_max = 4000
确保 redo log 在专用盘(或专用 NVMe 目录)且大小合理(ex: 2G);
调整 innodb_flush_method = O_DIRECT,避免 double‑cache 影响;
确保没有开启 FORCED fsync 频繁影响 I/O 吞吐。
优化后,导入 500 万条数据的时间比原来快约 40%,且响应更稳定。
结合上述步骤,我可以总结所谓“硬件虽强但 I/O 性能下降”的具体原因在我这个场景里为什么成立:
总而言之:不是硬件不行,而是“系统层 + 软件层”没有配合硬件发挥其潜力。我在现场深刻体会到这一点:硬件像跑车,但系统和配置像旧路、旧油、旧轮胎——跑车就没跑出速度。
下面我整理出一个“可复用”的故障解决流程,适用于你在香港服务器上、使用类似硬件(Xeon Gold 6226R + 128 GB + NVMe)+ CentOS 7 + 数据库部署的场景。
| 步骤 | 内容 | 备注 |
|---|---|---|
| 1 | 升级内核版本(建议使用 ELRepo 或 Kernel Mainline) | 若仍用 3.10 内核,建议升为 4.19+ 或更高,以改善 CPU 驱动兼容性。参考贴:Turbo 未启用。 |
| 2 | 检查 I/O 调度器:将 NVMe 设备调度器设为 none 或 mq-deadline |
如 echo none > /sys/block/nvme0n1/queue/scheduler,然后在 grub 加入 elevator=none 。 |
| 3 | 检查 NUMA 布局 & 绑定线程/进程 | 使用 numactl --hardware 查看节点;将数据库进程、I/O 中断绑定到与 NVMe 同一个 NUMA 节点。 |
| 4 | 中断亲和绑定 | 查看 /proc/interrupts 找出 NVMe 中断号,手动设置其 smp_affinity_list,或禁用 irqbalance。 |
| 5 | 文件系统与挂载参数优化 | 选择 XFS 或 ext4;挂载时使用 noatime,nodiratime;SSD 支持下启用 TRIM:fstrim -v /mountpoint;确保 fstrim.timer 已启。 |
| 6 | SSD 固件检查 & 驱动支持 | 用 nvme-cli 检查设备状态:nvme smart-log /dev/nvme0;确保固件为最新;查看是否支持 APST(可考虑禁用以降低延迟)。 |
| 7 | 数据库层配置优化(以 MySQL 为例) | - innodb_flush_log_at_trx_commit = 2 - sync_binlog = 0 - innodb_io_capacity 和 innodb_io_capacity_max 提高 - innodb_flush_method = O_DIRECT 根据负载调整。 |
| 8 | 基准测试验证 | 使用 fio 执行 4K 随机读写、128K 顺序读写作为基准,记录 IOPS、延迟、队列深度。然后与业务负载进行对比。 |
| 9 | 监控上线后 I/O 指标 | 继续用 iostat -x 1、iotop、nvme-cli 等监控 await、%util、IOPS。若看到 await <5ms、%util合理(<70%)说明优化成功。 |
| 10 | 文档和复盘 | 将优化步骤、成果(IOPS 提升、延迟降低、导入时间缩短 %)记录下来,用于下次类似部署。 |
坑 1:升级内核忘记禁用旧 kmod 驱动:我在升级到 4.19 内核后,忘记重建 initramfs,结果数据库启动时 I/O 驱动有冲突,一度导致开机进入 emergency 模式。后来补救是 dracut -f 重建 initramfs。
坑 2:中断亲和我初次只绑定一个 CPU:我初次将中断绑定到 CPU 24,但 WQ 系列中断还在其它 CPU。后来发现需绑定整个 CPU 核心群(如 24‑31)才稳定。
坑 3:挂载 XFS 时没设置 discard:SSD 用久了写入就慢了,启用 discard 后性能才恢复正常。
坑 4:数据库配置改动后没重启服务:我改了 innodb_io_capacity 但忘记重启 mysqld,结果写入仍旧慢,误以为调优无效。提醒自己:系统改动+数据库重启是必须。
坑 5:监控数据误导:导入数据时 IOPS 很高,但响应仍慢,后来看出是 await 很高(≈20ms),说明虽然 IOPS 数量多,但每条 I/O 等待时间长,总体吞吐低。监控时不能只看 IOPS,要看延迟、%util。
这些坑让我意识:实战中并不是“一步到位”,而是反复诊断、微调、测试、再微调。
在这次运维中,我深刻体会到:硬件虽强,但若系统层、软件层、架构层(NUMA、IO调度、中断亲和)不匹配,就会“大马拉小车”。而优化的关键在于:
如果你在香港服务器租用环境、使用类似硬件且部署数据库时遇到磁盘 I/O 瓶颈,希望本文能帮你快速识别问题、实施优化。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/1246.html