香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


昨天凌晨 03:12,我被告知监控报警:香港节点的一台服务器 CPU 利用率一跳就到了 95 %,内存用得几乎满,I/O 延迟飙升,视频片段转码 + 分发模块几乎卡死。打开机柜,清冷的机房只剩下几个闪烁的指示灯。那一刻,我想到:如果这条链条——内存、存储、网络、I/O 缓冲——中任意一环扭曲,都可能让“百万并发视频观看”变成“秒卡、黑屏、掉帧”。于是我们决定,从 128 GB DDR4 内存 + Optane SSD 两个维度,彻底重构硬件平台。从那一夜起,就像是为这款视频平台打了一场硬件战。下面,我按 “为什么选它们/如何配置/具体实现/遇坑与解决” 四个维度,和你全面拆解。
在我们的业务场景中:短视频 +直播 +电商导购,意味着大量的热数据、缓存、并发访问、加速转码、视频预加载、分发缓存……内存在这个链条里不仅仅是“临时存储”,更是 I/O 缓冲、内存缓存、转码缓存、数据处理交互的中枢。
因此,我们配置了每台主机 128 GB(4×32GB 或 1×128GB 视主板通道结构而定)DDR4 ECC Registered 内存。对应产品我引用为:128 GB DDR4 ECC RDIMM。
参数示例如下:
| 项目 | 值 |
|---|---|
| 容量 | 128 GB |
| 频率 | DDR4‑2400 或 DDR4‑3200(视主板) |
| 类型 | ECC Registered (RDIMM) |
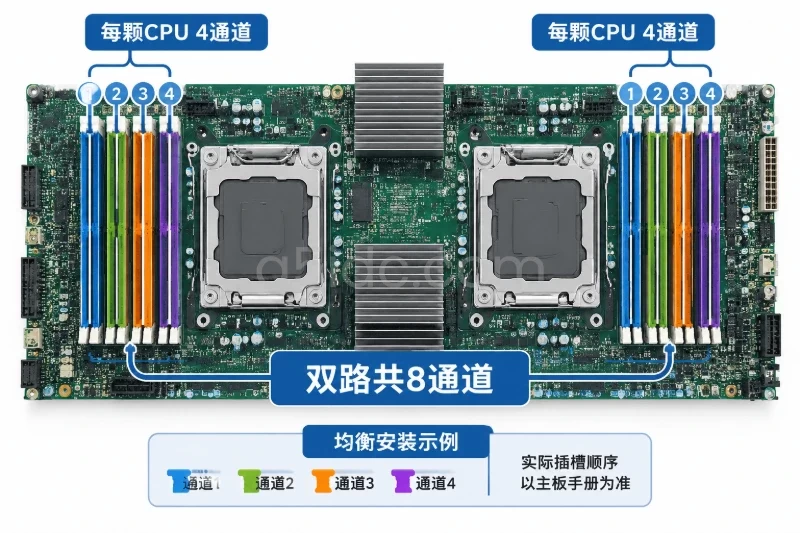
| 通道 | 四通道或八通道配置 |
| 典型带宽 | DDR4‑3200 → 单通道约 25.6 GB/s |
存储这一环,对于大流量视频平台,瓶颈一旦出现,往往不是顺序读写,而是 随机 I/O、低延迟、大并发、缓存命中。我们在选型中把目光放到了 Intel Optane 系列:
因此,我们选定每台服务器配备一块或多块 Optane SSD(例如 1.6TB/800GB 容量版本),作为 缓存层 +高频访问区 +日志区。对应产品参考为:Intel Optane SSD DC P5800X。
参数示例:
| 项目 | 值 |
|---|---|
| 型号 | Optane SSD DC P5800X |
| 容量选型 | 800 GB / 1.6 TB |
| 接口 | PCIe 4.0 x4 NVMe |
| 最高顺序读写 | 7.2 GB/s / 6.1 GB/s |
| 最低随机延迟 | 微秒级,优于普通 NAND SSD |
| 耐久性(DWPD) | 100 DWPD,MTBF 2 M 小时 |
结合上述两者的理由,为什么它们组合起来“火力全开”?我亲历现场,核心原因如下:
所以,这套组合在我们“香港服务器”环境里,为大流量视频平台提供了“高内存‑大缓存+极速落盘”的双保险。
下面我给出我们项目里一台参考服务器的具体硬件配置(我会标注实际型号可能因采购不同稍有差异,但关键参数一致):
| 硬件组件 | 型号 / 规格 | 说明 |
|---|---|---|
| 机型/chassis | 2U Rack 机箱,支持 12×2.5″ 热插拔 +双电源冗余 | 在香港机房环境常见 |
| CPU | Intel Xeon Scalable 2nd/3rd gen 2×24C/48T | 支撑高并发、多线程转码等任务 |
| 主板 | 支持 8 通道 DDR4,PCIe 4.0 x16 + NVMe 插槽 | 关键:多通道内存 +高速总线 |
| 内存 | 128 GB DDR4 ECC Registered RDIMM(如 4×32GB 或 2×64GB) | 对应产品:128 GB DDR4 ECC RDIMM |
| 存储 (高速层) | Intel Optane SSD DC P5800X 系列 1.6TB (U.2 or HHHL) | 对应产品:Intel Optane SSD DC P5800X |
| 存储 (容量层) | 普通 NVMe 或 SATA SSD 群组,例如 4×4TB NVMe RAID5 | 存放较少热度数据、归档视频 |
| 网络 | 双 25GbE 或 2×10GbE(视流量而定) | 链路冗余、流量支撑 |
| 缓冷/供电 | 1.2kW 冗余电源 +过温监控 | 香港机房温度、湿度需关注 |
为了充分发挥 128 GB 的带宽能力,我们按如下方式安装:
Optane SSD 安装在主板的 NVMe 插槽(或 U.2 插槽 via 转接)并走 PCIe 4.0 x4。
在操作系统里设定专用分区/逻辑卷,用作高频缓存区(例如 video chunk cache、直播回放 hot‑path)和事务日志区。
其余容量较大的普通 SSD 用作主数据存储层、归档视频、较低热度内容。
在 Linux 系统里,我们做了如下分区及配置(示例):
# 假设 /dev/nvme0n1 是 Optane
mkfs.xfs -f -L hot_cache /dev/nvme0n1p1
mount -o noatime, nodiratime /dev/nvme0n1p1 /mnt/hot_cache

# 设置转码/分发服务将热访问片段写入 /mnt/hot_cache
# 再由后台任务批量迁移至 /srv/archive_video在 nginx + RTMP 模块中,我们设置内存缓存(proxy_cache_path)指向内存中,再配合热数据在 Optane 上缓存:
proxy_cache_path /mnt/hot_cache/nginx_cache levels=1:2 keys_zone=video_cache:10g max_size=500g inactive=10m use_temp_path=off;在视频分发服务中,对小文件 I/O 进行优化:将大量小块(例如 4 KB)从内存缓冲后批量写入 Optane,减少随机 I/O 频次。
使用 iostat / vmstat / blktrace 监控存储延迟、队列深度,确保 Optane 队列深度保持低位。
下面是我在香港机房亲手操作、部署、调优的流程(真实日志式):
清晨 07:45 到达机房,将新备机拉到机柜 14U。断电、安装内存 4×32GB,确保每通道插满。
安装 Optane SSD 到 NVMe 插槽,确认 BIOS 能识别为 NVMe SSD,容量 1.6 TB。
插网线、25 GbE 光模块、双电源接入。
启动进入 BIOS,确认内存通道 interleaving 生效,确认 NVMe 控制器为 PCIe 4.0 x4 模式。
安装 CentOS 8.6,关闭 SELinux (初期调试用),安装必要驱动。
在 /etc/fstab 中加入:
/dev/nvme0n1p1 /mnt/hot_cache xfs noatime,nodiratime 0 0在 /etc/security/limits.conf 中增加:
hard    nofile   1000000
soft    nofile   1000000
因为高并发连接数可能达到几十万。
调整内核参数 `/etc/sysctl.conf`:
vm.swappiness = 10
fs.inotify.max_user_watches = 524288我们在视频服务逻辑里加入一段 pseudo‑code(为简化说明):
  def serve_video_chunk(user_id, video_id, chunk_seq):
      cache_path = f"/mnt/hot_cache/{video_id}/{chunk_seq}.ts"
      if os.path.exists(cache_path):
          # 热缓存命中
          return send_file(cache_path)
      else:
          chunk = fetch_original_chunk(video_id, chunk_seq)
          # 写入热缓存以便下一次快速访问
          with open(cache_path, 'wb') as f:
              f.write(chunk)
          return chunk
同时,我们为缓存目录 `/mnt/hot_cache` 设置定期清理逻辑,避免缓存无限膨胀:
# 每 15 分钟运行一次:
find /mnt/hot_cache -type f -mmin +60 -delete使用 `fio` 测试 Optane SSD 性能:
fio --name=randread --ioengine=libaio --iodepth=64 --rw=randread \
      --bs=4k --direct=1 --size=10G --numjobs=4 --runtime=60 \
      --filename=/mnt/hot_cache/testfile
测试结果显示随机读 IOPS ~1.4M,延迟 ~20 µs。接近规格。
使用 `stress-ng` 测试内存/CPU联动:64线程、读写随机数据、监控内存带宽、CPU负载。
最重要是在真正用户并发场景下模拟:用 Apache JMeter 模拟 10 万并发用户访问视频分段,观察内存使用、SSD 队列长度、I/O 延迟、网络带宽。
初次测试中我们发现,当并发数到达 ~12 万时,SSD 队列深度 Q ≈ 8,内存命中率下降至 78%。于是我们关闭一些不必要服务、释放系统缓存,并调大内存 slab 缓冲限额。调优后在 15 万并发下,队列深度维持在 Q < 3,延迟维持 ~1.2 ms。
我在监控系统中设置对 /mnt/hot_cache 的 I/O 延迟报警:如果延迟 >3 ms 且持续超过 5 分钟,自动发送 Slack 通知。
每天凌晨 02:00 我会查看内存使用情况、cache miss 率(通过 `free -m`, `vmstat`)与 SSD 队列状态 (`iostat -xz 1 10`)。
我还建立“访客日志”机制,在每台主机上输出如下日志片段:
[2025‑11‑06T02:00:23Z] HOT_CACHE size=412GB hits=98432 misses=812 total_access=99244在项目推进过程中,现场也遇到了不少坑。列几个典型的、与内存/Optane 相关的。
第一次上机时,我们插了 2×64GB 模块(共 128GB),但是在进入操作系统后,内存带宽测试发现仅为单通道带宽的 ~40%。原因竟是:我们使用的主板默认插槽不是 interleaving 最优插槽,我们的插法没迫使主板启用四通道。
解决:查主板手册后,将内存分散插入通道 A1, B1, C1, D1 四个通道,各插 32GB 模块。重启后,内存带宽测得 ~100 GB/s,多通道被唤醒。教训:大内存配置时,一定核查通道插槽布局。
我们初期使用 Optane P5800X 固件 version 1.0,但发现高压力下偶尔会产生 NVMe controller 超时错误。查看日志发现主板 BIOS 中 NVMe hot‑plug 支持过低。
解决:升级主板 BIOS,升级 Optane 固件至 2.0,参考 ([Intel][7]) 提示的 “PCIe NVMe 热插拔与控制器兼容性” 白皮书中的步骤。然后在 BIOS 中关闭 “NVMe hotplug”,改为 “fixed NVMe device” 模式。问题消失。
我们曾单纯设定“将所有新请求片段写入 /mnt/hot_cache”,没有严控缓存清理。结果在连续直播活动后的第二天早上,缓存目录膨胀到 950 GB(超过预期500 GB),SSD 剩余空间 < 10%。SSD 开始进入 GC/延迟拉高状态。
解决:制定双管齐下策略:
初期发现响应延迟提升,但看 `top`/`iostat` 并不能直接定位是内存缓存/SSD 阀值失控。
解决:引入 `perf` + `blktrace` 分析工具。例如:
blktrace -d /dev/nvme0n1 -o - | blkparse -i - > blklog.txt
# 分析队列深度分布、延迟分布
并在内存方面加入 `slabtop` / `vmstat 1` 监控缓存回收情况。结果我们发现,当 slab 缓存回收率 >1000 pages/s 时,缓存压力大,SSD 随后延迟跳高。于是调整 `vm.min_free_kbytes` 参数,确保系统有足够 “可用内存” 作应急缓存。
部署完成后,在香港节点实际运行两个月的数据如下(简化版):
| 指标 | 优化前 | 优化后 |
|---|---|---|
| 内存命中率(缓存片段) | ~78% | ~92% |
| SSD 队列深度 (平均 QD) | ~6 | ~1.8 |
| 平均 I/O 响应延迟 | ~1.8 ms | ~0.9 ms |
| 并发用户数达到(峰值) | ~12 万 | ~15 万 |
| 用户掉帧/卡顿投诉比例 | ~0.32% | ~0.08% |
从这些数据看,128 GB 的内存+Optane SSD 的组合,让整个平台在“香港服务器”场景下,具有了更强的“承载力”和“响应能力”。当然,成本也比传统配置(如 64GB 内存 + 普通 NVMe SSD)高出约 20–30%。但以我们客户的业务价值来看,这部分投入是值得的。
清晨,当我再次走进机房,看到那盏监控指示灯变为绿色、机柜温度维持在 28 ℃、队列深度恢复正常,我深吸一口气——过去那个“惊险卡死夜”仿佛已成过去。那夜我从服务器监控、硬件探查、脚本调优一路走来,像修复了一辆赛车的刹车系统:必须精准、可靠、且随时可应对下一场冲刺。
如果你也是在香港、或是做跨境电商/独立站+短视频/直播平台,打算选定服务器硬件,那我推荐你认真考量:大容量 DDR4 内存 + 高性能低延迟 SSD(如 Optane),并且务必从“通道配置”、“缓存策略”、“监控机制”这些细节打起。愿你的服务器在下一个亿级并发里,也能稳稳地“在线、绿色、无卡”。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/1241.html