香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


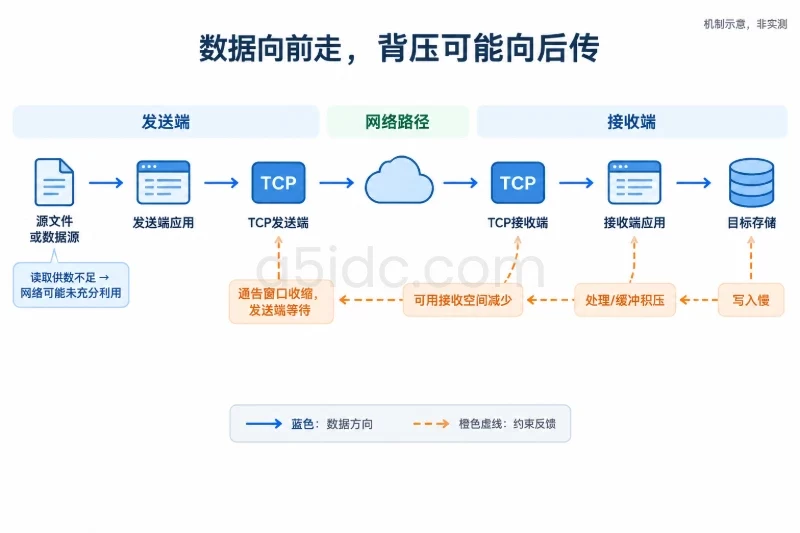
下载慢并不等于服务器出口带宽不足。监控中看到网卡出方向只有几百 Mbps,而线路标称为 1 Gbps,只能说明当前没有形成足够大的有效发送流量;单个 TCP 连接可能受跨地域 RTT、丢包、拥塞窗口或对端接收窗口限制,也可能是 Web 服务主动限速、磁盘无法持续供数,甚至应用还在等待数据库生成文件。
排查时应把“建立连接、等待首字节、持续传输”拆开观察,并同时比较受影响地区、不同客户端、服务器本机和公网访问结果。首字节时间明显变长,优先看 Web 入口、应用和数据库;首字节很快但文件主体传输慢,优先看链路、限速、磁盘和连接级资源。只有沿着这条链路逐层排除,才能避免把所有问题都归因于海外线路。
下载工具通常显示 MB/s,云监控和带宽规格通常显示 Mbps,两者不能直接比较。按十进制口径计算时:
传输速率 Mbps = 文件大小 GB × 8 × 1000 ÷ 下载耗时秒数
例如,一个 100 MB 的十进制文件在 21.4 秒内完成下载:
如果服务器有 1 Gbps 出口,但实际只有一条连接以 37.4 Mbps 下载,网卡利用率自然可能只有几十分之一。此时“带宽还有余量”与“用户下载很慢”并不矛盾。
再比如 1 GB 文件用了 120 秒:
如果监控显示整台服务器出方向约 70 Mbps,这个结果反而与该下载任务基本一致,不能据此认为线路还应自动达到 1 Gbps。
如果使用 GiB、MiB 等二进制单位,应单独记录口径。不要把 1 GiB 直接当成 1000 MB,也不要把 MB/s 直接当成 Mbps。
一次下载至少要区分以下三个阶段:
| 阶段 | 主要指标 | 典型含义 |
|---|---|---|
| 建立连接 | DNS、TCP、TLS 时间 | 域名解析、路由、握手或证书协商是否缓慢 |
| 等待首字节 | TTFB、starttransfer | Web 入口、应用、数据库或上游存储是否在准备响应 |
| 传输响应体 | 总耗时、speed_download、重传 | 链路、限速、磁盘读取、发送缓冲和客户端接收是否受限 |
可以用 curl 做基准测试。下面的结果是命令格式示例,不代表某个实际环境的测试结果:
curl --location --fail --silent --show-error \
  --output /dev/null \
  --write-out 'http_code=%{http_code}\nremote_ip=%{remote_ip}\nsize=%{size_download} bytes\ntime_namelookup=%{time_namelookup}s\ntime_connect=%{time_connect}s\ntime_appconnect=%{time_appconnect}s\ntime_starttransfer=%{time_starttransfer}s\ntime_total=%{time_total}s\nspeed_download=%{speed_download} bytes/s\n' \
  'https://download.example.com/files/test.bin'
例如,若输出接近以下形式:
http_code=200
remote_ip=203.0.113.10
size=104857600 bytes
time_namelookup=0.012s
time_connect=0.041s
time_appconnect=0.086s
time_starttransfer=0.090s
time_total=21.420s
speed_download=4890000 bytes/s
这表示首字节约 0.09 秒就返回,但主体传输了 21 秒左右。排查重点应放在传输阶段,而不是优先检查数据库查询。
反过来,如果结果是:
time_starttransfer=18.600s
time_total=21.100s
那么大部分时间消耗在首字节之前。即使下载完成后的平均速度看起来不高,也不能直接归因于线路,因为应用已经花了很长时间准备响应。
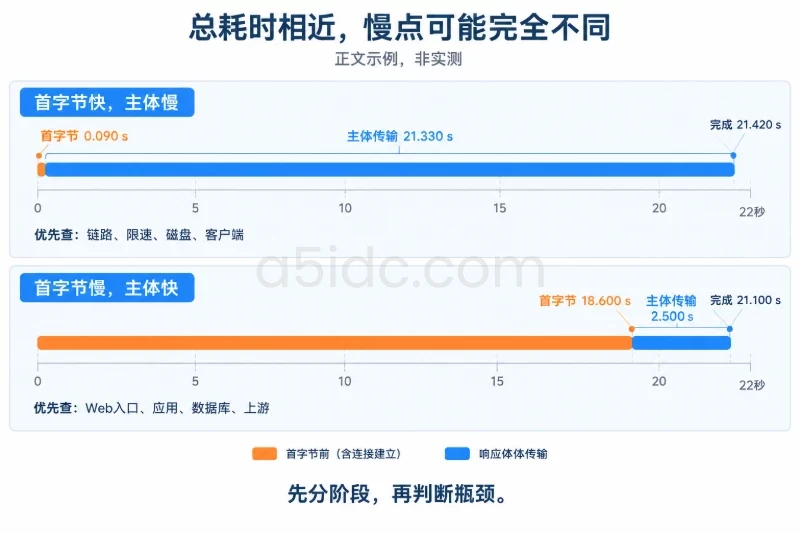
需要记录以下维度,而不是只记录“有人反馈下载慢”:
浏览器的下载速度还可能受到浏览器扩展、代理、磁盘写入、HTTP/2 多路复用和断点续传影响。诊断时最好使用固定 URL、固定文件、固定客户端,并用命令行结果与浏览器现象相互核对。
可以把下载链路拆成五层。每一层都有自己的观察证据,不能用另一层的指标替代。
| 层级 | 需要回答的问题 | 常见现象 | 下一步 |
|---|---|---|---|
| 网络链路 | 客户端到服务器的路径是否存在高 RTT、丢包或拥塞 | 某地区慢、跨运营商慢、单连接速率低 | 从受影响地区测试路径、RTT、重传和 IPv4/IPv6 |
| Web 入口 | Nginx、负载均衡、CDN 或网关是否限速或排队 | 首字节正常但响应体被固定速度限制 | 查响应头、入口配置、请求日志和上游耗时 |
| 系统与磁盘 | 文件能否持续从存储读出,系统是否在等待 I/O | %iowait 高、磁盘读延迟高、发送速率随磁盘抖动 | 对比磁盘读指标、进程 I/O 和文件类型 |
| 应用服务 | 文件是否由程序实时生成、压缩、加密或分块输出 | TTFB 高、工作线程占满、应用队列变长 | 查看应用耗时、线程池、生成任务和错误日志 |
| 数据库与上游 | 应用是否在查询数据或等待对象存储、内部服务 | 查询慢、连接池耗尽、导出边生成边发送 | 区分元数据查询和持续流式生成,检查只读指标 |
这里还有一个重要边界:静态文件由 Web 服务器直接读取时,数据库通常不在持续下载链路上。即使用户登录、权限验证需要数据库,数据库也可能只影响首字节时间;文件已经开始发送后,主体速度更可能由磁盘、Web 发送策略或网络决定。只有动态导出、实时打包、分块生成等场景,数据库才可能持续影响响应体传输。
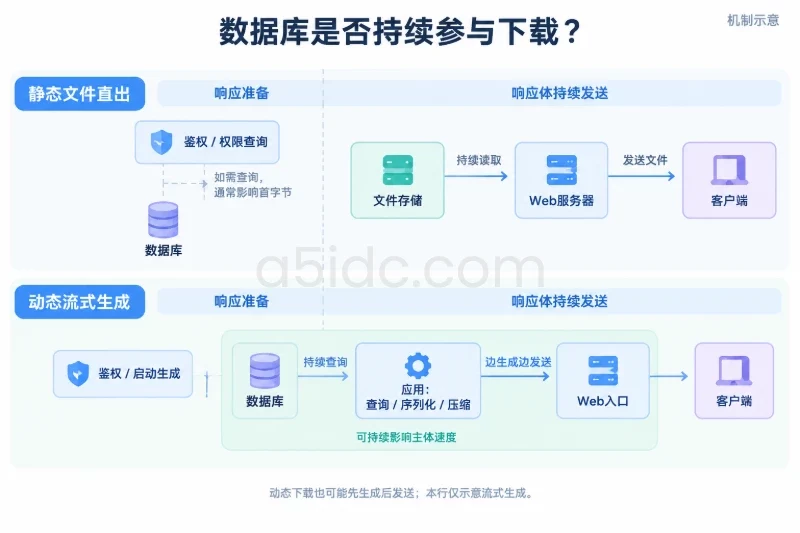
海外服务器面对的是一条端到端路径,包括用户本地网络、接入运营商、国际出口、跨境或跨洲链路、服务器机房入口以及服务器自身网络栈。服务器端带宽监控只能看到最后一段,无法说明中间路径没有拥塞。
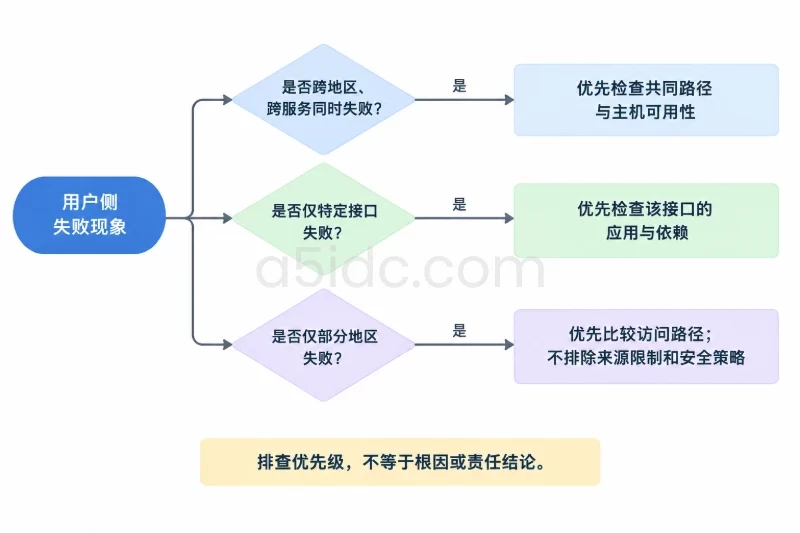
如果只有某个地区或某个运营商的用户慢,而服务器本机、其他地区访问正常,链路问题的优先级就会上升。建议从受影响区域和未受影响区域分别执行相同的下载测试,比较:
可以使用以下命令观察路径。mtr 需要在测试端已经安装,目标地址应替换为实际下载入口的 IP 或域名:
mtr -rwzc 50 203.0.113.10
如果需要观察从服务器返回客户端的方向,应在服务器上对测试客户端公网 IP 执行同类检查,因为互联网路径通常不完全对称。
中间某一跳显示丢包,不一定代表真实故障。许多路由器会限制 ICMP 响应,但仍能正常转发业务流量。判断依据应是:丢包或高延迟是否从该节点开始持续到最终目标,并且是否与 TCP 重传、下载速率下降同时出现。只看某个中间节点的百分比,容易产生误判。
在下载进行时,可以查看连接状态:
ss -tin dst 203.0.113.10:443
不同 Linux 版本的输出字段可能略有差异。以下是用于说明的模拟片段:
cubic wscale:8,7 rto:420 rtt:186/24.2 ato:40 mss:1448
cwnd:10 bytes_acked:184320 retrans:3/120
重点关注:
rtt:往返时延及其波动;cwnd:拥塞窗口是否长期偏小;retrans:是否出现持续重传;rto:重传超时是否升高;mss:是否因为路径 MTU 或隧道封装等因素明显偏小。高 RTT 本身不一定等于故障,但它会延长 TCP 慢启动和确认反馈周期。若同时存在丢包,发送窗口会收缩,单连接吞吐可能远低于物理带宽。此时服务器总出口利用率仍然很低,因为瓶颈在该连接的有效发送窗口,而不是整条线路已经被占满。
还可以查看网卡层面的错误和丢包:
ip -br link
ip -s link show dev eth0
实际网卡名称应以 ip -br link 的结果为准。重点查看 RX/TX errors、dropped、overruns 等计数是否在测试期间持续增加。计数器历史上有少量累积不一定说明当前异常,应在下载前后取差值。
如果域名同时配置了 A 和 AAAA 记录,可以分别测试:
curl -4 --location --fail --silent --show-error \
  --output /dev/null \
  --write-out 'ipv4 total=%{time_total}s speed=%{speed_download} bytes/s remote=%{remote_ip}\n' \
  'https://download.example.com/files/test.bin'

curl -6 --location --fail --silent --show-error \
  --output /dev/null \
  --write-out 'ipv6 total=%{time_total}s speed=%{speed_download} bytes/s remote=%{remote_ip}\n' \
  'https://download.example.com/files/test.bin'
如果 IPv4 明显正常而 IPv6 明显缓慢,应继续核对 AAAA 记录、IPv6 路由、机房上游和客户端网络,而不是笼统地说“海外带宽不够”。如果两者都慢,但只在某个地区慢,则更像该地区到机房的路径或入口问题。
在受控文件和非高峰时段,可以将单连接与少量并发连接进行对比。这个测试不能作为生产压力测试,也不能为了“跑满带宽”随意增加并发。
如果一个连接只有约 20 Mbps,四个连接合计接近 80 Mbps,可能说明:
但多连接更快并不能直接证明网络有问题。它也可能绕过了应用层每连接限速,或者只是多个请求分别命中了不同的后端。需要结合入口配置和 ss 连接状态判断。
下载请求可能经过 DNS、CDN、负载均衡、Nginx、Apache、应用网关或对象存储。每一层都可能改变速度。先查看响应头:
curl --silent --show-error \
  --dump-header - \
  --output /dev/null \
  'https://download.example.com/files/test.bin'
重点检查:
HTTP/1.1 200 或 206 Partial Content 是否符合预期;301、302 等跳转;Content-Length 是否存在且与文件大小合理;Transfer-Encoding: chunked;Accept-Ranges: bytes;Content-Encoding 是否对下载文件进行了不必要的压缩;Age、缓存命中标识、上游节点标识是否在不同地区发生变化。curl -I 只发出 HEAD 请求,某些应用对 HEAD 和 GET 的处理不同,因此不能用 HEAD 的结果完全代替实际下载。响应头检查应与真正 GET 的 time_starttransfer 和 speed_download 配合使用。
Web 入口常见的限制包括:
limit_rate、limit_rate_after 等响应级策略;如果每次测试都稳定在接近某个固定值,例如约 40 Mbps,且 RTT 和重传没有明显变化,应优先检查配置限速。Nginx 中 limit_rate 5m 这类配置表示大约 5 MB/s 的响应速率,按十进制近似相当于 40 Mbps,实际值还会受单位换算、协议开销和调度影响。
如果速度在 1 MB/s、10 MB/s、30 MB/s 之间剧烈波动,同时磁盘读延迟、TCP 重传或应用 CPU 也同步变化,则更像资源或链路波动,而不是固定限速。
Nginx 日志中常见的两个字段是:
$request_time:从读取请求到完成响应发送的总时间;$upstream_response_time:等待上游响应的时间,可能包括应用或内部服务耗时;$body_bytes_sent:发送给客户端的响应体字节数;$status:HTTP 状态码;$request_length:请求大小;$http_range:客户端是否使用了 Range 请求。下面是一个日志格式示例,仅用于说明应记录哪些字段:
log_format download_timing
    '$remote_addr "$request" '
    'status=$status body_bytes=$body_bytes_sent '
    'request_time=$request_time '
    'upstream_time=$upstream_response_time '
    'range="$http_range" '
    'user_agent="$http_user_agent"';
示例日志:
198.51.100.20 "GET /files/test.bin HTTP/1.1" status=200 body_bytes=104857600 request_time=21.420 upstream_time=0.082 range="-"
这个结果表示上游约 0.082 秒就返回了,Nginx 最终用了 21.420 秒发送完主体,重点应转向网络、Nginx 限速、磁盘发送能力或客户端路径。
另一个示例:
198.51.100.20 "GET /export?id=7812 HTTP/1.1" status=200 body_bytes=104857600 request_time=21.420 upstream_time=18.900 range="-"
此时大部分时间花在上游准备响应上,应用、数据库或内部存储应排在链路之前检查。
如果需要查看当前生效的 Nginx 配置,可以使用只读检查:
nginx -T
生产环境不要为了验证问题直接删除限速、改动代理缓冲或覆盖整个配置。若确实需要调整,应先备份当前配置,限制影响到一个测试路径或少量流量,先执行 nginx -t 校验,再在可控时间窗口 reload;验证失败时恢复备份配置并重新校验。修改前应确认当前 Nginx 版本、配置文件路径和运行用户,不能照搬其他发行版的路径。
Web 服务器发送文件前,需要持续从文件系统读取数据。以下情况可能造成网卡带宽有余量,但下载速度仍低:
可以先用只读监控观察系统整体状态:
iostat -xz 1 10
vmstat 1 10
free -h
df -hT
df -ih
iostat 如果未安装,可先使用 vmstat、free 和系统现有监控,不要为了排障在高峰期临时运行高负载磁盘测试。
重点观察:
r_await、w_await:读写请求平均等待时间;aqu-sz:设备队列长度;%util:设备忙碌程度;vmstat 中的 si、so:是否发生交换;wa:CPU 等待 I/O 的比例;这些指标没有适合所有 SSD、NVMe、云盘的统一阈值。比如 %util 在多队列设备上的解释与单队列设备不同,不能看到 80% 就断定一定满载。更可靠的方法是观察下载速度下降是否与读延迟、队列长度和 I/O 等待同步发生。
同一个文件第一次访问慢、随后访问明显变快,可能是首次需要从存储读取,后续命中了页缓存。此时不能只看第二次下载结果。应在相近条件下比较:
可以查看进程级 I/O:
pidstat -d 1 10
如果 Nginx、Apache 或应用进程的读速率与下载速率同步下降,并且设备 r_await、队列和 wa 同时升高,磁盘或存储层的可能性较大。
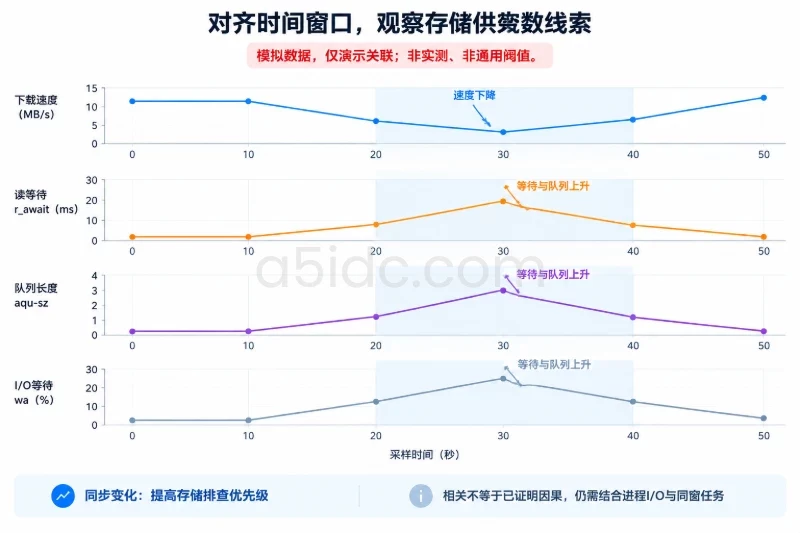
不要在生产高峰期直接使用大文件 dd、fio 等命令做压力测试。它们可能污染页缓存、制造额外 I/O,甚至影响同一存储卷上的数据库和其他服务。需要验证存储性能时,应使用隔离卷、测试文件和维护窗口,并提前确认测试不会覆盖业务数据。任何涉及覆盖设备或创建测试文件的操作,都应先备份并明确回滚方式。
如果磁盘等待不高,但发送速度仍低,还要排除系统资源:
top
free -h
vmstat 1 10
ulimit -n
ss -s
应关注:
SYN_RECV、TIME_WAIT 或已建立连接是否远超平时。动态压缩、加密、实时打包、图片处理和导出文件生成,可能让 CPU 成为瓶颈。此时文件并非简单地从磁盘读出,而是每发送一段就要完成计算。若 CPU 使用率升高、应用线程排队,网卡仍不可能跑满。
下载接口可以分为两类:
动态接口出现以下现象时,应用层优先级较高:
time_starttransfer 长期超过平时;upstream_response_time 接近 request_time;应用日志最好记录请求 ID、用户或任务 ID、鉴权耗时、数据库耗时、文件生成耗时、开始发送时间和完成时间。例如,下面是结构示例:
request_id=8d31 method=GET path=/export
auth_ms=24 db_ms=18420 build_ms=3120
first_byte_ms=21640 send_ms=1920 total_ms=23560
bytes=104857600 status=200
这里数据库和生成阶段用了约 21.5 秒,而实际发送只用了约 1.9 秒。即使服务器出口没有明显流量,也不能把问题归为网络。
相反,如果日志接近以下形式:
request_id=91af method=GET path=/files/test.bin
auth_ms=8 db_ms=0 build_ms=0
first_byte_ms=35 send_ms=21400
bytes=104857600 status=200
应用和数据库基本没有持续参与,应该转向入口、存储和链路。
数据库可能影响下载的场景包括:
排查时需要分别记录“查询完成时间”和“开始发送时间”。如果数据库查询只是生成签名 URL 前的一次短查询,它通常只影响首字节;如果应用使用游标持续查询并边读边发送,数据库延迟和连接池则可能持续影响响应体。
数据库排查优先使用已有的慢查询日志、连接池指标、查询耗时分布和锁等待指标。需要查看执行计划时,应先使用不会执行查询的 EXPLAIN,不要在生产高峰期直接运行会实际执行并放大负载的分析语句。涉及索引、表结构、参数或数据修改时,应先备份、评估锁影响,并准备回滚方案;不要为了验证下载速度直接清理、重建或修改业务数据。
有些下载 URL 由应用转发到对象存储、文件服务或内部 API。此时服务器出口带宽有余量,可能只是服务器到上游的读取速度不足。
应分别测量:
如果应用从上游读取只有 5 MB/s,再大的服务器公网带宽也无法让客户端获得更高速度。此类问题需要查看上游服务指标和应用转发日志,不宜单独调整本机网卡或 Nginx 缓冲区。
A5数据为海外文件下载与业务接口提供多地区物理服务器资源,覆盖中国香港、美国、日本等地。香港产品提供CN2与国际带宽选择,美国常规系列提供CN2 GIA线路;不同系列的NVMe存储、大内存和多核计算配置,可为静态文件分发、数据库缓存及动态文件生成提供硬件基础。香港存储系列另有大容量企业级硬盘方案,满足文件库、备份与归档需求,形成覆盖网络、计算和存储的资源选择。
下面是一套适合生产排障的顺序,先获取信息,再做范围有限的验证。
选择一个已知大小的文件或固定参数的导出任务,记录:
同一时间不要混用浏览器、下载器和命令行结果。不同工具可能使用不同的连接数、Range 请求和缓存策略。
本机测试可以判断 Web 入口、应用和文件读取是否大致正常,但不能代表公网链路。应至少比较以下结果:
| 本机结果 | 公网结果 | 优先怀疑方向 |
|---|---|---|
| 快 | 慢 | 跨地域链路、入口限速、客户端路径、IPv4/IPv6 |
| 慢 | 同样慢 | 磁盘、应用、数据库、上游存储或本机 Web 服务 |
| 首字节慢 | 首字节也慢 | 应用、数据库、内部上游 |
| 首字节快、主体慢 | 首字节快、主体也慢 | 网络、限速、磁盘发送、客户端接收 |
| 本机快且公网只有部分地区慢 | 受影响地区路径或边缘入口 | |
| 多连接明显快于单连接 | 单连接 TCP、每连接限速或入口策略 |
本机测试要尽量保持相同的 Host、路径和认证逻辑。直接访问 127.0.0.1 可能绕过公网负载均衡、TLS、CDN 和部分 Nginx 配置,因此只能作为局部隔离测试。
如果 request_time 很长而 upstream_response_time 很短,先查网络、磁盘、限速和客户端路径。如果两个时间都很长,再进入应用和数据库分支。
如果日志没有记录 $body_bytes_sent、请求耗时或 Range 信息,可以先补充低成本日志字段。修改日志格式不会自动修复故障,但能减少对单一带宽图的猜测。修改配置前应备份文件并确认日志量、磁盘空间和隐私字段,避免为了排障造成日志盘写满。
测试不要只执行一次命令,而应让下载和监控同时进行。至少保留:
iostat 或云监控中的磁盘读延迟;vmstat 中的 I/O 等待;ss -tin 中的 RTT、拥塞窗口和重传;ip -s link 中的网卡错误和丢包;如果这些指标都正常,但某个地区速度低,链路和入口路径的优先级上升。如果磁盘等待明显升高,先处理存储争用;如果应用线程或数据库连接池耗尽,则不要继续做网络调优。
排障验证应一次只改变一个变量。例如:
任何配置变更都要记录原值、影响范围、开始时间和回滚命令。验证成功不代表可以直接推广到全部下载接口,还要检查 CPU、磁盘、连接数、错误率和费用风险。
表现可能是:
ss 显示重传增加,拥塞窗口反复收缩;这时应优先保留受影响区域的路径、时间和 TCP 证据,检查机房上游或相关入口。不要因为服务器网卡只有 100 Mbps 就直接升级到更高带宽;如果瓶颈在跨地域路径,升级带宽未必改变单连接体验。
表现可能是:
此时应沿入口链路搜索 limit_rate、用户配额、节点策略、服务商限速和应用返回的限速标记。不要仅根据网卡利用率判断线路故障。
表现可能是:
iostat 的读等待和队列长度上升;此时根因可能是存储争用、文件所在卷性能不足或文件系统缓存压力。处理方向包括错开高 I/O 任务、改善文件存储层、使用适合的缓存策略或把静态文件与数据库放到不同资源池,而不是先调整 TCP 参数。
表现可能是:
time_starttransfer 高;upstream_response_time 接近总耗时;此时数据库或应用才是主要瓶颈。应拆分权限查询、数据查询、文件生成和发送阶段,避免把已经生成的文件每次都实时重算。若改为异步生成或缓存结果,还需要评估数据时效、权限隔离和临时文件清理策略。
还要检查客户端侧:
命令行从相同网络出口访问,可以帮助排除浏览器展示层问题。但如果命令行与浏览器使用的连接方式不同,也要对照请求头和最终响应 IP,不能简单把两者结果混为一谈。
根因处理后,需要使用相同文件、相同地区、相同协议地址和相近时间窗口重新测试。恢复验证至少包括:
例如,原来 100 MB 文件首字节为 18 秒、总耗时 24 秒;调整数据库查询后首字节降到 0.3 秒,但总耗时仍为 23 秒,说明只修复了准备阶段,传输阶段的链路、限速或存储问题还没有解决。反过来,如果首字节一直正常,取消限速后速度提高,但磁盘 %util 和其他业务延迟明显上升,也不能把变更直接视为完整修复。
涉及 Nginx、网关或应用配置的变更,应保留变更前版本。验证失败时恢复原配置,执行配置语法检查,再在可控窗口 reload;不要通过删除配置文件、覆盖整个目录或重启所有服务来“碰运气”。涉及数据库参数、索引、权限和防火墙的变更,还要单独准备备份、影响评估和回滚方案。
要避免下次再次陷入“带宽明明没跑满”的争论,建议按下载链路持续记录以下指标:
request_time、upstream_response_time、每个后端节点的响应时间、限速命中次数、连接数和队列长度;告警不要只设置“出口带宽超过某个百分比”。更有价值的组合条件是:某地区下载速度持续低于基线,同时首字节正常、TCP 重传升高;或者首字节时间持续升高,同时应用队列和数据库延迟上升;又或者磁盘读等待升高并与多个下载接口同时变慢。这样才能把链路、磁盘和应用瓶颈区分开,并在带宽尚未跑满时提前发现真正影响用户下载的环节。