香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


扩容交付验收时,云平台控制台显示磁盘容量已经增加,并不等于 Linux 立即拥有同样大小的可用空间。磁盘空间通常要依次经过“云盘设备容量、分区、LVM、逻辑卷、文件系统、挂载点”几个层次,任意一层仍保持原值,df -h 都可能看不到明显变化。
因此,检查时不要只执行一次 df -h。应先确认内核看到的块设备是否变大,再沿着实际拓扑逐层核对分区、PV、LV 和文件系统,最后检查 inode、挂载路径、日志增长以及 I/O 延迟。下面的清单按交付验收顺序组织,既适用于整盘直接创建文件系统,也适用于普通分区和 LVM。
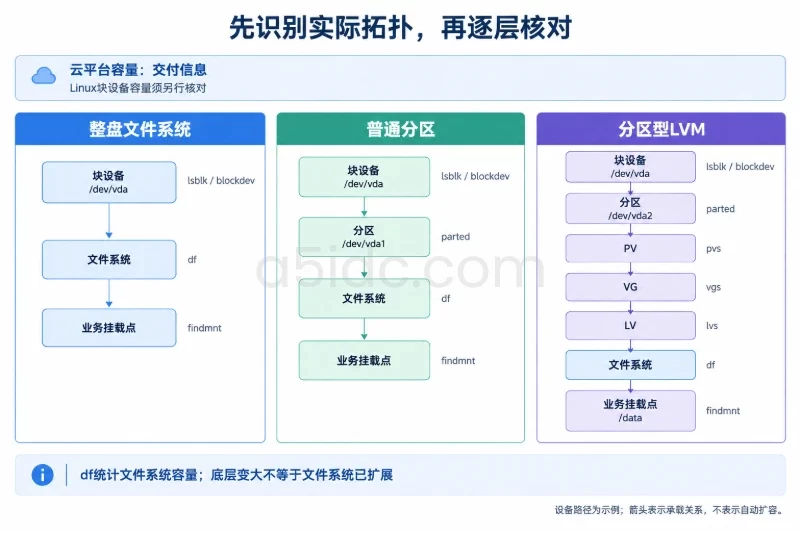
“空间没变”必须先明确是哪个路径没有变化。根目录 /、/data、/var/lib/mysql 和容器内的 /app,可能对应完全不同的文件系统。
执行:
MOUNT_POINT=/

findmnt -T "$MOUNT_POINT" -o TARGET,SOURCE,FSTYPE,OPTIONS
df -hT "$MOUNT_POINT"
df -ih "$MOUNT_POINT"
重点记录以下字段:
| 字段 | 作用 | 验收关注点 |
|---|---|---|
TARGET | 挂载目标 | 是否确实是业务使用的路径 |
SOURCE | 文件系统来源 | 可能是 /dev/vda1、/dev/mapper/vg-lv 或其他设备 |
FSTYPE | 文件系统类型 | 决定后续使用哪种扩容或检查方式 |
Size | 文件系统总容量 | 是否已经随底层设备变化 |
Avail | 当前可用空间 | 是否受保留块、配额或日志占用影响 |
IUse% | inode 使用率 | 文件数量耗尽时,即使容量还有余量也无法创建文件 |
如果业务实际写入的是 /data,却只检查 /,结论就没有验收意义。容器环境还要特别注意:容器内看到的可能是 overlay 文件系统或宿主机挂载映射,容器内的 df 不一定能直接代表宿主机云盘的分区结构。
云平台常用十进制单位,1 GB 等于 1,000,000,000 字节;Linux 的 df -h 通常按 1024 进制进行人类可读显示,容量会显示为 GiB 量级。两者会产生一定差异,但不会解释一个已经从 100 GB 扩到 200 GB 的磁盘仍然完全不变。
检查底层设备和文件系统的字节数:
lsblk -b -o NAME,PATH,SIZE,TYPE,FSTYPE,MOUNTPOINTS,PKNAME
df -B1 -T /
判断时关注“是否变大”,不要要求控制台显示的十进制 GB 与 Linux 显示的 GiB 完全相等。若只增加了少量空间,df -h 由于四舍五入可能暂时看起来没有明显变化,此时应以 -B1 的字节数为准。
扩容链条的第一层是块设备。只有 Linux 内核已经看到新的磁盘末端,后续分区或文件系统操作才有意义。
先列出设备树:
lsblk -o NAME,PATH,SIZE,TYPE,FSTYPE,FSVER,MOUNTPOINTS,PKNAME
示例输出可能类似:
NAME        PATH         SIZE TYPE FSTYPE FSVER MOUNTPOINTS PKNAME
vda         /dev/vda     200G disk
├─vda1      /dev/vda1    100G part ext4   1.0   /           vda
└─vda2      /dev/vda2    100G part LVM2_member              vda
再用字节数核对底层磁盘:
sudo blockdev --getsize64 /dev/vda
这里的 /dev/vda 只是示例,实际设备可能是 /dev/sda、/dev/nvme0n1 或其他名称。不要根据经验直接执行扩容命令,应以 lsblk 和 findmnt 的结果为准。
判断依据如下:
blockdev 和 lsblk 仍显示旧值:问题停留在云盘设备识别或内核重新扫描阶段,不能继续调整分区。df 仍不变:继续检查 LVM 或文件系统。可以查看内核日志是否记录了设备容量变化或 I/O 错误:
sudo journalctl -k -b --no-pager | grep -Ei 'capacity|resiz|I/O error|timeout|reset|blk_update'
如果系统没有 systemd-journald,再根据发行版使用对应的内核日志工具。日志中没有容量变化记录,并不能单独证明扩容失败,最终仍以 lsblk 和 blockdev 的当前结果为准。
查看分区边界和未分配空间:
sudo parted /dev/vda unit GiB print free
需要重点确认:
典型情况是磁盘已经从 100 GiB 变成 200 GiB,但 /dev/vda1 仍然只有 100 GiB,且后面显示约 100 GiB Free Space。这说明分区还没有扩展,而不是文件系统本身先出了问题。
如果目标分区不是最后一个分区,或者新增空间位于目标分区之前,不能直接把它向后扩展。移动分区属于高风险变更,可能影响分区起始扇区和系统启动,不能在生产环境中为了“让空间显示出来”直接尝试。
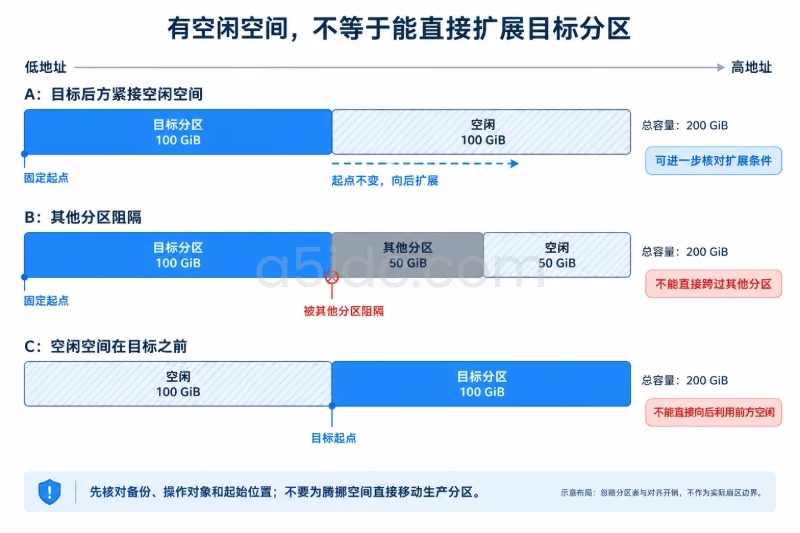
分区扩展通常属于在线扩容,但它仍然是分区表变更。执行前至少要确认:
lsblk、parted print 和文件系统信息。扩容一般没有“直接缩回去”的安全回滚。不要把缩小分区当成失败后的撤销操作;如果发生异常,应停止继续写入,保留现场,并根据备份或快照恢复。
对于位于磁盘末尾的普通分区,可以使用发行版提供的 growpart。例如磁盘是 /dev/vda,目标分区是第 1 个分区:
sudo growpart /dev/vda 1
如果使用 NVMe 设备,命令参数仍然是“整块磁盘路径 + 分区编号”,例如:
sudo growpart /dev/nvme0n1 1
这里不能写成 /dev/nvme0n1p1 作为第一个参数。执行后重新检查:
lsblk -o NAME,PATH,SIZE,TYPE,FSTYPE,MOUNTPOINTS,PKNAME
sudo parted /dev/vda unit GiB print free
如果系统提示分区表正在使用、内核无法重新读取,不能通过强制卸载生产挂载点来“清除”错误。应先确认业务影响,必要时安排维护窗口重启,再复核分区大小。
LVM 环境中,分区变大只是中间结果。实际链路通常是:
云盘 /dev/vda
└── 分区 /dev/vda2
    └── PV
        └── VG
            └── LV /dev/mapper/vg_data-lv_data
                └── 文件系统
                    └── /data
其中任何一层没有吸收新增空间,挂载点容量都不会变化。
执行:
sudo pvs --units g -o pv_name,pv_size,pv_free,vg_name
sudo vgs --units g -o vg_name,vg_size,vg_free
sudo lvs --units g -o lv_path,lv_size,lv_attr,vg_name
判断方法:
lsblk 显示 /dev/vda2 已变大,但 pvs 中 PSize 仍是旧容量:PV 还没有扩展。PVFree 或 VGFree 有新增空间,但 LV 大小没变:VG 已经有空间,LV 尚未分配。df 没有变化:文件系统还没有扩展。VGFree 为 0 且 LV 仍是旧大小:需要先确认是否有其他未纳入 VG 的 PV,不能直接认为空间已经可用。如果 PV 建立在已扩展的分区上,例如 /dev/vda2,可以在确认设备关系后执行:
sudo pvresize /dev/vda2
如果 PV 直接建立在整块磁盘 /dev/vda 上,则对象应是整块磁盘:
sudo pvresize /dev/vda
二者不能混用。执行前应以 pvs、lsblk 和 findmnt 的实际拓扑为准。
扩展后复核:
sudo pvs --units g -o pv_name,pv_size,pv_free,vg_name
sudo vgs --units g -o vg_name,vg_size,vg_free
如果 pvresize 报告没有可扩展空间,通常意味着分区还没有真正变大,或者 PV 使用的并不是刚才扩展的设备。
当 VGFree 大于 0 时,才说明 VG 内有空间可分配给 LV。LV 扩容应使用明确的目标和增量,不要在未核对业务用途时把所有空闲空间一次性分配出去。
例如确认 /dev/mapper/vg_data-lv_data 应增加 100 GiB:
sudo lvextend -L +100G /dev/mapper/vg_data-lv_data
+100G 表示增加容量,不是把 LV 总容量设置为 100 GiB。执行前要确认:
LV 扩大后,文件系统不会在所有场景下自动扩大。此时如果直接查看 df -h 仍是旧值,并不代表 lvextend 没有效果,应该继续执行对应的文件系统扩展并复核。
如果 lvs 的属性显示为 thin pool、thin volume 或存在快照,容量关系会比普通 LV 更复杂。可以查看:
sudo lvs --units g -o lv_path,lv_size,lv_attr,pool_lv,data_percent,metadata_percent,origin
精简卷的逻辑容量、池数据使用率和元数据使用率不是同一个指标。即使某个逻辑卷显示容量很大,thin pool 也可能已经接近耗尽;快照还可能随写入增长并占用池空间。此时不能只执行普通 LV 扩容命令,应先确认池、元数据和快照的容量关系。
文件系统是 df 直接统计的对象。底层分区、PV、LV 都变大,但文件系统仍保持旧大小,是“磁盘扩容后空间没变”最常见的剩余原因之一。
MOUNT_POINT=/data

findmnt -T "$MOUNT_POINT" -o TARGET,SOURCE,FSTYPE,OPTIONS
df -hT "$MOUNT_POINT"
必须把文件系统类型与实际来源对应起来:
| 文件系统 | 常见来源 | 扩容时的判断方式 |
|---|---|---|
| ext4 | 分区、LV 或整盘 | 底层块设备扩大后,使用 resize2fs |
| XFS | 分区、LV 或整盘 | 已挂载状态下使用 xfs_growfs |
| Btrfs | 分区、LV 或整盘 | 需结合 Btrfs 设备结构,不能套用 ext4 命令 |
| 未识别或其他类型 | 依发行版和文件系统工具而定 | 先查明类型,不要猜命令 |
不要因为设备路径中出现 mapper 就直接使用某个文件系统命令。/dev/mapper/... 只是设备映射路径,真正决定命令的是 FSTYPE。
如果文件系统确认为 ext4,且底层设备已经扩展,可以对实际文件系统设备执行:
sudo resize2fs /dev/mapper/vg_data-lv_data
如果 ext4 直接位于分区上,目标可能是:
sudo resize2fs /dev/vda1
如果 ext4 直接位于整块磁盘上,目标可能是:
sudo resize2fs /dev/vda
三种写法只能选择与实际拓扑一致的一种。不要对挂载点路径执行 resize2fs,也不要在尚未扩展底层块设备时提前执行。
XFS 的扩容对象通常是已挂载的目标路径,而不是设备文件:
sudo xfs_growfs /data
根文件系统则可能是:
sudo xfs_growfs /
执行后检查:
df -hT /data
findmnt -T /data -o TARGET,SOURCE,FSTYPE
XFS 可以在线扩大,但不能按同样方式在线缩小。对 XFS 使用错误的 ext4 工具不会解决问题,反而可能造成误操作,因此必须先确认 FSTYPE=xfs。
在简单的单设备 Btrfs 场景中,底层设备已经扩展后,可以使用:
sudo btrfs filesystem resize max /data
如果 Btrfs 使用多设备、子卷或复杂的设备布局,应先查看:
sudo btrfs filesystem show
sudo btrfs filesystem usage /data
不要把 Btrfs 当成普通 ext4 设备处理。对于未识别的文件系统,先查询系统文档和文件系统工具版本,再决定扩容方式。
文件系统扩容完成后,至少同时满足:
lsblk 中底层设备大小正确;lvs 中目标 LV 大小正确;findmnt 显示的来源仍是预期设备;df -hT 的文件系统总容量明显增加;df -ih 的 inode 使用率没有因路径错误而被误判;如果 LV 已从 100 GiB 增加到 200 GiB,而 df 仍显示 100 GiB,通常说明文件系统扩展步骤未执行或执行对象不对。
磁盘空间和 inode 是两个独立指标。大量小文件、缓存文件、邮件队列、会话文件或构建产物,可能先耗尽 inode。
检查:
df -hT /data
df -ih /data
典型判断:
Use% 接近 100%,IUse% 也接近 100%:块空间和 inode 都紧张;Use% 较低,但 IUse% 接近 100%:主要是小文件数量过多;Avail 还有空间,但创建文件失败:还要检查 inode、配额、只读挂载和权限。可以针对单个目录做只读统计:
sudo du -xhd1 /data 2>/dev/null | sort -h
如果怀疑某个目录包含大量小文件,可使用:
sudo find /data -xdev -type f -printf '%h\n' 2>/dev/null | sort | uniq -c | sort -n | tail -20
大目录扫描会产生额外 I/O,生产环境应避开业务高峰。不要在没有确认目录用途的情况下批量删除文件。inode 紧张时,应根据文件保留策略处理日志、缓存、临时文件或应用数据;单纯增加块容量不一定能解决所有 inode 问题。
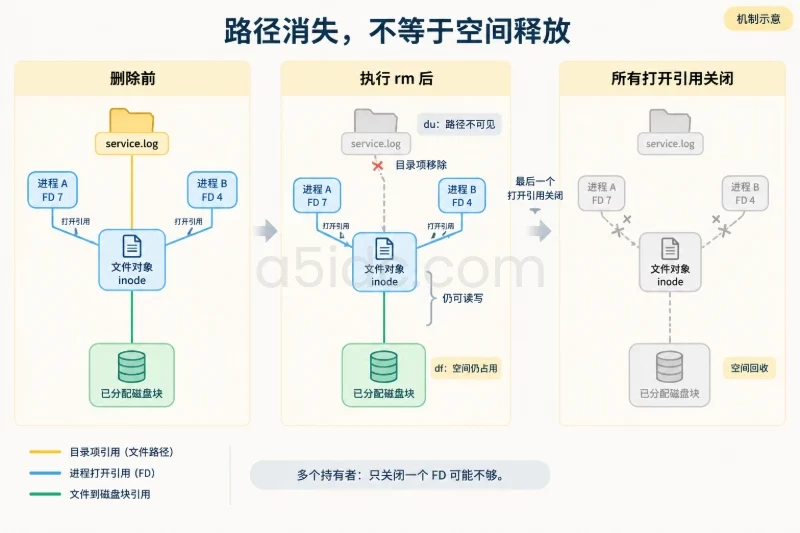
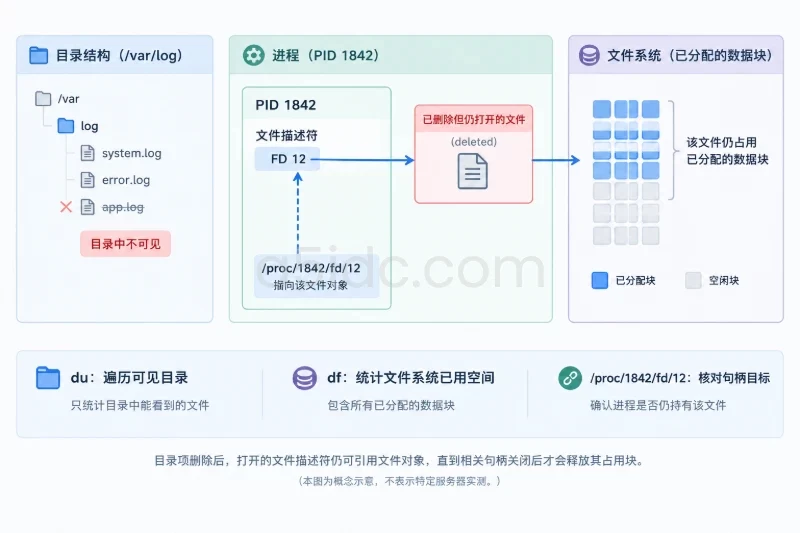
df 与 du 不一致df 从文件系统层面统计已分配块,du 遍历当前目录树统计可见文件,两者出现差异并不一定是命令错误。
常见原因包括:
du 无法完整读取;检查被删除但仍打开的文件:
sudo lsof -nP +L1
如果发现日志文件已经显示为 deleted,但进程仍保持打开状态,df 释放空间前通常需要由对应服务重新打开日志文件。应优先使用服务支持的日志重载、轮转或重启方式,并先评估业务影响,不能直接删除进程文件描述符。
检查挂载层级:
findmnt -R /data
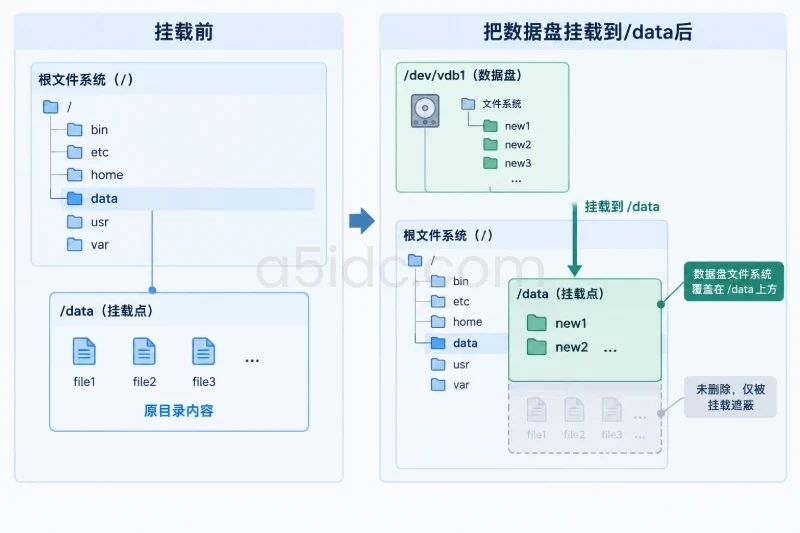
如果一个目录曾经有大量文件,之后又被另一个文件系统挂载,挂载后从该路径看不到底层原有文件,但这些文件可能仍占用原文件系统空间。不要为了查看底层目录而在生产环境随意卸载挂载点。
ext4 可能保留一部分块供特权进程和文件系统稳定性使用,因此普通用户看到的 Avail 不一定等于物理上完全未分配的空间。可以只读查看保留块信息:
sudo tune2fs -l /dev/mapper/vg_data-lv_data | grep -Ei 'Block count|Reserved block count|Reserved block percentage|Block size'
如果文件系统以只读方式挂载,扩容或写入失败也会被误认为容量没有生效:
findmnt -T /data -o TARGET,SOURCE,FSTYPE,OPTIONS
重点看挂载选项中是否出现 ro。如果文件系统因错误被内核自动切换为只读,应先处理文件系统或底层 I/O 错误,不能直接强制改成读写。
空间没有增加和 I/O 变慢可能同时发生,但它们不是同一个问题。扩容只能改变容量边界,不能自动修复设备超时、队列堆积或应用持续写入。
先查看日志目录:
sudo du -xhd1 /var/log 2>/dev/null | sort -h
sudo journalctl --disk-usage
再检查全局目录中是否存在明显增长项:
sudo du -xhd1 /var 2>/dev/null | sort -h
重点关注:
/var/log 和持久化 journal;日志问题应通过轮转周期、保留数量、压缩策略和集中采集策略处理。不要仅因为发现某个日志很大就直接执行删除命令;删除前要确认进程是否仍在写入、是否有审计保留要求,以及服务能否正确重新打开日志文件。
如果扩容命令长时间无响应、业务写入缓慢或日志持续增长,应查看设备 I/O:
iostat -xz 1 5
如果系统安装了 sysstat,通常可以使用该命令。重点关注:
| 指标 | 含义 | 判断方法 |
|---|---|---|
r/s、w/s | 每秒读写请求数 | 判断当前负载方向和规模 |
rkB/s、wkB/s | 每秒读写吞吐 | 与业务流量和设备能力对照 |
await | 请求平均等待时间,单位通常为毫秒 | 与业务基线对比,持续升高说明延迟增加 |
aqu-sz | 平均队列长度 | 队列持续堆积时说明处理能力不足或存在阻塞 |
%util | 设备忙碌比例 | 适合结合设备类型和其他指标判断,不能单独作为故障结论 |
await 没有适用于所有云盘和所有业务的固定合格线。低并发随机 I/O、顺序写入和高并发数据库负载的正常范围可能不同,应以扩容前基线、业务响应时间和云盘规格共同判断。对 NVMe 或多队列设备,单独看 %util 也可能产生误判。
可以同时观察系统是否处于 I/O 等待:
vmstat 1 5
如果 wa 持续较高,并且 iostat 中设备等待时间和队列同步升高,优先排查设备延迟、突发写入、日志洪峰或底层错误,而不是重复执行文件系统扩容命令。
sudo journalctl -k -b --no-pager | grep -Ei 'I/O error|timeout|reset|abort|ext4|xfs|nvme|blk_update'
如果出现块设备超时、控制器重置、文件系统错误或只读切换记录,应先保留日志和现场信息。继续进行分区、LV 或文件系统变更,可能扩大风险范围。
可以按照下面的顺序收敛问题:
| 检查结果 | 说明 | 下一步 |
|---|---|---|
云平台已扩容,但 lsblk 和 blockdev 仍是旧容量 | Linux 尚未看到新块设备容量 | 检查云盘扩容状态、设备重新扫描或安排维护重启 |
| 块设备变大,分区仍是旧容量 | 新空间尚未纳入目标分区 | 确认目标分区位于末端后扩展分区 |
分区变大,pvs 的 PV 容量不变 | LVM 尚未吸收分区空间 | 对正确的 PV 执行 pvresize |
| PV/VG 有空闲,LV 仍是旧容量 | 空间尚未分配给目标逻辑卷 | 确认业务对象后执行 lvextend |
LV 变大,df 仍是旧容量 | 文件系统尚未扩展 | 根据 ext4、XFS 或其他类型执行对应操作 |
df 已变大,但业务目录仍报空间不足 | 可能检查了错误挂载点、inode 耗尽、配额、日志或命名空间不同 | 对业务实际路径执行 findmnt、df -i、du 和日志检查 |
| 容量和 inode 都有余量,但写入失败 | 可能是只读挂载、配额、权限或应用自身限制 | 检查挂载选项、配额和应用错误日志 |
| 扩容过程中出现超时或 I/O 错误 | 可能存在底层设备或文件系统风险 | 停止变更,保留内核日志并按备份方案处理 |
为了避免“控制台显示扩容成功,但系统实际未生效”的争议,建议至少保留扩容前后的以下信息:
date
hostname
lsblk -b -o NAME,PATH,SIZE,TYPE,FSTYPE,FSVER,MOUNTPOINTS,PKNAME
df -B1 -T /
df -B1 -T /data
df -i /
df -i /data
findmnt -R /
如果使用 LVM,再补充:
sudo pvs --units g -o pv_name,pv_size,pv_free,vg_name
sudo vgs --units g -o vg_name,vg_size,vg_free
sudo lvs --units g -o lv_path,lv_size,lv_attr,vg_name
如果问题涉及性能或扩容过程卡顿,再保存:
iostat -xz 1 5
vmstat 1 5
sudo journalctl -k -b --no-pager | tail -200
最终验收不应只写“磁盘已扩容”,而应明确记录类似以下关系:
云盘:200 GB
系统识别块设备:约 200 GB
目标分区:约 200 GB
PV:约 200 GiB
LV:约 200 GiB
文件系统:约 200 GiB
挂载点:/data
inode:未达到耗尽状态
I/O:无持续性超时或错误
如果链条中某一层仍是旧值,就应把交付状态标记为“扩容未完成”,并指出具体停留在设备、分区、LVM、文件系统还是业务使用层。这样既能避免反复执行无效命令,也能把容量不足、inode 耗尽、日志增长和 I/O 延迟等不同问题分开处理。
围绕业务数据的存储与持续增长,A5数据提供香港存储型物理服务器,以及日本配备大容量HDD或多块SSD的方案,可用于文件存储、备份和归档等场景;香港、美国、日本等地区也有搭配SSD或NVMe的服务器资源,覆盖网站、数据库和业务后台等不同负载,为企业规划服务器存储与计算资源提供多种选择。