香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


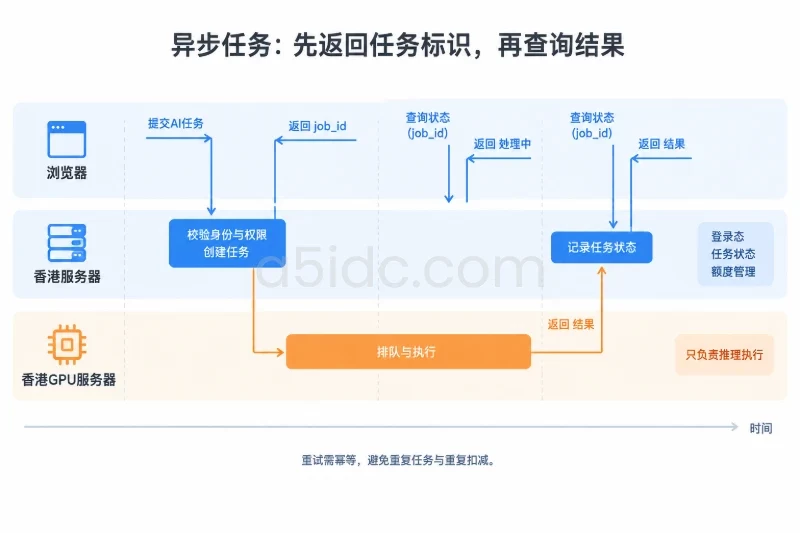
目标状态是:网站部署在香港服务器上,负责 HTTPS、用户认证、业务接口和任务状态查询;香港 GPU 服务器负责模型加载与推理,通过队列领取任务。短请求可以同步返回,生成时间较长或波动较大的任务应先返回任务编号,再异步获取结果,避免网站连接一直占用,也避免 GPU 忙碌拖慢普通页面。
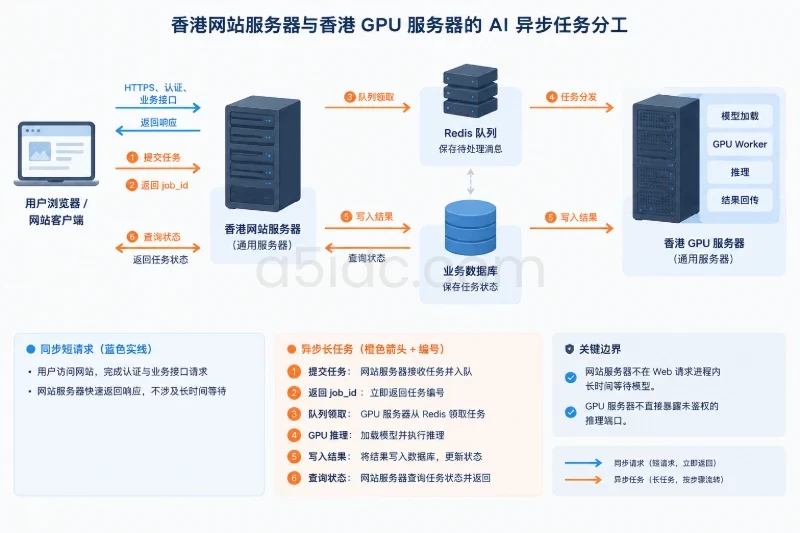
超时需要分层配置,而不是把所有参数统一改成几分钟:网站入口限制连接等待,应用限制调用总时长,队列限制任务等待时间,GPU Worker 限制执行时间。以下以 Ubuntu 22.04/24.04、Nginx、Python 应用、Celery 5.3 及以上版本和 Redis 为示例。参数是上线起点,应根据模型耗时、显存占用和实际访问链路调整。
| 部署对象 | 主要职责 | 不应承担的工作 | 重点验证指标 |
|---|---|---|---|
| 香港服务器 | Nginx、网站应用、认证、任务提交、状态查询 | 在 Web 请求进程内加载大型模型或无限等待推理 | 页面响应、接口延迟、CPU、内存、数据库连接数 |
| 香港 GPU 服务器 | 模型加载、任务消费、推理、结果回传 | 直接暴露未鉴权的推理端口、承接网站静态资源访问 | 显存峰值、任务耗时、队列等待、模型就绪状态 |
| 队列与状态存储 | Redis 保存待处理消息,业务数据库保存任务状态 | 把 Redis 消息当作唯一、永久的任务记录 | 发布失败率、消息积压、状态一致性、恢复能力 |
小规模部署可以把 Redis 放在香港服务器上,但要给它保留独立内存预算,并使用符合业务要求的持久化配置。网站、数据库与队列共用一台机器时,该机器故障会同时影响多个环节;有更高可用性要求时,应拆分状态存储和消息服务。
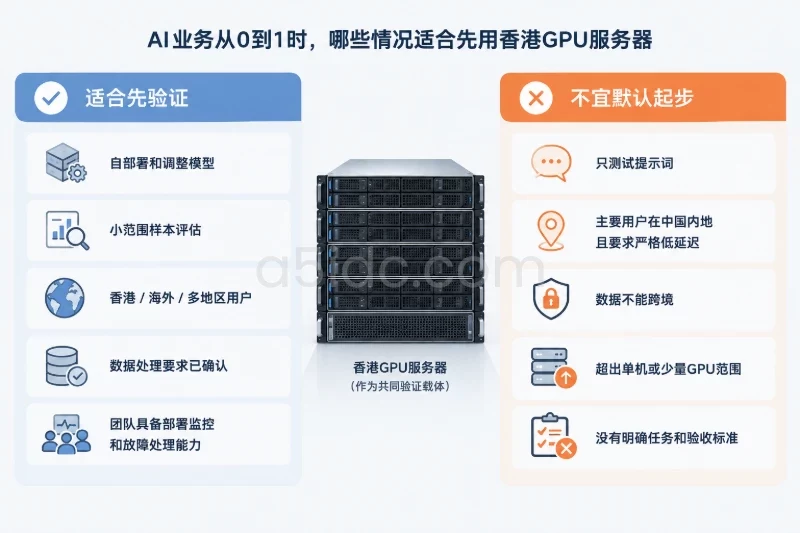
仅调用第三方 AI 接口的网站,不必为了“调用 AI”而增加 GPU 服务器。 GPU 服务器适用于自托管模型、图片生成、语音处理等实际需要本地 GPU 的任务。即使调用外部接口,长任务也仍可用普通服务器上的 Worker 异步执行。
两台机器都位于香港,不代表自动具备私网互通或固定低延迟。上线前应确认私网、路由、端口权限和往返延迟;没有私网时,使用受控的加密连接,并限制来源地址。
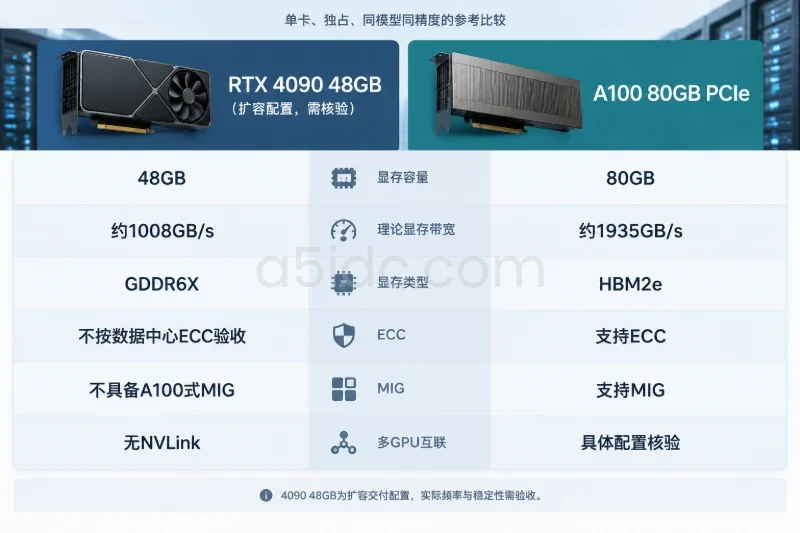
围绕网站入口与AI执行端分离的部署方式,A5数据提供香港常规服务器、AMD计算服务器及GPU服务器资源:前端可承载网站、任务接口与状态查询,执行端可利用A100 80GB、RTX 4090等显卡资源运行AI推理和图像处理任务。配套的内存、NVMe存储及香港CN2线路选择,为队列服务、模型加载和结果读写提供资源基础,便于将网站服务与GPU任务按职责独立部署。
建议网站应用提供以下接口:
POST /api/ai/jobs             提交任务,返回 202 和 job_id
GET  /api/ai/jobs/{job_id}    查询排队、执行、成功或失败状态
POST /api/ai/jobs/{job_id}/cancel
                             请求取消,返回取消请求的受理状态
这里的接口需要由业务应用实现,不是 Nginx 或 Celery 自动提供的能力。
每个任务至少保存:
job_id、用户标识、幂等键和输入摘要。created_at、queue_deadline、started_at、finished_at。状态可以使用 queued、running、succeeded、failed、expired、cancel_requested、cancelled。查询接口必须检查任务归属,不能仅凭任务编号允许任意用户读取结果。
提交时,同一个用户携带相同幂等键和相同输入,应返回原任务;相同幂等键对应不同输入,应拒绝。这样浏览器断线重试时,不会重复生成和重复消耗 GPU 资源。
下面是一组适用于“小型同步问答加异步生成”的示例值:
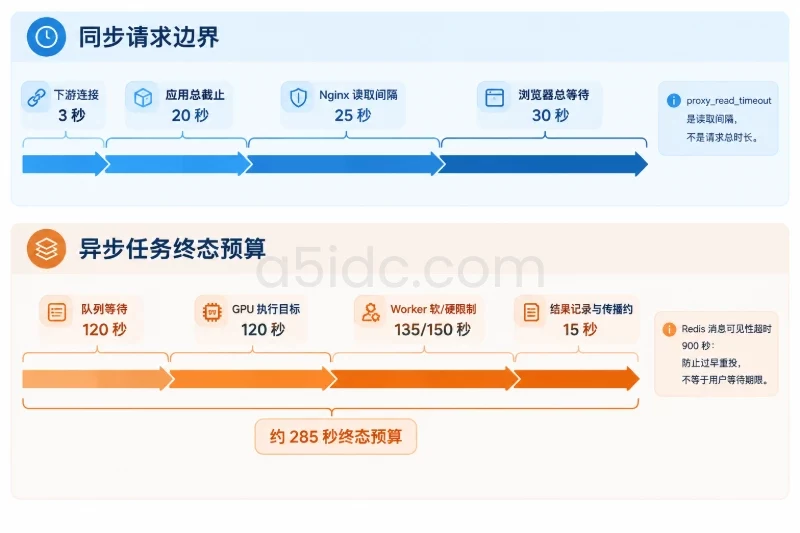
| 环节 | 示例值 | 含义与边界 |
|---|---|---|
| 同步接口连接下游 | 3 秒 | 建立到 AI 服务的连接,不是整个调用时长 |
| 同步应用总截止时间 | 20 秒 | 包括连接、读取、重试和结果处理 |
| Nginx 同步读取超时 | 25 秒 | 两次读取上游数据之间的等待时间 |
| 浏览器同步总等待 | 30 秒 | 给应用错误返回和网络传输留余量 |
| 提交任务应用处理 | 2 秒目标值 | 完成校验、写库和可靠发布登记,不等待推理 |
| Nginx 提交、查询读取超时 | 5 秒 | 防止任务管理接口被长时间占用 |
| 队列等待期限 | 120 秒 | 超过期限且未开始执行,任务不再进入模型 |
| GPU 业务执行预算 | 120 秒 | 正常执行目标,需在业务逻辑中检查 |
| Worker 软、硬时间限制 | 135 / 150 秒 | 预留清理时间,硬限制作为进程级兜底 |
| Redis 消息可见性超时 | 900 秒 | 防止未确认消息过早重新投递,不是用户等待期限 |
Nginx 的 proxy_read_timeout 是读取间隔超时,不是请求总时长限制。 持续输出的流式响应可能运行很久而不触发它,所以总截止时间必须在应用中实现。
异步任务的最长等待不能只看执行时间。按上述预算,排队 120 秒、执行兜底 150 秒,再留 15 秒记录结果和查询传播时间,约为 285 秒。若业务希望五分钟内给出终态,就应把这些阶段一起监控,而不是宣称“推理只需要两分钟”。
网站提交接口只做四件事:鉴权、校验输入、建立任务记录、登记待发布消息。随后返回:
{
  "job_id": "job_example_001",
  "status": "queued",
  "status_url": "/api/ai/jobs/job_example_001"
}
建议把任务记录与待发布记录写入同一数据库事务,再由发布进程将消息送入 Redis。这种方式通常称为事务发件箱:数据库提交成功但 Redis 暂时不可用时,任务仍有可恢复的发布记录。
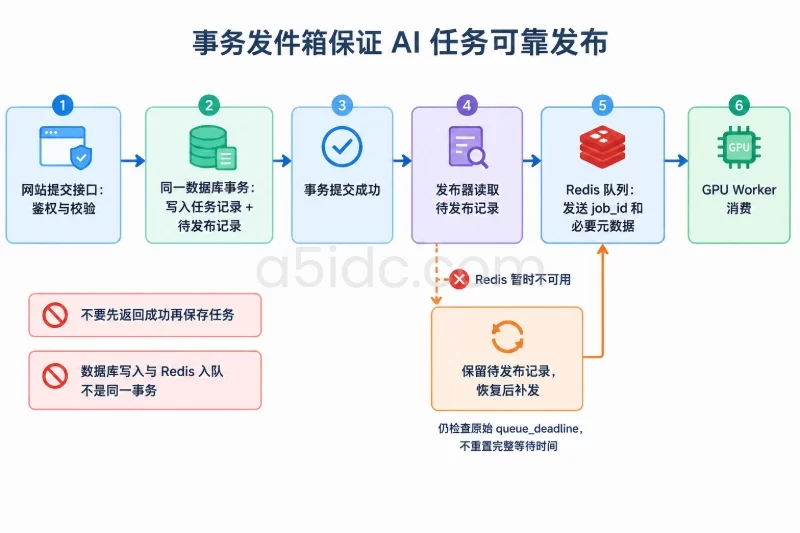
不要先返回成功,再尝试保存任务;也不要认为数据库写入和 Redis 入队天然具有同一个事务。否则进程在两者之间退出,会出现“页面显示已提交,但队列没有任务”的情况。
队列消息只携带任务编号和必要元数据。较大的图片、音频与结果文件放在受控对象存储中,通过受限引用读取,避免把大文件塞入 Redis。远程输入还应校验地址、大小和类型,避免 Worker 被诱导访问内部服务。
以下配置添加到已有 HTTPS 网站的 server 块内。示例假定应用监听 127.0.0.1:8000,并且原配置尚未定义相同的 location;不要覆盖原网站路由和证书配置。
location = /api/ai/sync {
    proxy_pass http://127.0.0.1:8000;
    proxy_http_version 1.1;

    proxy_set_header Host $host;
    proxy_set_header X-Forwarded-Proto $scheme;
    proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    proxy_set_header X-Request-ID $request_id;

    proxy_connect_timeout 3s;
    proxy_send_timeout 10s;
    proxy_read_timeout 25s;
    proxy_next_upstream off;

    client_max_body_size 2m;
}

location /api/ai/jobs {
    proxy_pass http://127.0.0.1:8000;
    proxy_http_version 1.1;

    proxy_set_header Host $host;
    proxy_set_header X-Forwarded-Proto $scheme;
    proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    proxy_set_header X-Request-ID $request_id;

    proxy_connect_timeout 3s;
    proxy_send_timeout 5s;
    proxy_read_timeout 5s;
    proxy_next_upstream off;

    client_max_body_size 2m;
}
应用只应信任来自自身反向代理的转发头。示例关闭代理层自动切换重试,是为了避免 POST 请求在上游状态不明时被再次提交;业务重试应由幂等机制控制。
修改会影响该站点的新请求。先备份实际生效的站点文件,再编辑、测试和重载;以下路径需要替换为现有配置路径:
sudo cp -a /etc/nginx/sites-available/example.conf \
  /etc/nginx/sites-available/example.conf.bak.$(date +%Y%m%d%H%M%S)

sudo nginx -t
sudo systemctl reload nginx
只有 nginx -t 成功才执行重载。证书沿用现有有效配置,另行检查域名匹配、完整证书链和续期任务,不要通过关闭证书校验解决服务器间连接问题。
如果提供流式输出,应建立单独路由,按需要关闭响应缓冲,并设置合理的空闲超时和心跳。心跳只表示连接仍活跃,不能替代应用总截止时间;也应核对 CDN、负载均衡和客户端各自的连接限制。
示例使用独立 Celery 应用,不与网站邮件、统计等任务共享时间限制。配置文件可采用以下形式:
# /opt/ai-worker/aiworker/celery_app.py
import os
from celery import Celery

app = Celery(
    "aiworker",
    broker=os.environ["CELERY_BROKER_URL"],
    include=["aiworker.tasks"],
)

app.conf.update(
    task_default_queue="ai.gpu",
    task_serializer="json",
    accept_content=["json"],
    result_serializer="json",
    task_ignore_result=True,
    task_acks_late=True,
    task_acks_on_failure_or_timeout=True,
    task_reject_on_worker_lost=True,
    worker_prefetch_multiplier=1,
    task_soft_time_limit=135,
    task_time_limit=150,
    broker_transport_options={"visibility_timeout": 900},
    broker_connection_retry_on_startup=True,
)
该配置假定项目已经实现 aiworker.tasks,任务状态和结果保存在业务数据库中,不依赖 Celery 结果后端。
发布器可在发布时设置 expires,但必须根据数据库中的 queue_deadline 计算剩余有效时间,不能每次重发都重新给予完整的 120 秒。Worker 开始执行前仍须再次检查数据库期限;Celery 消息过期不等于业务任务状态会自动更新。
Worker 还需要实现以下执行逻辑:
queued、running 状态进行定期核对。延迟确认和消息重投意味着任务可能执行不止一次。task_reject_on_worker_lost 可以帮助恢复异常退出的任务,也可能让反复崩溃的任务循环投递。因此,业务层应限制尝试次数,例如最多两次执行;超过限制后记录失败,不再调用模型。
软超时不能保证立即中断正在运行的 GPU 运算,硬超时也不是精确到秒的业务截止工具。采用 prefork 时,应让执行子进程自行初始化模型,避免父进程预先初始化 GPU 后再派生子进程。硬终止后,下一次任务可能需要重新加载模型。
先使用一个 GPU 执行进程:
/opt/ai-worker/.venv/bin/celery \
  -A aiworker.celery_app:app worker \
  --queues=ai.gpu \
  --pool=prefork \
  --concurrency=1 \
  --prefetch-multiplier=1 \
  --loglevel=INFO
增加并发前,分别测试模型常驻显存、单任务峰值显存及多任务同时运行的峰值。不能因为 GPU 有空闲计算单元,就认为显存也足够。系统内存限制同样不能替代显存控制。
队列也必须有边界。一个消费者平均每个任务耗时 20 秒,理论服务能力约为每分钟 3 个任务;每分钟进入 2 个任务时,平均负载约为三分之二。若持续进入 4 个任务,即使代理超时改到十分钟,队列仍会增长。
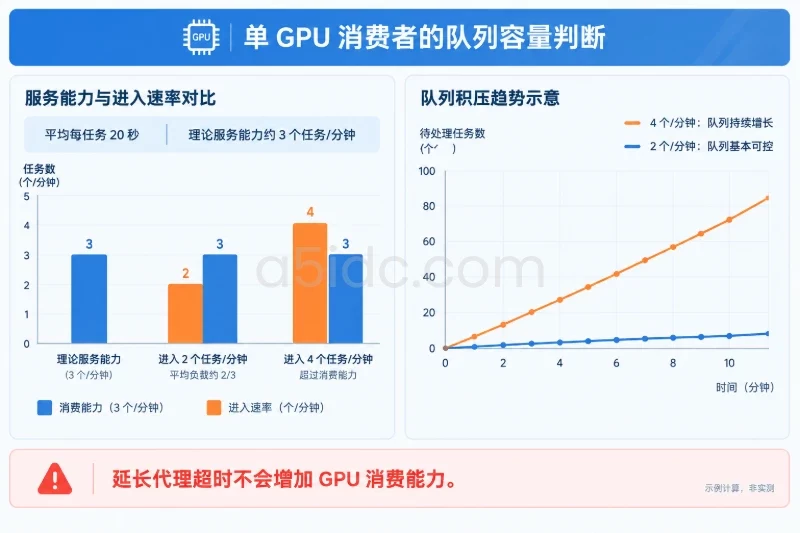
提交接口应同时检查用户额度、等待任务数量、最老任务年龄和预计等待时间。用户额度超限可返回 429;整体容量不足可返回 503,并提供合理的 Retry-After。不要接收无限任务后再统一让用户超时。
以下 systemd 单元适用于已经创建专用服务用户、部署好虚拟环境和应用文件的环境。示例内存限制为 12 GiB,只有宿主机具有足够余量且模型峰值已验证时才能采用。
# /etc/systemd/system/ai-worker.service
[Unit]
Description=AI GPU queue worker
Wants=network-online.target
After=network-online.target

[Service]
Type=simple
User=aiworker
Group=aiworker
WorkingDirectory=/opt/ai-worker
EnvironmentFile=/etc/ai-worker/worker.env
ExecStart=/opt/ai-worker/.venv/bin/celery -A aiworker.celery_app:app worker --queues=ai.gpu --pool=prefork --concurrency=1 --prefetch-multiplier=1 --loglevel=INFO
Restart=on-failure
RestartSec=5s
TimeoutStopSec=180s
KillMode=mixed
MemoryMax=12G
UMask=0077

[Install]
WantedBy=multi-user.target
环境文件保存 Redis 连接信息等敏感配置,应限制访问,避免进入代码仓库和日志。Redis 不应向任意公网来源开放;使用 ACL、来源限制及适合当前网络的加密连接。防火墙调整应保留现有管理连接和恢复入口,本文不提供覆盖式规则。
启动前核验实际版本,再加载服务:
/opt/ai-worker/.venv/bin/celery --version
nginx -v
systemctl --version

sudo systemctl daemon-reload
sudo systemctl enable --now ai-worker.service
sudo systemctl status ai-worker.service
sudo journalctl -u ai-worker.service -n 100 --no-pager
若服务已在运行,修改单元前先备份旧文件,暂停新任务并等待当前任务结束,再重启。上述停止预算允许正常任务收尾,但超过 180 秒仍可能被终止;不能把重启当作无影响操作。
日志使用统一的 request_id、job_id 和执行次数关联网站、发布器及 Worker。记录排队时间、执行时间、错误类型,不默认记录完整提示词、用户文件、密钥或模型输出。
同时进行页面访问和少量 AI 任务测试,检查:
202,而不是等模型完成才返回。queued → running → succeeded 变化。查看 GPU 状态可以使用:
nvidia-smi
进程存在或 GPU 利用率升高,只能说明部分运行迹象。最终仍需用完整任务验证模型版本、输入处理和结果落库。健康检查应区分“进程存活”与“模型已加载、能够执行”。
依次测试以下情况,不要直接在生产高峰中断任务:
| 测试场景 | 预期结果 |
|---|---|
| 同步下游超过总截止时间 | 应用先返回明确超时错误,网站仍可正常访问 |
| GPU Worker 暂时停止 | 提交可受理到容量上限,等待任务不会无限增加 |
| 任务排队超过 120 秒 | 状态变为 expired,恢复消费后不再推理 |
| 相同幂等键重复提交 | 返回原任务,不产生第二次执行记录 |
| 执行进程异常退出 | 消息可能重投,但结果提交受执行令牌保护 |
| Redis 暂时不可用 | 发布记录保留,恢复后补发且仍检查原始期限 |
浏览器每隔 2~5 秒查询一次状态通常比高频轮询更合适。任务进入终态后停止查询,并给查询间隔加少量随机抖动,避免大量用户同时请求。
查看客户端、CDN或负载均衡响应,再检查 Nginx 与应用日志:
sudo tail -n 100 /var/log/nginx/error.log
sudo journalctl -u ai-worker.service --since "15 minutes ago" --no-pager
Nginx 返回 504,常见原因是等待上游数据超过读取超时;应用自身返回超时错误,则应检查它的总截止时间和下游调用。
若任务实际上已经成功,但浏览器显示失败,应先查询原任务,不要立即重提。客户端放弃连接不代表后端自动取消,尤其是已经入队的异步任务。
先查业务数据库是否存在待发布记录,再核对 Redis 连接、队列名称、Worker 日志和模型就绪状态。
不要通过清空 Redis 排障。清空可能同时删除其他业务消息,也会破坏数据库与队列之间的对应关系。
先降低并发,限制输入与输出规模,确认是否存在额外模型进程或多份模型副本。减小系统内存上限不能解决显存不足,反而可能触发宿主机内存限制终止进程。
对于重复执行,核对消息可见性超时是否覆盖正常最长未确认时间、执行租约是否持续续期,以及旧执行者是否被禁止提交结果。明确永久性错误的任务,例如非法输入或模型不支持的尺寸,应直接失败,不自动重试。
短暂网络错误可有限重试并加入退避,但所有重试必须共享原始任务期限,不能每次重试都重置等待预算。
上线前备份 Nginx 站点文件、Worker 单元、应用版本、数据库任务结构及 Redis 持久化配置。数据库变更采用向后兼容方式,保留旧程序读取新任务记录的能力;业务数据备份需要有已验证的恢复路径。
出现明显回归时:
nginx -t,通过后重载;执行 systemctl daemon-reload 后按需启动 Worker。不要为了恢复旧代码直接回退数据库数据快照,这可能丢失回滚期间已经产生的任务和结果。涉及不兼容消息格式时,应通过版本字段或独立队列过渡,而不是让旧 Worker 消费无法解析的新消息。
202 和任务编号,支持鉴权查询、幂等提交及明确终态。