香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


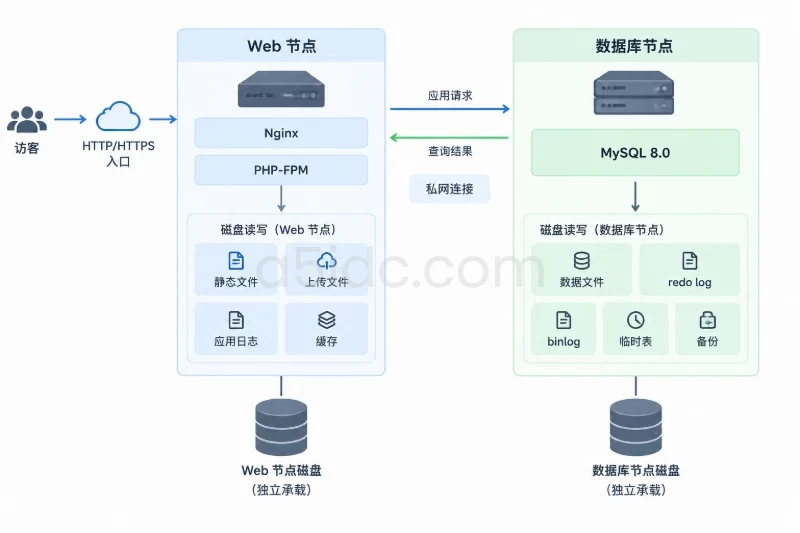
把数据库从 Web 服务器搬到另一台香港服务器后,访问变快并不等于读写压力已经真正缓解。有效验证需要比较分层前后的同一组业务负载,并同时观察 Web 层、数据库层、网络链路和最终请求延迟,而不能只看某一台服务器的 CPU 使用率。
推荐将两台香港服务器分别作为 Web 服务器和数据库服务器,再从第三台独立机器发起压测。测试结果至少要回答三个问题:同等请求量下响应是否更快;达到相同响应目标时可承载的吞吐是否更高;Web 层释放出的资源是否被数据库、磁盘或两台服务器之间的网络消耗掉。
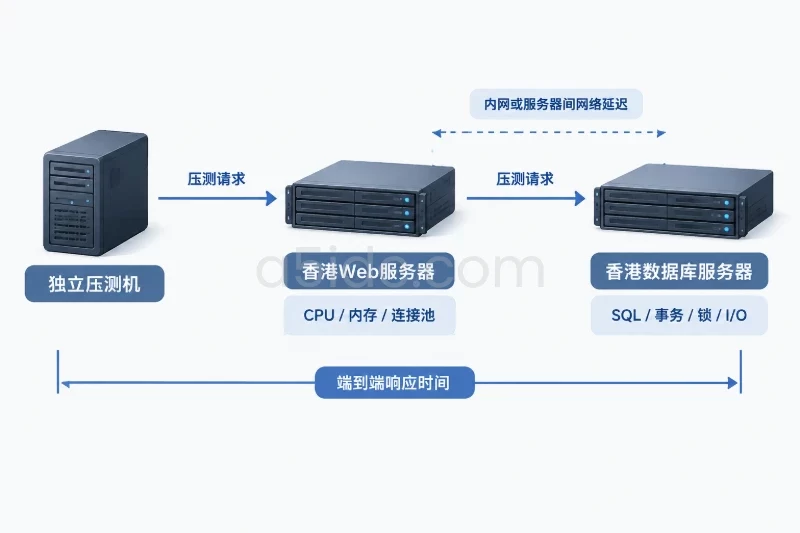
数据库与 Web 分层解决的主要是资源争用问题:
但分层并不会自动降低 SQL 数量,也不会自动把读请求和写请求拆到不同数据库。两台服务器只是将 Web 和数据库放在不同节点上,读写仍然可能集中在同一个数据库实例中。
因此,可以把验收目标拆成四层:
例如,业务可以先设定一组用于压测的示例门槛:
这些数值不是所有业务的通用标准。高并发接口、后台任务、管理系统和交易型业务的目标不同,应以实际 SLO、接口超时时间和业务可接受延迟为准。
至少准备以下两种部署状态:
| 对照组 | 部署方式 | 测试目的 |
|---|---|---|
| A 组 | Web、应用进程和数据库位于同一台香港服务器 | 获取分层前基线 |
| B 组 | Web 位于香港服务器 1,数据库位于香港服务器 2 | 验证资源隔离后的变化 |
两组测试应尽量保持以下条件一致:
如果 A 组使用本机回环地址连接数据库,而 B 组通过两台香港服务器之间的网络连接数据库,新增的网络延迟必须保留在测试中。这部分延迟是分层架构的真实成本,不能为了得到更好结果而绕过。
两台服务器如果位于同一数据中心或具备稳定的内网连接,通常更容易控制延迟和抖动。如果应用到数据库的流量经过公网,还应额外记录连接建立时间、网络抖动、重传和带宽使用率。公网带宽或跨网络链路本身可能成为新的限制因素。
A5数据提供香港物理服务器租用,覆盖Xeon Gold与AMD EPYC等平台,可为Web服务、数据库及独立压测端提供分层部署的计算资源。不同档位的内存与SSD、NVMe存储,为数据库缓存、事务读写和接口处理提供硬件基础;香港产品另有CN2与国际带宽方案,承接不同业务的访问与网络资源需求,让Web层和数据层拥有各自的资源配置空间。
压测程序会消耗 CPU、内存、网络连接和文件描述符。最理想的方式是使用第三台独立的香港服务器作为压测机,并确保它与两台目标服务器不在同一台物理主机上。
如果只能从外部网络发起测试,也可以使用固定位置的压测机,但应在报告中记录压测机所在地。香港压测机测到的是香港机房侧的服务能力;如果真实访问者来自其他地区,还需要增加相应来源的测试,否则不能直接把香港侧结果等同于所有用户的访问体验。
数据库缓冲池、操作系统页缓存和应用缓存会显著影响结果。建议至少执行两种测试:
对 A 组和 B 组必须采用相同的缓存状态。不能让 A 组处于冷缓存、B 组处于热缓存,然后将延迟差异全部归因于分层。
写入测试应使用专用测试数据、测试租户或可恢复的数据库快照。不要直接对生产订单、库存、账户余额等真实数据进行无控制的写入压测。需要清理数据时,应优先使用测试环境快照恢复或经过审批的定向清理方案,避免执行没有范围限制的删除操作。
并发用户数、请求吞吐和响应时间是三个不同指标:
可以用近似关系检查数据是否合理:
并发数 ≈ 吞吐量 × 平均响应时间(秒)
例如,系统以每秒 200 个请求运行,平均响应时间为 0.4 秒,那么平均并发约为:
200 × 0.4 = 80
如果压测报告显示 200 RPS、平均响应时间 0.4 秒,但并发数长期只有 10,通常说明统计口径、压测工具配置或数据采集方式存在问题。
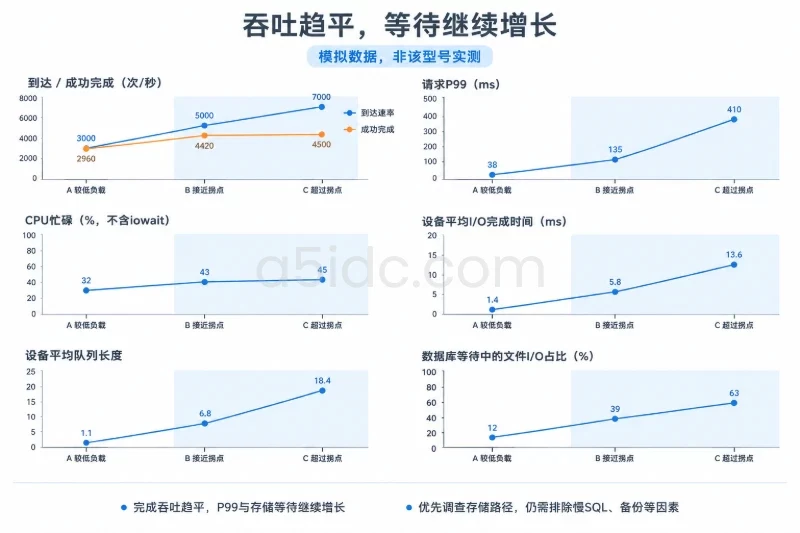
并发数增加不一定代表吞吐量增加。如果数据库已经排队,虚拟用户会堆积在连接池、锁或磁盘队列中,吞吐可能停止增长,而 P95 和 P99 继续变差。
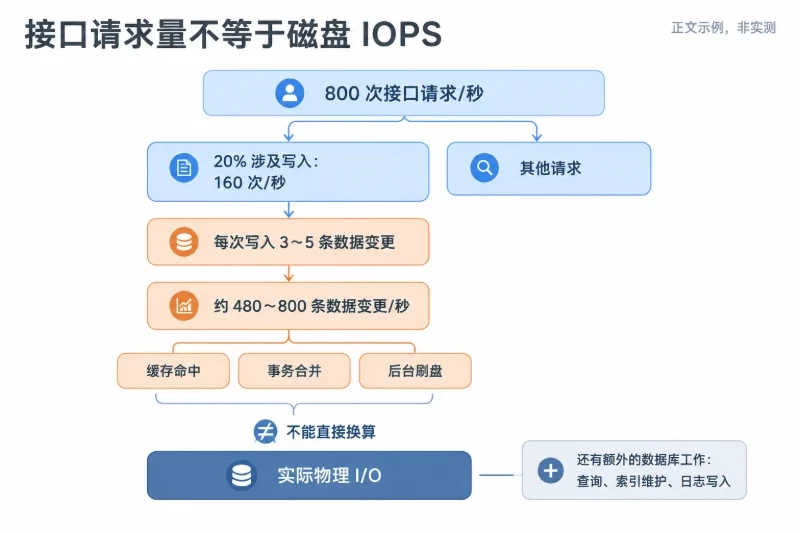
“80% 读、20% 写”应明确是 HTTP 请求比例,还是数据库语句比例。一个查询接口可能执行多条 SQL,一个写入接口也可能同时执行库存查询、事务写入和日志写入。
可以用以下方式估算数据库语句量:
数据库语句量 ≈ HTTP 请求量 × 每个请求平均 SQL 数量 + 后台任务 SQL 量
例如:
那么数据库大致需要处理:
这不等于 1240 TPS。TPS 通常指事务提交次数,多个 SQL 可能属于同一个事务。数据库报告中应分别记录查询量、事务提交量和回滚量。
建议至少准备三种负载模型:
| 场景 | 读取/写入比例 | 主要观察点 |
|---|---|---|
| 读取型 | 80/20 | Web CPU、数据库缓存命中率、查询延迟 |
| 混合型 | 60/40 | 连接池、锁等待、事务响应时间 |
| 写入型 | 30/70 | 磁盘写入、日志刷盘、锁竞争、提交延迟 |
比例应根据业务日志调整。电商列表页、内容展示页通常偏读取型;订单、支付、库存、消息状态更新等业务则可能在高峰期明显增加写入比例。
推荐采用以下测试节奏:
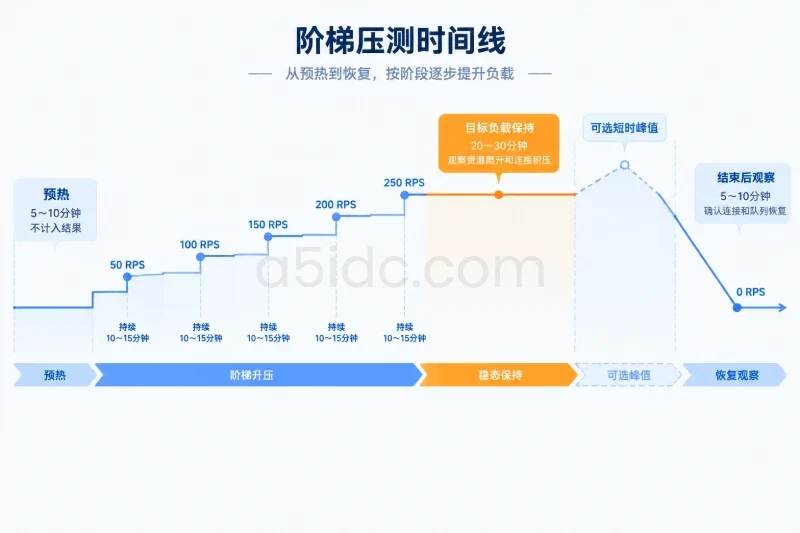
阶梯测试能看出系统在哪个负载区间开始恶化。单次直接施加很高的并发,只能证明系统在某一刻失败,难以判断瓶颈从哪里开始出现。
以下是一个适合改造的 k6 示例。接口路径、请求字段和认证方式均为示例,写入接口只能在具备隔离数据和恢复方案的测试环境使用。
import http from 'k6/http';
import { check, sleep } from 'k6';

const baseUrl = __ENV.BASE_URL || 'https://staging.example.com';
const token = __ENV.AUTH_TOKEN || 'replace-with-test-token';

export const options = {
  stages: [
    { duration: '5m', target: 50 },
    { duration: '10m', target: 100 },
    { duration: '10m', target: 200 },
    { duration: '20m', target: 200 },
    { duration: '5m', target: 0 }
  ],
  thresholds: {
    http_req_failed: ['rate<0.005'],
    'http_req_duration{op:read}': ['p(95)<500'],
    'http_req_duration{op:write}': ['p(95)<800']
  }
};

export default function () {
  const headers = {
    'Content-Type': 'application/json',
    'Authorization': `Bearer ${token}`
  };

  if (Math.random() < 0.8) {
    const response = http.get(
      `${baseUrl}/api/products/12345`,
      {
        headers,
        tags: { op: 'read' }
      }
    );

    check(response, {
      'read status is 2xx': (r) => r.status >= 200 && r.status < 300
    });
  } else {
    const payload = JSON.stringify({
      test_id: `load-${__VU}-${__ITER}`,
      quantity: 1
    });

    const response = http.post(
      `${baseUrl}/api/test-orders`,
      payload,
      {
        headers,
        tags: { op: 'write' }
      }
    );

    check(response, {
      'write status is 2xx': (r) => r.status >= 200 && r.status < 300
    });
  }

  sleep(0.2);
}
如果目标是测量固定 RPS,而不是观察固定虚拟用户数,应使用压测工具的到达率模式。固定 VU 模式下,响应变慢会导致每秒发出的请求数量下降,容易把“系统变慢”误判为“系统吞吐降低”。
Web 层至少记录以下内容:
如果分层后 Web CPU 从 90% 降到 55%,但 P95 没有改善,不能直接认为测试成功。可能是数据库响应变慢、连接池等待时间增加,或者 Web 服务器只是把等待转移到了远端数据库。
数据库层应按照“资源、执行、并发、存储”四个方向采集:
MySQL 或 MariaDB 环境可以使用只读状态查询获取一部分信息。不要把密码直接写在命令行中,也不要使用具有写入权限的账号执行监控命令。
mysql --defaults-extra-file=/etc/mysql/loadtest-readonly.cnf -e "
SHOW GLOBAL STATUS
WHERE Variable_name IN (
  'Threads_connected',
  'Threads_running',
  'Questions',
  'Queries',
  'Com_commit',
  'Com_rollback',
  'Innodb_buffer_pool_read_requests',
  'Innodb_buffer_pool_reads',
  'Innodb_row_lock_time',
  'Innodb_row_lock_waits'
);
SHOW ENGINE INNODB STATUS\G
"
Linux 主机可以在测试期间采集基础资源数据。以下命令只读取系统状态,前提是服务器已安装 sysstat 等工具:
vmstat 1
iostat -xz 1
sar -n DEV 1
pidstat -u -r -d 1
如果数据库使用 PostgreSQL,应根据实际版本查看 pg_stat_database、pg_stat_activity、后台写入统计和 I/O 统计视图。不同版本字段可能不同,先以数据库版本对应的系统视图为准,不要直接套用其他数据库的指标名称。
两台香港服务器之间的网络开销需要单独记录。重点不是单次 ping 的结果,而是应用真实连接中的:
例如,应用每个请求平均返回 120 KB,在 250 RPS 下,单向响应流量约为:
120 KB × 250 = 30,000 KB/秒 = 30 MB/秒
按十进制单位换算,30 MB/秒等于:
30 × 8 = 240 Mbps
这还没有计入请求体、TCP/IP、TLS 和其他后台流量。如果应用和数据库之间还会传输大量查询结果,数据库内网带宽也必须纳入容量估算。
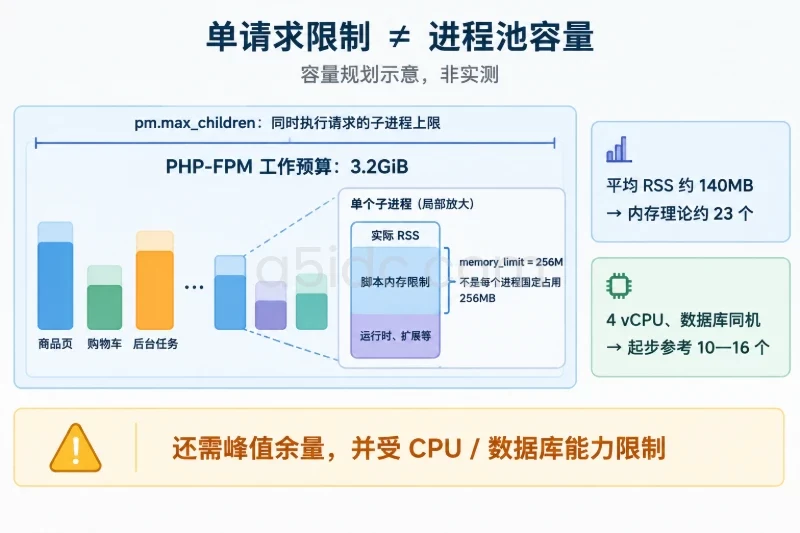
连接池也要按 Web 实例总数计算。例如两台 Web 实例各运行 4 个应用进程,每个进程最多 20 个数据库连接,则理论连接上限为:
2 × 4 × 20 = 160 个连接
这 160 个连接不应直接等同于数据库可以接受的连接数。数据库还要为管理连接、后台任务、监控和突发请求保留空间,连接池上限应与数据库的可用连接预算一起设计。
两种比较方式都需要保留:
同等负载比较,例如 A 组和 B 组都接收 200 RPS,比较:
同等延迟比较,例如都要求 P95 不超过 500 毫秒,比较:
后一种比较更接近容量规划。因为分层后数据库 CPU 可能上升,但如果系统因此完成了更多请求,单看 CPU 上升并不能判定架构变差。
下面是一组用于说明分析方法的模拟数据,不代表某次线上实测。测试采用相同数据集、相同 80/20 读写比例,在目标负载下持续 20 分钟。
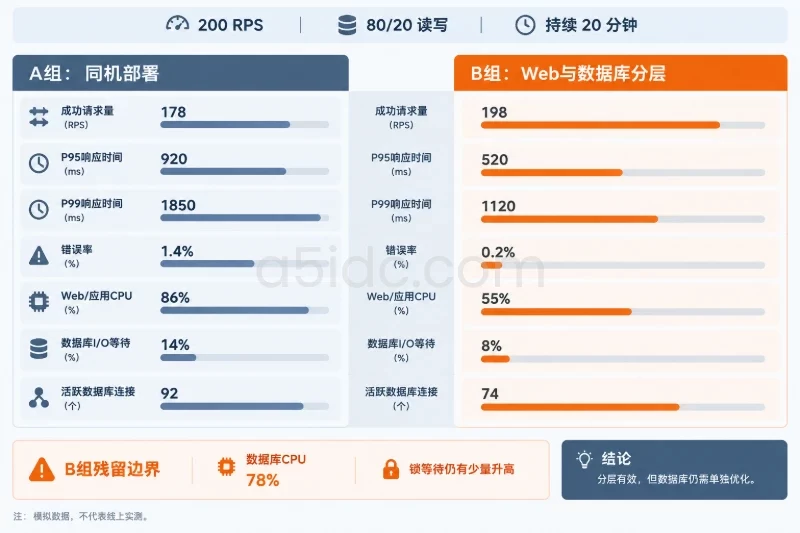
| 指标 | A 组:同机部署 | B 组:Web 与数据库分层 | 观察 |
|---|---|---|---|
| 目标请求量 | 200 RPS | 200 RPS | 相同输入 |
| 成功请求量 | 178 RPS | 198 RPS | B 组排队和失败减少 |
| P95 响应时间 | 920 ms | 520 ms | 接近业务门槛 |
| P99 响应时间 | 1,850 ms | 1,120 ms | 长尾改善 |
| 错误率 | 1.4% | 0.2% | B 组满足示例门槛 |
| Web/应用 CPU | 86% | 55% | Web 资源争用明显下降 |
| 数据库 CPU | 与应用共用主机,难以独立归因 | 78% | 数据库仍是主要消耗者 |
| 数据库 I/O 等待 | 14% | 8% | 同机磁盘争用减轻 |
| 活跃数据库连接 | 92 | 74 | 连接等待减少 |
| 锁等待 | 偶发升高 | 仍有少量升高 | 写入竞争尚未完全解决 |
这组结果可以支持“分层有效,但数据库仍需单独优化”的判断。不能说数据库压力已经消失,因为数据库 CPU 仍接近 80%,写入锁等待也没有完全消失。分层主要消除了 Web 进程与数据库进程之间的资源争用。
| 结果表现 | 更可能的原因 | 判断 |
|---|---|---|
| Web CPU 明显下降,P95 和成功 RPS 同时改善 | 同机 CPU、内存或磁盘争用被拆开 | 分层达到了主要目标 |
| Web CPU 下降,但数据库 CPU、磁盘延迟和锁等待超过门槛 | 数据库成为新的主瓶颈 | 分层有效,但数据库容量不足 |
| Web 和数据库 CPU 都不高,P95 却上升 | 网络往返、连接池、应用线程等待或序列化成本增加 | 检查跨服务器通信路径 |
| 读取接口改善,写入接口基本不变 | 写入受事务、日志刷盘、索引或锁竞争限制 | 分层不能替代数据库写入优化 |
| 只有热缓存测试改善,冷缓存没有改善 | 主要收益来自缓存,而不是分层本身 | 需要分别评估内存和磁盘容量 |
| RPS 继续增加,但 P95 快速恶化 | 系统已进入排队区,吞吐接近饱和 | 不能把更高的请求数当作有效容量 |
| 数据库 QPS 不变,Web 请求变慢 | 单个请求 SQL 数量、锁或连接等待仍是问题 | 检查 SQL 和事务,而不是只加 Web CPU |
尤其要关注 P99。平均响应时间可能只有 300 毫秒,但少量请求因为锁等待或磁盘刷盘达到数秒,这些长尾请求往往会进一步占用连接和线程,最终造成级联排队。
容量不能以“服务器还能不能返回响应”作为标准,而应以“在业务 SLO 内能稳定完成多少请求”作为标准。
例如,B 组在阶梯测试中的模拟结果如下:
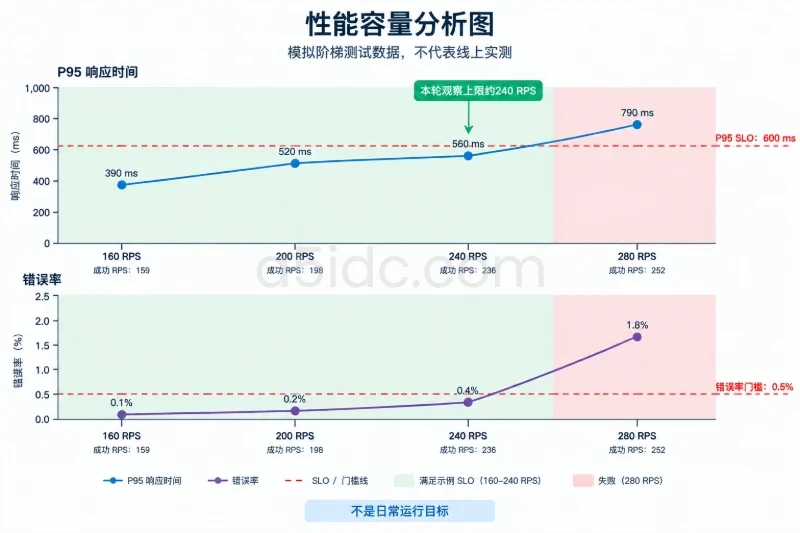
| 目标负载 | 成功 RPS | P95 | 错误率 | 判断 |
|---|---|---|---|---|
| 160 RPS | 159 | 390 ms | 0.1% | 通过 |
| 200 RPS | 198 | 520 ms | 0.2% | 若门槛为 600 ms,则通过 |
| 240 RPS | 236 | 560 ms | 0.4% | 接近边界 |
| 280 RPS | 252 | 790 ms | 1.8% | 失败 |
若业务门槛为 P95 不超过 600 毫秒、错误率低于 0.5%,那么可把 240 RPS 视为本轮测试观察到的上限,但不能把它直接当作日常运行目标。
若需要保留约 25% 的增长余量,可以先按以下方式估算日常安全上限:
240 × 75% = 180 RPS
如果当前高峰为 140 RPS,未来增长系数为 1.3,则预测高峰为:
140 × 1.3 = 182 RPS
这已经略高于按 25% 余量计算的 180 RPS 日常上限。此时不能只因为“240 RPS 测试通过”就认为容量充足,应继续优化数据库或把下一轮目标提升到 280~300 RPS,并重新验证 P95、P99 和数据库 I/O。
增长余量还应区分不同类型的增长:
例如,HTTP 流量只增长 20%,但每个请求的 SQL 数量从 5 条增加到 8 条,数据库压力并不是只增加 20%。容量模型应同时估算 Web RPS、数据库 SQL QPS、事务 TPS 和磁盘写入量。
分层后,可以进一步计算单位请求的资源成本:
如果 Web CPU 总量下降、成功请求量上升,那么 Web 层单位请求成本通常会下降。数据库 CPU 总量即使上升,只要成功事务增加更多、P95 仍满足目标,也不一定是坏结果。
相反,如果 Web CPU 从 85% 降到 40%,但数据库锁等待导致成功请求量下降,说明压力只是从一台机器转移到了另一台机器,不能算完成容量改善。
建议在以下条件下复测,而不是只执行一次压测:
最终可以按下面的边界做判断:
只要每次复测都固定压测机、数据规模、缓存状态、读写比例和统计时段,并同时保存 Web、数据库、网络和业务接口指标,就能判断两台香港服务器的分层究竟是降低了资源争用,还是仅仅把瓶颈从 Web 服务器转移到了数据库服务器。