香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


CPU利用率只有45%,并不代表香港金牌5115服务器还有一半数据库处理能力;32GB DDR4没有用满,也不代表查询不会因读盘而排队。并发压测中的瓶颈,通常表现为吞吐量停止增长、响应时间拉长,以及某一种资源或等待队列同步积压,而不是某个指标单独超过阈值。
对于10核20线程、32GB DDR4这一档配置,数据库瓶颈可能落在单核计算、缓存容量、随机读写与日志落盘、事务锁竞争,也可能根本不在数据库,而在应用连接池或跨地域网络。判断的关键是:把CPU、内存、I/O、网络、数据库等待和请求结果放进同一个观察窗口,找到“并发增加后,哪条队列先增长”,再通过对照复测验证。
评估这台服务器,不能仅凭处理器型号和内存容量给出固定QPS。相同配置执行主键查询、复杂排序和高频事务提交,承载能力可能相差很大;磁盘介质、存储阵列、数据规模及SQL结构,也会改变瓶颈出现的位置。
其中,10核20线程表示10个物理核心、20个逻辑线程,不等于20个独立物理核心的数据库算力。超线程能否提高吞吐,取决于工作负载和执行资源竞争。32GB DDR4则主要影响可驻留的数据、索引和运行时内存,但不能直接推导出磁盘性能。
以Linux上的MySQL 8.0、InnoDB事务负载为例,压测至少应固定以下条件:
每一级负载可以先预热,再观察一个持续数分钟的稳定窗口,按约1秒采样收集系统指标,并保留窗口内的P95、P99和错误率。CPU、磁盘和数据库监控应使用一致时间轴;不要拿五分钟CPU平均值解释某一秒的超时尖峰。
增加并发时,还要区分两种压测方式。固定连接数、收到响应再发送下一次请求,属于闭环负载:服务变慢后,实际发出的请求也会减少。按固定速率持续发送,则更容易暴露队列增长,但必须确认压测工具本身没有达到CPU、网络或连接数上限。
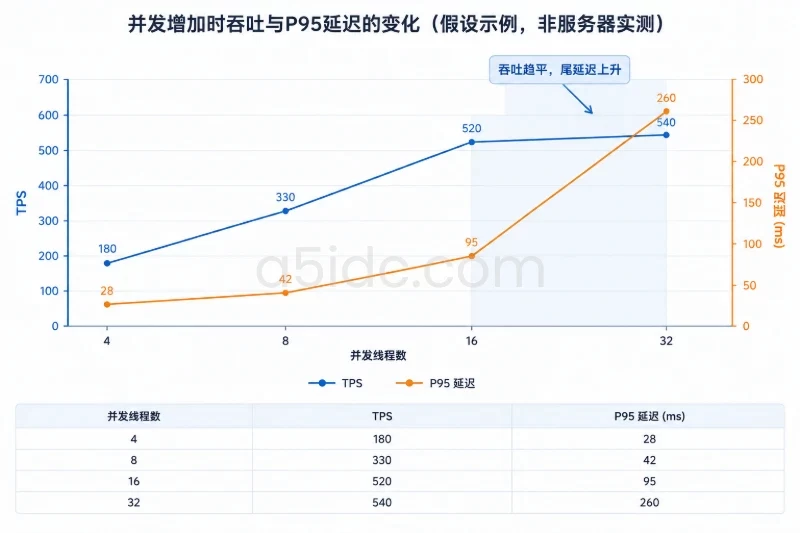
瓶颈拐点不是“CPU达到多少”,而是负载继续增加时,成功吞吐增长明显放缓,同时延迟或错误开始持续上升。
下面是一个混合读写负载的模拟监控窗口,用于解释判断过程,不代表该型号服务器的实际测试成绩。
| 指标 | 窗口A:较低负载 | 窗口B:接近拐点 | 窗口C:超过拐点 |
|---|---|---|---|
| 请求到达速率 | 3000次/秒 | 5000次/秒 | 7000次/秒 |
| 成功完成吞吐量 | 2960次/秒 | 4420次/秒 | 4500次/秒 |
| 请求P99 | 38ms | 135ms | 410ms |
| 错误率 | 0 | 0.2% | 2.0% |
| 主机CPU忙碌比例,不含iowait | 32% | 43% | 45% |
| 数据设备平均I/O完成时间 | 1.4ms | 5.8ms | 13.6ms |
| 数据设备平均队列长度 | 1.1 | 6.8 | 18.4 |
| 数据库活跃线程数,窗口均值 | 24 | 57 | 114 |
| 数据库等待时间中的文件I/O占比 | 12% | 39% | 63% |
从B到C,成功吞吐几乎不再增加,P99、磁盘完成时间和队列却继续增长,数据库文件I/O等待也同步增加。此时应优先调查存储路径,而不是直接升级CPU。
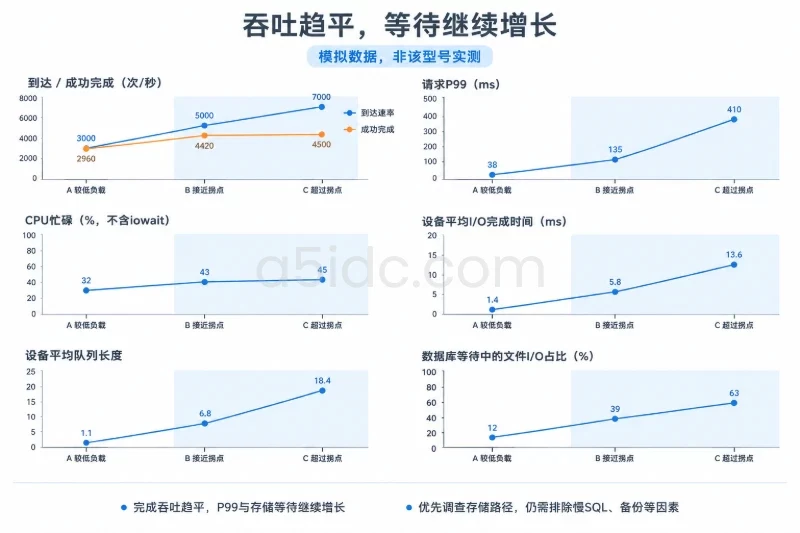
但这仍然只是一个因果候选:慢SQL造成大量扫描,也能把磁盘队列推高;后台备份或存储阵列异常,也可能产生相似曲线。接下来需要逐项排除。
CPU瓶颈有两种常见形态:整机计算资源逐渐耗尽,或者少数核心、线程已经饱和,而总利用率仍不高。
如果并发提高后,数据库进程CPU同步上升,多个核心持续繁忙,运行队列增长,吞吐接近平台,同时磁盘、网络和锁等待没有明显恶化,才比较符合计算瓶颈。
还应检查SQL层面的变化:
例如,业务吞吐不再增长,但数据库每秒执行次数继续上升,可能是超时重试造成了额外负载,并非服务器正常需求下已经耗尽算力。此时需要分别统计业务请求、SQL调用和重试次数。
在20个逻辑线程的统计口径下,一个逻辑CPU满载,对整机平均利用率的贡献约为5个百分点。因此,总CPU只有二三成,也可能存在执行热点。
需要观察每个逻辑CPU的利用率、数据库线程CPU,以及线程是否迁移。若某个查询执行线程持续消耗CPU,磁盘读写不多、锁等待也不突出,就应重点检查它的执行计划和计算量,而不是认为“整机空闲,数据库不可能慢”。
相反,单线程事务串行化、日志提交协调等问题,也可能表现为吞吐受限,但不一定属于纯计算瓶颈。必须结合数据库等待事件判断。
Linux环境可使用以下只读监控命令;mpstat和iostat由sysstat工具包提供,应先确认系统已安装:
# 在不同终端中覆盖同一段压测窗口
vmstat 1 60
mpstat -P ALL 1 60
iostat -xz -y 1 60
vmstat首行通常是启动以来的平均值,不应直接当作当前采样。运行队列变长也不是独立证据,需要与每核负载、上下文切换和数据库等待一起看。如果监控出现明显的steal时间,则还应检查宿主调度或虚拟化资源竞争。
CPU瓶颈的有效判断是“计算忙碌、可运行任务排队、吞吐停止增长”同时出现,而不是只看整机CPU百分比。
32GB DDR4是否足够,取决于活跃工作集,而不是数据库文件总大小。一个较大的数据库,如果频繁访问的数据与索引很集中,仍可能拥有较好的缓存表现;一个总量较小、但不断进行大范围扫描的数据库,也可能持续读盘。
在MySQL中,可以对同一窗口起止位置的状态计数器取差值。以下查询为只读操作,应使用具备相应权限的监控账号,避免不必要的高频采集:
SHOW GLOBAL STATUS
WHERE Variable_name IN (
  'Threads_running',
  'Threads_connected',
  'Innodb_buffer_pool_read_requests',
  'Innodb_buffer_pool_reads',
  'Innodb_data_reads',
  'Innodb_data_writes',
  'Innodb_log_waits',
  'Innodb_row_lock_waits',
  'Innodb_row_lock_time'
);
累计计数器要使用“窗口结束值减开始值”,再除以窗口秒数,不能直接比较两个运行时长不同的实例。Threads_running和Threads_connected则是瞬时值,需要连续采样;它们分别反映活跃线程与连接规模,不能相互替代。
例如,每秒发生10万次逻辑页读取,即使按相关计数器估算的命中率为99%,也意味着约1000次读取需要从缓冲池之外取得数据。实际块设备I/O还会受到预读、系统缓存、请求合并等因素影响,因此要继续与磁盘读取速率核对。
这就是为什么“命中率已经很高”不能单独排除内存容量问题:高访问量下,少量未命中仍可能形成明显读盘压力。
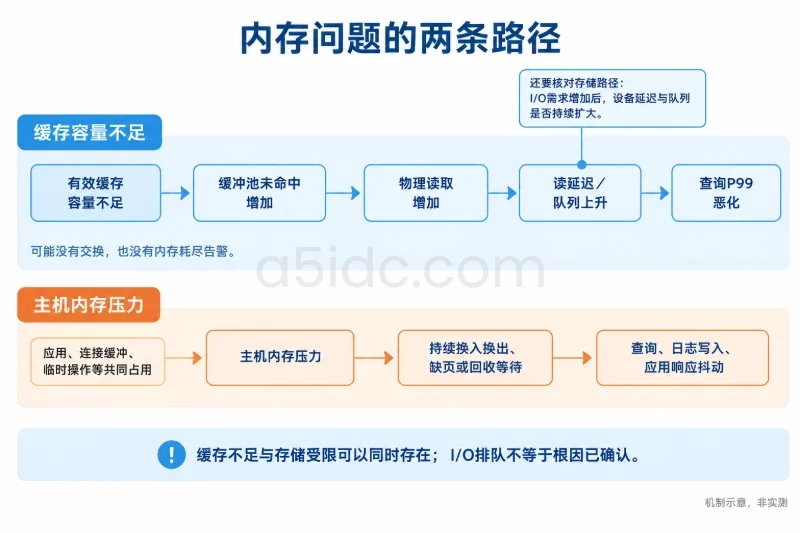
第一条是缓存容量不足。典型联动是缓冲池未命中增多、物理读取上升、磁盘读队列变长,最后查询P99恶化。主机不一定发生交换,也不一定出现内存耗尽告警。
第二条是主机内存压力。数据库之外的应用、连接缓冲、临时操作和其他进程共同消耗内存,导致持续换入换出、缺页或内存回收等待。这种情况下,查询、日志写入和应用响应都可能一起抖动。
判断时不要只看“空闲内存少”。Linux会利用空闲内存做缓存,更值得联动观察的是:
MemAvailable是否持续下降。对于32GB配置,缓冲池不应机械地占满主机。独立数据库、同机部署应用、连接较多等场景,需要不同的预算。例如18~22GiB可以作为某些同机部署场景的候选范围,但应以操作系统实际可用内存、应用峰值和压测结果确定,不能直接作为通用推荐值。
随机读取受限,通常表现为物理读取增加、读延迟和队列上升,查询等待集中在数据读取。此时,索引优化、缩小扫描范围、提高有效缓存容量,都可能减少I/O需求。
事务提交受限则不同:磁盘吞吐量看起来并不大,但同步写入与日志持久化延迟可能已经很高。小事务、高提交频率,以及多个写入流争用同一设备,都可能使提交成为主要等待点。
Innodb_log_waits增长可以提供日志缓冲相关压力的线索,但不能单独代表所有日志落盘问题,更不能反过来认为它不增长就没有提交瓶颈。应结合提交耗时、日志文件I/O等待、设备写延迟及队列判断。
还要注意三个容易误判的指标:
%util接近100%不一定代表支持并行处理的SSD或NVMe已经达到性能上限。iowait低不代表没有I/O瓶颈,其他可运行任务会改变它的表现。await是平均值,短时高延迟和少量慢写可能被平均掉。内存不足偏向“未命中驱动物理读取”,存储受限偏向“I/O需求增加后延迟与队列持续扩大”。两者可以同时存在,不能强行二选一。
当P99上升,但每核CPU、磁盘延迟和网络都没有相应变化,应进一步检查数据库内部的锁、热点与事务行为。
常见情况是多个并发事务修改同一条库存记录、计数记录或热点索引范围。数据库连接数增加了,但真正能够推进的事务数量没有明显增加,其他事务只是等待锁释放。
此时通常能观察到:
仅凭行锁累计计数还不够。MySQL 8.0可以结合Performance Schema中的语句、等待事件,以及当前数据锁等待关系查看阻塞链;相关采集项是否启用、监控权限是否具备,应先核验。行锁状态也不能覆盖元数据锁等所有锁类型。
一个低风险的对照方法,是在隔离测试数据中将更新目标由单一热点分散到多条独立记录,同时保持SQL类型和事务次数接近。如果吞吐明显恢复、锁等待下降,而CPU与磁盘仍有余量,锁热点就比硬件不足更符合现象。
没有合适索引的查询,会放大扫描和读盘;过大的排序,会同时消耗CPU、内存与临时文件I/O。因此,“磁盘排队”是直接表现,根因却可能是查询需求被放大。
应把SQL摘要中的执行次数、扫描行数、总耗时和单次延迟,与系统窗口对应起来。若某类SQL在负载提高后占据主要执行时间,优化它可能比更换硬件更有效。
执行计划分析应优先在隔离环境进行。MySQL的EXPLAIN ANALYZE会实际执行受支持的查询,不能把它当成完全不执行SQL的静态检查工具;对大型查询尤其需要控制影响范围。
应用连接池也是重要边界。如果数据库活跃线程并不多,应用却出现大量“等待获取连接”,需要进一步区分:是连接池限制了数据库利用,还是已有连接被慢SQL、锁等待或长事务占住。直接增大连接池可能把排队从应用转移到数据库,甚至使延迟更差。
香港服务器的压测必须明确客户端位置。数据库同机房测试回答的是服务器处理能力,面向实际访问地区的端到端测试回答的是业务体验,两者不能用一个延迟数字替代。
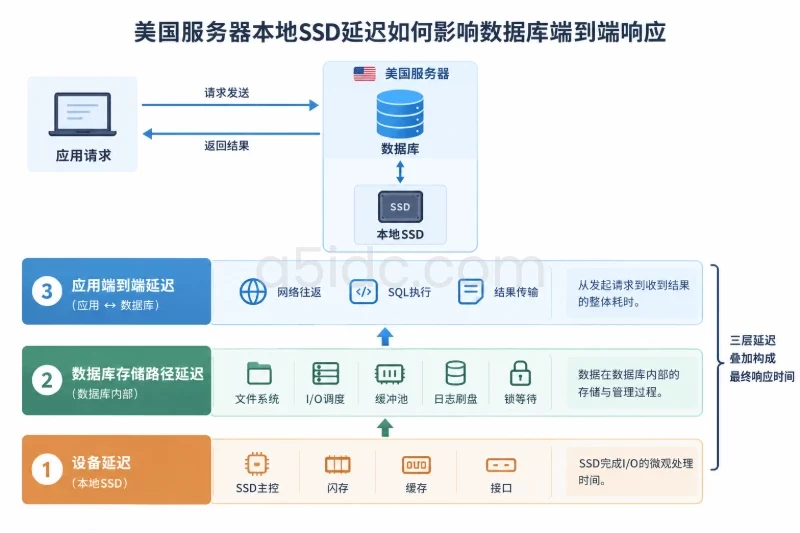
建议将链路拆成几个可观测阶段:应用排队、获取数据库连接、执行SQL、读取结果、返回客户端。数据库语句耗时与应用记录的SQL调用耗时也可能不同,后者可能包含网络传输、驱动处理和结果读取。
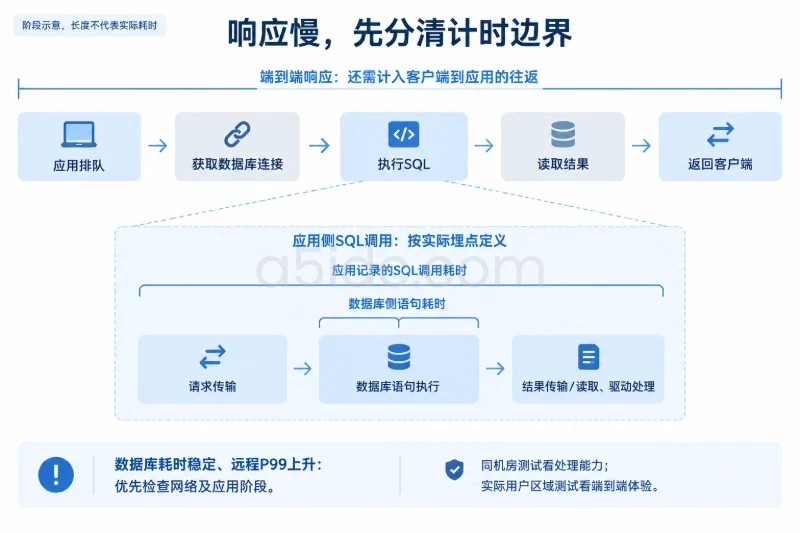
如果数据库语句耗时基本稳定,但远程P99明显上升,且出现TCP重传、连接建立变慢或网络队列增长,应优先检查网络路径。香港机房的位置本身并不能保证某个地区、运营商或时段的时延表现。
带宽需求还与结果集大小有关。按十进制单位计算,若每次返回约8kB,每秒返回5000次:
5000 × 8000字节 × 8 = 320000000比特/秒,即约320Mbps。
这只是响应载荷,不包含请求、协议头、加密和重传开销。若实际出口能力接近这一量级,即使数据库仍有余量,业务吞吐也可能受网络限制。Mbps与MB/s不能混用。
跨地域数据库访问还会放大多次往返的成本。一个业务请求依次发出多条SQL,即使每条SQL执行很快,累计等待也可能较长。应优先比较同机房应用访问与远程应用访问,而不是把跨地域往返直接计入数据库计算能力。
应用工作线程、事件循环、连接池和序列化处理,都可能限制最终吞吐。典型现象是应用CPU或内部队列上升,数据库CPU、活跃线程与SQL耗时却保持稳定。
队列数量还可以与平均响应时间交叉核对。在稳定状态、相同统计边界下,平均在途请求数约等于吞吐率乘以平均响应时间。例如每秒完成2000个请求、平均耗时40ms,平均在途请求约为80个。这里必须使用平均值,不能把P99代入。
若到达速率持续大于完成速率,队列还在增长,就不满足稳定状态条件。此时看到大量在途请求,只能说明积压,不能说明系统能够稳定承载这些并发。
这台10核20线程、32GB DDR4香港服务器的数据库瓶颈,应以“吞吐拐点、队列位置、等待类型”共同描述。以下组合可以作为可独立使用的判断表。
| 更可能的瓶颈 | 同一窗口内应看到的联动 | 需要排除的替代解释 | 优先复测方向 |
|---|---|---|---|
| CPU计算能力 | 多核或热点线程繁忙、运行队列增加、吞吐趋平 | 重试风暴、宿主调度争用、执行计划退化 | 优化高CPU查询,对比相同工作量 |
| 缓存容量 | 未命中增加、物理读取增加、读延迟与P99上升 | 大范围扫描、缓存预热不足 | 比较不同工作集,或合理调整缓存预算 |
| 存储与提交 | I/O延迟及队列增长,数据读取或提交等待增加 | 备份干扰、日志与数据争用、异常慢SQL | 减少单请求I/O,或对比存储路径 |
| 锁与热点 | 锁等待、阻塞链和长事务增加,硬件仍有余量 | 连接池排队、元数据锁 | 分散热点,缩短事务持锁时间 |
| 网络路径 | 远程延迟、重传或链路负载增加,数据库耗时稳定 | 压测端不足、应用处理变慢 | 比较同机房与实际用户区域 |
| 应用层 | 线程或连接池队列增长,数据库负载变化不大 | 数据库慢调用占住连接 | 分离连接等待、SQL执行和应用处理 |
复测不宜一次同时修改缓存、连接池、索引和持久化设置,否则性能改善也难以确定原因。更有效的流程是:
涉及索引、内存配置或事务参数的变更,应明确影响范围,保留原配置和可恢复备份,并准备相应恢复方法。尤其不要通过降低持久化保障来证明存储性能更好:如果测试确实改变了持久化语义,必须单独说明潜在的数据丢失边界,不能与原测试直接比较。
容量也不应只用峰值QPS表达。更有意义的是:在指定SQL组合、数据规模和客户端位置下,同时满足P99目标与错误率要求的持续吞吐。超过拐点后继续增加并发,往往只会增加排队,并不会获得等比例的有效处理能力。
下一次压测这台香港金牌5115服务器,建议至少同步保留四组指标:成功吞吐+P99+错误率;每核CPU+运行队列+数据库线程CPU;可用内存+缓存未命中+物理I/O;数据库等待+应用连接池队列+网络重传。 当这些指标处于同一时间窗口,才能区分是需要更多计算资源、更大的有效缓存、更低延迟的存储,还是应该先减少SQL工作量、事务争用与跨地域往返。
数据库并发能力不仅与计算资源有关,也受到内存、存储和访问链路影响。A5数据提供香港Xeon Gold与AMD EPYC物理服务器,配置涵盖较大内存、SSD或NVMe存储,并有CN2与国际带宽方案,可为数据库、业务后台和接口服务提供不同的硬件与网络资源组合。其香港存储系列也提供大容量硬盘配置,适用于数据库及相关文件的存储需求。