香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


香港GPU服务器用于AI推理时,Ubuntu Server与Windows Server并不存在脱离业务的固定优劣。若推理主线是vLLM、TensorRT-LLM、Triton Inference Server、容器化PyTorch或多GPU服务,Ubuntu Server通常更容易与主流CUDA软件栈对接;若现有系统依赖Windows Server、IIS、.NET、专有Windows SDK或已经验证过的ONNX Runtime CUDA方案,Windows Server也可以成立,但需要逐项核对GPU型号、驱动模式、框架版本和部署方式。
同一张NVIDIA GPU换用不同操作系统,并不会自动改变显存容量和硬件计算能力。最终差异主要来自驱动是否匹配、框架是否提供对应构建、容器与多GPU能力是否完整、推理服务能否稳定运行,以及企业团队是否具备相应的运维能力。香港机房位置更多影响访问延迟、数据传输、镜像和模型下载,而不是直接决定操作系统兼容性。
A5数据提供香港GPU物理服务器,配备A100 80GB、RTX 4090等显卡选项,并结合服务器CPU、内存与NVMe存储资源,为大语言模型API、图像处理和模型测试等业务提供推理承载基础。香港GPU产品提供CN2线路,可配合面向香港及跨区域用户的接口服务、数据传输与模型运行环境建设。
企业技术负责人在做系统选型时,建议先把AI推理需求拆成四层:模型运行时、GPU能力、服务承载方式和运维约束。只有明确这四层,Ubuntu Server与Windows Server的比较才有实际意义。
不同推理框架对操作系统的依赖差异很大。
这里要区分“框架能够安装”和“框架适合生产运行”。某个Python包可以在Windows中安装,不代表其所有CUDA扩展、多GPU功能、量化后端和监控组件都与Linux版本等价。
仅知道“有一张GPU”还不够。至少需要确认以下变量:
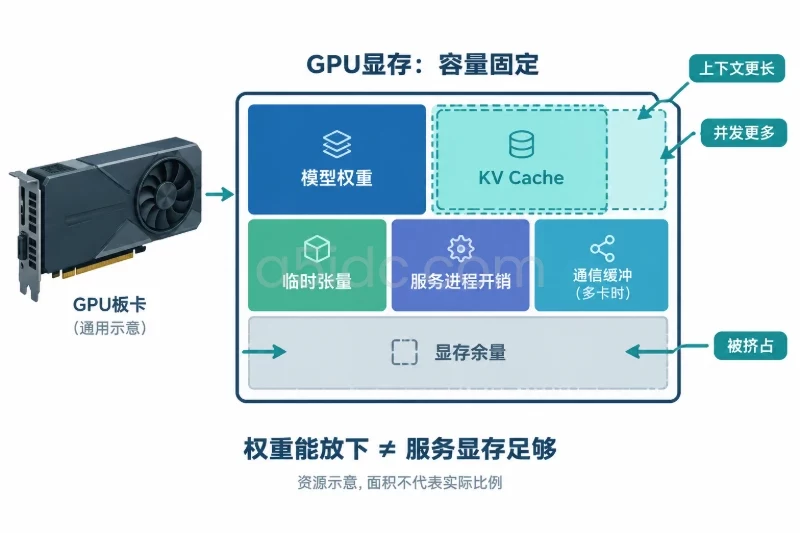
以大语言模型为例,量化后的权重只是显存需求的一部分。模型权重、KV Cache、临时张量、通信缓冲区和服务进程自身都要占用显存。上下文长度和并发数提高后,KV Cache可能成为新的主要消耗。不能只用“模型参数量乘以量化位数”得出最终显存结论。
以下两种项目对操作系统的要求不同:
| 服务形态 | 典型特点 | 对系统选型的影响 |
|---|---|---|
| 单进程推理程序 | 由Python、C++或.NET应用直接调用模型 | 更看重语言运行时、SDK和依赖包,Windows可行性相对更高 |
| 容器化模型服务 | 通过Docker、Kubernetes或统一镜像发布 | Linux生态和NVIDIA容器工具链通常更成熟 |
| 多模型推理平台 | 需要模型仓库、动态加载、版本管理和监控 | 应优先选择框架原生支持更完整的系统 |
| 大模型API服务 | 关注显存、KV Cache、并发、流式输出和多GPU | Ubuntu Server通常更容易与主流LLM推理栈结合 |
| Windows业务系统内嵌推理 | 应用与Windows服务、IIS或.NET紧密结合 | Windows可以减少跨系统通信和改造工作 |
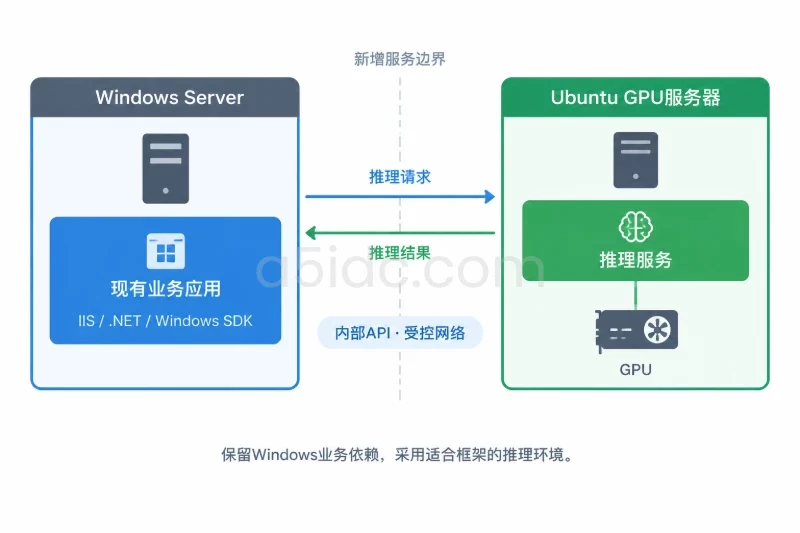
如果业务应用运行在Windows Server,但GPU推理框架更适合Ubuntu,可以采用“业务层与推理层分离”的方式。Windows承载应用接口,Ubuntu GPU服务器承载推理服务,两者通过企业内部API或受控网络通信。这样会增加一个服务边界,但可以避免为了迁就业务系统而牺牲推理框架的可用性。
下表以NVIDIA CUDA GPU为主要讨论对象。AMD、Intel或其他加速卡应重新核对对应厂商和框架的支持矩阵。
| 框架或运行时 | Ubuntu Server | Windows Server | 选择时的重点 |
|---|---|---|---|
| PyTorch CUDA | 生态较完整,容器和扩展包较常见 | 原生CUDA运行有可行路径,但依赖包需逐项确认 | Python、CUDA、显卡驱动和第三方扩展必须成套测试 |
| ONNX Runtime CUDA | 适合标准化模型推理 | 适合与Windows应用、.NET服务结合 | 检查CUDA Execution Provider是否实际启用 |
| TensorRT | 适合追求低延迟和固定模型部署 | 部分组件可用,但版本、插件和Python包需核对 | 不能只验证TensorRT能安装,还要验证模型转换和插件 |
| TensorRT-LLM | Linux生产部署路径更常见 | 原生Windows通常不作为默认生产路径 | 重点检查操作系统、GPU架构、CUDA和依赖版本 |
| vLLM | Linux环境更适合作为主流部署方案 | 原生Windows兼容范围和版本变化较快 | 需要确认目标版本是否支持所需功能,不要仅依赖社区补丁 |
| Triton Inference Server | Linux容器路径较成熟 | Windows原生部署需谨慎核验 | 检查模型后端、容器运行方式和监控组件 |
| llama.cpp CUDA | Windows和Linux均有使用场景 | 适合已有Windows工具链的轻量部署 | 检查编译选项、量化格式、CUDA后端和并发能力 |
表中的“可用”不等于“功能完全相同”。例如,PyTorch在Windows上能调用CUDA,并不代表所有Linux下常用的分布式训练、量化扩展、编译优化和服务编排工具都能直接迁移。
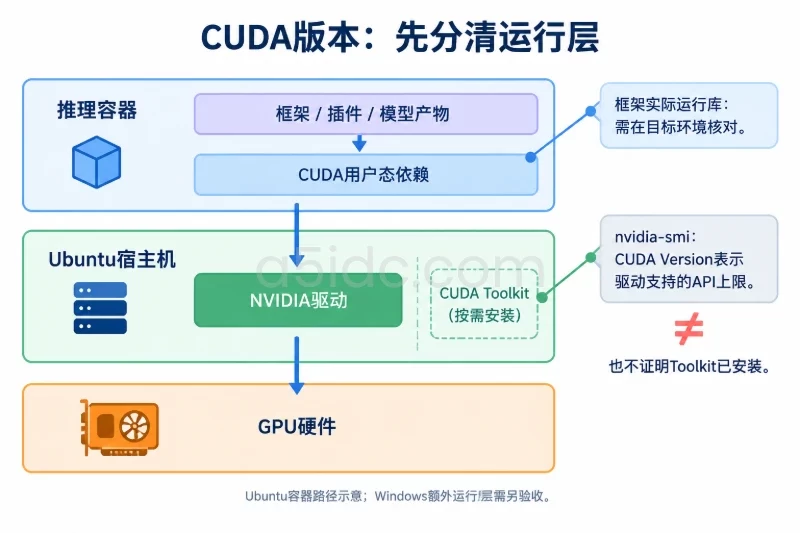
执行nvidia-smi时,输出中的“CUDA Version”通常反映当前驱动能够支持的CUDA API上限,不一定代表服务器中已经安装了对应版本的CUDA Toolkit,也不等于目标Python环境实际使用的CUDA运行库版本。
因此,兼容性至少要核对三层:
Ubuntu环境通常更容易通过容器固定CUDA用户态依赖,同时保留宿主机驱动。Windows环境也可以采用类似思路,但涉及Windows原生容器、Linux容器、WSL2或虚拟化GPU时,运行层次会增加,不能把Linux下的Docker命令和镜像直接照搬。
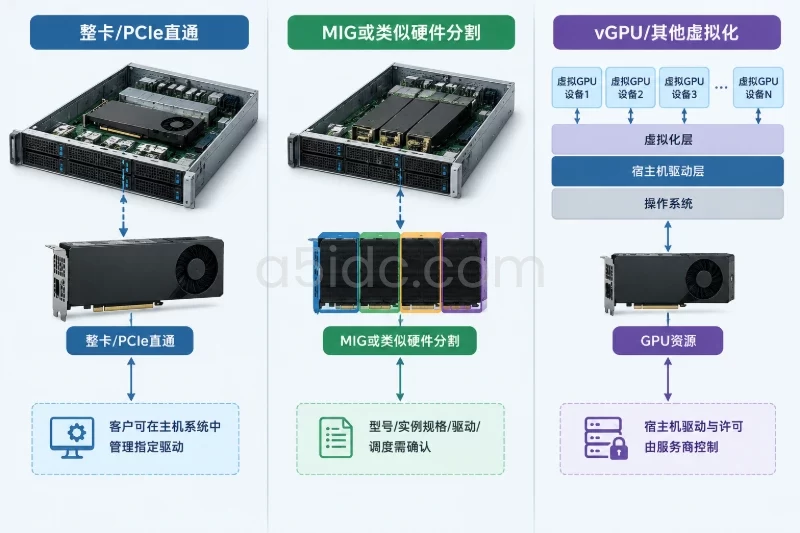
Windows Server下,GPU驱动模式、GPU型号和应用场景会影响计算能力。部分数据中心或专业GPU支持面向计算的驱动模式,但具体GPU、驱动版本和Windows版本是否支持,需要以对应矩阵为准。
尤其要注意以下情况:
如果应用需要MIG、vGPU、多GPU隔离或集群调度,建议优先从框架和虚拟化平台的支持矩阵反向确定操作系统,而不是先购买服务器再尝试适配。
GPU选型和系统选型需要同时考虑。Ubuntu并不会增加显存,Windows也不会减少GPU的物理显存;真正的区别在于目标推理框架能否调用这些资源。
例如,一个中等规模的量化大语言模型可能需要约7至9GB空间存放权重,但这不代表8GB显存就足够生产运行。实际还需要预留:
如果目标是低并发、短上下文的内部问答服务,单卡方案可能足够;如果要支持长上下文、流式输出和多用户并发,就需要把显存余量纳入验收,而不能只看模型是否成功加载。
下表假设两台服务器使用相同GPU型号、相同模型和相同精度,比较重点放在系统和软件栈,而不是硬件性能。
| 比较维度 | Ubuntu Server | Windows Server |
|---|---|---|
| CUDA与容器生态 | Linux容器、NVIDIA容器工具链和主流推理镜像更常见 | 原生Windows和Linux容器路径需要分别验证 |
| 大模型框架 | vLLM、TensorRT-LLM等更容易作为默认方案 | 需要确认原生支持或采用额外运行层 |
| PyTorch推理 | 适合Python、C++扩展和多GPU服务 | 单卡基础推理可行,但第三方依赖需逐项核验 |
| ONNX Runtime CUDA | 支持成熟,适合服务化 | 适合与.NET、IIS和Windows应用集成 |
| 多GPU与分布式 | 工具和文档路径通常更统一 | 驱动、运行时和框架组合的验证成本较高 |
| 显卡驱动管理 | 更适合无图形界面的服务器环境 | 需关注WDDM、TCC或具体计算模式 |
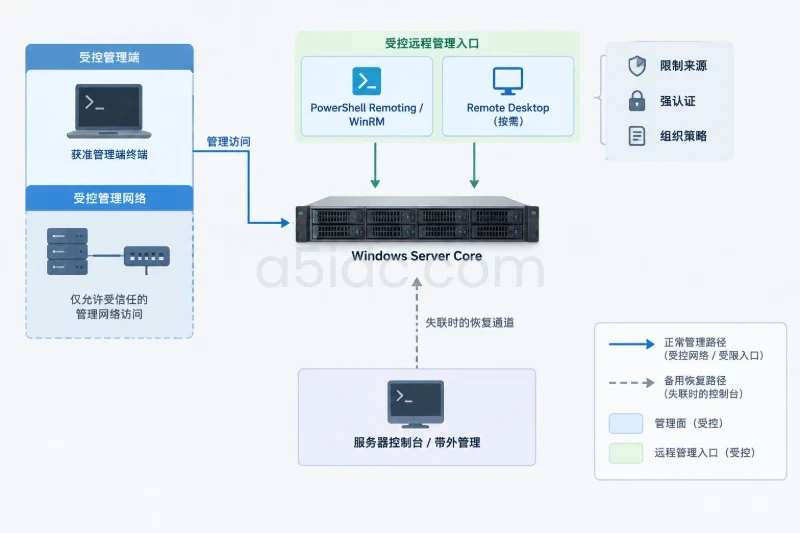
| 运维方式 | SSH、脚本、容器和自动化工具较自然 | RDP、PowerShell、Windows服务和企业域环境较自然 |
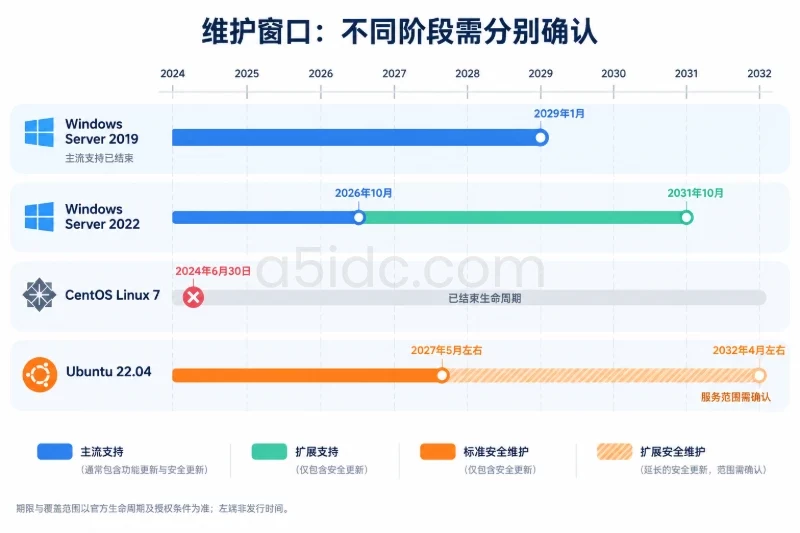
| 软件授权 | 系统本身通常不产生Windows许可费用 | 需要确认许可类型、计费方式和使用范围 |
| 团队门槛 | Linux命令行、权限和容器经验重要 | Windows服务、补丁和PowerShell经验重要 |
| 适合的默认场景 | LLM API、多模型服务、容器化部署 | Windows业务集成、ONNX推理、专有Windows软件 |
这里的“更常见”不代表另一方完全不可用。实际选择应以目标框架的具体版本和GPU型号为准。
Ubuntu Server更适合作为以下场景的默认候选:
Ubuntu的主要收益不是“系统更快”,而是推理软件生态通常更容易按照同一套方式部署。相同GPU、相同CUDA内核和相同模型配置下,操作系统本身不一定造成显著的计算差异。真正影响结果的,往往是是否使用了相同的精度、算子、编译优化、批处理和服务参数。
Ubuntu的成本也不能只看系统许可。需要纳入以下项目:
Windows Server在以下条件下可能更合适:
Windows Server需要重点确认:
如果选择Windows只是因为团队不熟悉Linux,但目标框架明确以Linux为主,那么后续迁移、补丁和兼容性维护可能抵消初期熟悉度带来的便利。
如果目标是提供聊天、文本生成、摘要、知识库问答或代码生成接口,通常会涉及:
这类场景更适合优先验证Ubuntu Server。尤其当目标框架包含vLLM、TensorRT-LLM或Linux容器时,先确认Ubuntu路径,通常比在Windows上寻找替代运行方式更直接。
Windows并非完全不能承担大模型推理,但如果需要通过WSL2、虚拟机或额外兼容层运行Linux组件,应把额外层的性能、GPU映射、升级方式和故障定位成本纳入评估。对于长期生产服务,不宜只依据“开发机能够启动”做决定。
如果业务已有Windows服务,模型已经固定导出为ONNX,推理入口由C#或C++调用,并且主要使用单GPU和稳定批处理,那么Windows Server可以作为合理候选。
验收时不要只检查模型能否加载,还要确认实际使用的是CUDA Execution Provider,而不是因为环境缺少CUDA依赖而退回CPU。对于图像分类、目标检测、OCR、部分语音模型等任务,ONNX Runtime的跨平台特性可能比大语言模型服务框架更重要。
如果后续计划切换到TensorRT,需要重新检查模型算子、动态输入、插件和精度校准流程。ONNX能够运行,不代表TensorRT一定能够无修改转换。
这种方案看似节省服务器数量,但需要注意资源争用:
如果推理服务是核心链路,建议至少将模型进程与普通业务进程分离,或者采用独立Ubuntu GPU服务器承载推理,Windows服务器通过内部接口调用。若必须合并部署,应为GPU显存、系统内存、磁盘和服务重启设置明确的资源上限与维护窗口。
香港GPU服务器的选择不能只看系统,还要确认访问来源与数据流向。
这些因素不会直接改变Ubuntu或Windows的框架兼容性,但会影响整体服务体验和运维成本。
“不宜作为默认方案”不等于完全不能实现,而是意味着需要为兼容性验证、额外运行层和故障排查预留时间与预算。
不要只根据订单名称验收。应在目标系统中确认GPU数量、型号、显存和驱动版本。
Ubuntu Server可在目标虚拟环境或宿主机执行:
nvidia-smi --query-gpu=name,driver_version,memory.total,pstate,temperature.gpu --format=csv
也可以查看设备枚举:
nvidia-smi -L
Windows Server可在PowerShell中执行:
nvidia-smi
如果输出的型号、显存数量或GPU卡数与交付信息不一致,应在部署模型前完成核对。对于虚拟化GPU,还要确认显示的是分配到的虚拟资源,而不是宿主机物理卡的总资源。
仅执行import torch不能证明PyTorch已经调用GPU。应在目标Python环境中进行设备检查。
Ubuntu示例:
python3 - <<'PY'
import torch

print("torch:", torch.__version__)
print("cuda_available:", torch.cuda.is_available())
print("torch_cuda:", torch.version.cuda)

if torch.cuda.is_available():
    print("device_count:", torch.cuda.device_count())
    print("device_name:", torch.cuda.get_device_name(0))
PY
Windows PowerShell示例:
python -c "import torch; print('torch:', torch.__version__); print('cuda_available:', torch.cuda.is_available()); print('torch_cuda:', torch.version.cuda); print('device_count:', torch.cuda.device_count() if torch.cuda.is_available() else 0)"
如果使用ONNX Runtime,还需要检查CUDA执行提供程序:
python3 -c "import onnxruntime as ort; print(ort.get_available_providers())"
输出中应出现目标CUDA执行提供程序。若只有CPU执行提供程序,不能把测试结果当成GPU推理结果。
Ubuntu容器化部署通常需要同时检查宿主机驱动、容器运行时、NVIDIA容器组件和镜像内CUDA依赖。示例命令如下,镜像标签应根据目标框架要求调整:
docker run --rm --gpus all nvidia/cuda:12.4.1-base-ubuntu22.04 nvidia-smi
这条命令只用于验证容器能否看到GPU,不代表目标推理框架已经兼容。后续仍要在实际模型镜像中验证Python包、插件、模型文件和服务启动参数。
Windows Server如果通过WSL2、虚拟机或其他方式运行Linux GPU容器,应单独验收GPU映射和容器访问,不要以Windows宿主机能够执行nvidia-smi为依据推断Linux容器也一定可用。
至少记录以下信息:
如果模型使用预编译TensorRT Engine或自定义CUDA扩展,还要确认它是否针对目标GPU架构构建。把在另一种GPU上生成的Engine直接复制到新服务器,可能出现加载失败、重新构建或性能不稳定的情况。
Ubuntu与Windows对比时,必须保证以下条件一致:
建议至少记录:
| 指标 | 说明 |
|---|---|
| 冷启动时间 | 进程启动、加载模型和首次可服务所需时间 |
| 首Token延迟 | 大语言模型从请求到输出首个Token的等待时间 |
| 单请求延迟 | 从接收请求到完成响应的时间 |
| P50、P95、P99 | 分别观察中位数和尾延迟 |
| 输出吞吐 | 以tokens/s表示时,需固定输入和输出Token数量 |
| 图像或音频吞吐 | 固定样本尺寸、批次和预处理方式 |
| 峰值显存 | 观察模型加载、预热和高并发阶段 |
| CPU与内存占用 | 判断系统是否成为新的瓶颈 |
| 错误率 | 包括超时、显存不足、模型加载失败和服务重启 |
| 长时间运行情况 | 观察数小时运行中的显存增长、进程退出和驱动异常 |
性能测试不应只跑一次请求。对于API服务,至少要分别测试单并发、目标并发和接近峰值并发;对于计算机视觉服务,应固定图片尺寸和批量大小;对于大语言模型,应固定提示词长度和输出Token上限。
Ubuntu与Windows的成本不能只比较系统安装费。
Ubuntu侧需要评估:
Windows侧需要评估:
如果GPU服务器长期运行,系统许可通常只是总成本的一部分,但当部署规模扩大到多台实例时,按实例或按授权方式产生的差异会逐渐明显。香港机房的带宽、出站流量、模型存储和备份费用也应单独核算,不能全部归入“操作系统成本”。
如果核心是vLLM、TensorRT-LLM、Triton或Linux优先的容器栈,先验证Ubuntu Server。若核心是ONNX Runtime CUDA、.NET和Windows SDK,再验证Windows Server。
检查驱动、CUDA运行时、显存、精度、计算能力、多GPU和虚拟化功能,不要只看GPU商品名称。
至少完成模型加载、GPU执行、目标并发、尾延迟、峰值显存和长时间运行测试。
把许可证、运维技能、框架升级、业务改造、镜像维护和香港机房网络成本放在同一张表中,而不是只比较操作系统价格。
Windows Server承载现有业务,Ubuntu GPU服务器承载推理服务,通过明确的内部API连接,通常比在单台Windows服务器中强行运行Linux优先框架更容易维护。
测试环境如果使用Ubuntu,生产就不宜临时换成Windows;测试环境如果使用Windows,也不应在上线前才改成Ubuntu。操作系统、驱动、CUDA、框架和模型版本应尽量保持一致。
因此,面向主流大模型推理、容器化部署和多GPU扩展时,可以把Ubuntu Server作为优先验证路径;面向Windows应用集成、ONNX Runtime CUDA和固定单卡推理时,Windows Server可以作为同层级候选。最终决定应由框架支持范围、GPU兼容矩阵、团队运维能力和香港机房的实际网络与数据要求共同确定。