香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


目标状态是:香港物理服务器由操作系统稳定识别各块数据盘,按业务需求组成 RAID 阵列;阵列、文件系统和挂载配置在重启后仍可正常恢复;上线前完成状态检查,并明确故障盘更换和数据恢复流程。以下以 Ubuntu Server 22.04/24.04 LTS、mdadm 软件 RAID 和独立数据盘为例,系统盘不纳入操作范围。
实施前需要确认服务器的磁盘数量、容量、接口类型和控制器模式,并准备可用的带外管理方式或远程控制台。RAID 创建及文件系统格式化会覆盖目标磁盘上的数据,操作前必须核实磁盘身份并完成备份。RAID 提高的是磁盘故障下的可用性,不替代异地备份。
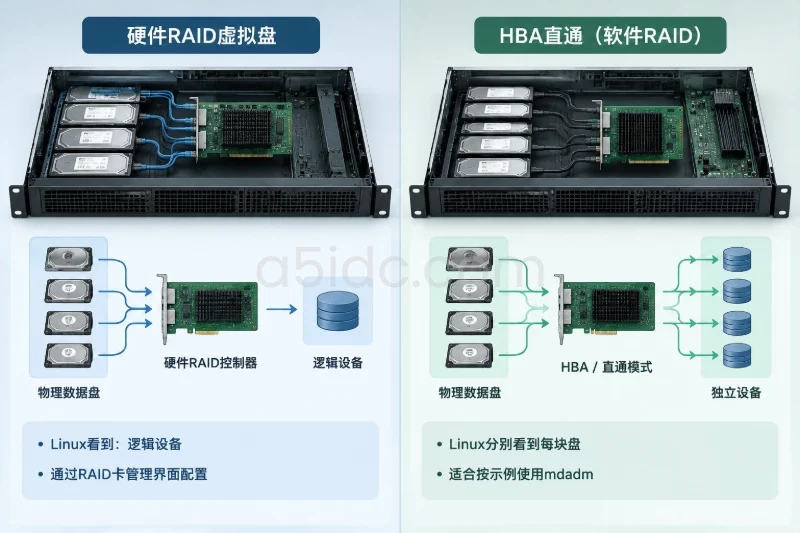
先确认服务器当前使用硬件 RAID 还是操作系统软件 RAID。若 RAID 卡已将多块物理盘组成虚拟盘,Linux 通常只会看到一个或少数逻辑设备,此时应通过 RAID 卡管理界面配置阵列,不要再把逻辑盘和底层成员盘混合组成 mdadm 阵列。若操作系统能分别看到每块盘,且控制器处于直通或 HBA 模式,才适合按本文示例使用软件 RAID。
在 Ubuntu 上检查磁盘、文件系统和挂载关系:
lsblk -o NAME,PATH,SIZE,TYPE,FSTYPE,MOUNTPOINTS,MODEL,SERIAL
sudo fdisk -l
findmnt
cat /proc/mdstat
需要重点确认:
/dev/sdX 设备名可能因启动顺序变化而改变。执行破坏性操作前,建议使用持久化设备路径核对型号和序列号:
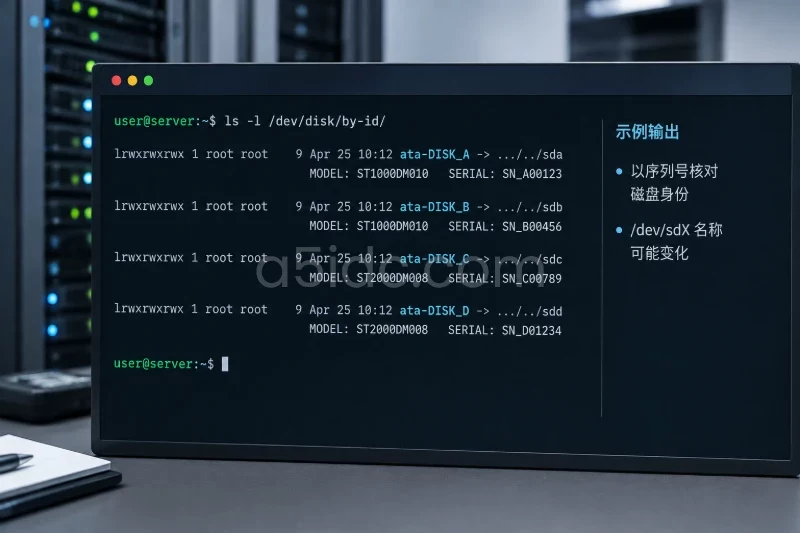
ls -l /dev/disk/by-id/
下文用 /dev/disk/by-id/ata-DISK_A 等名称表示示例磁盘。它们是占位符,必须替换成服务器上实际存在、且已核对序列号的路径,不能原样复制执行。
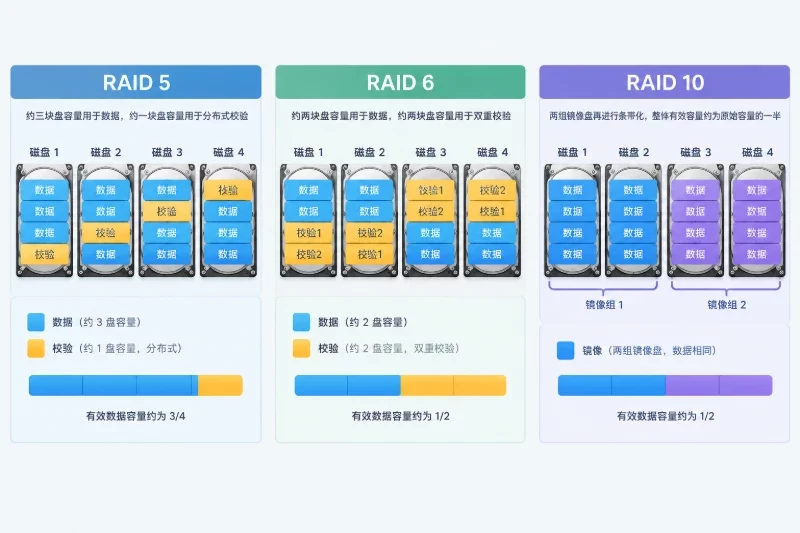
| 级别 | 最少磁盘数 | 可用容量参考 | 可容忍故障 | 适用情形与边界 |
|---|---|---|---|---|
| RAID 0 | 2 | 所有磁盘容量之和 | 0 块 | 需要合并容量或条带性能,任一成员盘故障都可能使整个阵列数据不可用 |
| RAID 1 | 2 | 约等于最小成员盘容量 | 通常可容忍 1 块 | 两盘镜像,容量利用率较低,但结构简单 |
| RAID 5 | 3 | 约为(磁盘数-1)×最小盘容量 | 1 块 | 有校验盘开销;重建期间再次发生读错误或盘故障会增加数据风险 |
| RAID 6 | 4 | 约为(磁盘数-2)×最小盘容量 | 2 块 | 比 RAID 5 多一份校验,适合更重视双盘容错的场景 |
| RAID 10 | 通常为 4,且为偶数 | 约为磁盘总容量的一半 | 每个镜像组可容忍 1 块;不同组合结果不同 | 镜像加条带,重建通常只需读取对应镜像成员,但可用容量约为一半 |
表中容量按成员盘容量一致估算,不含文件系统和元数据开销。RAID 10 并不意味着任意两块盘故障都可容忍:如果两块故障盘恰好属于同一镜像组,该组数据仍可能丢失。选择时还应结合控制器能力、盘型、业务写入模式和备份策略。
围绕香港物理服务器的阵列存储需求,A5数据提供配备四块14TB企业级机械硬盘与H730控制器的香港存储服务器,为多盘阵列部署、大容量文件存储及备份归档提供硬件基础。香港产品线还涵盖搭载SSD或NVMe的Xeon Gold、AMD EPYC平台,并有CN2与国际带宽方案,承接数据库、业务后台等场景的计算、存储与网络资源需求。
更新软件源并安装 mdadm。如需查看 SATA/SAS 磁盘健康信息,可另外安装 smartmontools;NVMe 设备可安装 nvme-cli。
sudo apt update
sudo apt install -y mdadm
sudo apt install -y smartmontools
本示例上线目标是:4 块独立数据盘组成 RAID 10,创建 ext4 文件系统,挂载到 /data,并将阵列配置纳入开机恢复流程。若系统盘也需要 RAID,应优先在操作系统安装阶段配置,或使用经验证的硬件 RAID 方案;不建议在已经运行的系统上照搬数据盘步骤改造根分区。
在创建阵列前,逐个将持久化路径映射到实际设备,并查看序列号、容量和挂载情况:
sudo lsblk -o NAME,PATH,SIZE,TYPE,FSTYPE,MOUNTPOINTS,MODEL,SERIAL
sudo udevadm info --query=property --name=/dev/disk/by-id/ata-DISK_A
如果磁盘已有分区、文件系统签名或阵列元数据,不要直接继续。先确认数据是否需要保留、设备是否属于其他阵列,再按已批准的变更方案处理。对身份不确定的设备,停止操作,不以“看起来容量一样”作为判断依据。
确认四块目标盘均为独立数据盘后,创建 RAID 10。以下命令会在指定磁盘上写入阵列元数据,并使其原有数据无法按原方式访问:
sudo mdadm --create /dev/md/data \
  --name=data \
  --level=10 \
  --raid-devices=4 \
  /dev/disk/by-id/ata-DISK_A \
  /dev/disk/by-id/ata-DISK_B \
  /dev/disk/by-id/ata-DISK_C \
  /dev/disk/by-id/ata-DISK_D
如果系统提示目标设备已有元数据,先停止并再次核验盘的身份和用途,不要为绕过提示直接清除元数据。阵列创建后检查同步状态:
cat /proc/mdstat
sudo mdadm --detail /dev/md/data
初次同步可能需要较长时间,取决于磁盘容量、接口和系统负载。可以在同步期间继续进行其他低风险准备,但不要在阵列状态异常或磁盘正在报错时进入格式化步骤。不同 RAID 级别应修改 --level 和成员盘数量:RAID 1 使用两块盘;RAID 5 至少三块;RAID 6 至少四块;RAID 0 至少两块且没有冗余。不要为了提高可用容量把 RAID 0 用作唯一数据副本。
确认阵列设备 /dev/md/data 存在、状态正常且没有错误后,再创建文件系统。格式化会覆盖阵列设备上的现有文件系统和数据,以下命令只适用于刚创建、尚未存放业务数据的阵列:
sudo mkfs.ext4 -L data /dev/md/data
sudo mkdir -p /data
sudo blkid /dev/md/data
使用文件系统 UUID 写入 /etc/fstab,避免依赖可能变化的设备名。先备份现有配置,再编辑文件:
sudo cp -a /etc/fstab /etc/fstab.bak.$(date +%F-%H%M%S)
sudo nano /etc/fstab
新增一行,UUID 替换为上一条 blkid 命令显示的实际值:
UUID=替换为实际文件系统UUID /data ext4 defaults,nofail 0 2
nofail 可减少数据盘未就绪时对启动流程的影响,但不能替代阵列恢复检查。保存后先验证配置,不要立即重启:
sudo findmnt --verify
sudo mount -a
findmnt /data
df -hT /data
若 mount -a 报错,先修正配置并重新验证;不要在挂载失败时继续上线业务。
记录阵列 UUID 和当前配置:
sudo mdadm --detail --scan
sudo mdadm --detail /dev/md/data
检查 /etc/mdadm/mdadm.conf 是否已有对应阵列配置。若没有,将 mdadm --detail --scan 输出中与 /dev/md/data 对应的 ARRAY 行合并到配置文件;不要重复添加相同阵列条目。修改前备份文件:
sudo cp -a /etc/mdadm/mdadm.conf /etc/mdadm/mdadm.conf.bak.$(date +%F-%H%M%S)
sudo nano /etc/mdadm/mdadm.conf
数据盘阵列配置完成后更新 initramfs,使启动环境能够读取当前阵列配置:
sudo update-initramfs -u -k all
根文件系统所在阵列的启动配置更敏感,必须按发行版安装器、控制器和启动模式单独验证,不能仅凭数据盘阵列可挂载就认定根阵列能够启动。
在阵列同步完成或达到变更计划要求后,检查阵列、成员盘、挂载点和内核日志:
cat /proc/mdstat
sudo mdadm --detail /dev/md/data
sudo lsblk -o NAME,SIZE,TYPE,FSTYPE,MOUNTPOINTS
findmnt /data
df -hT /data
sudo dmesg -T | tail -n 100
正常情况下,mdadm --detail 应显示阵列级别、成员数量和状态;/proc/mdstat 应显示阵列已启动,成员状态符合预期。若仍处于同步或恢复状态,不能仅凭文件系统已经挂载就认为阵列验收完成。
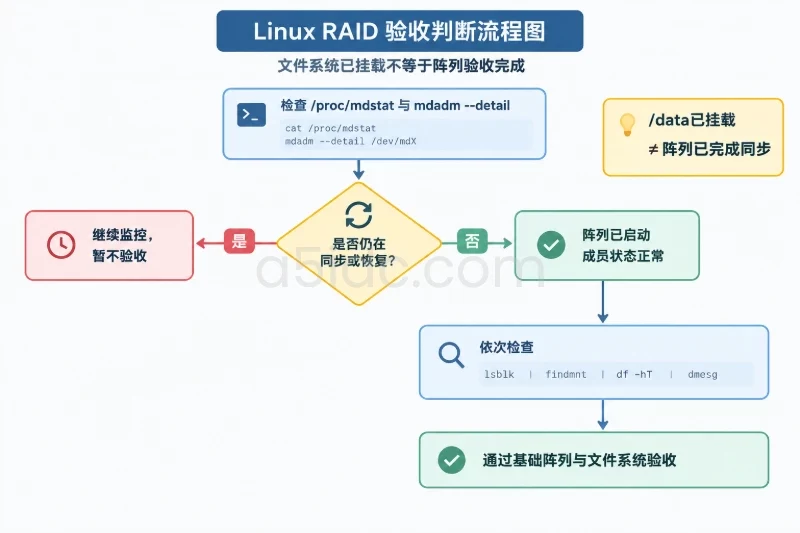
可以进行小规模写入和读取验证。以下测试会在 /data 创建临时文件,确认空间充足且目录不与业务路径冲突后执行:
sudo dd if=/dev/zero of=/data/.raid-write-test bs=1M count=64 conv=fsync
sudo sha256sum /data/.raid-write-test
sudo rm -f /data/.raid-write-test
该测试只用于验证基本读写链路,不等同于完整性能测试,也不证明阵列能在磁盘故障时正确重建。正式业务上线前,应由应用侧完成目录权限、数据读写和服务重启后的挂载检查。
计划重启前确认业务已停机或处于允许维护的状态,且有带外控制台和回退通道。重启后再次检查:
cat /proc/mdstat
sudo mdadm --detail /dev/md/data
findmnt /data
df -hT /data
阵列应自动组装,/data 应按 fstab 挂载,文件系统和阵列状态无降级或错误。若设备名发生变化但 UUID 挂载正常,应继续以持久化路径和序列号核对成员盘,避免按旧的 /dev/sdX 名称做判断。
重建验证会让阵列进入降级状态并产生额外 I/O。不要为了测试而在生产环境中随意拔盘、标记健康盘故障或执行成员删除。需要演练时,应使用测试服务器、空阵列或经过批准的维护窗口,并提前确认备份可恢复、替换盘可用、带外管理有效。
真实故障更换完成后,重点验证成员状态回到正常、同步进度结束、系统日志没有持续的 I/O 错误,并检查业务数据和备份任务。仅看到 recovery 进度开始,并不代表重建已经完成。
先查看目标盘是否挂载、是否属于其他阵列,检查 lsblk、findmnt 和 /proc/mdstat。若设备上有未识别数据、分区或阵列签名,先查明来源;不要直接清除签名后重试。设备路径指向错误时,停止操作并重新核对序列号。
执行以下命令收集状态和内核日志:
cat /proc/mdstat
sudo mdadm --detail /dev/md/data
sudo dmesg -T | grep -iE 'error|failed|I/O|reset'
先判断是成员盘掉线、链路不稳定、控制器故障,还是阵列仍在正常同步。检查硬盘健康信息、背板和线缆,同时确认是否存在第二块故障盘。RAID 5 降级时,不应在原因未查明前继续高负载写入;RAID 6 或 RAID 10 也要依据具体故障成员位置判断剩余容错能力。若出现多盘异常或文件系统错误,优先停止写入、保全现状并从备份恢复,不要反复尝试组装或修复。
先执行 sudo findmnt --verify,检查 UUID 是否抄错、fstab 文件系统类型是否与实际一致,以及阵列是否已成功组装。可查看启动日志:
sudo journalctl -b -p warning
sudo journalctl -b | grep -iE 'mdadm|mount|data'
若配置错误导致启动进入维护模式,通过控制台修正 /etc/fstab,或使用恢复环境恢复事先备份的配置。不要为了绕过启动问题而删除阵列元数据或格式化文件系统。
先确认替换盘容量不小于原成员盘,接口和设备状态正常,且替换盘不是系统盘或其他阵列成员。查看阵列详细信息与新盘序列号后再执行加入操作。若新盘已有分区或阵列元数据,先确认其数据可丢弃,再按维护方案清理;不要把未核验的设备直接作为成员盘加入。
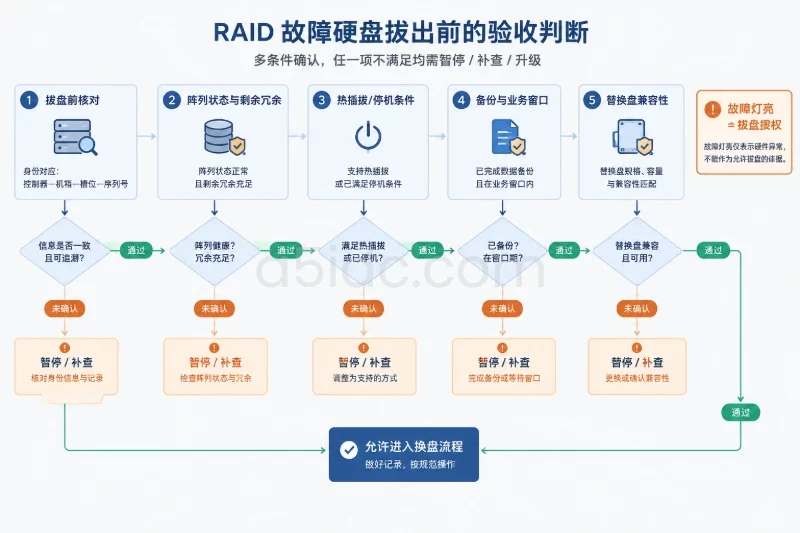
发现成员盘故障时,先记录阵列状态、故障设备序列号和系统日志,并确认备份可用。需要更换物理盘时,遵循服务器厂商的热插拔条件和机箱槽位标识;不支持热插拔的设备应按维护流程关机。不要单凭 Linux 设备名判断物理槽位。
更换盘接入后,以持久化路径确认新盘身份,再按实际阵列成员路径操作。以下示例只表示加入新盘的动作,必须将设备名替换为对应阵列可接受的实际成员设备;加入操作会使新盘数据被阵列重建内容覆盖:
sudo mdadm --add /dev/md/data /dev/disk/by-id/ata-REPLACEMENT_DISK
cat /proc/mdstat
sudo mdadm --detail /dev/md/data
如果故障盘仍被阵列识别为成员,先由管理员依据当前阵列状态执行故障标记和移除流程;不要直接照抄命令对健康成员操作。重建期间避免不必要的磁盘维护、重启和高强度 I/O,并持续检查内核错误、磁盘健康和同步进度。重建结束后,再核验阵列状态、文件系统挂载、业务读写和备份任务。
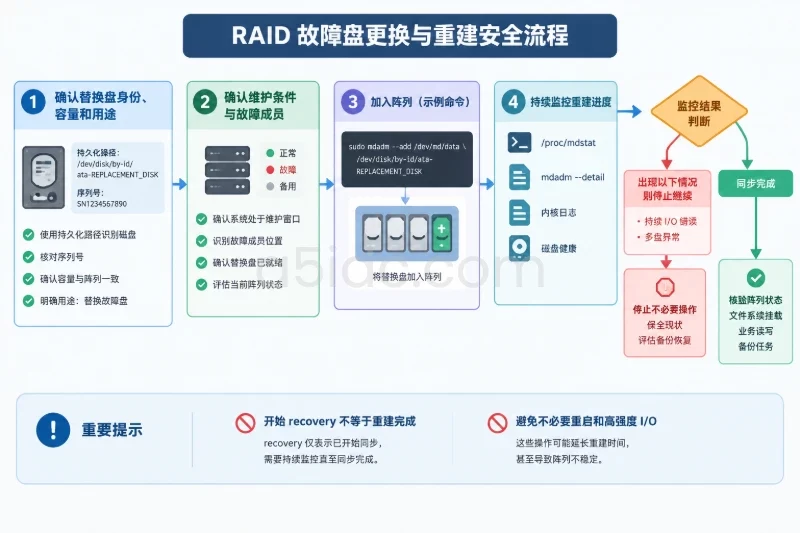
回滚方式取决于操作阶段:
阵列级别之间不能简单视为可无损互换。改变 RAID 级别、磁盘数量或文件系统布局前,应按容量规划重新设计,并以备份恢复作为可验证的回退路径。
mdadm --detail 和 /proc/mdstat 状态正常。fstab,findmnt --verify 与 mount -a 通过。mdadm 开机组装配置已核验,initramfs 已更新。/data 可自动挂载。