

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


很多 Ceph 部署失败,并不是因为命令写错,而是节点之间“看起来能通信”,实际却存在主机名不一致、私网未打通、磁盘混用、时间漂移或端口未放行等问题。对香港服务器 Ubuntu 系统实施 Ceph 分布式存储多节点部署方案时,部署前至少要确认五类条件:节点身份与系统版本、部署权限与软件源、管理网络与存储网络、OSD 磁盘布局,以及故障域和容量余量。
建议先不要急着初始化集群。应先完成节点清单、网络连通性、磁盘健康度和权限验证,再进行 Ceph 引导。下面的示例使用 3 个节点、3 个 MON、每台服务器配置独立 OSD 磁盘的场景,IP 地址和网卡名称均为示例,需要替换为实际环境。
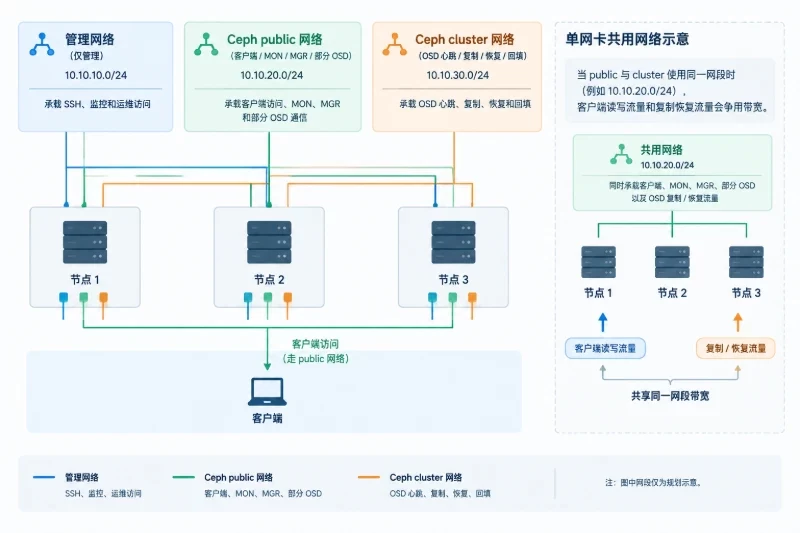
public_network 不等于公网Ceph 中的 public_network 是客户端访问网络,也承载 MON、MGR、OSD 的一部分通信,不代表必须使用互联网公网地址。
常见网络划分如下:
| 网络用途 | 示例网段 | 主要流量 | 是否建议与公网隔离 |
|---|---|---|---|
| 管理网络 | 10.10.10.0/24 | SSH、监控、运维访问 | 是 |
| Ceph public 网络 | 10.10.20.0/24 | 客户端访问、MON、MGR、部分 OSD 通信 | 是 |
| Ceph cluster 网络 | 10.10.30.0/24 | OSD 心跳、复制、恢复、回填 | 是 |
如果香港服务器只有一张网卡,也可以让 public_network 和 cluster_network 共用同一网段,但复制和恢复流量会与客户端读写争用带宽。对于写入量较高、恢复时间要求较严格的环境,最好使用独立私网或独立 VLAN。
在云服务器环境中,不要仅凭公网 IP 之间可以互相 ping 就判断网络满足 Ceph 要求。需要确认:
Ceph 的数据可靠性由 MON 仲裁、OSD 副本和 CRUSH 故障域共同决定。
生产环境通常至少准备:
host,避免同一主机上的多个副本被当作独立故障域;两台服务器也可以构建测试集群,但无法同时获得理想的仲裁冗余和主机级副本保护。若副本数为 3,至少需要 3 个可用的主机故障域;若只有 2 台主机,强行使用副本数 3 通常不符合预期。
还要区分 Ceph 的副本和备份。副本主要解决磁盘、OSD 或主机故障下的在线可用性,不能替代异地备份、历史版本和误删除恢复。
每台服务器都应有唯一、稳定的主机名。集群初始化后再修改主机名,可能导致编排、证书、SSH 主机记录或监控关系出现问题,因此应在部署前完成。
在每个节点执行:
hostnamectl
hostname -f
ip -br addr
ip route
getent hosts node-a node-b node-c
如果使用内部 DNS,应确保正向解析稳定;如果没有可用 DNS,可以在所有节点维护一致的 /etc/hosts。示例:
10.10.20.11 node-a
10.10.20.12 node-b
10.10.20.13 node-c
写入前先备份文件:
sudo cp -a /etc/hosts /etc/hosts.bak.$(date +%F-%H%M%S)
然后验证:
for host in node-a node-b node-c; do
    getent hosts "$host"
done
验证结果应满足:
hostname -f 不返回错误或临时云主机名;Ceph 版本与 Ubuntu 版本存在兼容关系,不要在不同发行版或不同大版本上直接混装。先记录系统信息:
cat /etc/os-release
uname -a
dpkg --print-architecture
systemctl is-system-running
然后确认时间同步:
timedatectl status
timedatectl show -p NTPSynchronized --value
如果使用 Chrony,还可以执行:
chronyc tracking
chronyc sources -v
MON 选举、证书校验、日志排序和故障判断都依赖相对准确的时间。若某节点时间持续偏移,应先处理 NTP 或 Chrony 配置,不要把时间同步问题留到集群初始化之后。
还应检查内存、磁盘空间、交换分区和系统负载:
free -h
df -hT
swapon --show
uptime
Ceph MON、MGR、OSD 和容器运行时都会占用内存。不要只按照数据盘容量采购服务器,还要为系统、守护进程、缓存和恢复任务保留内存余量。
Ceph 可以通过发行版软件包、cephadm 编排或其他自动化方式部署。实施前必须先冻结以下变量:
在使用 cephadm 时,检查工具和容器运行时:
command -v cephadm
cephadm version

podman --version 2>/dev/null || true
docker --version 2>/dev/null || true
检查 APT 软件源和候选版本:
apt-cache policy cephadm ceph-common
这里不应把不同大版本的软件包混在一起安装。若某个节点可以更新,另一个节点无法访问软件源,部署前应先解决软件源、DNS、出口防火墙或内部镜像问题。
cephadm 通常需要从引导节点通过 SSH 管理其他节点。部署账号应满足目标部署方式要求,例如使用 root,或使用具备无密码 sudo 权限的专用账号。
检查本机 sudo 是否能够非交互执行:
sudo -n true
echo $?
从引导节点测试到其他节点:
ssh -o BatchMode=yes -o ConnectTimeout=5 deploy@node-b 'sudo -n true'
ssh -o BatchMode=yes -o ConnectTimeout=5 deploy@node-c 'sudo -n true'
返回值为 0 才表示 SSH 和 sudo 基本满足自动化要求。若命令提示输入密码,自动化部署通常会在中途失败。
建议使用专用部署账号和专用 SSH 密钥,不要为了省事把所有服务器永久开放密码登录或把 SSH 暴露给任意来源。修改 SSH 配置前应保留当前会话,并准备云控制台或带外登录方式,避免新配置导致远程失联。
查看网卡、地址和路由:
ip -br link
ip -br addr
ip route
重点确认:
如果需要调整 Ubuntu Netplan,先备份原配置:
sudo cp -a /etc/netplan /etc/netplan.bak.$(date +%F-%H%M%S)
一个双网卡的概念示例:
network:
  version: 2
  ethernets:
    ens3:
      addresses:
        - 10.10.10.11/24
      routes:
        - to: default
          via: 10.10.10.1
      nameservers:
        addresses:
          - 10.10.10.1
    ens4:
      addresses:
        - 10.10.30.11/24
ens3、ens4、网关和地址只是示例。云服务器的网卡名、网关和路由由实际网络环境决定,不能直接复制到生产主机。
远程修改网络时,优先使用:
sudo netplan try
确认新配置后再正式应用。若未在规定时间内确认,Netplan 通常会自动回退。不要在没有控制台、备用 SSH 会话或带外访问的情况下直接覆盖远程服务器的唯一网络配置。
从每个节点向其他节点测试 Ceph public 和 cluster 地址:
ping -c 20 -I 10.10.20.11 10.10.20.12
ping -c 20 -I 10.10.20.11 10.10.20.13
如果测试 cluster 网络:
ping -c 20 -I 10.10.30.11 10.10.30.12
ping -c 20 -I 10.10.30.11 10.10.30.13
测试结果主要看三点:
延迟没有一个适用于所有业务的固定合格值。小规模同一私网测试中,若出现持续丢包、周期性超时或明显抖动,应先处理网络;即使平均延迟不高,恢复和回填期间的尾延迟也可能影响客户端写入。
使用 tracepath 检查路径和 MTU:
tracepath -n 10.10.30.12
tracepath -n 10.10.30.13
常规 MTU 为 1500 时,可以进行不分片测试:
ping -M do -s 1472 -c 4 10.10.30.12
IPv4 报文的 1472 字节数据加上 20 字节 IP 头和 8 字节 ICMP 头,正好对应 1500 字节 MTU。若环境计划使用 Jumbo Frame,则必须保证云网络、虚拟交换、网卡和所有中间设备的 MTU 一致。只修改服务器本地 MTU,而不修改路径上的其他部分,容易造成大包丢失或连接异常。
在一台节点的 cluster 地址监听:
iperf3 -s -B 10.10.30.11
在另一台节点发起测试:
iperf3 -c 10.10.30.11 -B 10.10.30.12 -P 4 -t 30
iperf3 -c 10.10.30.11 -B 10.10.30.12 -P 4 -t 30 -R
建议对 node-a、node-b、node-c 做两两测试,并分别验证正向和反向流量。-P 4 用于观察多连接时的吞吐,不代表 Ceph 的最终性能。
测试时不要只看带宽数字,还要记录:
如果只有公网网络可用,不建议直接把 MON、OSD 和复制流量暴露在公网地址上。公网地址应尽量只用于管理或受控的客户端访问,节点间复制优先使用隔离的私网。
常见端口用途如下:
| 端口或范围 | 用途 | 建议允许的来源 |
|---|---|---|
| TCP 22 | SSH 管理 | 管理网或指定运维地址 |
| TCP 3300 | MON v2 | Ceph 节点及受控客户端 |
| TCP 6789 | MON v1,是否启用取决于配置 | Ceph 节点及受控客户端 |
| TCP 6800 起的连续范围 | OSD、MGR、MDS 等守护进程 | Ceph 私网及必要客户端 |
OSD 动态端口范围可能因 Ceph 版本和配置而变化。不要把表中的示例范围直接开放到公网,应以目标版本和实际配置为准。集群建立后可检查相关配置:
ceph config get osd ms_bind_port_min
ceph config get osd ms_bind_port_max
如果使用 UFW,先查看现状:
sudo ufw status verbose
sudo ss -lntp
修改防火墙前备份规则,并确认已通过控制台或备用会话保留回滚通道:
sudo cp -a /etc/ufw /etc/ufw.bak.$(date +%F-%H%M%S)
放行规则应限制到 Ceph 私网 CIDR,而不是使用 0.0.0.0/0。如果防火墙策略较复杂,也应同步检查云平台安全组和 ACL,因为本机放行并不能绕过云平台的上游拦截。
在每台节点执行:
lsblk -e7 -o NAME,MODEL,SERIAL,SIZE,TYPE,FSTYPE,MOUNTPOINTS
findmnt
sudo blkid
建议形成类似下面的磁盘清单:
| 节点 | 系统盘 | OSD 数据盘 | DB/WAL 盘 | 当前用途 |
|---|---|---|---|---|
| node-a | /dev/vda | /dev/sdb、/dev/sdc、/dev/sdd | /dev/nvme0n1 | 空闲 |
| node-b | /dev/vda | /dev/sdb、/dev/sdc、/dev/sdd | /dev/nvme0n1 | 空闲 |
| node-c | /dev/vda | /dev/sdb、/dev/sdc、/dev/sdd | /dev/nvme0n1 | 空闲 |
不要根据设备名猜测磁盘身份。云环境中设备名可能因重启、挂载方式或控制器变化而改变,应结合序列号、容量、模型和云平台磁盘 ID 核对。
对于 BlueStore,常见规划是:
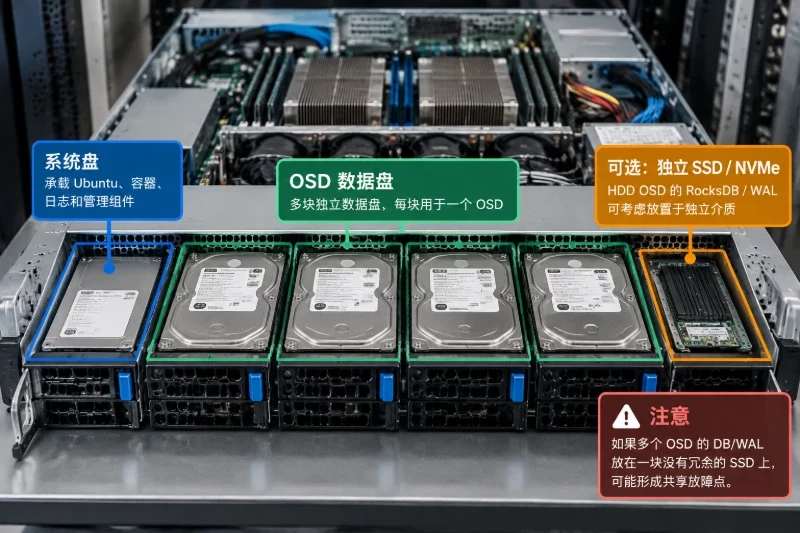
是否使用 DB/WAL 独立盘,需要结合随机写、元数据量、SSD 耐久度和故障替换策略判断。把所有 OSD 的 DB/WAL 放在一块没有冗余的 SSD 上,可能形成新的共享故障点。
以下操作可能破坏磁盘上的文件系统或已有数据:
wipefs
ceph-volume lvm zap
mkfs
分区表重建
在执行任何擦除或初始化前,必须确认:
若设备用途不明确,应停止操作,先执行只读检查:
lsblk -f
sudo pvs
sudo vgs
sudo lvs
sudo mdadm --detail --scan
不要用“清空所有磁盘”类脚本代替逐盘确认。新集群初始化失败时,优先保留现场和日志,不要立即对所有节点执行 zap 或重新分区。
容量规划不能直接把所有磁盘容量相加。可以先使用以下估算:
可用名义容量 ≈ 原始容量 ÷ 副本数
例如,3 台节点各有 4 块 3.84 TB 数据盘:
这个数值仍不是最终业务容量。实际结果还会受以下因素影响:
min_size;如果业务预计长期使用超过名义容量的七八成,应提前规划扩容,而不是等到 HEALTH_WARN 或 HEALTH_ERR 后再加盘。恢复和回填本身会消耗网络、磁盘 I/O 和 CPU,因此“容量刚好够用”并不等于“集群可以安全运行”。
SATA/SAS 磁盘可以使用:
sudo smartctl -a /dev/sdb
NVMe 设备可以使用:
sudo nvme list
sudo nvme smart-log /dev/nvme0
检查内核是否记录了 I/O 错误:
dmesg -T | egrep -i 'error|fail|timeout|reset|nvme|scsi'
已在使用的业务盘不要直接进行压力测试。对空闲盘做基准测试时,应在维护窗口进行,并使用临时文件系统或专门测试文件,不要把裸设备作为 fio 目标。测试后还应确认测试文件和临时挂载没有被误纳入 OSD 规划。
实际判断时,随机读写延迟、持续写入稳定性和异常重置比单次峰值 IOPS 更有参考价值。云硬盘还要确认是否存在突发 IOPS、吞吐封顶或共享存储底层资源争用。
如果使用双网络,规划可以表达为:
[global]
public_network = 10.10.20.0/24
cluster_network = 10.10.30.0/24
这段配置说明:
10.10.20.0/24;10.10.30.0/24;如果没有独立 cluster 网络,应只规划一个稳定的 Ceph 网络,不要填写一个实际上无法通信的 cluster_network。错误的网段配置可能让 OSD 互相发现失败,表现为集群长时间处于降级或不稳定状态。
配置副本数时,应先确定故障模型:
| 场景 | 规划重点 |
|---|---|
| 3 台 OSD 主机 | 通常按主机故障域规划 3 副本 |
| 2 台 OSD 主机 | 适合测试或低冗余场景,不适合要求主机级高可用的部署 |
| 4 台及以上 OSD 主机 | 更适合滚动维护和故障恢复,但仍需核对容量 |
| 盘数很多但主机少 | 不能把同一主机内多块盘当作多个独立主机故障域 |
| 网络带宽有限 | 降低恢复并发或延后扩容,避免恢复影响客户端 |
不要在没有容量和故障模型评估的情况下,直接修改全局 osd_pool_default_size、osd_pool_default_min_size 或恢复并发参数。不同类型的池可能需要不同的副本和恢复策略,应优先按业务池单独设计。
可以将以下结果保存为部署记录:
{
    echo "=== identity ==="
    hostnamectl
    hostname -f
    getent hosts node-a node-b node-c

    echo "=== system ==="
    cat /etc/os-release
    uname -r
    timedatectl show -p NTPSynchronized --value

    echo "=== network ==="
    ip -br addr
    ip route
    ss -lntp

    echo "=== storage ==="
    lsblk -e7 -o NAME,MODEL,SERIAL,SIZE,TYPE,FSTYPE,MOUNTPOINTS
    df -hT

    echo "=== permission ==="
    sudo -n true && echo "sudo: ok" || echo "sudo: failed"
} | tee preflight-$(hostname)-$(date +%F-%H%M%S).log
这段命令只进行信息采集,不会初始化磁盘或修改网络。各节点的日志应统一收集,重点对比主机名、Ubuntu 版本、网卡地址、时间同步和磁盘序列号。
完成引导和 OSD 部署后,先查看整体状态:
ceph -s
ceph health detail
ceph osd tree
ceph df
如果使用 cephadm,再查看:
ceph orch host ls
ceph orch ps
ceph orch device ls
一个基本可接受的结果应包括:
up 且为 in;HEALTH_ERR;ceph df 中的池容量与副本规划一致;刚部署完成时可能因池、监控或服务尚未完全创建而出现短暂告警。判断时应结合 ceph health detail 逐条确认,不要只看 ceph -s 的一行状态。
在专用测试池中完成最小读写验证:
ceph -s、OSD 日志和客户端错误;不要直接对生产池执行删除池、批量清理或破坏性测试。若需要验证 OSD 故障恢复,应先确认剩余容量和副本数量足够,并在维护窗口内按演练流程执行。模拟故障前必须记录原始状态,避免因为恢复流量过大影响业务。
可以按照以下结果判断是否进入正式部署:
| 检查项 | 可以继续的表现 | 应暂停的表现 |
|---|---|---|
| 主机名与解析 | 各节点解析一致且稳定 | 主机名重复、解析漂移 |
| 时间同步 | 所有节点已同步 | 节点时间持续偏移 |
| 私网连通性 | 无持续丢包,延迟稳定 | 超时、明显抖动或路径不一致 |
| MTU | 全路径一致 | 大包测试失败或部分节点不同 |
| 带宽 | 多连接吞吐满足复制与业务余量 | 重传明显或带宽被业务占满 |
| 防火墙 | 私网端口按范围放行 | 只能通过公网互通,或端口间歇性阻断 |
| 数据盘 | 设备身份明确、健康度正常 | 设备用途不明、SMART 报错 |
| 容量 | 副本后仍有恢复和维护余量 | 规划后接近满盘 |
| 权限 | SSH、sudo 可非交互执行 | 部署中途需要人工输入密码 |
如果 Netplan 修改后 SSH 中断,应通过云控制台或带外方式进入服务器,使用已备份的配置恢复。远程环境优先使用 netplan try,不要直接覆盖唯一可用链路。
恢复前先确认:
sudo ls -ld /etc/netplan*
sudo ip -br addr
sudo ip route
确认原配置无误后再恢复,并重新验证默认路由和私网路由。不要通过关闭全部防火墙来“验证网络”,这样可能掩盖安全组、路由或地址配置问题。
如果节点可以 ping,但 MON、OSD 仍无法建立连接,应按以下顺序检查:
ss -lntp 是否有服务监听;回滚时只删除本次添加的规则,保留原有管理访问规则。不要直接执行“允许全部端口”或“关闭防火墙”作为长期方案。
如果发现设备序列号、挂载点或 OSD 映射错误,应立即停止后续初始化,保留日志和当前设备状态。不要继续执行 wipefs、ceph-volume lvm zap 或重新格式化。
已经加入生产集群的 OSD,不能简单拔盘后重建。是否可以安全下线,取决于副本状态、剩余容量、池的 min_size 和当前恢复进度。没有容量验证前,不要随意执行 osd out。
新建且没有业务数据的测试集群,可以按照目标 Ceph 版本的官方清理流程撤销初始化;生产集群则应优先修复网络、权限或软件版本,不要因为某个节点加入失败就销毁整个集群。
回滚的基本原则是:
这套检查方式适合在 Ubuntu 香港服务器上部署常规 Ceph RBD、CephFS 或对象存储集群前使用,尤其适合具备私网、独立数据盘和自动化 SSH 权限的多节点环境。
以下情况不建议直接进入正式部署:
当主机身份、时间同步、私网端口、MTU、磁盘序列号和副本容量都通过验证,并且 ceph -s、ceph osd tree、ceph orch host ls 与实际规划一致时,才适合进入业务池创建和应用接入阶段。只要其中一项仍然依赖猜测,继续部署通常会把问题从“可修正的前置配置”变成“需要数据迁移的集群故障”。


