香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


直接回答容量问题:量化主要压缩模型权重,并不会自动等比例压缩上下文产生的 KV Cache、推理框架开销和显存预留。以常见模型规模估算,7B/8B 模型采用 4-bit 量化后,权重通常占用约 4.5~6GB;13B/14B 约 8~10GB;32B/34B 约 18~24GB;70B/72B 约 38~48GB。这个范围只代表权重文件加载后的大致占用,不等于可以直接使用的服务器显存。
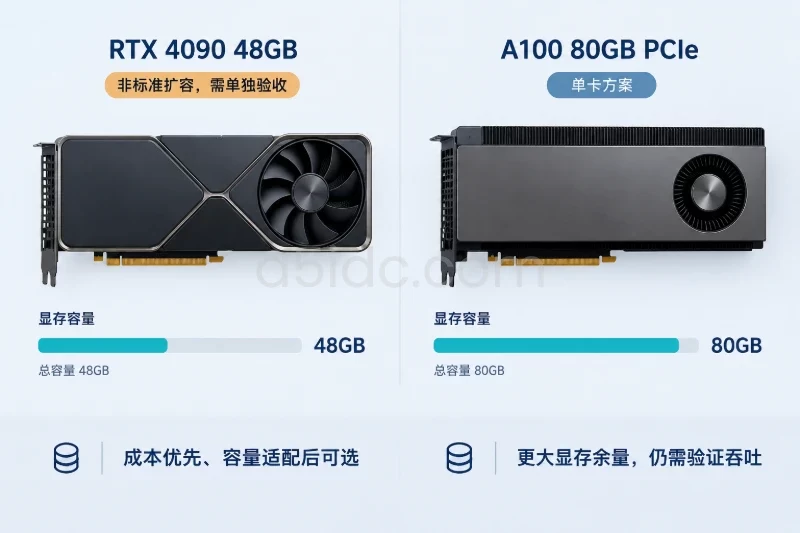
在香港 GPU 服务器上,24GB 显存的 RTX 4090 适合低到中等并发的 7B/8B、13B/14B 量化部署,32B/34B 进入显存边界,70B/72B 无法在单卡上稳妥部署。A100 40GB 可以承载更多 4-bit 中型模型,但 70B 量化模型通常仍需要多卡;A100 80GB 在控制上下文长度和并发的前提下,可以尝试单卡运行部分 70B/72B 4-bit 模型,但不能据此推导出固定并发或固定吞吐保证。
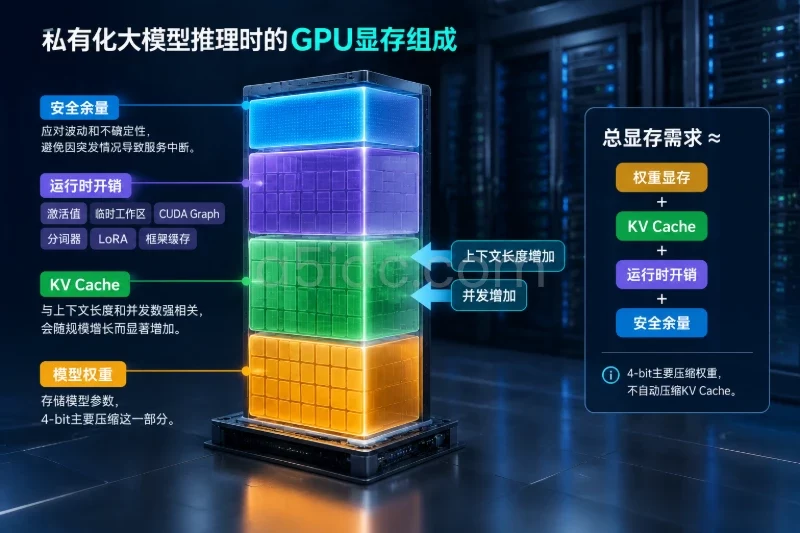
大模型推理的显存不是一个单独的数字,可以按以下关系估算:
总显存占用 = 模型权重 + KV Cache + 推理运行时开销 + 框架与缓存开销 + 安全余量
其中,模型权重通常在服务启动时就需要加载;KV Cache 会随着并发请求数、输入长度和输出长度增长,是高并发场景中最容易被低估的部分。
按照参数数量估算:
因此,不能简单地用“参数数量乘以 0.5 字节”作为最终显存结果。下面是按模型参数规模整理的参考区间,表内使用十进制 GB 作为权重文件和容量估算口径,实际框架日志可能以 GiB 展示。
| 模型规模 | FP16/BF16 权重 | INT8 权重 | 4-bit 权重 | 适合的显存判断 |
|---|---|---|---|---|
| 7B/8B | 14~16GB | 8~10GB | 4.5~6GB | 24GB 单卡较容易部署 |
| 13B/14B | 26~29GB | 14~17GB | 8~10GB | 4-bit 适合 24GB 单卡 |
| 32B/34B | 64~72GB | 34~40GB | 18~24GB | 24GB 单卡余量很小 |
| 70B/72B | 140~150GB | 72~82GB | 38~48GB | 通常需要 A100 80GB或多卡 |
例如,一个 8B 模型的 4-bit 原始权重理论值约为:
8,000,000,000 × 0.5 字节 ≈ 4GB
但实际加载时还要增加量化元数据、分组缩放参数、张量对齐和框架转换空间,所以更适合按 4.5~6GB 规划,而不是按 4GB 卡边界部署。
不同模型架构、量化工具和量化分组方式会造成差异。AWQ、GPTQ、不同的 INT8 实现以及运行时采用的权重格式,最终显存占用并不完全相同。模型文件大小也不能完全代替显存测试,因为部分推理引擎会在加载阶段生成额外的工作区。
模型权重决定“能不能加载”,KV Cache 更多决定“能同时处理多少请求”。
自回归模型在生成过程中,需要保存每一层注意力的 Key 和 Value。一个常用的估算关系是:
单个 Token 的 KV Cache 字节数
= 2 × 层数 × KV 头数 × 每头维度 × 每个元素字节数
其中前面的 2 代表 Key 和 Value 两份缓存。FP16 或 BF16 通常按每个元素 2 字节计算。
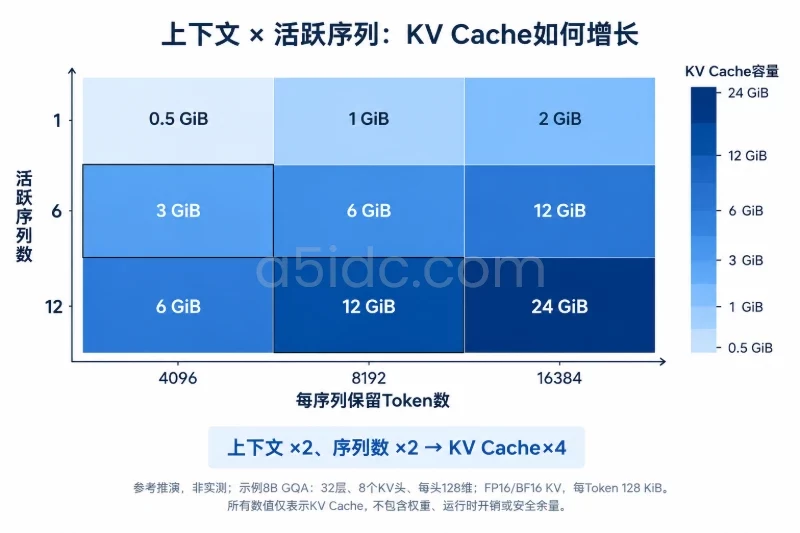
以一类常见的 8B、32 层、8 个 KV 头、每头 128 维的 GQA 模型为例:
2 × 32 × 8 × 128 × 2 字节 = 131,072 字节
这相当于每个序列每增加一个 Token,约增加 128KiB 的 FP16/BF16 KV Cache。若一个请求从输入到生成结束共保留 4096 个 Token,则单个请求大约需要:
128KiB × 4096 ≈ 512MiB
当同时有 6 个活跃序列时,KV Cache 约为:
512MiB × 6 ≈ 3GiB
这个例子并不是所有 8B 模型的固定结果。层数、KV 头数和是否采用 GQA/MQA 都会改变结果。相同参数规模的两个模型,KV Cache 可能因为注意力结构不同而相差明显。
还需要注意以下几点:
max_model_len 设置得越大,系统通常需要为更长的序列预留更大的缓存空间,具体行为取决于推理引擎。模型权重和 KV Cache 之外,显存还会被以下部分占用:
容量规划时,建议至少保留 15%~25% 的显存余量。对于 24GB RTX 4090,可以把 3~5GB 作为运行余量;对于 80GB A100,通常应预留约 8~12GB,具体数值还要结合引擎启动时的固定开销和 KV Cache 策略确定。
如果模型权重已经占到显卡容量的 85% 以上,即使服务能启动,也很难容纳稳定的并发请求。启动成功不等于具备生产可用容量。
请求总量、峰值并发和数据规模对资源的影响并不相同。容量规划时,至少要分开看请求速率、Token 数量、活跃序列和知识库规模。
可以用峰值请求速率和 Token 数量估算推理压力:
峰值输入 Token 速率 = 峰值 QPS × 单请求输入 Token 数 × 峰值系数
峰值输出 Token 速率 = 峰值 QPS × 单请求输出 Token 数 × 峰值系数
例如,一个内部问答服务在高峰期每秒处理 2 个请求,每个请求平均输入 2000 Token、输出 800 Token,峰值系数取 1.5,则估算为:
这两个数字不能直接转换成“A100 可以承载多少、RTX 4090 可以承载多少”,因为实际结果还取决于模型、量化格式、推理引擎、批处理策略、上下文长度和服务目标延迟。它们的作用是定义压测目标,之后再用真实模型和真实请求分布进行验证。
输入 Token 主要影响首字延迟和 Prefill 阶段;输出 Token 主要影响 Decode 阶段和持续占用时间。长文档问答通常会提高输入处理压力,而长篇生成、代码生成和多轮对话更容易拉长 KV Cache 生命周期。
平均并发可以用排队系统中的近似关系估算:
并发请求数 ≈ 请求速率 × 平均响应时间
例如,峰值速率为每秒 2 个请求,平均响应时间为 5 秒,则平均活跃请求约为 10 个。如果高峰时响应时间升至 8 秒,活跃请求可能增加到约 16 个,即使 QPS 没有变化,KV Cache 和队列压力也会继续上升。
生产规划不宜只使用平均值。可以分别记录:
当单请求的最大上下文是 8192 Token,而业务平均只使用 1500 Token 时,不能只按平均值规划。更稳妥的方式是使用平均值估算日常容量,再用 P95 或业务设置的最大值校验极端情况下的显存边界。
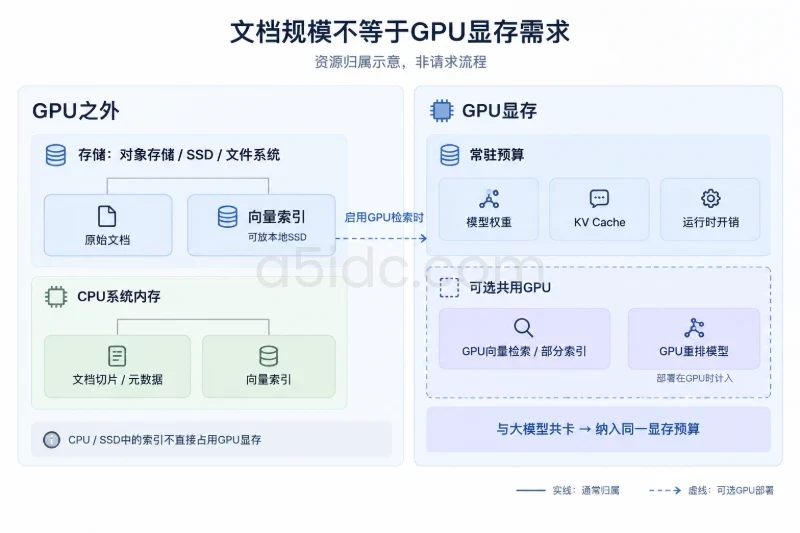
私有化部署经常同时包含大模型、向量数据库、文档库和重排模型。文档总量本身不等于大模型显存需求:
例如,100 万条 1536 维、FP32 格式的向量,其原始向量空间约为:
1,000,000 × 1536 × 4 字节 = 6,144,000,000 字节 ≈ 6.14GB
实际还要增加索引结构、元数据、碎片和副本空间。如果这部分索引运行在 CPU 内存中,就不会直接挤占 A100 或 RTX 4090 的显存;如果启用 GPU 向量检索,则需要把索引占用纳入 GPU 容量表。
因此,香港 GPU 服务器的规格不能只看“模型能否加载”,还要确认文档库、向量数据库、重排模型是否与大模型共用同一张 GPU。
RTX 4090 的核心限制是显存容量为 24GB。对于 7B/8B 和 13B/14B 模型,4-bit 权重通常可以留下较为可用的 KV Cache 和运行时空间。
典型适配关系可以这样理解:
RTX 4090 的优势是单卡算力和部署成本可能具有吸引力,但它属于消费级显卡,通常不具备 A100 这类数据中心卡的 ECC 显存能力。用于香港私有化服务器时,还应确认机箱散热、供电、PCIe 插槽间距、长时间满载稳定性和远程运维方式。
A100 40GB 比 RTX 4090 多出较大的显存空间,适合:
32B/34B 4-bit 模型的权重通常约 18~24GB。加载到 A100 40GB 后,还要扣除运行时开销、KV Cache 和预留空间,因此更适合低到中等并发、受控上下文的部署。如果业务要求 16K 甚至更长上下文,A100 40GB 也可能很快遇到缓存边界。
70B/72B 4-bit 在 A100 40GB 单卡上通常不具备实际可行性。即使通过特殊压缩让权重勉强接近容量,也很难留下足够的运行空间。
A100 80GB 更适合需要较大权重空间或较高并发的场景:
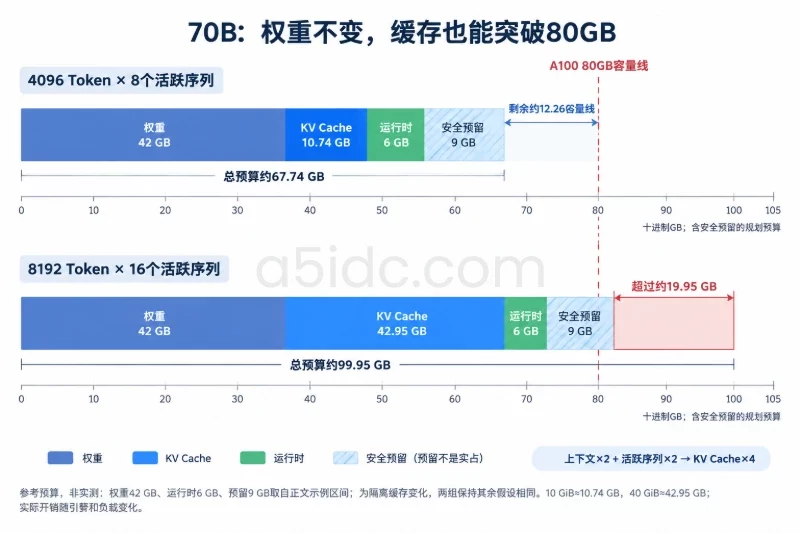
以某类 70B GQA 模型作为说明,若 80 层、8 个 KV 头、每头 128 维,FP16/BF16 KV Cache 约为 0.3125MiB/Token。单个 4096 Token 序列约需 1.25GiB,8 个活跃序列约需 10GiB。
若 4-bit 权重占用约 40GB,再加上运行时开销、10GiB 左右的 KV Cache和预留空间,A100 80GB 仍可能有一定余量。但如果同时使用 8192 Token 上下文和 16 个活跃序列,KV Cache 可能接近:
1.25GiB × 2 × 16 = 40GiB
此时再加权重和框架开销,就可能超过单张 A100 80GB。这个例子说明,A100 80GB 能否承载 70B,并不是只由“4-bit 权重小于 80GB”决定。
| 模型规模 | RTX 4090 24GB | A100 40GB | A100 80GB |
|---|---|---|---|
| 7B/8B 4-bit | 适合,需按并发配置 KV Cache | 适合 | 适合高并发或长上下文规划 |
| 13B/14B 4-bit | 适合中低并发 | 适合 | 适合更高缓存余量 |
| 32B/34B 4-bit | 显存边界,不适合高上下文 | 可尝试,需验证并发 | 较适合 |
| 70B/72B 4-bit | 单卡不可取 | 单卡通常不可取 | 低到中等并发下可评估 |
| 70B/72B INT8 | 单卡不可行 | 单卡通常不可行 | 通常需要多卡 |
表中的“适合”只表示显存规划方向,不是固定吞吐承诺。模型架构、量化格式、推理框架、最大上下文和并发配置都可能改变结果。
4-bit 权重量化适合以下条件:
4-bit 不一定带来线性加速。部分引擎需要在计算过程中进行反量化,实际速度受 GPU 架构、批大小、输入输出比例和内核实现影响。对 RTX 4090 来说,4-bit 主要价值通常是降低权重占用;对 A100 来说,还可以把节省出来的显存用于更长上下文或更多并发。
INT8 权重一般比 4-bit 占用更多显存,但可能减少部分精度损失,适合:
INT8 也不是统一标准。不同量化方案可能采用权重-only、权重与激活共同量化或混合精度,需要确认模型格式和推理引擎是否匹配。
如果瓶颈来自上下文和并发,而不是模型权重,可以评估 KV Cache 量化。它的目标是减少每个活跃 Token 的缓存占用,尤其适合:
KV Cache 量化可能影响长上下文检索能力、数字精度、代码生成或格式化输出。上线前至少应使用真实的中文问题、长文档、连续多轮对话和结构化输出样本进行对比,不能仅凭显存下降就判断方案可用。
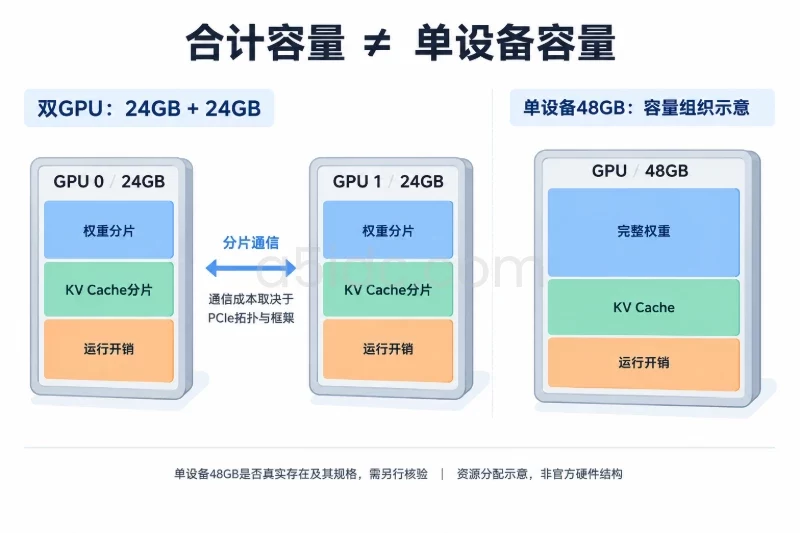
70B 4-bit 模型在 RTX 4090 上通常需要多卡切分。两张 24GB 显卡理论上拥有 48GB 显存,但实际可用空间会受到以下因素影响:
因此,2×RTX 4090 的实际部署效果不能简单等同于 1×A100 80GB。A100 的具体 PCIe、SXM、互联方式也会影响多卡性能,采购香港 GPU 服务器时应要求服务商明确 GPU 型号、显存规格、互联方式和容器环境,而不是只确认“A100”或“4090”这一个名称。
把权重卸载到 CPU 内存可以降低 GPU 显存压力,但通常会增加 PCIe 数据搬运和响应延迟。如果业务要求稳定的实时对话,不宜把 CPU 卸载当作显存不足后的默认解决方案。
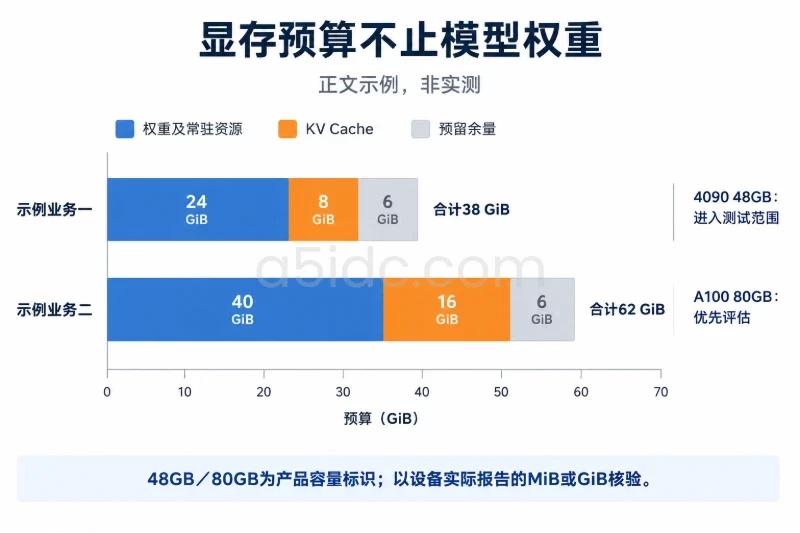
业务设置如下:
按照前面的 8B GQA 示例,单个 4096 Token 序列约需 512MiB KV Cache,6 个序列约需 3GiB。合计可按以下范围预估:
4.5~6GB 权重
+ 约 3GB KV Cache
+ 3~5GB 运行时开销
+ 3~4GB 预留
= 约 13.5~18GB
在 24GB RTX 4090 上,这类方案通常有可操作空间。但如果把活跃序列提高到 12 个,同时把上下文上限提高到 8192 Token,KV Cache 可能接近原来的 4 倍,显存余量会明显收缩。此时应优先评估上下文上限、分页缓存、KV 量化或增加副本,而不是只观察模型权重大小。
容量假设如下:
以示例架构估算,8 个 4096 Token 序列约需 10GiB KV Cache。总体占用可能处于:
约 40~45GB 权重
+ 约 10GiB KV Cache
+ 5~8GB 运行时开销
+ 8~10GB 预留
这种配置在 A100 80GB 上有机会运行,但可用并发会受到模型具体权重大小和引擎分配方式影响。如果将上下文提高到 8192 Token,或者同时活跃序列达到 16 个,KV Cache 可能增加到约 40GiB,单卡空间就会变得紧张。
因此,70B 部署的验收条件不应只写“模型成功加载”,还应写明:
A5数据提供香港及美国GPU物理服务器资源,涵盖A100 80GB、RTX 4090等显卡配置,并结合服务器CPU、内存与NVMe存储,为私有化大模型推理、模型测试和图像处理提供硬件基础。香港GPU系列配有CN2线路,美国GPU系列提供三网直连回国或国际带宽方案,适配不同业务访问路径与部署场景。
香港机房位置不会改变模型本身的显存需求,但会影响服务器供应、网络路径、数据存储位置和运维方式。采购或租用时,应分别核对 A100 和 RTX 4090 的以下条件:
| 核对项 | A100 重点 | RTX 4090 重点 |
|---|---|---|
| 显存规格 | 确认 40GB 还是 80GB,PCIe 还是其他形态 | 确认是否为 24GB 实体显存 |
| 多卡互联 | 确认 PCIe、NVLink 或服务器互联方案 | 通常需要重点确认 PCIe 通信和主板布局 |
| 稳定性能力 | 确认 ECC、驱动和数据中心运维支持 | 确认长时间满载散热、供电和远程重启能力 |
| 软件环境 | 确认 CUDA、驱动、容器运行时和量化内核 | 确认消费级 GPU 对目标推理框架的支持 |
| 存储 | 模型文件、量化版本和向量数据库的本地读写能力 | 避免模型加载和向量检索与 GPU 争用资源 |
| 网络 | API 请求、文档上传、跨区域访问和备份路径 | 同样需要确认带宽、延迟和流量限制 |
| 交付验收 | 用目标模型、上下文和并发压测 | 重点验证显存峰值、温度和持续运行稳定性 |
如果企业数据、会话日志和向量索引都在香港服务器内处理,还应明确日志保存周期、备份位置、管理员访问范围以及是否存在跨区域调用。私有化的边界不仅是模型部署在自有 GPU 上,也包括输入、检索结果、生成内容和监控日志的完整数据路径。
扩容不应等到服务出现 OOM 后才执行。建议在预发布压测和生产运行中持续记录以下指标:
可以用一组条件化阈值作为初始规则:
| 监控情况 | 判断 | 建议动作 |
|---|---|---|
| 稳态显存长期低于 70% | 仍有较大容量空间 | 继续观察吞吐和延迟 |
| 显存长期达到 80%~85% | 余量开始不足 | 限制最大上下文或准备扩容 |
| KV Cache 长期超过 70%~80% | 并发增长会快速挤压显存 | 评估 KV 量化、分页缓存或增加副本 |
| P95 队列等待持续上升 | 计算吞吐或并发容量不足 | 先区分 Prefill 和 Decode 瓶颈 |
| TTFT 上升而 Decode 稳定 | 输入过长或 Prefill 瓶颈 | 优化检索片段、上下文和批处理 |
| TPOT 上升且活跃序列增加 | Decode 或 KV Cache 瓶颈 | 降低并发、增加副本或升级 GPU |
| 出现 OOM 或频繁重启 | 已超过安全边界 | 立即降低缓存上限并制定扩容方案 |
更稳妥的阈值确定方法是先做阶梯压测:从低并发逐步增加请求,记录显存、队列和 P95 延迟。当队列开始持续增长,或 P95 延迟相对稳定基线提高约 20%~30% 时,将该点视为当前配置的有效边界,再把日常运行目标设置在边界的 70%~80% 左右。
扩容触发点可以同时考虑增长率和采购周期。例如,若过去四周的峰值活跃序列、输入 Token 速率或向量检索量持续增长,并预计在服务器交付周期内还会增加 30%~50%,就不应继续按照当前峰值满载运行。对于 RTX 4090,常见动作是增加模型副本或改用更小量化模型;对于 A100,则可以在增加并发、扩大上下文、采用多卡或切换更大模型之间进行选择。
最终的容量规划应保留一份按模型版本、量化格式、最大上下文、峰值 QPS、活跃序列数和显存余量填写的配置表。这样才能判断当前瓶颈是模型权重、KV Cache、Prefill、Decode、向量检索还是网络队列,并据此决定继续优化量化、增加香港 GPU 服务器副本,还是升级到显存更大的 A100 规格。