香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


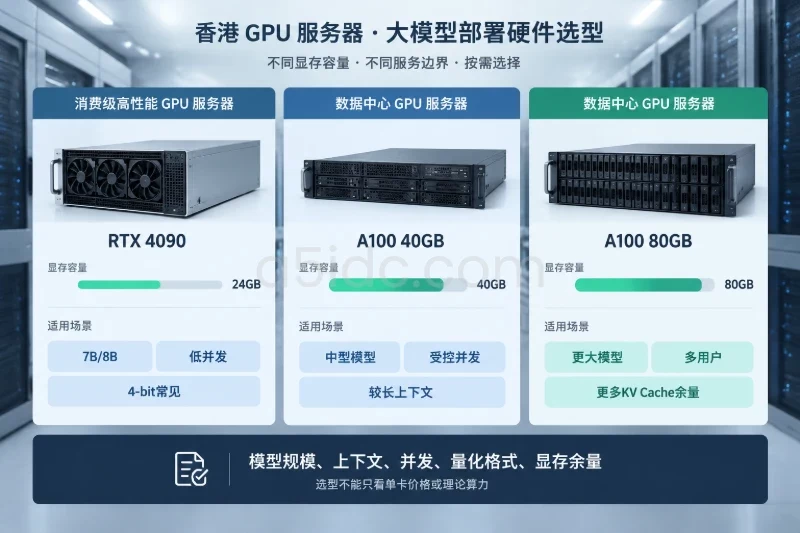
在香港GPU服务器上部署私有化大模型,A100与RTX 4090的选择不能只看单卡价格或理论算力,首先要看同一个模型在目标上下文长度、并发数和量化格式下是否能够稳定留出显存余量。常见的RTX 4090拥有24GB显存,适合7B/8B以及部分14B模型的低并发推理;A100则有40GB和80GB等版本,更适合BF16/FP16部署、32B以上模型、长上下文和多用户并发。
如果主要运行7B/8B模型、单轮对话为主、并发不高,4-bit权重量化通常可以让RTX 4090获得较好的成本与性能平衡。14B模型在RTX 4090上一般需要4-bit,或在控制上下文和并发的前提下使用8-bit;如果希望保留更大的上下文窗口、更高并发或更少依赖量化,A100更合适。32B模型通常应优先考虑A100,70B模型则要重点核对A100 80GB或多卡方案,不能因为权重经过4-bit量化就直接认为单卡一定能够稳定运行。
A100与RTX 4090只有在以下条件一致时,比较结果才有意义:
同一个14B模型,单用户、4K上下文和8用户、16K上下文可能需要完全不同的显存。前一种场景可能在RTX 4090上运行,后一种场景即使权重相同,也可能需要A100 80GB或多卡部署。
因此,型号选择应放在显存规划之后,而不是反过来先决定GPU,再强行压缩模型。
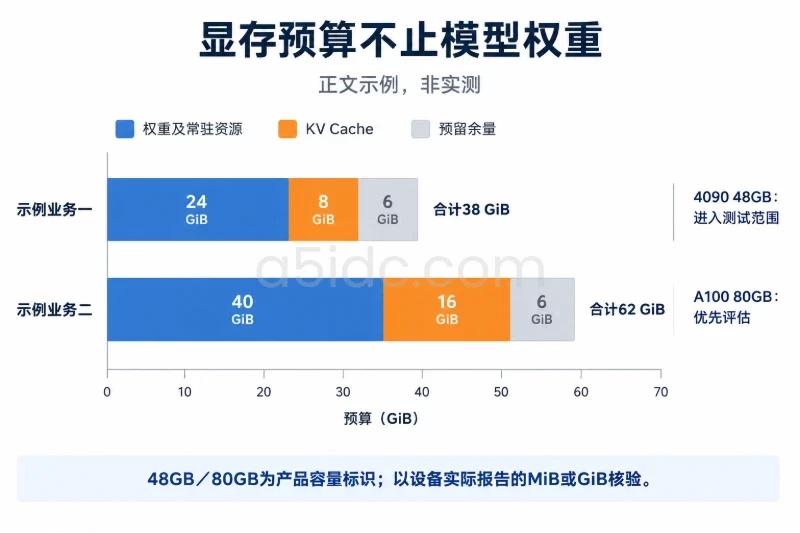
推理时的显存并不等于模型文件大小,通常可以拆分为:
可以使用下面的简化关系进行初步判断:
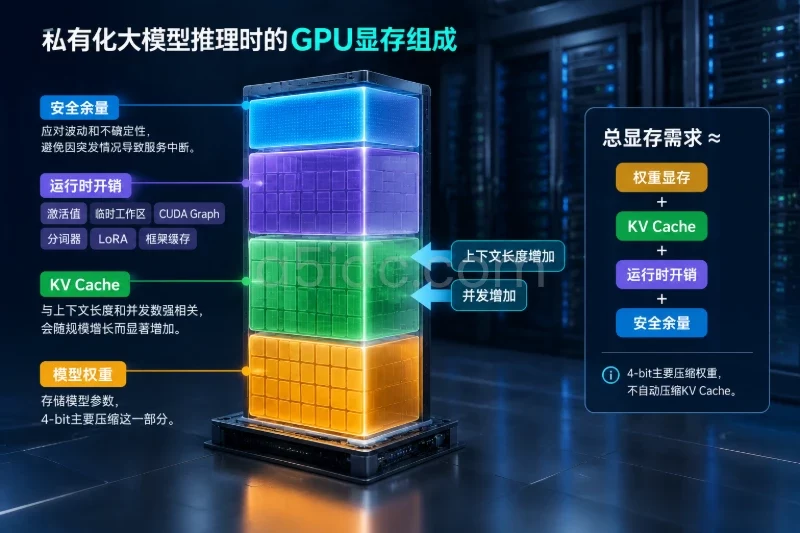
总显存需求 ≈ 权重显存 + KV Cache + 运行时开销 + 安全余量
权重显存可用参数量和每个参数占用的字节数估算。以十进制GB计算,FP16或BF16约占2字节/参数,INT8约占1字节/参数,4-bit约占0.5字节/参数。
| 模型规模 | FP16/BF16权重理论值 | INT8权重理论值 | 4-bit权重理论值 |
|---|---|---|---|
| 7B | 约14GB | 约7GB | 约3.5GB |
| 8B | 约16GB | 约8GB | 约4GB |
| 14B | 约28GB | 约14GB | 约7GB |
| 32B | 约64GB | 约32GB | 约16GB |
| 70B | 约140GB | 约70GB | 约35GB |
这些是理论权重值,不是实际运行占用。量化文件还会包含缩放因子、分组信息和部分未量化层,推理框架也可能保留FP16或BF16的输出层、激活和临时缓冲区。因此,4-bit模型的实际权重占用通常会高于理论值,不能直接用“参数量乘以0.5字节”作为最终验收标准。
稳妥的单卡规划可以先把GPU总显存的75%至85%作为模型和服务运行区间,剩余空间用于应对上下文增长、并发波动和框架临时分配。这不是硬性规则,但比把显存占用推到95%以上更适合长期服务。
| 对比维度 | RTX 4090 24GB | A100 40GB | A100 80GB |
|---|---|---|---|
| 单卡显存余量 | 适合小中型模型和4-bit推理 | 适合中型模型、较长上下文 | 适合更大模型、较高并发或更少量化 |
| 典型部署重点 | 低并发、低成本、单卡服务 | 兼顾模型规模和稳定性 | 大模型、长上下文、多用户服务 |
| BF16/FP16空间 | 7B/8B较容易,14B通常不适合FP16 | 14B较宽松,32B需量化 | 32B可有更多选择,70B仍需谨慎 |
| 多卡与数据中心能力 | PCIe多卡,通信和散热需重点核对 | 支持数据中心级特性 | 更适合高显存、多卡和长期服务 |
| 适合的服务形态 | 原型、内部工具、低并发API | 中小规模生产服务 | 大模型生产服务和扩展空间更大的场景 |
RTX 4090并不是单纯的“低端替代品”。在单用户或小批量解码时,它的单卡计算性能可能很有竞争力,尤其适合显存需求不高、希望控制GPU租用成本的部署。但它的24GB显存上限会明显限制模型规模、上下文长度和并发数。
A100的优势更多体现在显存容量、数据中心可靠性、多卡部署条件和持续服务能力。A100 40GB与A100 80GB也不能视为同一选择,后者不仅能多容纳40GB显存,还能减少量化强度或为KV Cache保留更多空间。
FP16和BF16都使用约2字节存储权重,显存占用大致相近。它们适合以下情况:
A100通常更适合BF16/FP16生产部署,因为40GB或80GB显存可以容纳更大的模型和KV Cache。RTX 4090运行7B/8B的FP16或BF16通常更现实,但上下文、并发和运行时开销仍然需要单独核对。
例如,8B模型的FP16权重理论上约为16GB。放入24GB显存后,剩余空间只有约8GB,还要分配给KV Cache、框架开销和临时缓冲区。单用户、较短上下文可能可以运行,但不能据此推断它能够承载多用户长对话。
INT8一般分为权重量化和权重加激活量化两类。
权重-only INT8部署相对容易,主要减少模型权重占用;W8A8则同时压缩权重和激活,可能带来更好的显存和吞吐表现,但需要校准数据、匹配的推理内核以及框架支持。
INT8适合以下场景:
对于14B模型,INT8权重理论值约14GB,RTX 4090仍可能有空间放置KV Cache和运行时组件,但能支持多少上下文和并发不能只看这个数字。对32B模型,INT8权重理论值约32GB,A100 40GB上也需要谨慎规划,A100 80GB会更宽松。
AWQ和GPTQ都常用于大语言模型的4-bit权重量化。它们能够显著降低权重显存,使14B、32B甚至部分70B模型具备单卡或少量多卡部署的可能。
二者不应只按“谁的bit数更低”判断,重点在于:
RTX 4090部署7B/8B和14B模型时,AWQ或GPTQ 4-bit通常是较自然的选择。32B模型也可能在单张RTX 4090上启动,但上下文和并发空间会明显受限,稳定性不能只根据权重“能放进去”来判断。
A100 40GB可以利用4-bit部署32B模型,但如果服务需要长上下文或多用户并发,应预留更大的空间。A100 80GB则可以在更宽松的条件下部署32B 4-bit,或者尝试70B 4-bit的短上下文场景。
NF4常见于bitsandbytes等工具链,通常以4-bit存储权重,并使用FP16或BF16作为计算类型。它适合快速验证和部分量化推理流程,但实际速度、显存占用和多卡表现取决于框架实现。
GGUF更常见于llama.cpp及其相关生态,适合纯GPU、CPU卸载或混合部署。若业务采用的是以vLLM、TensorRT-LLM或其他服务框架为核心的API服务,不能直接把GGUF的Q4_K_M等命名与AWQ/GPTQ的4-bit结果当成同一种性能表现。
量化格式必须和推理引擎一起评估。模型文件能够下载、能够被加载,并不代表已经适合目标API并发。
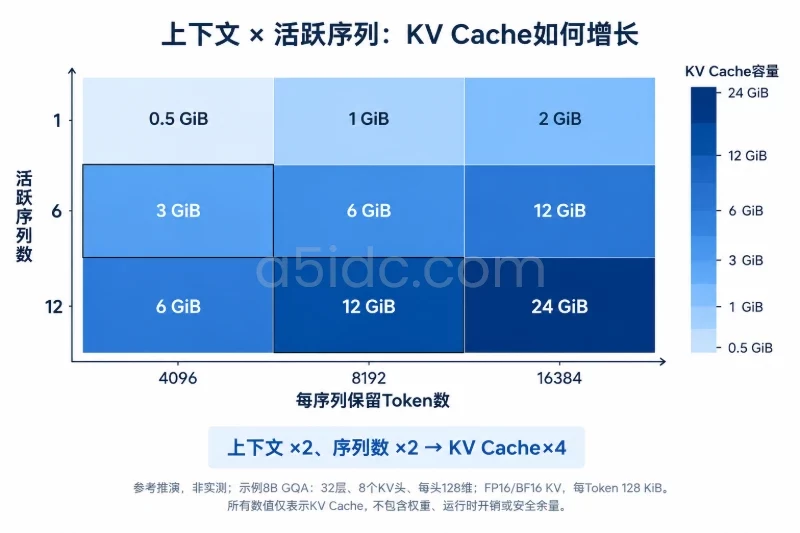
权重量化主要减少模型权重显存,但KV Cache通常仍以FP16或BF16存储。随着上下文长度和并发数增加,KV Cache可能成为新的主要瓶颈。
以一个采用GQA的8B级模型为例,若有32层、8个KV头、每个头128维,FP16 KV Cache每个Token的近似占用为:
2 × 32 × 8 × 128 × 2字节 = 131072字节,约128KiB
单个请求使用8192 Token时:
128KiB × 8192 ≈ 1GiB
如果同时保留8个类似请求,KV Cache就可能接近8GiB。实际模型的层数、KV头数、头维度和数据类型不同,结果也会不同,但这个例子说明了一个关键问题:把权重从FP16压缩到4-bit,并不会自动把KV Cache压缩到4-bit。
KV Cache量化可以进一步降低显存,但可能影响长文本连贯性、复杂指令遵循和部分任务表现。只有在目标模型、框架和业务评测均通过后,才适合将其作为生产配置。
7B或8B模型是RTX 4090较适合的范围,常见选择顺序可以是:
8B模型FP16权重约16GB,24GB显存仍需扣除KV Cache和运行时开销。若服务只有单用户或少量并发,且最大上下文不高,RTX 4090可以保留较好的模型精度。若是内部知识库问答、代码助手或多用户API,则4-bit能够提供更大的并发余量。
A100在这个规模上的优势不是“能不能运行”,而是能够用更少的量化、更大的批处理和更长的上下文运行。若业务对8B模型的并发要求不高,使用A100可能属于容量冗余;若需要全天候提供稳定API、多个团队同时调用,A100的显存余量和数据中心特性更有价值。
14B模型FP16权重理论上约28GB,通常无法在RTX 4090 24GB上直接完成稳定的FP16服务。即使采用8-bit,权重和运行时开销叠加后,也需要严格控制上下文与并发。
因此,RTX 4090部署14B时,较常见的路线是:
A100 40GB可以为14B FP16/BF16提供更好的空间,但如果最大上下文较长,仍然不能把28GB权重视为全部需求。A100 80GB则可以在保持更大KV Cache和并发余量的同时减少量化约束。
如果14B模型承担企业知识问答、结构化输出或工具调用,建议先用4-bit和BF16各做一组业务样本测试。量化后是否可用,应以答案正确率、引用完整性、JSON格式通过率和长文本表现为准,而不是只看生成速度。
32B模型的FP16权重理论值约64GB,单张RTX 4090无法容纳;4-bit权重理论值约16GB,看起来可以放入24GB,但实际还要支付量化元数据、KV Cache和运行时开销。
RTX 4090单卡运行32B 4-bit时,适合:
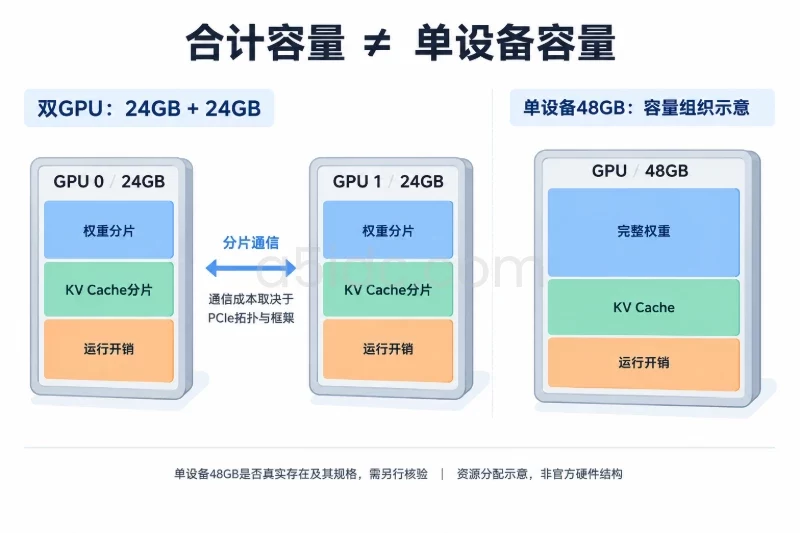
如果使用两张或更多RTX 4090进行张量并行,显存总量虽然增加,但多卡通信依赖PCIe和服务器拓扑,通信延迟、显存切分、容器识别和负载均衡都会增加部署复杂度。两张24GB卡的总显存也不能简单等同于一张48GB数据中心卡。
A100 40GB运行32B 4-bit通常更容易留出余量;A100 80GB则可以考虑8-bit或更高精度的方案,具体仍取决于上下文和并发。若32B模型是核心生产服务,优先评估单张A100 80GB或多张A100,而不是只根据单卡租用价格选择多张RTX 4090。
70B模型的4-bit权重理论值约35GB,实际占用可能达到40GB以上,随后还要加入运行时开销和KV Cache。
因此:
如果业务必须使用70B模型,应先确定是追求模型能力、服务并发,还是控制成本。追求能力但接受较低并发,可以先评估A100 80GB的4-bit方案;追求稳定并发,则应将多卡通信、KV Cache和故障切换一起纳入方案,而不是只计算35GB理论权重。
量化后的模型可能在普通问答中表现正常,但在以下场景出现差异:
因此,量化验收不应只用几条常识问题。可以建立一组固定样本,至少包含知识问答、长上下文、结构化输出和异常输入。用BF16或FP16作为参考版本,比较4-bit、8-bit输出的业务通过率。
如果4-bit模型的业务通过率已经满足要求,A100也不一定要保留FP16;如果4-bit导致工具调用失败或结构化输出不稳定,升级到8-bit或BF16可能比单纯增加并发更重要。
权重变小通常有利于显存容量和带宽压力,但量化模型还需要反量化或特殊Kernel。实际速度受到以下因素影响:
RTX 4090在低并发Decode场景中可能有较好的单请求速度,但当并发提高、上下文变长后,24GB显存会限制Batch和KV Cache。A100在持续并发、长上下文及多卡服务中,通常更容易保持稳定的P95延迟。
因此,不要用“4-bit显存更低”直接推导出“4-bit吞吐一定更高”,也不要用一次单请求生成速度替代生产服务的并发测试。
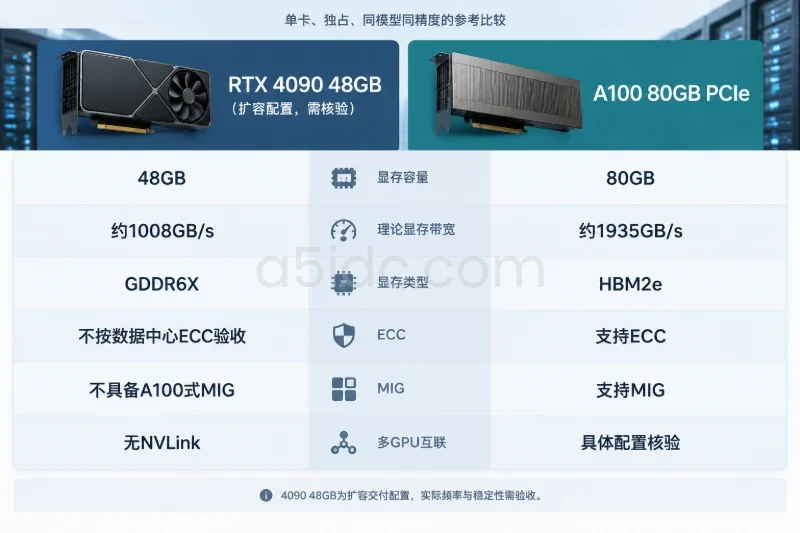
A100是面向数据中心的GPU,通常具备更完整的ECC、RAS、虚拟化和长期运行支持。A100还可使用MIG等资源隔离能力,但是否可用取决于服务器、驱动和云平台配置。
RTX 4090更偏向消费级高性能显卡,部署到香港GPU服务器时需要额外核对:
A100多卡也不是自动没有问题。A100 PCIe与SXM平台的互联能力和服务器拓扑可能不同,具体应查看实例说明和nvidia-smi topo -m结果。不要把A100 80GB的单卡能力与带高带宽互联的多卡节点混为一谈。
租用成本可以用下面的方式估算:
月度GPU成本 = GPU小时价格 × 实际运行小时数
如果按持续运行估算,可以将一个月按约730小时计算,但实际业务还要加上:
更有意义的比较方式是:
单位有效成本 = 月度总成本 ÷ 稳定可提供的并发数或有效Token吞吐
例如,单张RTX 4090的租用成本可能较低,但如果14B模型必须使用4-bit、最大并发只有2,且业务高峰需要再增加一张卡,那么它的有效服务成本未必低于一张A100 40GB。反过来,如果只是每天少量调用7B模型,A100的大显存也可能长期闲置,RTX 4090更合理。
具体价格和库存会随香港机房、GPU代际、带宽、磁盘和租期变化,不能用固定报价替代实际询价。选型时应要求服务商分别确认GPU型号、显存容量、是否独占、PCIe拓扑、带宽计费和故障处理范围。
A5数据提供香港GPU服务器资源,涵盖A100 80GB、RTX 4090等显卡选项,并配套服务器CPU、内存与NVMe存储,可用于私有化大模型推理、量化模型测试和企业API服务。香港GPU产品提供CN2线路配置,结合不同硬件组合,为模型权重、运行环境及业务数据提供相应的算力与网络资源基础。
私有化部署的价值之一是模型权重、知识库和推理数据可以放在受控的服务器环境中,但“服务器在香港”本身不能自动代表完整的数据合规结论。
需要核对:
如果应用系统和香港GPU服务器之间存在较长网络链路,用户感知的首Token延迟可能受网络影响。此时即使GPU算力足够,也需要分别测量网络往返时间、Prefill耗时和Decode耗时。
多卡部署可以扩大可用显存,但会增加:
A100 SXM平台通常更适合对互联要求较高的多卡场景,但具体能力仍取决于实例形态。RTX 4090没有面向此类服务器互联设计的NVLink方案,多卡运行大模型时更加依赖PCIe拓扑和软件切分策略。
如果模型能够通过单张A100 80GB稳定运行,通常比两张RTX 4090拼接出相近的理论显存更容易运维。只有在单卡方案成本明显不合适,且业务能够接受多卡复杂度时,才值得进一步比较多张RTX 4090。
在Linux服务器上,可以先查看实际GPU名称、显存和驱动版本:
nvidia-smi --query-gpu=name,memory.total,memory.used,driver_version --format=csv
多卡服务器还应查看卡间拓扑:
nvidia-smi topo -m
这两条命令只能确认设备和拓扑,不能证明目标模型能够稳定服务。还需要核对CUDA版本、推理框架版本、量化格式支持情况以及模型的实际配置文件。
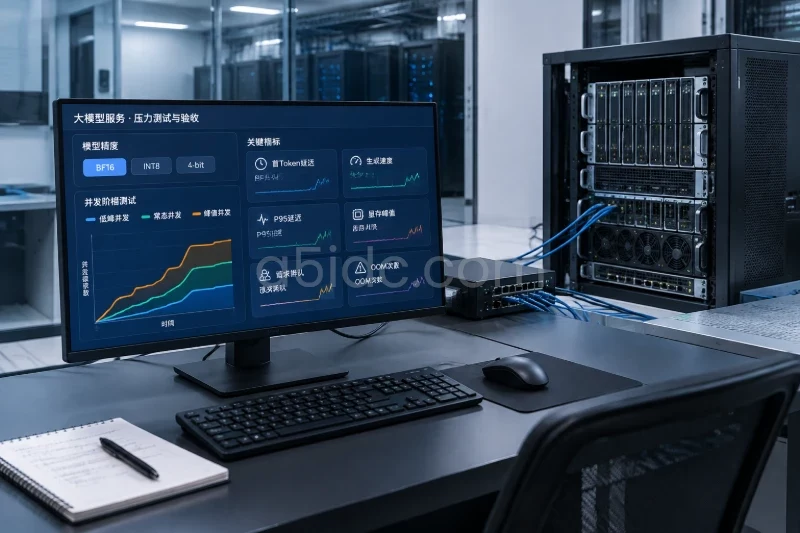
建议将以下条件固定后再进行测试:
| 验收项目 | 建议固定内容 |
|---|---|
| 模型 | 具体模型版本、上下文窗口、是否加载LoRA |
| 精度 | BF16/FP16、INT8、AWQ/GPTQ 4-bit等 |
| 并发 | 1、目标并发、峰值并发 |
| 输入长度 | 短问答、长文档、最大上下文 |
| 输出长度 | 典型输出和最大输出 |
| 性能指标 | 首Token延迟、单请求生成速度、P95延迟 |
| 资源指标 | 显存峰值、GPU利用率、显存碎片、OOM次数 |
| 质量指标 | 正确率、格式通过率、工具调用成功率 |
测试时不要只观察平均Tokens/s。生产服务更应关注高峰时的P95延迟、显存峰值和请求排队情况。若测试配置将显存占用推到接近100%,应降低并发或缩短上下文后重新评估,而不是直接上线。
可以采用以下决策顺序:
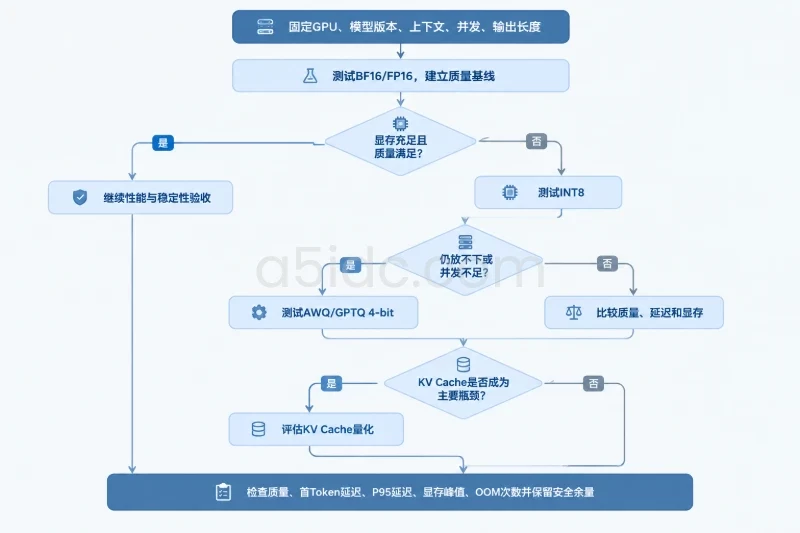
这种顺序能够避免一开始就选择4-bit,最后才发现量化损失影响业务,也能避免为了保留FP16而租用长期闲置的大容量GPU。
如果目标是7B/8B模型、单卡部署、并发较低,且预算更敏感,RTX 4090通常可以从FP16/BF16或4-bit开始评估。需要更多并发、长上下文或全天候API稳定性时,再考虑A100 40GB。
如果目标是14B模型,RTX 4090应优先规划4-bit,并将最大上下文和并发写入服务限制;A100 40GB适合保留更高精度或提供更多KV Cache空间,A100 80GB则更适合希望减少量化约束的场景。
如果目标是32B模型,优先考虑A100。A100 40GB适合4-bit和受控并发,A100 80GB适合更宽松的上下文、并发或8-bit方案。除非已经验证PCIe拓扑、通信效率和运维能力,否则不建议仅为了凑显存而直接堆叠多张RTX 4090。
如果目标是70B模型,A100 80GB只能作为短到中等上下文、较低并发的单卡4-bit候选;长上下文、多用户和高可用服务应按照多张A100 80GB规划。RTX 4090多卡方案不是不能实现,但需要把通信开销、服务复杂度和实际有效成本一并计算。
最终可以遵循三条规则:显存不足时先判断是权重问题还是KV Cache问题;量化选择先看业务质量,再看节省的显存;GPU选择以稳定并发和有效服务成本为准,而不是只比较单卡理论算力。对大多数内部知识库、轻量API和7B/8B模型,RTX 4090配合合理的4-bit策略已经足够;对14B以上模型、长上下文、多人并发以及长期生产服务,A100 40GB或80GB通常能提供更宽松的部署边界。