香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


A5数据香港256核512线程双路EPYC 9754服务器,适合能够拆分成大量独立任务、持续消耗CPU资源,并且有足够内存和数据供给的大规模计算业务。典型对象包括批量编译与持续集成、CPU渲染、科学计算中的参数扫描与蒙特卡洛模拟、大批量数据清洗、部分生物信息分析,以及多租户虚拟化和容器计算资源池。它的主要价值是提高整台服务器的任务吞吐量,而不是让任意一个程序都按核心数量等比例加速。
是否值得使用这类香港服务器,要同时判断三个问题:业务能否有效利用大量核心,内存、存储和网络能否跟上,以及数据与业务用户是否适合放在香港。对于串行程序、以GPU为主的模型训练、强依赖单线程响应的应用,或需要跨节点容灾的关键系统,256核并不直接等于更合适。标题给出的CPU规格也不代表某个固定内存、磁盘或带宽套餐,具体配置与交付范围应以实际订单为准。
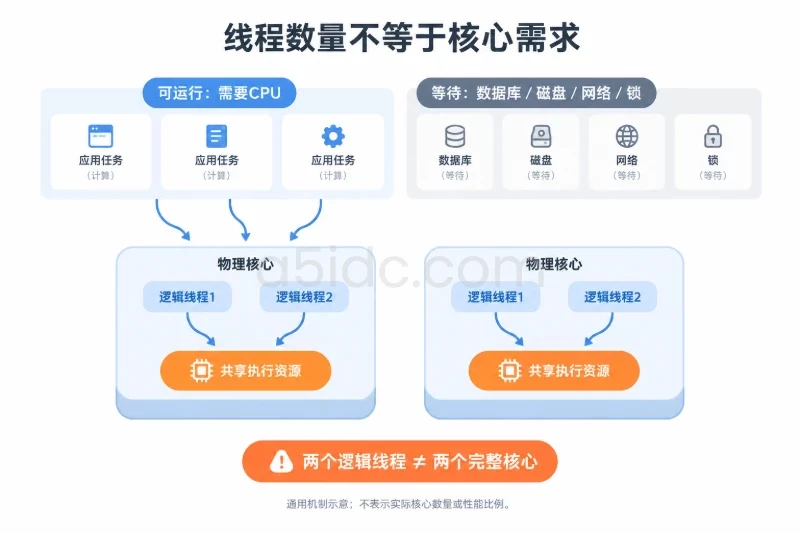
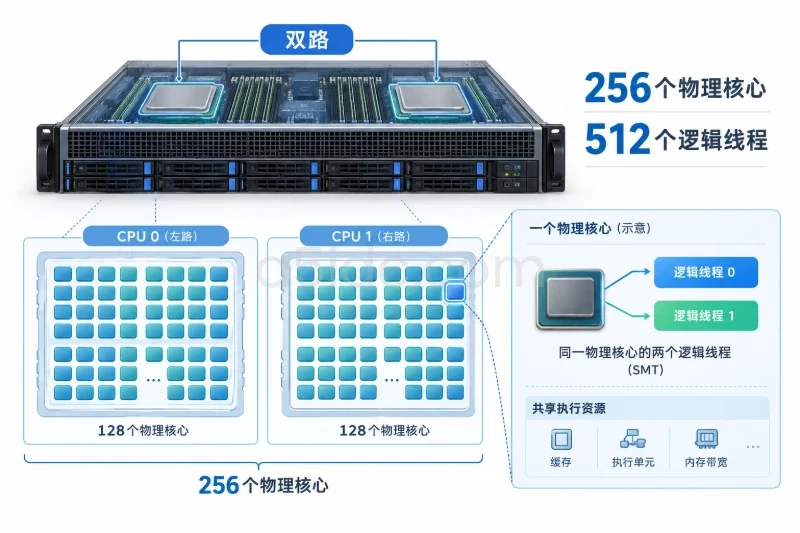
双路EPYC 9754在这里意味着两颗处理器合计提供256个物理核心,启用SMT后可呈现512个逻辑线程。512线程不是512个独立物理核心,也不代表性能可以在256核基础上再翻一倍。 同一物理核心上的两个逻辑线程会共享部分执行资源,收益取决于任务的指令特征、缓存命中率和内存访问行为。
判断业务适配性时,应先区分两类目标:
两者并不矛盾,但需要采用不同的测试口径。
| 业务类型 | 适配程度与成立条件 | 主要限制 |
|---|---|---|
| 批量编译、持续集成 | 较适合;存在多个独立项目、构建分支或测试任务 | 单次链接、磁盘小文件访问、每个作业的内存需求 |
| CPU渲染、离线图像处理 | 较适合;渲染器支持多线程,或能够按帧、按素材分发 | 场景内存、素材读取、GPU渲染路径是否更经济 |
| 参数扫描、蒙特卡洛模拟 | 较适合;样本间独立,单任务持续时间足够长 | 任务粒度过小、汇总阶段串行、许可证限制 |
| 数据清洗、批量ETL、日志处理 | 条件适合;数据可分片,处理阶段确实受CPU限制 | 存储吞吐、远端读取、数据倾斜和内存带宽 |
| 生物信息分析 | 条件适合;可按样本并行,算法和工具支持相应并发 | 单样本内存、临时文件量、工具自身线程上限 |
| 虚拟化、容器计算资源池 | 较适合;承载多个CPU密集型实例或作业 | 内存容量、资源隔离、超售比例、单机故障范围 |
| 在线交易、低延迟数据库 | 需要谨慎;应先验证延迟和锁竞争 | 单线程瓶颈、NUMA访问、存储延迟 |
| 大模型训练及高算力推理 | 通常不应仅凭CPU核心数选择 | GPU能力、显存、软件框架与计算精度要求 |
这个判断表的重点不是给业务贴上固定标签,而是确认它属于“能够用更多核心换取更多有效产出”,还是“瓶颈根本不在核心数量”。
高核心服务器最容易发挥作用的方式,是运行大量相互独立的中等规模任务,而不一定是让一个进程占用全部核心。
例如,一个计算程序单任务只能有效使用8个核心,但业务每天需要处理数百个样本,那么可以通过多个作业并行提高吞吐量。相反,如果一天只有一个任务,且主要计算路径是串行的,空闲核心就无法自动转化为速度。
串行部分还会限制单任务加速。按理想化的阿姆达尔定律计算,如果程序有95%的执行时间能够并行,其余5%必须串行,那么使用256个核心时,理论加速比约为:
理论加速比 = 1 ÷(0.05 + 0.95 ÷ 256)≈ 18.6倍。
这还没有计入线程同步、内存访问和调度开销。因此,不能把“256核”理解为同一任务必然比单核快256倍。对于可拆成独立作业的业务,更应该观察每小时完成量,而不是只盯着一个作业的加速比。
核心越多,允许同时运行的任务越多;如果内存没有同步增加,结果可能是任务排队、频繁回收缓存,甚至发生内存不足。
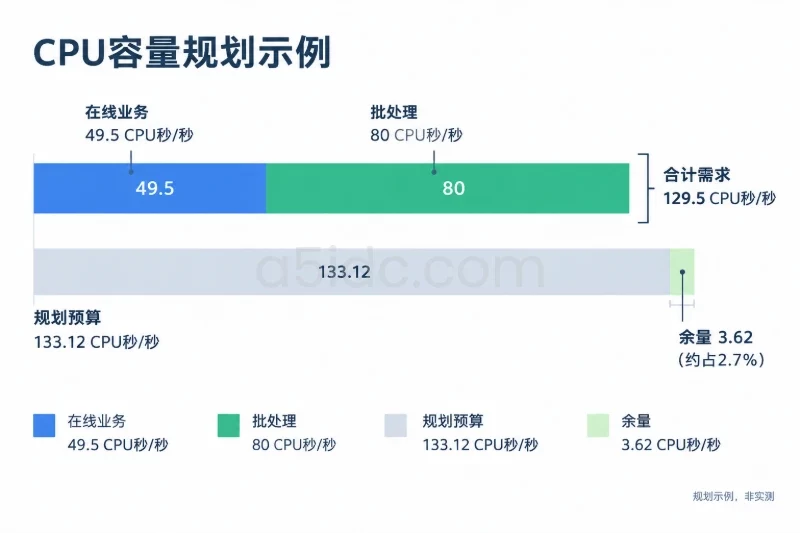
一个容量估算例子:计划同时运行64个计算作业,每个作业峰值占用6 GiB内存,那么作业内存合计为384 GiB。如果再为操作系统、文件缓存、调度服务及波动预留96 GiB,总需求约为480 GiB。在这一估算下,512 GiB配置的余量已经较小,还需要检查峰值是否同时出现,必要时考虑更大的内存容量。
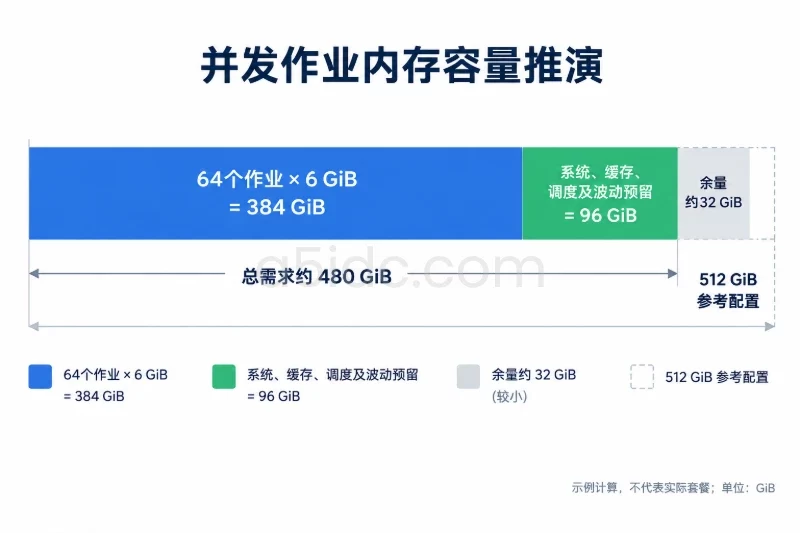
这里使用GiB口径,1 GiB等于2的30次方字节。上述数字只是容量推演,不代表A5数据某个套餐的实际内存配置。
此外,内存容量与内存带宽是两回事。同样的总容量,不同的内存通道填充方式可能影响数据供给能力。双路平台应核对两颗CPU的内存是否均衡配置、通道是否得到合理利用,而不是只看“总共多少内存”。
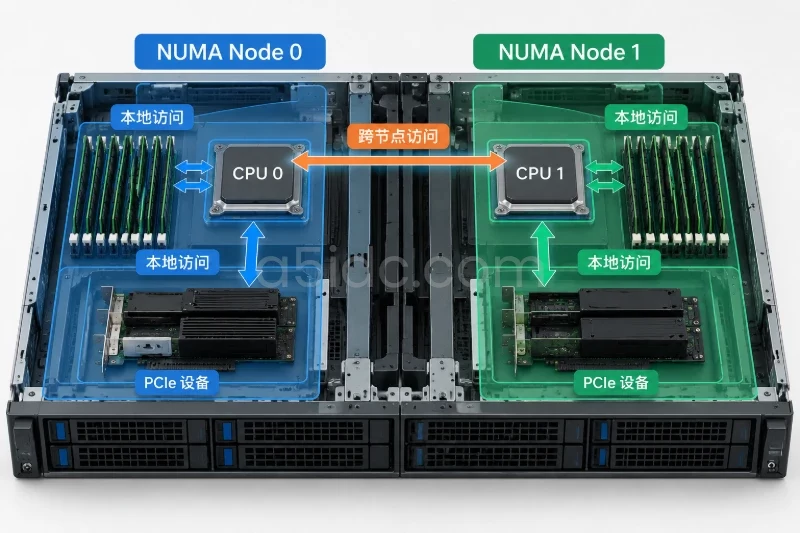
双路服务器不是所有核心访问所有内存都具有完全相同的成本。处理器访问另一颗处理器附近的内存,可能产生额外延迟和互连流量;实际NUMA节点数量还会受到平台设置影响。
对于独立作业,可以优先采用与NUMA节点相匹配的任务分组,使计算线程和主要数据尽量保持本地性。对于跨节点共享大块内存的程序,则需要通过实际测试判断:增加线程后,收益是否被远端访问、缓存一致性和同步开销抵消。
内存密集型任务不应默认把512个逻辑线程全部开满。 更稳妥的做法是比较不同并发级别下的完成时间、单位时间产出和内存压力,再决定是否启用更多SMT线程。
数据清洗、编译、日志解析等任务经常表现为CPU利用率不高,但业务处理仍然很慢。原因可能是大量小文件读取、共享存储响应慢,或者任务一直等待远端数据。
可以按瓶颈类型核对配置:
增加CPU核心无法解决输入数据供应不足的问题。
这类服务器适合构建量较大、项目较多,或需要运行大量自动化测试的研发平台。业务收益通常体现为减少作业排队时间、提高一天内能够完成的构建次数。
但一个编译任务的并行度并非越高越好。编译阶段可能有较好的并行能力,链接阶段却可能成为瓶颈;多个构建同时运行,也可能争抢同一块磁盘上的依赖包、源代码和缓存。
比较合理的安排,是分别测量单个构建在不同线程数下的耗时,再测试多个构建并行时的整体吞吐量。例如,对单作业比较16、32、64个执行线程,再决定整台服务器应运行多少个作业。不能直接给每个构建都设置512线程,否则容易出现内存膨胀和CPU争用。
验收指标应包括构建完成量、排队时间、失败率,以及并发构建下的峰值内存;仅有一次空载构建耗时,不足以判断容量。
当渲染引擎采用CPU计算,且项目可以拆分为大量独立帧时,高核心服务器具有较明确的用途。即使单帧无法充分利用全部核心,也可以同时处理不同帧,提高整批任务的完成速度。
需要特别核对场景内存。多个渲染进程可能分别加载场景、贴图和几何数据,内存占用不一定能充分共享。并发提高后,CPU还没满,内存就可能先到上限。
选型时也应比较CPU渲染与GPU渲染的实际路径。如果使用的渲染器、插件和场景已经适合GPU,GPU服务器可能更符合单位时间成本目标;如果依赖CPU插件、较大的内存空间或既有CPU工作流,双路EPYC平台才更值得评估。
适合的验收方式是使用真实代表场景,比较整批帧的完成时间、失败帧数量和每帧资源消耗,而不是只运行一个轻量演示场景。
参数扫描、蒙特卡洛模拟、组合搜索和部分优化任务,往往可以把输入拆成大量独立样本。这类工作负载容易通过任务队列分配到多个核心,适合集中式CPU计算节点。
一个任务粒度示例:每个样本占用1个核心、运行约10分钟,队列中持续有数千个样本待处理,那么单机可以维持较高的计算负载。若每个样本只运行几毫秒,却都需要单独启动进程和读取文件,调度开销就可能占据较大比例,应先考虑合并任务。
对于计算流体力学、有限元和大型矩阵求解,则不能仅按核心数量判断。不同求解器对内存带宽、通信、矩阵分解及许可证的依赖差异很大。单机双路可以避免跨服务器通信,但仍存在NUMA和线程同步开销;更大规模的问题也可能需要分布式系统。
此类业务应同时比较收敛后的总耗时、内存峰值与数值结果一致性,而不是只记录某个阶段的CPU占用率。
大量日志解析、文本转换、压缩与解压、规则匹配等CPU密集型步骤,可以通过文件分片或数据分区并行执行。生物信息分析中,也有不少流程适合按样本、批次或流程阶段并行调度。
不过,同一流程中的不同阶段可能需要不同资源:有的步骤受CPU限制,有的步骤主要消耗内存,还有的步骤大量读写临时文件。把每个阶段都设置为同样的线程数,通常不是合理方案。
例如,若某个阶段内存需求很高,应降低同时运行的样本数;另一个阶段只有轻量计算,则可以提高并发。临时文件还需要按并发量估算容量,并与最终结果、原始数据的保留空间分开考虑。
这类任务的验收应覆盖完整流程,包括数据读入、计算、结果写出和失败重试。只测其中一个CPU密集步骤,容易高估实际产能。
双路256核平台可以承载较多计算实例,适合内部研发环境、批处理执行器或CPU计算租户的集中资源池。
但vCPU数量不等于物理核心数量。不同虚拟化平台的资源映射方式有所区别,逻辑线程共享物理执行资源,分配出去的vCPU也可能同时争用CPU时间。若租户负载长期满载,激进超售会带来运行队列增长和延迟抖动。
对于持续计算任务,应根据CPU时间需求和隔离要求制定分配策略;对于低占用、间歇运行的环境,才有空间采用较高整合比。还要核对每个实例的内存、磁盘IO配额和NUMA布局。
整合的另一个代价是故障影响集中:一台服务器停止服务,可能同时影响多个实例。因此,关键业务仍需要异机副本、备份或可重新调度的计算节点。
面向批量计算、研发构建和容器资源池等场景,A5数据提供香港AMD EPYC物理服务器,产品覆盖单路与双路平台,可为多任务并行提供不同层级的CPU资源。香港系列也包含配备NVMe存储的方案,适用于编译产物、计算任务数据及业务文件的读写需求;结合香港、美国、日本等地区的服务器资源,A5数据可承载不同部署区域下的计算与业务服务。
香港节点是否合适,应从数据入口、结果出口和协作位置判断,而不是把地理位置直接等同于某种固定网络效果。
如果原始数据已经存放在香港,应用服务也位于香港,或者业务需要与当地及周边区域的系统协作,那么把计算节点放在同一区域,有机会减少跨区域搬运。离线任务还可以先完成数据上传,再在服务器本地计算,只将结果返回,降低计算过程对远端网络的依赖。
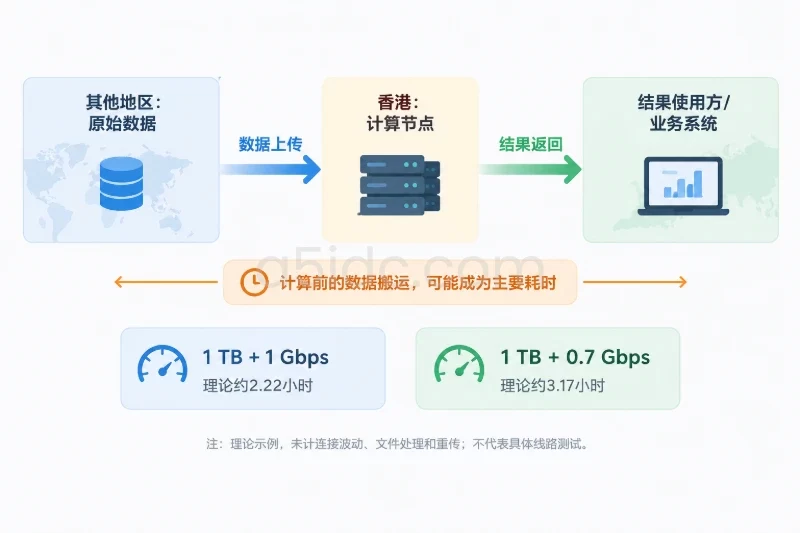
如果每天需要从其他地区传入大量原始数据,则应把传输时间计入任务窗口。以十进制1 TB数据、持续有效传输速率1 Gbps为例:
1 TB = 1000 GB;数据量换算为比特后为8000 Gb;理论传输时间为8000 Gb ÷ 1 Gb/s = 8000秒,约2.22小时。
如果端到端有效速率只有700 Mbps,即0.7 Gbps,同样的数据理论上需要约3.17小时。这里还未计入连接波动、文件处理和重传等额外耗时,也不代表任何具体线路的测试结果。
因此,计算只需一小时但数据每天要传三小时的业务,不能只按计算性能选型。应考虑增量传输、数据缓存、计算与存储同区域部署,或重新安排数据处理位置。
在线业务则更关注实际用户到香港节点的往返延迟和高峰表现。测试应覆盖目标用户所在地区、实际应用协议和业务时段;机房内部测速不能替代端到端访问验证。涉及个人信息、敏感数据或跨境处理时,还应先确认业务允许的存储地点和处理要求。
集中到一台服务器,可以减少跨服务器任务调度和部分数据传输,适合共享较大内存空间或统一管理的作业池。但多台服务器更容易分散故障影响,也能按节点逐步扩容。
| 比较维度 | 单台双路256核服务器 | 多台较小服务器 |
|---|---|---|
| 任务组织 | 适合单机多作业、共享数据和较大内存任务 | 适合独立分片和分布式队列 |
| 数据通信 | 主要涉及本机内存、存储及NUMA访问 | 需要考虑节点间网络与数据复制 |
| 扩容方式 | 受单机资源和配置空间限制 | 可以逐台增加节点 |
| 故障影响 | 故障域较集中 | 能否分散影响取决于调度和副本设计 |
| 软件许可 | 按核心授权时可能增加成本 | 按节点、实例或核心授权均需单独核算 |
| 适用目标 | 集中吞吐、减少节点管理 | 弹性扩展、分散风险、逐步增加容量 |
公平比较时,必须使用相同输入、相同质量要求和相近资源约束。例如,不能拿大内存配置与内存不足的小服务器比较,再把全部收益都归因于CPU核心数。
更有用的指标是单位有效任务成本:将某一统计周期内的服务器、存储、网络、软件许可和相关运维成本相加,再除以成功完成且满足质量要求的任务数量。
如果高核心服务器只在少量时段忙碌,其余时间长期闲置,月租模式下的利用率就会显著影响成本。反之,若任务队列充足,持续计算可以减少等待,较高的单机费用也可能被更多有效产出摊薄。
需要分别核对的费用包括:内存和存储配置差异、带宽及流量计费方式、备份空间、软件授权、故障期间的重算成本。尤其是按核心计费的商业软件,不能因为硬件核心数增加就默认整体方案更经济。
硬件规格确认回答“交付的是什么”,业务测试回答“它能否满足目标”。两者都需要,但不能相互替代。
建议按以下顺序验收:
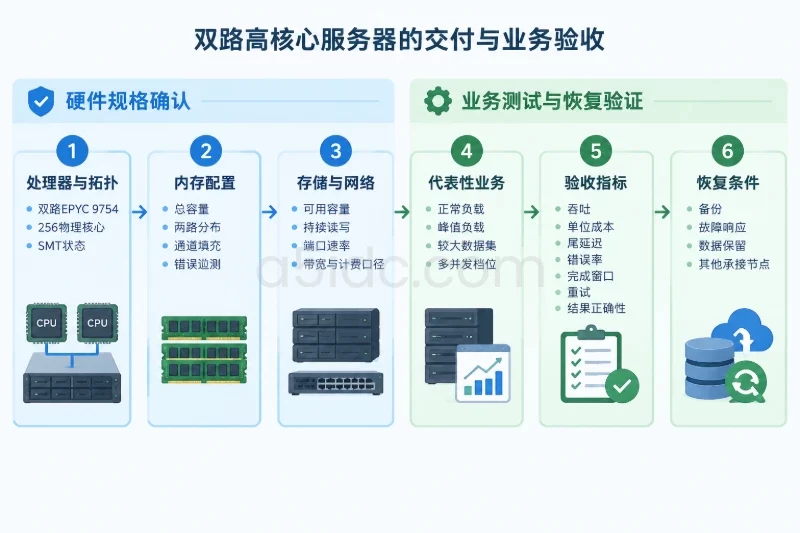
测试应使用可重放、脱敏或专用样本,避免让生产业务承担无控制的满载压测风险。
以下几类情况,不宜仅凭256核512线程选择这台服务器:
可执行的选择标准是:先用代表性任务测试不同并发级别,再看业务目标是否达成。对于A5数据这类双路EPYC 9754香港服务器,只有当任务队列足够、并发增加确实提高有效吞吐、内存与IO没有提前形成瓶颈、香港部署符合数据流向,而且单位任务成本可接受时,高核心配置才有明确价值。
如果测试显示吞吐量仍随并发增长,可以继续评估更高并发;如果产出已经停滞,应定位内存、存储、线程同步或网络限制,而不是继续增加线程。最终应把采购条件写成可验收的业务目标,例如“在约定数据规模和结果质量下,规定时间内完成多少作业”,而不是只写“CPU达到512线程”。