香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


AI推理选用美国 GPU 服务器时,难点并不只是判断模型能否装入显存。模型权重占用、上下文长度、并发请求数、首字延迟和输出吞吐会同时争夺 GPU 资源。单卡显存足够运行模型,不代表它能在目标并发下保持可接受的响应速度;反过来,盲目增加 GPU 数量,也可能因为跨卡通信、闲置资源和跨区域网络延迟造成浪费。
实际选型可以先采用这一判断框架:显存容量至少覆盖“模型权重 + KV Cache + 推理框架开销 + 安全余量”,再用目标并发和性能指标验证 GPU 算力是否足够。7B~8B 级量化模型、低并发接口通常可以从 24GB 显存档位开始评估;14B 级模型或更长上下文更适合考察 48GB;30B~34B 级量化模型、70B 级量化模型或高并发服务,则需要重点比较 80GB 及以上单卡和多卡方案。具体结果仍取决于量化格式、模型结构、推理框架和业务负载。
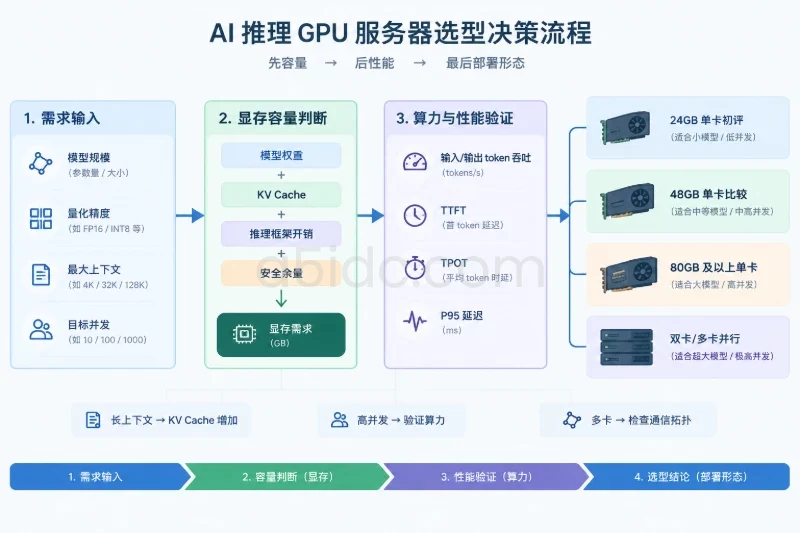
企业技术负责人在询价前,应先固定以下信息:
同一个参数规模的模型,实际显存占用可能并不相同。GQA、MoE、视觉编码器、量化元数据和推理框架的内存管理策略都会影响结果。因此,不能只拿“模型是 14B”或“模型是 70B”作为唯一采购依据。
“并发 100”并不是完整的性能需求。至少要把它拆成以下三类指标:
交互式应用还需要区分:
例如,20 个并发会话,每个会话要求持续生成约 15 token/s,理论上就需要约 300 token/s 的聚合输出能力。但真实系统中,随着并发提高,单会话输出速度通常会下降,输入预填充和输出解码也会争用 GPU,因此这个数值只能作为负载目标,不能直接当作采购承诺。
如果业务已知平均服务时间,可以用简单的排队估算辅助判断:
活跃并发数 ≈ 每秒请求数 × 平均服务时间
例如平均每秒进入 2 个请求,平均服务时间约 5 秒,平均活跃请求数约为 10。若请求存在明显突发,仍需根据峰值 RPS、P95 服务时间和排队上限增加余量。
美国 GPU 服务器是否合适,还取决于用户和数据所在位置:
美国区域适合的前提,通常是用户分布、数据合规要求和数据源位置都能接受美国境内或跨境访问。服务器位于美国,并不会自动满足某项数据驻留或合规要求。
可以先用以下方式估算权重的理论存储量:
权重显存 ≈ 参数量 × 每个参数占用的字节数
常用精度的理论占用如下:
| 精度 | 每个参数的理论字节数 | 7B 模型权重约值 | 70B 模型权重约值 |
|---|---|---|---|
| FP16/BF16 | 2 字节 | 14 GB,约 13.0 GiB | 140 GB,约 130.4 GiB |
| INT8 | 1 字节 | 7 GB,约 6.5 GiB | 70 GB,约 65.2 GiB |
| INT4 | 0.5 字节 | 3.5 GB,约 3.3 GiB | 35 GB,约 32.6 GiB |
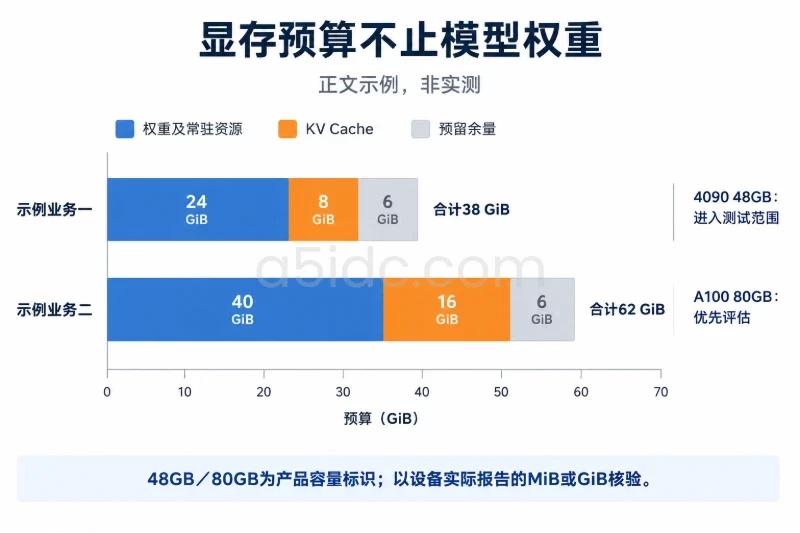
表中 GB 按十进制计算,GiB 按 1 GiB = 1024³ 字节计算。实际加载时还要考虑量化比例、缩放参数、张量对齐、权重格式、运行时缓冲区和框架开销。例如,70B INT4 模型的理论权重约为 35 GB,但实际运行可能需要 38~45 GiB 甚至更多;如果再叠加较长上下文,48GB 显存就可能缺少余量。
因此,24GB 显存能够装下某个 7B INT4 模型,不等于适合运行 7B FP16,也不等于能够支撑几十个长上下文并发请求。
大语言模型推理时,每个请求都会产生 KV Cache,用于保存已经处理过的上下文状态。KV Cache 通常与以下因素相关:
一个简化的估算方式是:
KV Cache 字节数 ≈ 2 × 层数 × KV Head 数 × Head 维度 × 每元素字节数 × 缓存 token 数
其中“2”代表 Key 和 Value 两部分。以一个示例模型为例,假设有 32 层、8 个 KV Head、每个 Head 维度为 128,KV 使用 FP16,每个会话缓存 4096 个 token:
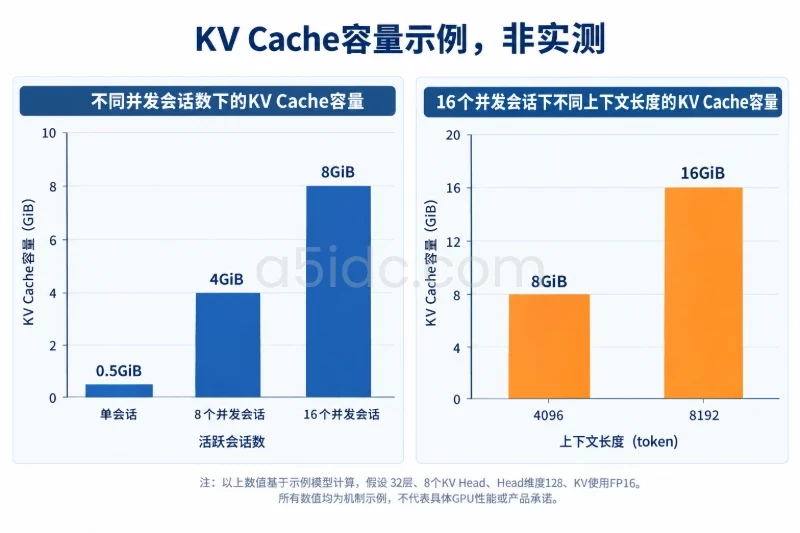
这只是用于理解机制的示例,实际模型的 GQA、MQA、层数和 KV 精度不同,结果会变化。更重要的是,并发请求数量本身还不够,应该计算所有活跃请求当前占用的 token 总量。16 个短请求和 16 个长上下文请求,显存压力可能完全不同。
启用分页式 KV Cache可以降低内存碎片、提高显存利用率,但不会消除 KV Cache 的基本容量需求。将最大上下文长度设置得过高,也可能让运行时预留更多空间,导致实际可用并发下降。
GPU 显存通常还需要承担以下开销:
规划时,可以先把显存的 10%~20% 作为试运行余量,再通过实际压测调整。对于长上下文、高并发或多模态模型,应留出更宽裕的空间。若模型刚好填满显存,短时间单请求测试可能通过,但在并发增加、输入变长或框架版本变化后容易出现 OOM。
显存解决的是“能不能放下”和“能同时保留多少上下文”,GPU 算力解决的是“能多快处理”。常见的两种不平衡包括:
输入较长时,预填充阶段的计算压力明显;输出较长或并发较高时,解码阶段的调度和显存带宽更加关键。采购时应分别记录输入 token 吞吐和输出 token 吞吐,而不是只看一个综合 TPS。
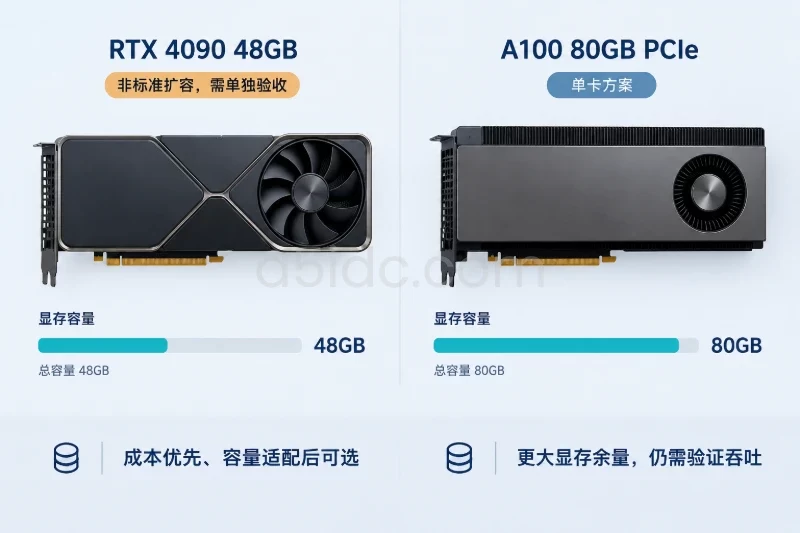
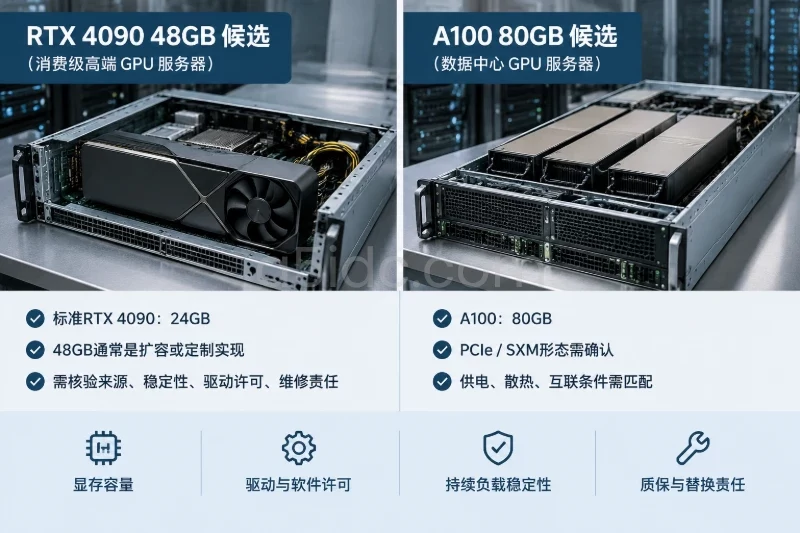
把显存与算力需求分别确定后,可以将候选档位对应到具体硬件。A5数据的美国GPU系列提供A100 80GB及RTX 4090等显卡选项:若容量估算已指向80GB档位,可先考察A100 80GB配置;若模型显存需求较小,也可将RTX 4090列入比较,但不能仅凭“模型能加载”判断其满足目标吞吐。这些是可询价的硬件选项,下面的参考配置则用于统一比较口径,并非具体在售套餐。
下面的配置是用于初筛的容量档位,不对应某个具体在售产品、价格或库存。表中的 CPU、内存和 NVMe 也需要根据框架和业务调整。
| 参考档位 | GPU显存 | 配套资源参考 | 更适合的场景 | 主要边界 |
|---|---|---|---|---|
| 单卡入门档 | 24GB | 8~16 vCPU、64GB内存、500GB~1TB NVMe | Embedding、重排、7B~8B量化模型、低并发问答 | 7B FP16长上下文、14B FP16和高并发场景余量有限 |
| 单卡中档 | 48GB | 16~32 vCPU、128GB内存、1TB以上NVMe | 7B~8B FP16、14B量化、部分30B级量化服务 | 70B量化、高并发长上下文可能受KV Cache限制 |
| 单卡大显存档 | 80~96GB | 32~64 vCPU、128~256GB内存、1~2TB NVMe | 14B FP16、30B级模型、部分70B量化推理 | 高并发时仍要验证算力,无法自动替代多卡 |
| 双大显存卡 | 2×80GB级 | 32~64 vCPU、256GB以上内存、2TB以上NVMe | 70B级FP16或更高并发服务 | 依赖张量并行、通信拓扑和框架支持,扩展不一定线性 |
| 四卡及以上 | 4×80GB级或更高 | 64 vCPU以上、256~512GB内存 | 大模型、多租户或多个高负载服务 | 成本、功耗、调度和故障影响范围明显增加 |
“2×80GB”不应简单理解为一张160GB显存的 GPU。模型是否能跨卡切分,取决于推理框架、张量并行策略、卡间互联、PCIe 拓扑和算子支持。如果两张卡之间只有普通 PCIe 连接,通信等待可能使延迟和吞吐不如预期;即使使用高速互联,性能也不会必然按照 GPU 数量线性增加。
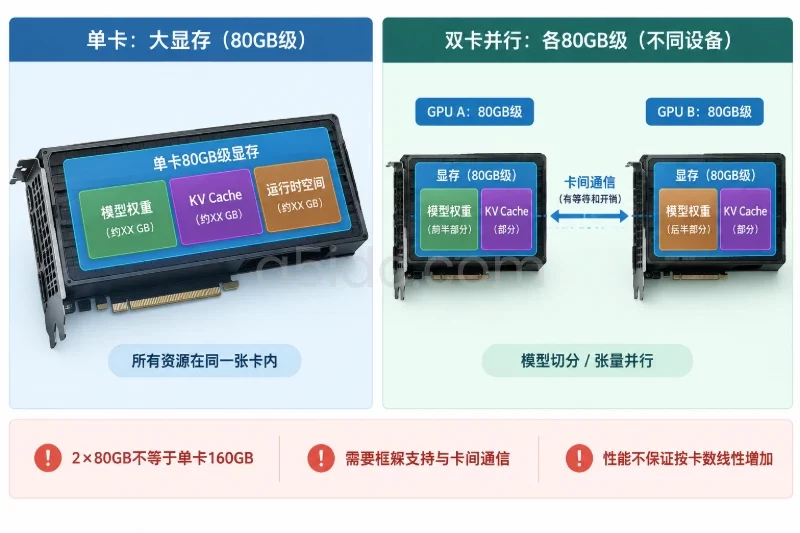
单卡方案更适合以下条件:
单卡的好处是调度路径短,模型加载、监控和故障定位相对简单。对于 7B~14B 级模型,先寻找合适的单卡档位,往往比直接上多卡更容易验证真实需求。
多卡方案更适合以下条件:
如果只是为了把多个低负载模型放在同一台服务器上,多卡并不一定是唯一选择。多实例部署、GPU 分区或多台单卡服务器可能更利于隔离和弹性,但会增加模型副本、存储和调度成本。GPU 分区还可能限制单个实例可使用的显存和计算资源,需要确认推理框架是否支持。
INT8、INT4 等量化可以显著降低权重占用,使较大模型进入较小显存档位,但需要同时评估:
如果业务是分类、抽取或固定格式生成,量化带来的效果变化可能比较容易评估;如果业务依赖复杂推理、长文本生成或代码质量,则应使用真实样本进行离线评测,不宜只按显存节省幅度做决定。
美国 GPU 服务器还可按交付形态比较:
比较报价时,应把 GPU、CPU、内存、系统盘、模型盘、出口流量、快照、IP、管理费用和最低计费周期放在同一张成本表中。简单比较“每张 GPU 的价格”容易遗漏整机和网络成本。
适用特征包括:
这类业务可以先从 24GB 单卡档位开始,重点验证实际输出速度、显存余量和模型质量。如果测试发现单请求已经接近显存上限,应优先调整精度、上下文上限或升级到 48GB,而不是直接增加并发。
不适合的情况是:要求多个长上下文会话同时流式输出,或者要求持续的低延迟服务。此时即使模型能够加载,KV Cache 和解码算力也可能成为瓶颈。
典型场景包括知识库问答、客服辅助、企业搜索和代码助手。此类业务一般需要同时关注:
14B 级量化模型可以考察 48GB 档位,14B FP16 或更长上下文则应重点比较 80GB 档位。若希望同时运行 Embedding、重排和主模型,应核算它们是否共享同一张 GPU,避免主模型推理受到辅助模型抢占。
70B 级模型、长上下文、复杂多模态输入和高峰流量,通常需要在以下方向中取舍:
如果业务要求低延迟且流量持续稳定,多副本可能比单个超大多卡实例更容易进行容量管理;如果模型无法装入单卡,则必须接受多卡并行的通信成本。最终应以真实模型、真实上下文和真实请求比例压测,而不是只按显存总和估算。
以下条件出现时,应谨慎使用美国 GPU 服务器,或者至少先做区域对比:
美国区域仍可能适合离线批处理、内部研发、北美用户服务或对实时性要求不高的异步任务,但应在业务指标允许的范围内使用。
在购买或租用前,形成一份不可含糊的测试矩阵,至少包含:
| 项目 | 建议记录内容 |
|---|---|
| 模型 | 模型版本、参数规模、权重格式、量化方式 |
| 输入 | 平均输入 token、峰值输入 token、最大上下文 |
| 输出 | 平均输出 token、最大输出 token、是否流式 |
| 并发 | 平均并发、峰值并发、峰值持续时间 |
| 性能 | P50/P95 TTFT、P95 TPOT、输入和输出 token 吞吐 |
| 稳定性 | OOM次数、请求错误率、排队长度、显存水位 |
| 业务质量 | 准确率、格式遵循率、拒答或幻觉相关指标 |
| 区域网络 | 代表用户所在地的延迟、抖动、丢包和跨区访问情况 |
不要只做单请求测试。至少应覆盖单请求、目标并发、峰值并发和峰值加余量四个阶段,并分别测试短上下文与长上下文。
交付时应确认实际 GPU 型号、显存容量、驱动版本、GPU 数量和拓扑关系。在 Linux 主机上,可以使用以下只读命令查看基础信息:
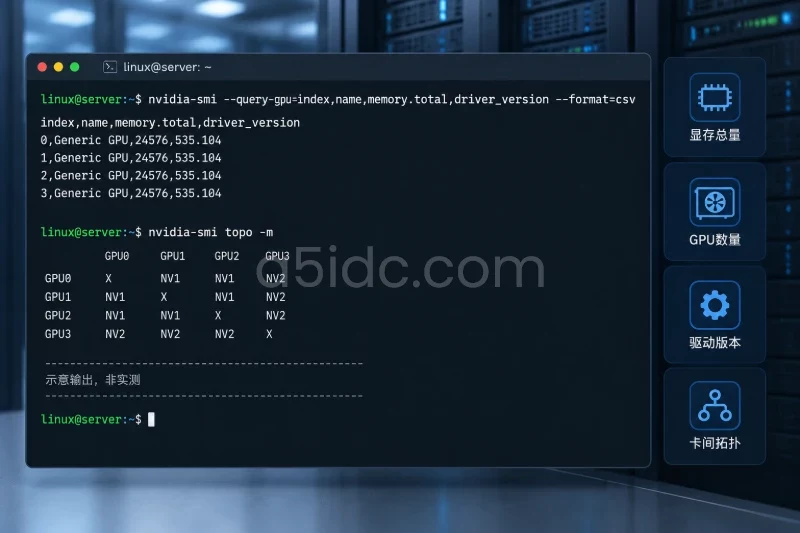
nvidia-smi --query-gpu=index,name,memory.total,driver_version --format=csv
nvidia-smi topo -m
命令适用于已安装 NVIDIA 驱动的 Linux 主机。核对重点包括:
若硬件批次、驱动或固件发生变化,应重新执行关键压测,不应默认不同批次的性能和拓扑完全一致。
模型文件较大时,存储与网络会影响扩容速度。例如,40 GB 的模型文件通过理想的 1 Gbps 链路传输:
实际还会受到协议开销、磁盘写入、对象存储读取、校验和并发下载限制影响。模型冷启动、容器拉取、权重加载和 GPU 初始化应分别计时。若业务需要快速扩容,应考虑本地 NVMe 缓存、预加载模型或保持热实例,并把相关存储与流量费用计入成本。
不要只看“端口为 1Gbps 或 10Gbps”。需要从实际用户区域和业务数据源测试:
对于短文本 API,网络带宽可能不是主要瓶颈;对于多模态推理、文档解析和大规模 RAG,输入数据传输可能显著影响整体时延。
服务条款中应明确以下内容:
这里的“保证”应以合同约定为准,不能只依据销售页面的规格摘要。
如果采用量化、框架升级或多卡并行,应在上线前保留可回滚版本:
涉及删除旧模型、清理磁盘或覆盖配置时,应先确认备份完整、影响范围明确,并保留回滚副本,避免为了释放存储而破坏正在使用的版本。