香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


香港节点运行 Ubuntu 26.04 时,CN2 GIA 线路的 TCP 调优重点不是“把某个参数调到最大”,而是让拥塞控制、队列调度、连接复用和应用层响应策略相互匹配。BBR 与 fq 在内核支持且业务特征合适时,可以改善高延迟链路上的建立速度和吞吐稳定性;但它们不能改变运营商路由,也不能弥补线路丢包、MTU异常或上游服务响应过慢。
面向跨境电商 Web 服务,更应将 TCP 参数与 Nginx 的 Keepalive、静态资源缓存、Gzip 压缩、反向代理缓冲和超时策略一起调整。下面以已有 Web 服务的 Ubuntu 26.04 香港节点为例,按照“先采集、再变更、逐项验证、保留回滚”的顺序执行。配置中的域名、端口、上游地址和带宽均为示例,需要替换为实际环境值。
本文配置适用于以下常见架构:
127.0.0.1:8080,也可能位于内网或其他服务器。TCP 参数只作用于本机连接栈。以下问题不能单靠 sysctl 解决:
需要具备 sudo 权限。修改 sysctl 会影响后续建立的 TCP 连接,修改 Nginx 配置会影响新的请求分发,建议在低峰期执行。
开始前确认当前环境:
. /etc/os-release
printf 'OS: %s %s\n' "$NAME" "$VERSION_ID"
uname -a
nginx -v 2>&1 || true
systemctl is-active nginx || true
ip route show default
示例输出仅用于说明判断方式,不代表某台实际服务器的执行记录:
OS: Ubuntu 26.04
Linux hk-web-01 6.x.x-generic x86_64 GNU/Linux
nginx version: nginx/1.2x.x
active
default via 192.0.2.1 dev eth0 proto dhcp
如果输出的系统版本、内核版本或 Nginx 版本与预期不一致,应先确认当前连接到的是目标服务器。不要直接套用其他 Ubuntu 版本的内核模块或第三方内核参数。
以下操作会备份 Nginx 配置、sysctl 配置和当前内核参数。备份目录仅保存到本机 /root,请根据安全策略另行复制到受控位置。
STAMP=$(date +%F-%H%M%S)
BACKUP="/root/a5idc-tcp-tune-${STAMP}"

sudo install -d -m 0700 "$BACKUP"
sudo cp -a /etc/nginx "$BACKUP/nginx"
sudo cp -a /etc/sysctl.d "$BACKUP/sysctl.d"
sudo sysctl -a 2>/dev/null | sort | sudo tee "$BACKUP/sysctl-before.txt" >/dev/null
sudo nginx -T > "$BACKUP/nginx-T-before.txt" 2>&1 || true

printf 'Backup directory: %s\n' "$BACKUP"
备份目录路径要记录下来,后续回滚会用到。覆盖 /etc/nginx 或 /etc/sysctl.d 前没有备份时,不建议继续操作。
准备一个实际访问地址。为了避免把后台管理页、登录接口或带敏感参数的 URL 写入历史命令,可以使用测试页面:
URL="https://shop.example.com/"
连续采集几次基础数据:
for i in $(seq 1 5); do
    curl -L -sS -o /dev/null \
      --connect-timeout 5 \
      --max-time 30 \
      -w "run=$i remote=%{remote_ip} http=%{http_code} dns=%{time_namelookup}s connect=%{time_connect}s tls=%{time_appconnect}s ttfb=%{time_starttransfer}s total=%{time_total}s size=%{size_download}B speed=%{speed_download}B/s\n" \
      "$URL"
done
重点记录以下字段:
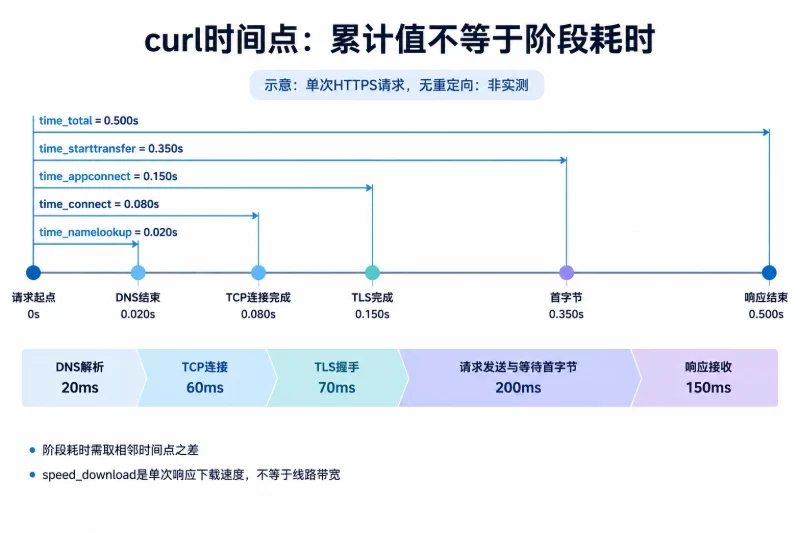
time_connect:TCP 连接建立耗时。time_appconnect:HTTPS 场景下包含 TLS 握手的时间点。time_starttransfer:收到首字节的时间,通常受到上游处理、缓存和压缩影响。time_total:完整响应耗时。speed_download:单次下载速度,不能等同于线路带宽。如果首页由动态应用生成,time_starttransfer 可能主要反映应用和数据库性能,而不是 TCP 参数。
检查当前连接与套接字概况:
ss -s
ss -lntp | grep -E ':(80|443)\b' || true
示例中的 LISTEN 行可用于观察监听队列:
LISTEN 0 511 0.0.0.0:443 0.0.0.0:* users:(("nginx",pid=1234,fd=8))
Recv-Q 长时间接近监听队列上限,才可能说明连接接收存在压力。不能仅凭某一次输出就提高所有队列参数。
先确认业务出口接口:
IFACE=$(ip -o route show default | awk 'NR==1 {print $5}')
printf 'Default interface: %s\n' "$IFACE"
tc qdisc show dev "$IFACE"
查看到测试目标的路由选择:
TARGET="www.example.com"
TARGET_IP=$(getent ahostsv4 "$TARGET" | awk 'NR==1 {print $1}')
printf 'Target IPv4: %s\n' "$TARGET_IP"
ip route get "$TARGET_IP"
ip route get 只能说明本机选择了哪个下一跳和出口,不能证明整条路径就是 CN2 GIA。要判断线路质量,应在香港节点、实际用户侧网络和必要的其他对照节点分别测试。
如果系统已经安装 mtr,可以进行一轮低频采样:
mtr -rwzc 100 -i 0.2 "$TARGET"
路径中的某一跳显示丢包,不一定代表最终业务丢包。部分路由器会限制 ICMP 响应,而继续转发后续流量。应重点观察最终目标的丢包、延迟波动,以及 TCP 业务本身的重传情况。
还可以检查路径 MTU:
tracepath -n "$TARGET"
如果发现 PMTU 明显低于预期,或者 TCP 业务出现规律性卡顿,应优先核查隧道、负载均衡器、云网络和出口设备,不要直接把所有 TCP 参数调大。
Ubuntu 26.04 的具体内核配置可能随镜像、云厂商内核和安装批次变化,先查看实际支持项:
sysctl net.ipv4.tcp_available_congestion_control
sysctl net.ipv4.tcp_congestion_control
sysctl net.core.default_qdisc
可能看到类似结果:
net.ipv4.tcp_available_congestion_control = reno cubic bbr
net.ipv4.tcp_congestion_control = cubic
net.core.default_qdisc = fq_codel
确认 BBR 模块是否可加载:
sudo modprobe tcp_bbr
printf 'tcp_bbr module status: '
if [ -d /sys/module/tcp_bbr ]; then
    echo loaded
else
    echo unavailable
fi
确认 fq 是否可用:
sudo modprobe sch_fq
printf 'sch_fq module status: '
if [ -d /sys/module/sch_fq ]; then
    echo loaded
else
    echo unavailable
fi
如果 modprobe 失败,或者 bbr 不在 tcp_available_congestion_control 中,不要下载第三方内核模块强行启用。保持系统默认的 cubic,先从连接复用、缓存和上游响应方向优化。
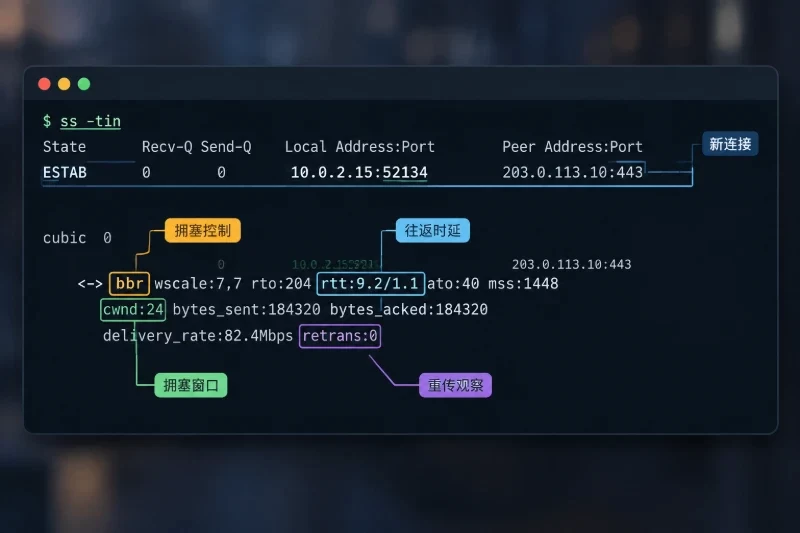
BBR根据带宽和往返延迟估计发送速率,不完全依赖丢包来降速。在跨境访问存在较高 RTT、带宽较大且队列容易积压的情况下,可能比默认算法更适合长连接和大文件传输。
但以下场景不应直接认为 BBR 会带来收益:
切换后只影响新建立的 TCP 连接,已经存在的连接通常不会立即改变拥塞控制状态。因此验证时应等待旧连接自然结束,或使用新的测试请求。
以下配置偏向 Web 入口服务器,目标是改善连接队列、保活探测和新连接调度,不会固定每条连接使用大内存。
写入前已经完成备份。该命令会覆盖同名文件,适用范围仅为 /etc/sysctl.d/99-a5idc-web-tcp.conf:
sudo tee /etc/sysctl.d/99-a5idc-web-tcp.conf >/dev/null <<'EOF'
# Use fq for newly created network queues when the kernel supports it.
net.core.default_qdisc = fq

# Queue limits for bursty Web connection arrivals.
net.core.somaxconn = 4096
net.ipv4.tcp_max_syn_backlog = 4096

# Keep SYN cookies enabled as a protection mechanism.
net.ipv4.tcp_syncookies = 1

# TCP keepalive probes for idle long-lived connections.
net.ipv4.tcp_keepalive_time = 600
net.ipv4.tcp_keepalive_intvl = 30
net.ipv4.tcp_keepalive_probes = 5
EOF
这些参数的作用和风险如下:
| 参数 | 作用 | 适用边界 |
|---|---|---|
net.core.default_qdisc | 设置新建网络设备队列的默认调度器 | fq 不可用时应保留现有调度器 |
net.core.somaxconn | 限制应用监听队列上限 | 必须结合 Nginx 的监听参数和进程处理能力 |
tcp_max_syn_backlog | 设置尚未完成握手的连接队列上限 | 只提高上限不能解决丢包或 CPU 忙 |
tcp_syncookies | 在 SYN 队列压力较大时提供保护 | 不应为了追求速度关闭 |
tcp_keepalive_* | 清理失效的长时间空闲连接 | 过短可能误判慢客户端或长轮询连接 |
tcp_fin_timeout、tcp_tw_reuse、tcp_max_tw_buckets 等参数不建议作为常规优化项。它们会改变连接回收和端口复用行为,不能用来替代连接池或正确的 Keepalive 配置。
先确认 fq 已经可用。如果前面的 modprobe sch_fq 失败,删除配置中的 net.core.default_qdisc = fq 行,保留系统现有队列调度器:
if [ -d /sys/module/sch_fq ]; then
    echo "sch_fq is available"
else
    echo "sch_fq is not available; remove the fq line before applying"
fi
检查是否存在其他文件覆盖同名参数:
grep -RInE 'default_qdisc|somaxconn|tcp_max_syn_backlog|tcp_syncookies|tcp_keepalive_' \
  /etc/sysctl.conf /etc/sysctl.d 2>/dev/null || true
应用单个文件:
sudo sysctl -p /etc/sysctl.d/99-a5idc-web-tcp.conf
验证结果:
sysctl net.core.default_qdisc
sysctl net.core.somaxconn
sysctl net.ipv4.tcp_max_syn_backlog
sysctl net.ipv4.tcp_syncookies
sysctl net.ipv4.tcp_keepalive_time
如果出现 cannot stat、Invalid argument 或 permission denied,不要继续叠加其他参数。先根据报错确认内核支持情况和配置文件权限。
只有当 bbr 已出现在可用列表,并且模块能够加载时,才执行以下步骤:
AVAILABLE=$(sysctl -n net.ipv4.tcp_available_congestion_control)

if printf '%s\n' "$AVAILABLE" | tr ' ' '\n' | grep -qx bbr; then
    sudo modprobe tcp_bbr
    sudo sysctl -w net.ipv4.tcp_congestion_control=bbr

    if [ -d /sys/module/tcp_bbr ]; then
        printf '%s\n' tcp_bbr | sudo tee /etc/modules-load.d/a5idc-tcp-bbr.conf >/dev/null
    fi
else
    echo "BBR is not available; keep the current congestion control."
fi
验证:
sysctl net.ipv4.tcp_available_congestion_control
sysctl net.ipv4.tcp_congestion_control
预期是当前值为:
net.ipv4.tcp_congestion_control = bbr
如果切换失败,保留原有算法即可。不要把 net.ipv4.tcp_congestion_control = bbr 写入持久化文件后反复执行 sysctl --system,否则每次启动都会产生错误。
如果希望让 fq 和 BBR 在重启后仍然可用,可以在模块确认成功后创建加载文件:
if [ -d /sys/module/sch_fq ]; then
    printf '%s\n' sch_fq | sudo tee /etc/modules-load.d/a5idc-sch-fq.conf >/dev/null
fi
Linux TCP 自动调优通常已经能够覆盖普通 Web 业务。只有在链路带宽较高、RTT 较大、单连接需要持续传输大对象时,才需要根据带宽时延积评估缓冲区。
估算公式:
BDP(KB)≈ 链路速率(Mbps)× RTT(ms)÷ 8
例如,假设单方向速率为 500 Mbps,RTT 为 80 ms:
500 × 80 ÷ 8 = 5000 KB
5000 KB ÷ 1024 ≈ 4.88 MiB
这里的 500 Mbps 是兆比特每秒,5,000 KB 是近似十进制千字节;换算成二进制 MiB 时除以 1024。不要把 500 Mbps 误写成 500 MB/s。
查看当前自动调优范围:
sysctl net.ipv4.tcp_rmem
sysctl net.ipv4.tcp_wmem
sysctl net.core.rmem_max
sysctl net.core.wmem_max
只有在基线测试确认单连接吞吐受窗口限制,并且服务器有足够内存时,才考虑以下示例值:
sudo tee /etc/sysctl.d/99-a5idc-tcp-buffers.conf >/dev/null <<'EOF'
net.core.rmem_max = 33554432
net.core.wmem_max = 33554432
net.ipv4.tcp_rmem = 4096 131072 33554432
net.ipv4.tcp_wmem = 4096 16384 33554432
EOF

sudo sysctl -p /etc/sysctl.d/99-a5idc-tcp-buffers.conf
这里的 33554432 是 32 MiB 的字节数。它是自动调优允许达到的上限,并不代表每条连接启动时都会分配 32 MiB。连接数很多时,实际内存仍可能明显增加,应同步观察:
free -h
ss -s
vmstat 1 5
如果出现内存回收、Swap 使用、OOM 日志或连接数上升后响应变慢,应立即删除该可选配置并恢复原值。
TCP 参数只能改善传输层行为。电商网站常见的首屏慢、静态资源重复下载和接口连接占用,通常还需要调整 Nginx。
先查看 Nginx 是否加载 /etc/nginx/conf.d/*.conf:
sudo nginx -T 2>/dev/null | grep -E 'include .*(conf\.d|sites-enabled)' | head -20
如果输出中存在:
include /etc/nginx/conf.d/*.conf;
且该指令位于 http {} 内,可以将通用 HTTP 配置放入 /etc/nginx/conf.d/。如果没有,应把配置合并到实际的 http {} 区域,不要盲目创建文件。
以下配置适合放在 http {} 上下文。open_file_cache 缓存的是文件描述信息、大小和修改时间,不是完整 HTTP 响应,也不等同于 CDN 或 Nginx 代理缓存。
sendfile on;
tcp_nopush on;
tcp_nodelay on;

keepalive_timeout 15s;
keepalive_requests 1000;

open_file_cache max=10000 inactive=60s;
open_file_cache_valid 120s;
open_file_cache_min_uses 2;
open_file_cache_errors on;
参数关系如下:
sendfile on:减少静态文件从磁盘到用户态再回内核的复制。tcp_nopush on:配合 sendfile,减少静态响应中小包数量。tcp_nodelay on:减少交互式请求等待,适合动态响应和 Keepalive 连接。keepalive_timeout:客户端空闲连接保持时间。设置过长会占用连接和文件描述符,设置过短会增加握手次数。keepalive_requests:单条 Keepalive 连接允许承载的请求数。open_file_cache:适合静态文件较多且重复访问明显的站点。如果服务器内存较小、静态文件很少,可以把 max=10000 调整为 max=1000 或暂时不启用文件元数据缓存。
HTML、CSS、JavaScript、JSON、XML 和 SVG 通常适合压缩;JPEG、PNG、WebP、视频、ZIP 等已经压缩的文件不应重复压缩。
gzip on;
gzip_comp_level 5;
gzip_min_length 1024;
gzip_vary on;
gzip_proxied any;

gzip_types
    text/plain
    text/css
    text/xml
    application/javascript
    application/json
    application/xml
    application/rss+xml
    image/svg+xml;
gzip_comp_level 5 是 CPU 和压缩率之间的示例取值。若 CPU 已经接近使用上限,可以先降到 3;若响应体很小,压缩带来的收益也可能不明显。
不要对全部响应统一添加 Content-Encoding: gzip,Nginx 会根据客户端的 Accept-Encoding 自动协商。压缩后应检查响应头:
curl -sS -D - -o /dev/null \
  -H 'Accept-Encoding: gzip' \
  "$URL" | grep -iE 'HTTP/|content-encoding|vary|content-length'
示例结果:
HTTP/2 200
content-encoding: gzip
vary: Accept-Encoding
只有文件名包含内容哈希或版本号时,才适合使用较长时间和 immutable。例如 app.8f31c2.js、main-202604.css。
location ~* \.(?:css|js|mjs|svg|ico|woff2?)$ {
    expires 7d;
    add_header Cache-Control "public, max-age=604800, immutable";
}
如果静态文件名不会随内容变化,不要使用 immutable,否则发布新版本后,客户端可能继续使用旧资源。可以改为:
location ~* \.(?:css|js|mjs|svg|ico|woff2?)$ {
    expires 1h;
    add_header Cache-Control "public, max-age=3600";
}
商品价格、库存、购物车、登录状态和结算接口不要套用静态资源缓存规则。对动态页面应根据业务决定是否使用 no-cache、短时间缓存或带用户维度的缓存。
以下内容应合并到现有的 API 或应用 location 中,不要直接覆盖原有的路由、鉴权和请求头配置:
location /api/ {
    proxy_pass http://app_backend;

    proxy_http_version 1.1;
    proxy_set_header Connection "";
    proxy_set_header Host $host;
    proxy_set_header X-Real-IP $remote_addr;
    proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    proxy_set_header X-Forwarded-Proto $scheme;

    proxy_connect_timeout 5s;
    proxy_send_timeout 30s;
    proxy_read_timeout 30s;

    proxy_buffering on;
    proxy_buffer_size 8k;
    proxy_buffers 8 16k;
    proxy_busy_buffers_size 24k;
}
如果上游使用 Nginx 的 upstream 连接池,还可以在现有上游定义中评估:
upstream app_backend {
    server 127.0.0.1:8080;
    keepalive 32;
}
keepalive 32 不是固定推荐值,需要根据应用线程数、并发量和上游数据库连接数调整。连接池过大可能把压力从 Nginx 转移到应用或数据库。
几个超时参数容易被误解:
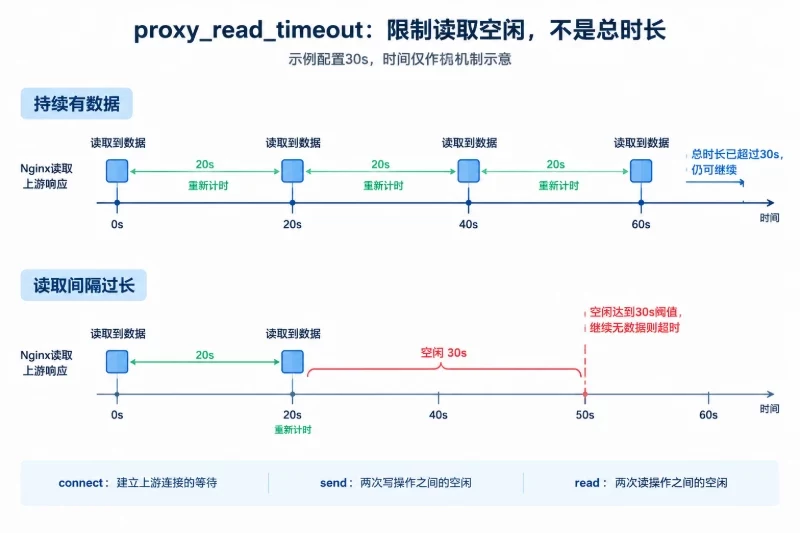
proxy_connect_timeout 是连接上游的等待时间。proxy_send_timeout 是向上游发送请求时,两次写操作之间允许的空闲时间。proxy_read_timeout 是等待上游返回数据时,两次读取之间允许的空闲时间,不是整个请求的总时长。如果出现 upstream timed out,先确认是连接阶段、发送阶段还是读取阶段,再判断是网络、应用处理还是超时策略问题。不要简单把所有超时改成几小时。
将配置写入实际文件后,必须先检查:
sudo nginx -t
成功时通常会看到:
nginx: the configuration file /etc/nginx/nginx.conf syntax is ok
nginx: configuration file /etc/nginx/nginx.conf test is successful
只有语法检查成功,才执行平滑重载:
sudo systemctl reload nginx
sudo systemctl is-active nginx
reload 通常不会像 restart 一样主动中断全部活动连接。不要在配置未验证时直接执行 systemctl restart nginx。
STATIC_URL="https://shop.example.com/assets/app.8f31c2.js"

curl -sS -D - -o /dev/null \
  -H 'Accept-Encoding: gzip' \
  "$STATIC_URL" | grep -iE 'HTTP/|cache-control|content-encoding|etag|expires'
应根据资源命名策略检查:
max-age。Content-Encoding: gzip。Cache-Control。API_URL="https://shop.example.com/api/health"
curl -sS -o /dev/null \
--connect-timeout 5 \
--max-time 30 \
-w "http=%{http_code} connect=%{time_connect}s ttfb=%{time_starttransfer}s total=%{time_total}s\n" \
"$API_URL"
如果静态资源改善明显,但 API 的 TTFB 没有变化,应把重点放到应用日志、数据库查询、上游连接池和序列化过程,不要继续提高 TCP 缓冲区。
ss -s
ss -lntp | grep -E ':(80|443)\b' || true

sudo journalctl -u nginx --since "10 minutes ago" --no-pager
sudo dmesg -T | grep -Ei 'oom|tcp|memory|net' | tail -50 || true
如果系统安装了 nstat,可记录 TCP 统计:
nstat -az | grep -Ei 'TcpRetransSegs|TcpTimeouts|TcpExt'
验证时应与变更前保持相同测试 URL、相同请求数量和相近时间段。单次下载速度容易受到缓存命中、客户端窗口、目标文件大小和线路瞬时状态影响,不宜单独作为验收标准。
bbr 不在可用列表处理方式:
sudo modprobe tcp_bbr 查看具体错误。cubic。不要为了启用 BBR 在生产节点临时更换第三方内核。更换内核属于系统级变更,应单独安排维护窗口和启动回滚方案。
fq 无法设置如果执行:
sudo sysctl -w net.core.default_qdisc=fq
出现 Invalid argument,说明当前内核或网络设备不支持该设置。恢复为原有值,或者删除配置文件中的 default_qdisc 行:
sudo sed -i '/^[[:space:]]*net\.core\.default_qdisc[[:space:]]*=/d' \
  /etc/sysctl.d/99-a5idc-web-tcp.conf

sudo sysctl -p /etc/sysctl.d/99-a5idc-web-tcp.conf
该命令会修改指定配置文件,影响范围仅为这一行;执行前应确认备份存在。
优先检查:
tracepath -n "$TARGET"
mtr -rwzc 100 "$TARGET"
nstat -az | grep -Ei 'Retrans|Timeout'
如果重传增加、RTT 波动明显,可能是线路或 MTU 问题。可以先回退 BBR,仅使用原有拥塞控制算法,再比较同一组测试结果。不要用增大 socket 缓冲区掩盖物理丢包。
directive is not allowed here这通常表示配置放错上下文:
gzip、keepalive_timeout 等可放在 http、server 或部分 location 上下文。proxy_pass、proxy_read_timeout 应放在 location 或相关上游上下文。upstream 必须位于 http 上下文。listen 只能放在 server 上下文。使用以下命令查看完整展开后的配置和文件来源:
sudo nginx -T > /tmp/nginx-expanded.conf
grep -nE '10-a5idc|gzip|proxy_read_timeout|upstream' /tmp/nginx-expanded.conf
upstream sent too big header这表示上游响应头超过了当前缓冲区,常见于登录状态、Cookie 或应用响应头过大。不要直接把所有 proxy_buffers 调到很大,先检查:
Set-Cookie。确认业务确实需要后,再针对对应的 location 调整 proxy_buffer_size,并同步观察连接数和内存。
处理顺序:
gzip_comp_level 从 5 调整为 3。gzip_min_length,排除很小的响应。proxy_read_timeout 是两次读取之间的空闲时间。长轮询接口如果超过该时间没有数据,就可能被关闭。应为长连接接口单独设置更长的读取超时,而不是把整个站点统一改为很大的数值:
location /api/long-polling/ {
    proxy_pass http://app_backend;
    proxy_http_version 1.1;
    proxy_set_header Connection "";

    proxy_read_timeout 300s;
    proxy_send_timeout 30s;
}
如果新增的是独立文件,优先只删除该文件,不要覆盖整个 /etc/nginx:
sudo rm -f /etc/nginx/conf.d/10-a5idc-web-performance.conf
sudo nginx -t
sudo systemctl reload nginx
rm -f 的影响范围仅为明确指定的配置文件,但仍应确认文件名没有写错。若新增配置是直接合并到已有文件,应从备份中恢复对应文件,而不是删除整个配置目录。
将 BACKUP 替换为实际备份目录:
BACKUP="/root/a5idc-tcp-tune-2026-xx-xx-xxxxxx"
如果备份中原本存在同名文件,恢复它:
if [ -f "$BACKUP/sysctl.d/99-a5idc-web-tcp.conf" ]; then
    sudo cp -a "$BACKUP/sysctl.d/99-a5idc-web-tcp.conf" \
      /etc/sysctl.d/99-a5idc-web-tcp.conf
else
    sudo rm -f /etc/sysctl.d/99-a5idc-web-tcp.conf
fi
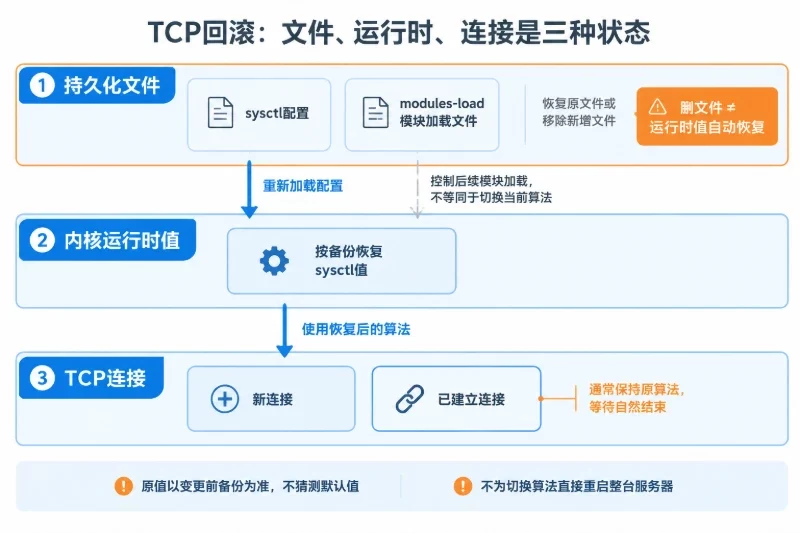
如果该文件原本不存在,删除新建文件后,还要根据变更前记录恢复运行时值。先查看备份:
grep -E '^(net\.core\.default_qdisc|net\.core\.somaxconn|net\.ipv4\.tcp_max_syn_backlog|net\.ipv4\.tcp_syncookies|net\.ipv4\.tcp_keepalive_)' \
  "$BACKUP/sysctl-before.txt"
然后逐项执行对应的 sysctl -w。不要根据其他服务器的默认值猜测。
回滚可选缓冲区配置:
sudo rm -f /etc/sysctl.d/99-a5idc-tcp-buffers.conf
sudo sysctl --system
sysctl --system 会重新加载多个系统配置文件,执行后应检查输出中是否有错误,并再次查看关键参数。
将新连接恢复为原有算法。下面的 cubic 仅适用于变更前确认使用 cubic 的环境;如果备份显示原值不同,应替换成备份中的值:
sudo sysctl -w net.ipv4.tcp_congestion_control=cubic
sudo rm -f /etc/modules-load.d/a5idc-tcp-bbr.conf
如果同时不再使用 fq:
sudo rm -f /etc/modules-load.d/a5idc-sch-fq.conf
回滚不会主动中断已经建立的 TCP 连接,新连接会使用恢复后的算法。需要立即让所有连接采用旧策略时,必须结合业务低峰期重启对应服务,但不建议为了切换拥塞控制而直接重启整台服务器。
完成调优后,至少保留一份变更前后对照记录:
/etc/nginx、/etc/sysctl.d 和变更前 sysctl 值已经备份。fq 无法使用时没有强行写入持久化配置。nginx -t 成功后才执行 reload。如果 TCP 层指标没有恶化,但用户侧的首字节时间仍然偏高,下一步应检查应用处理、数据库查询、DNS 和 TLS,而不是继续扩大内核缓冲区。对于 CN2 GIA 线路,最终体验还取决于服务商出口、目标运营商和实际访问地的路径质量,服务器参数优化应当与线路监测和 Web 服务指标一起判断。