

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


CN2线路的TCP调优不能靠一次性堆叠几十个sysctl参数完成。对Linux内核5.15香港服务器,更稳妥的做法是先记录路径、RTT、丢包、PMTU、拥塞控制算法和队列状态,再优先验证BBR + fq是否适合当前连接;只有在带宽时延积确实较大、窗口成为瓶颈时,才扩大TCP缓冲区。每次只改一组参数,并用相同目标、相同方向和相近负载复测,最后保留可执行的回滚文件。
下面的命令以Ubuntu、Debian、Rocky Linux等使用Linux 5.15内核的发行版为例。参数是否有效,以服务器实际输出为准。CN2只代表承载路径,不能直接证明RTT、丢包或吞吐一定满足预期;服务器TCP参数主要影响本机发起或本机发送数据的连接,远端发送方向仍受远端系统和应用控制。
先确认当前运行的内核确实是5.15系列,并检查iproute2提供的诊断命令是否存在。
uname -r
cat /etc/os-release

command -v ip
command -v ss
command -v tc
command -v nstat
command -v ping
command -v tracepath
command -v iperf3
uname -r可能输出类似下面的结果:
5.15.0-xxx-generic
重点不是发行版内核字符串完全一致,而是主版本为5.15,并且当前运行的内核与将要调整的系统相同。云服务器可能存在多个内核,修改前不要只查看/boot目录中的配置文件。
如果tracepath或iperf3不存在,不要用安装命令代替诊断结论:
tracepath用于查看路径MTU和路径变化,缺失时可以先跳过;iperf3用于授权测试端之间的吞吐验证,缺失时可使用受控的业务文件传输或应用层压测;ip、ss、tc和sysctl是本次调优的核心工具,建议先补齐对应发行版的标准工具包。测试目标应当是实际业务访问的IPv4地址,或者由运维人员控制的授权测试服务器,不建议使用随机公共地址。
export TARGET_IP="203.0.113.10"

export IFACE="$(
  ip route get "$TARGET_IP" |
  awk '{for (i=1; i<=NF; i++) if ($i=="dev") {print $(i+1); exit}}'
)"

printf 'TARGET_IP=%s\nIFACE=%s\n' "$TARGET_IP" "$IFACE"
ip route get "$TARGET_IP"
203.0.113.10只是文档示例地址,应替换为实际目标。正常情况下可以看到类似信息:
203.0.113.10 via 192.0.2.1 dev eth0 src 192.0.2.20
TARGET_IP=203.0.113.10
IFACE=eth0
判断标准如下:
dev eth0或其他网卡名称,说明路由和出口网卡已经确定;Network is unreachable,先处理路由问题,不要进入TCP参数调优;修改TCP参数通常不会像修改防火墙那样立即切断SSH,但仍应保留以下至少一种方式:
tmux或其他终端复用会话。不要在唯一的SSH连接中直接关闭网络服务或重启网卡。本文默认不执行防火墙、路由和网卡重启操作,因此风险主要集中在参数不兼容、持久化配置错误和结果误判。
使用root权限执行以下命令。这里保存的是调优前状态,不会修改参数。
sysctl \
  net.ipv4.tcp_congestion_control \
  net.ipv4.tcp_available_congestion_control \
  net.ipv4.tcp_rmem \
  net.ipv4.tcp_wmem \
  net.core.rmem_max \
  net.core.wmem_max \
  net.core.default_qdisc \
  net.ipv4.tcp_mtu_probing \
  net.ipv4.tcp_window_scaling \
  net.ipv4.tcp_moderate_rcvbuf

ip -s link show dev "$IFACE"
tc -s qdisc show dev "$IFACE"
ss -s
nstat -az 2>/dev/null | grep -Ei 'Retrans|Timeout|ListenOverflows|ListenDrops' || true
典型输出可能类似:
net.ipv4.tcp_congestion_control = cubic
net.ipv4.tcp_available_congestion_control = reno cubic bbr
net.ipv4.tcp_rmem = 4096 131072 6291456
net.ipv4.tcp_wmem = 4096 16384 4194304
net.core.rmem_max = 212992
net.core.wmem_max = 212992
net.core.default_qdisc = fq_codel
net.ipv4.tcp_mtu_probing = 0
net.ipv4.tcp_window_scaling = 1
net.ipv4.tcp_moderate_rcvbuf = 1
这些字段的判断方式:
| 输出项目 | 主要含义 | 调优判断 |
|---|---|---|
tcp_congestion_control | 新建TCP连接默认使用的拥塞控制算法 | 先记录,不要因为看到cubic就直接认定异常 |
tcp_available_congestion_control | 当前内核可用算法 | 只有列表中存在bbr,或成功加载tcp_bbr模块后,才测试BBR |
default_qdisc | 新建网络设备默认使用的排队规则 | fq适合配合需要 pacing 的算法,但不代表当前网卡已经切换 |
tcp_rmem、tcp_wmem | TCP自动调节的最小值、默认值、最大值 | 最大值过小且带宽时延积较大时,才考虑扩大 |
tcp_window_scaling | TCP窗口扩大选项 | 长RTT和高带宽场景通常应保持为1 |
tcp_moderate_rcvbuf | 接收缓冲区自动调节 | 通常保持为1,否则扩大tcp_rmem的效果会受限 |
nstat中的重传字段 | TCP和协议栈累计计数 | 需要保存基线,再与同等时长的调优后数据比较 |
net.core.rmem_max或wmem_max较小,不一定说明当前连接已经达到瓶颈。它们是上限,不是每条连接都会立即分配的内存。
先对同一个目标执行ICMP测试:
ping -c 30 -i 0.2 -W 1 "$TARGET_IP"
需要关注:
packet loss:丢包比例;min/avg/max/mdev:最小、平均、最大RTT和抖动;例如:
30 packets transmitted, 30 received, 0% packet loss
rtt min/avg/max/mdev = 8.421/9.103/12.775/0.812 ms
这个结果只能说明ICMP探测的表现,不能证明TCP吞吐,也不能证明业务端口一定没有丢包。目标禁止ICMP时,ping失败不等于CN2线路丢包,应改用实际TCP连接或授权的iperf3测试。
继续查看路径和PMTU:
tracepath -n "$TARGET_IP"
可能看到:
 1?: [LOCALHOST]                      pmtu 1500
 1:  192.0.2.1                          1.102ms
 2:  198.51.100.1                       2.431ms
 3:  203.0.113.10                       9.008ms reached
     Resume: pmtu 1500 hops 3 back 3
这里的判断边界很重要:
pmtu 1500或其他稳定数值表示路径发现到的最大传输单元;no reply,可能只是路由器不响应探测,不能单独判定丢包;tracepath使用的探测协议和实际业务TCP不完全相同,只能作为路径和MTU线索,不能代替吞吐测试。查看网卡和队列统计:
ip -s link show dev "$IFACE"
tc -s qdisc show dev "$IFACE"
如果RX errors、TX errors、dropped在测试期间持续增加,先排查网卡、虚拟化宿主机或本地队列问题。单纯提高TCP缓冲区,不能修复网卡错误。
建议在变更前保存关键输出,并生成可用于回滚的参数文件。
export BACKUP_DIR="/root/cn2-tcp-backup-$(date +%F-%H%M%S)"
mkdir -p "$BACKUP_DIR"

uname -r > "$BACKUP_DIR/uname.txt"
cat /etc/os-release > "$BACKUP_DIR/os-release.txt"
ip route get "$TARGET_IP" > "$BACKUP_DIR/route.txt"
ip -s link show dev "$IFACE" > "$BACKUP_DIR/link-before.txt"
tc -s qdisc show dev "$IFACE" > "$BACKUP_DIR/qdisc-before.txt"
ss -s > "$BACKUP_DIR/ss-summary-before.txt"
nstat -az 2>/dev/null > "$BACKUP_DIR/nstat-before.txt"

save_sysctl() {
  local key="$1"
  local value
  if value="$(sysctl -n "$key" 2>/dev/null)"; then
    printf '%s = %s\n' "$key" "$value"
  fi
}

{
  save_sysctl net.core.default_qdisc
  save_sysctl net.ipv4.tcp_congestion_control
  save_sysctl net.core.rmem_max
  save_sysctl net.core.wmem_max
  save_sysctl net.ipv4.tcp_rmem
  save_sysctl net.ipv4.tcp_wmem
  save_sysctl net.ipv4.tcp_mtu_probing
  save_sysctl net.ipv4.tcp_window_scaling
  save_sysctl net.ipv4.tcp_moderate_rcvbuf
} > "$BACKUP_DIR/restore.conf"

printf '备份目录:%s\n' "$BACKUP_DIR"
cat "$BACKUP_DIR/restore.conf"
如果服务器原本已经存在/etc/sysctl.d/99-cn2-tcp-tuning.conf,还要单独备份:
if [ -f /etc/sysctl.d/99-cn2-tcp-tuning.conf ]; then
  cp -a /etc/sysctl.d/99-cn2-tcp-tuning.conf \
    "$BACKUP_DIR/99-cn2-tcp-tuning.conf.before"
fi
Linux 5.15通常具备BBR支持,但具体发行版可能将其编译为模块、内置功能,或使用了裁剪内核。先查询,不要假设一定存在。
sysctl -n net.ipv4.tcp_available_congestion_control
如果输出中已经包含bbr,可以进入测试。若没有,尝试加载模块:
modprobe tcp_bbr 2>/dev/null || true
sysctl -n net.ipv4.tcp_available_congestion_control
加载后仍没有bbr,说明当前内核没有提供可用的BBR模块,继续使用现有算法即可。不要把字符串强行写入配置文件,否则重启后可能出现参数加载失败。
如果模块存在并且希望开机自动加载,可以先确认:
modinfo tcp_bbr 2>/dev/null | head
只有命令能够返回模块信息时,才考虑创建模块加载文件:
printf '%s\n' tcp_bbr > /etc/modules-load.d/tcp-bbr.conf
这个文件只影响开机模块加载,不会立即改变当前连接。创建后要把它纳入回滚记录;如果测试不通过,使用mv移至备份目录,而不是直接删除未知来源的文件。
BBR和fq应当分开验证。先将可用参数写入一个专用文件,避免修改发行版已有配置。
export TUNE_FILE="/etc/sysctl.d/99-cn2-tcp-tuning.conf"

: > "$TUNE_FILE"

if sysctl -n net.core.default_qdisc >/dev/null 2>&1; then
  printf '%s\n' 'net.core.default_qdisc = fq' >> "$TUNE_FILE"
fi

if sysctl -n net.ipv4.tcp_available_congestion_control 2>/dev/null |
   tr ' ' '\n' | grep -qx bbr; then
  printf '%s\n' 'net.ipv4.tcp_congestion_control = bbr' >> "$TUNE_FILE"
else
  echo "当前内核没有可用的 bbr,保留原拥塞控制算法"
fi

cat "$TUNE_FILE"
sysctl -p "$TUNE_FILE"
这里使用sysctl -p "$TUNE_FILE"只加载本文件,比直接执行sysctl --system更容易控制影响范围。sysctl --system会按发行版顺序加载多个配置目录,可能把与本次调优无关的历史配置一并应用。
应用后检查:
sysctl net.core.default_qdisc
sysctl net.ipv4.tcp_congestion_control
sysctl net.ipv4.tcp_available_congestion_control
需要注意两个事实:
tcp_congestion_control主要作为新建TCP连接的默认算法,已经建立的连接通常不会因为修改默认值而切换;default_qdisc = fq是默认策略,不等于当前网卡的活动队列已经变成fq。检查当前活动队列:
tc qdisc show dev "$IFACE"
如果输出仍然是fq_codel、mq或其他队列,不要立即判定配置失败。多队列网卡和发行版网络初始化服务可能已经为网卡设置了队列。本文不建议在没有维护窗口的情况下直接执行tc qdisc replace覆盖现有队列,因为这会影响该网卡上的全部流量。
在调优前后分别建立新的业务连接,然后执行:
ss -tin
在输出中找到目标连接,常见字段可能类似:
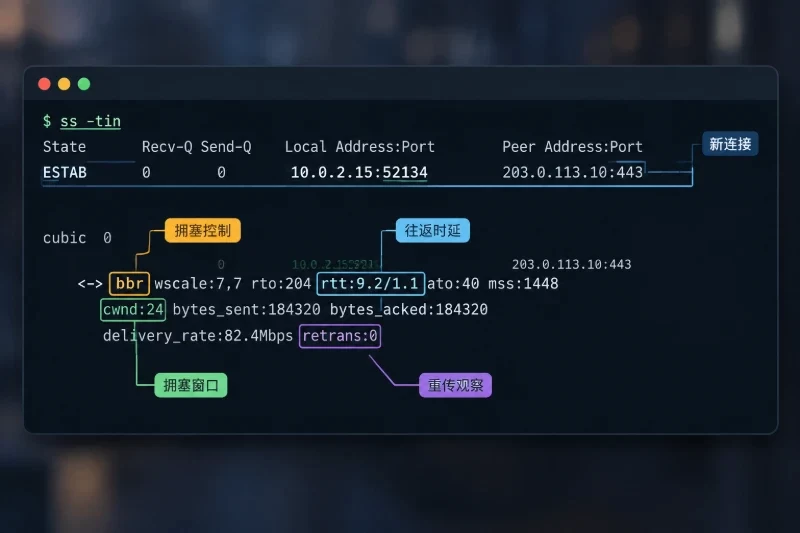
ESTAB 0 0 192.0.2.20:54012 203.0.113.10:443
     bbr wscale:7,7 rto:204 rtt:9.2/1.1 ato:40 mss:1448
     cwnd:24 bytes_sent:184320 bytes_acked:184320
     delivery_rate:82.4Mbps retrans:0
判断方法:
bbr,说明该连接使用了BBR;rtt是该TCP连接估计的往返时延,不是ping平均值的简单替代;cwnd是拥塞窗口,不能单独用来判定吞吐高低;retrans:0或重传没有明显增长是较好的信号;TCP_CONGESTION自行指定算法,系统默认值不一定覆盖应用设置;ss -tin显示仍为cubic,应先确认是不是复用了旧连接,重新建立连接后再判断。TCP窗口是否成为瓶颈,可以先用带宽时延积估算:
所需窗口约等于目标带宽(Mbps)× RTT(ms)÷ 8,结果约为KB。
例如:
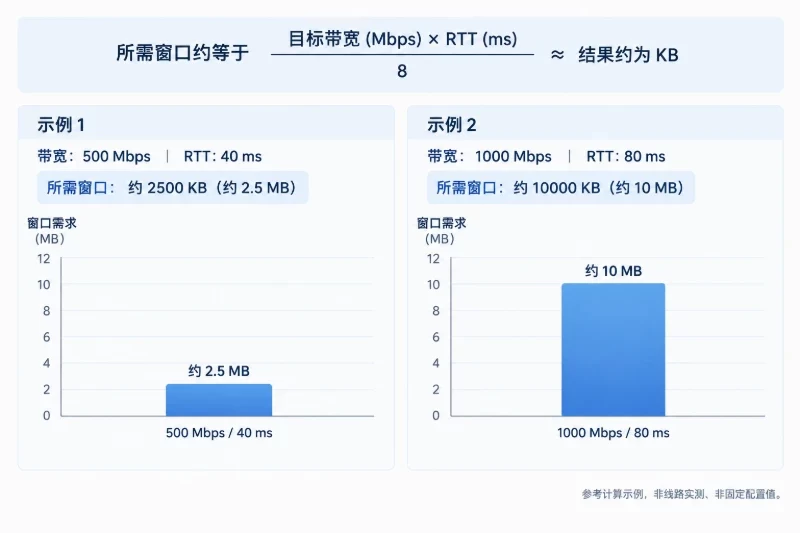
这是估算值,不是必须设置成相同数值。实际还要考虑协议开销、抖动、并发连接数量和接收端限制。如果目标带宽、RTT和业务方向都不明确,直接把缓冲区提高到64 MB或更大,通常只是增加可分配上限,并不会自动提高速度。
当基线显示单连接吞吐明显低于线路能力,并且ss -tin、iperf3或业务指标提示窗口受限时,可以先使用16 MB级别的配置:
cat >> "$TUNE_FILE" <<'EOF'
net.core.rmem_max = 16777216
net.core.wmem_max = 16777216
net.ipv4.tcp_rmem = 4096 131072 16777216
net.ipv4.tcp_wmem = 4096 16384 16777216
net.ipv4.tcp_window_scaling = 1
net.ipv4.tcp_moderate_rcvbuf = 1
EOF

sysctl -p "$TUNE_FILE"
这些数值的单位是字节,16777216等于16 MiB。它们不是每条连接立即占用16 MiB,而是自动调节允许达到的上限。连接数较多时,仍需要观察内存和套接字统计:
free -h
cat /proc/net/sockstat
ss -s
如果服务器是高并发业务,扩大单连接上限后出现内存压力、TCP内存压力或应用延迟上升,应撤销缓冲区扩展,而不是继续提高上限。
以下参数经常出现在网络调优脚本中,但不能直接解决跨线路吞吐或RTT问题:
net.ipv4.tcp_fin_timeout:主要影响连接关闭后的状态,不会降低链路RTT;net.ipv4.tcp_tw_reuse:主要涉及主动连接的TIME_WAIT复用,不是单连接带宽参数;net.core.somaxconn、tcp_max_syn_backlog:主要影响监听队列和突发建连,不会改变已建立连接的传输速度;net.ipv4.tcp_fastopen:需要客户端、服务端和应用共同支持,不能仅靠服务器开启就获得稳定收益;net.ipv4.tcp_no_metrics_save:会改变TCP历史度量的使用方式,缺少明确问题时不建议修改;tcp_low_latency等旧式参数:不能替代拥塞控制和路径验证。调优范围越大,越难判断性能变化到底来自哪个参数,也越难安全回滚。
执行与基线相同的命令:
ping -c 30 -i 0.2 -W 1 "$TARGET_IP"
tracepath -n "$TARGET_IP"

ip -s link show dev "$IFACE"
tc -s qdisc show dev "$IFACE"
不要期待切换BBR后ping平均RTT必然下降。TCP拥塞控制主要影响发送速率、排队和丢包恢复,不能改变运营商路径长度。若平均RTT没有变化,但TCP吞吐提升且重传没有增加,这仍可能是有效调优。
如果调优后出现:
ping丢包明显增加;TX dropped或队列丢包增长;tracepath的PMTU异常下降;应立即停止扩大参数范围,优先回滚最近一次变更。
如果有自己控制的远端测试端,先进行单连接测试。单连接更适合观察拥塞控制变化:
export TEST_SERVER="203.0.113.10"

iperf3 -c "$TEST_SERVER" -t 30 -P 1 --json \
  > "$BACKUP_DIR/iperf-after-forward.json"
再测试反向方向:
iperf3 -c "$TEST_SERVER" -t 30 -P 1 -R --json \
  > "$BACKUP_DIR/iperf-after-reverse.json"
调优前也应使用完全相同的目标、时长、并发数和方向,保存为iperf-before-forward.json和iperf-before-reverse.json。不要将不同目标、不同时间段或不同并发数的结果直接比较。
文本模式输出可能类似:
[ ID] Interval           Transfer     Bitrate         Retr  Cwnd
[  5]   0.00-30.00 sec  2.74 GBytes   784 Mbits/sec     3   1.21 MBytes
判断时同时看以下项目:
Bitrate:单连接有效吞吐是否提高;Retr:重传是否明显增加;Cwnd:拥塞窗口是否稳定增长,而不是频繁回落;如果没有iperf3,可以使用实际业务文件或接口请求进行对照,但必须固定文件大小、并发数、客户端、目标端口和测试时间。仅凭下载一次文件的耗时,不足以判断BBR或缓冲区一定有效。
在持续传输期间执行:
ss -tin
nstat -az 2>/dev/null | grep -Ei 'Retrans|Timeout|ListenOverflows|ListenDrops' || true
cat /proc/net/sockstat
调优成功不应只表现为吞吐数字增加,还应满足:
retrans没有持续上升;TcpRetransSegs和超时相关计数没有明显恶化;可以使用下面的记录表整理结果:
| 项目 | 调优前 | 调优后 | 接受标准 |
|---|---|---|---|
| 平均RTT | 记录值 | 记录值 | 不要求因TCP调参下降 |
| 丢包率 | 记录值 | 记录值 | 不应明显增加 |
| 单连接吞吐 | 记录值 | 记录值 | 多轮测试有稳定改善才算有效 |
| TCP重传 | 记录值 | 记录值 | 不应以吞吐提升为代价显著增加 |
| 活动拥塞控制 | 例如cubic | 例如bbr | 新连接与目标配置一致 |
| 活动队列 | 例如fq_codel | 实际输出 | 以tc输出为准,不只看默认值 |
| TCP套接字内存 | 记录值 | 记录值 | 不应出现持续内存压力 |
bbr不存在如果以下命令没有返回bbr:
sysctl -n net.ipv4.tcp_available_congestion_control
并且:
modprobe tcp_bbr
也无法加载,不要继续写入:
net.ipv4.tcp_congestion_control = bbr
此时保留cubic或原有算法,先验证路径、PMTU、网卡错误和远端服务能力。Linux 5.15只代表内核主版本,不保证发行版内核配置一定启用了BBR。
sysctl -p返回unknown key或permission denied常见原因包括:
处理方式是记录报错项,不要盲目执行sysctl --system反复加载。先查看当前值:
sysctl net.ipv4.tcp_available_congestion_control
sysctl net.core.default_qdisc
删除或注释不支持的配置行后,再单独加载专用文件。若无法确认某个参数是否存在,应以sysctl -n 参数名的返回结果为准,而不是根据网络文章照抄。
default_qdisc已改成fq,但活动队列没有变化这是常见情况。default_qdisc主要是默认值,网卡可能已经被NetworkManager、systemd-networkd、云初始化脚本或多队列驱动设置了实际队列。
先查看:
tc qdisc show dev "$IFACE"
如果活动队列为fq_codel且没有明显丢包、队列堆积和重传增加,不必为了追求输出一致而强制替换。只有在维护窗口、已确认驱动支持、并且有完整的原队列恢复命令时,才考虑显式调整活动队列。
按以下顺序检查:
ss -tin是否显示新连接确实使用了目标算法;ping和tracepath的路径是否发生变化;iperf3是否使用了不同方向、不同并发数或不同时间段;ss -s、sockstat和free是否出现资源压力。如果RTT、丢包和重传本来就正常,且目标带宽已经接近线路或远端上限,继续扩大缓冲区通常不会带来线性收益。
如果小数据连接正常,大数据传输卡住,且tracepath显示路径PMTU异常,可以先临时启用内核的黑洞探测:
sysctl -w net.ipv4.tcp_mtu_probing=1
然后新建连接复测。该参数只适合在反复出现PMTU黑洞迹象时使用,不要仅因为一次tracepath中间跳数不响应就开启。验证无效或引入异常时,应按备份值恢复。不要直接修改网卡MTU,除非已经确认业务、隧道、云平台和对端都支持新的MTU。
假设备份目录仍保存在$BACKUP_DIR,先确认恢复文件内容:
cat "$BACKUP_DIR/restore.conf"
然后加载变更前的值:
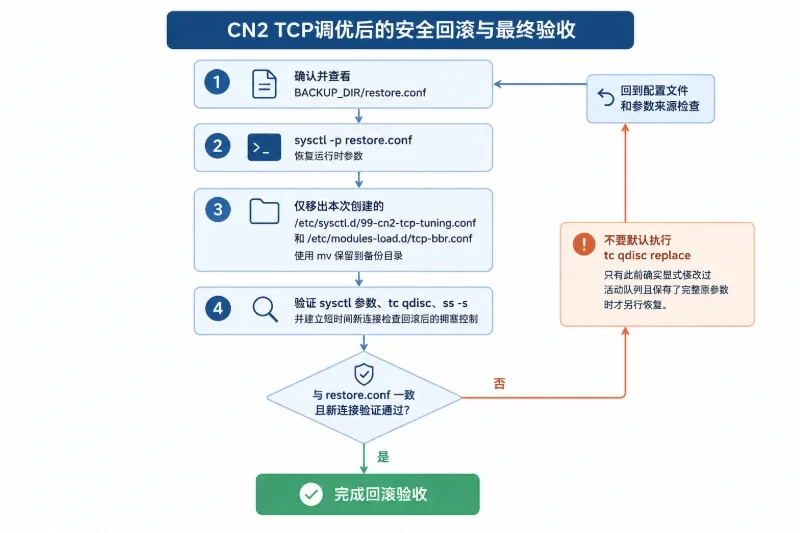
sysctl -p "$BACKUP_DIR/restore.conf"
如果本次创建了专用持久化文件,先恢复运行时参数,再将其移出加载目录:
if [ -f "$TUNE_FILE" ]; then
  mv "$TUNE_FILE" "$BACKUP_DIR/99-cn2-tcp-tuning.conf.rollback"
fi
如果此前创建了BBR模块自动加载文件,也一并移出:
if [ -f /etc/modules-load.d/tcp-bbr.conf ]; then
  mv /etc/modules-load.d/tcp-bbr.conf \
    "$BACKUP_DIR/tcp-bbr.conf.rollback"
fi
这里使用mv而不是直接删除,便于审计和再次恢复。不要移动不是本次创建的系统配置文件。
sysctl \
  net.core.default_qdisc \
  net.ipv4.tcp_congestion_control \
  net.core.rmem_max \
  net.core.wmem_max \
  net.ipv4.tcp_rmem \
  net.ipv4.tcp_wmem \
  net.ipv4.tcp_mtu_probing

tc qdisc show dev "$IFACE"
ss -s
需要确认:
restore.conf一致;tc qdisc replace。如果确实执行过,必须按照变更前保存的完整队列参数恢复,不能只恢复default_qdisc;完成调优或回滚后,至少保留以下记录:
uname -r确认运行内核为5.15系列;ip route get "$TARGET_IP"确认测试走向和出口网卡;ping、tracepath和tc输出已保存;ss -tin验证了实际拥塞控制算法;iperf3或业务传输使用相同目标、方向、并发数和时长;default_qdisc输出当作活动队列的唯一证据;/root下保留了原始参数和restore.conf;对Linux内核5.15香港服务器而言,CN2线路TCP调优的合理终点不是“参数越大越好”,而是用基线证明问题确实存在,再用最小变更验证:拥塞控制是否生效、队列是否稳定、窗口是否足够、重传是否可控。若没有稳定的吞吐收益,或收益伴随重传、内存和延迟恶化,应恢复原值,而不是继续叠加更多参数。


