香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


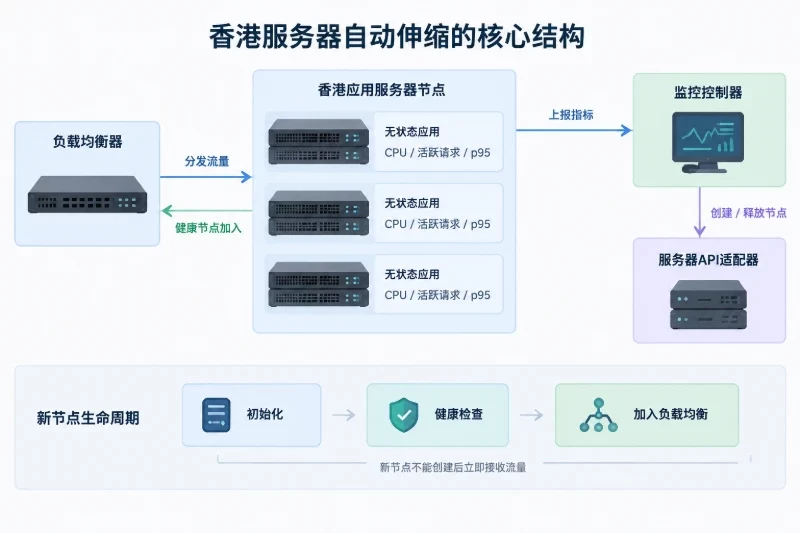
要把香港服务器自动伸缩落地,建议采用“负载均衡 + 无状态应用节点 + 监控控制器 + 服务器API适配器”的结构。控制器每分钟读取各节点CPU、活跃请求数和延迟数据,使用持续窗口而不是单次采样判断是否扩容;扩容后先完成节点初始化和健康检查,再加入负载均衡。缩容则使用更长的低负载窗口,并执行连接排空,避免正在处理的请求被直接中断。
基于CPU与并发阈值时,CPU可以反映计算压力,并发数可以反映请求堆积或处理能力不足。实际规则可设为:CPU达到70%且单节点活跃请求数达到安全并发的80%时连续触发扩容;CPU达到85%或活跃请求数明显超过安全值时快速触发扩容。缩容则要求CPU和并发同时处于较低水平,并且持续时间明显长于扩容观察窗口。以下以Ubuntu 22.04、Nginx反向代理、Python控制器和通用服务器API为例,说明一套可重复部署、可审计、支持定时任务和失败回滚的实施方式。
建议将职责拆成四个部分:
| 组件 | 主要职责 | 是否参与扩缩容决策 |
|---|---|---|
| 负载均衡 | 将请求分发到健康的香港应用节点 | 间接参与 |
| 应用节点 | 提供实际业务服务,保持无状态 | 提供CPU和并发指标 |
| 监控控制器 | 读取指标、计算目标节点数、执行状态机 | 是 |
| 服务器API适配器 | 创建、查询、加入、摘除和释放节点 | 执行动作 |
应用节点不能依赖本地会话、临时上传文件或只存在于单台服务器上的任务状态。否则,即使新节点成功加入,用户请求也可能因为会话不一致或文件不可见而产生异常。
自动伸缩控制器本身不应直接嵌入具体云平台的全部接口逻辑。更稳妥的方式是定义一个统一的适配器接口,把不同服务器平台的创建、查询和负载均衡操作放在适配器中,控制器只处理以下逻辑:
这样做的好处是,阈值和扩缩容规则可以重复使用,后续更换服务器管理接口时不需要重写决策逻辑。
“并发”不能简单等同于TCP连接数。
更适合用于自动伸缩的指标优先级如下:
例如,浏览器保持长连接时,TCP连接数可能较高,但实际没有持续处理请求。如果直接使用连接数触发扩容,可能出现节点数量不断增加、业务吞吐却没有明显变化的问题。
如果只能采集连接数,应在性能测试中专门建立“连接数与实际请求压力”的对应关系,并在配置中明确写成 active_connections,不要把它误标为应用并发数。
自动伸缩不能直接采用一个看起来合理的并发数字。应先在和生产环境相同的香港服务器节点上进行压力测试,找出满足业务延迟目标时的单节点安全并发。
例如,测试发现:
那么可以把96作为扩容参考阈值,把120作为紧急压力阈值。这里的数字只是示例,实际值必须根据应用类型、请求耗时、数据库依赖和业务延迟目标重新测试。
下面是一套便于复现的参考环境:
/etc/hk-autoscale/;/var/lib/hk-autoscale/;/var/log/hk-autoscale/audit.jsonl;wrk;控制器可以与负载均衡和应用节点分开部署。若暂时没有独立管理节点,也可以先放在一台固定的香港服务器上,但这台服务器不能参与被自动删除的应用节点组。
在控制器上先确认系统版本、Python版本和Nginx状态:
uname -a
cat /etc/os-release
python3 --version
systemctl is-active nginx
预期可以看到Ubuntu 22.04、Python 3.x以及Nginx处于active状态。若系统版本或Python运行时与控制器依赖不匹配,应先固定运行环境,不要在扩缩容逻辑上线后临时升级。
检查应用节点的健康接口:
curl -i --max-time 5 http://127.0.0.1/healthz
应用健康检查至少应能区分以下状态:
如果Nginx自身返回200,但后端应用已经停止,控制器会误判节点健康。因此,/healthz最好由应用服务处理,或由Nginx反向代理到应用健康接口。
控制器不建议长期使用登录管理员账号运行。可以创建专用用户,并限制其读取配置和调用适配器的权限:
sudo useradd --system --home /var/lib/hk-autoscale \
  --create-home --shell /usr/sbin/nologin hk-autoscale

sudo install -d -o hk-autoscale -g hk-autoscale -m 0750 \
  /etc/hk-autoscale \
  /var/lib/hk-autoscale \
  /var/log/hk-autoscale \
  /usr/local/libexec/hk-autoscale
如果适配器需要调用服务器API,应为其配置权限范围明确的访问凭证,至少限制到以下操作:
不要让控制器凭证具备删除全部服务器、修改账号、变更网络策略等无关权限。
可以先创建一份参考配置:
environment: hk-prod
timezone: Asia/Hong_Kong

nodes:
  min: 2
  max: 8
  step: 1

sampling:
  interval_seconds: 60
  stale_after_seconds: 120

scale_out:
  consecutive_samples: 3
  cooldown_seconds: 600
  cpu_percent: 70
  active_requests_per_node: 96
  emergency_cpu_percent: 85
  emergency_requests_per_node: 120
  p95_latency_guard_ms: 300

scale_in:
  consecutive_samples: 15
  cooldown_seconds: 1200
  cpu_percent: 35
  active_requests_per_node: 48
  p95_latency_guard_ms: 250
  drain_timeout_seconds: 300

health:
  path: /healthz
  expected_status: 200
  ready_timeout_seconds: 600

audit:
  path: /var/log/hk-autoscale/audit.jsonl
  state_path: /var/lib/hk-autoscale/state.json

scheduled_windows:
  - name: evening-peak
    start: "19:40"
    end: "23:00"
    minimum_nodes: 3
此配置的含义是:
19:40至23:00期间至少保留3台节点。配置中的时间使用Asia/Hong_Kong,不要混用UTC和本地时间。服务器系统时间也应先确认:
timedatectl
若系统时区未按预期设置,应在系统层面统一时间来源,或确保控制器明确使用配置中的时区。
推荐使用带滞后的规则,避免节点数量在临界点来回变化。
普通扩容条件可以写成:
任一健康节点同时满足:
CPU >= 70%
且活跃请求数 >= 96
连续3个采样周期成立
紧急扩容条件可以写成:
任一健康节点满足:
CPU >= 85%
或活跃请求数 >= 120
连续2个采样周期成立
如果应用p95延迟已经超过300毫秒,可以直接视为压力确认条件,在满足冷却规则和最大节点数限制时提前扩容。延迟指标不应完全替代CPU和并发指标,因为延迟升高也可能来自数据库、外部接口或应用锁竞争。
缩容条件建议更加严格:
所有健康节点同时满足:
CPU < 35%
且活跃请求数 < 48
且p95延迟 < 250毫秒
连续15个采样周期成立
同时还要满足:
配置文件不应直接覆盖生产版本。可以采用版本目录:
sudo install -d -m 0750 /etc/hk-autoscale/releases/20261004-01

sudo install -o hk-autoscale -g hk-autoscale -m 0640 \
  config.yaml \
  /etc/hk-autoscale/releases/20261004-01/config.yaml

sudo ln -sfn /etc/hk-autoscale/releases/20261004-01 \
  /etc/hk-autoscale/current
ln -sfn会改变当前配置指向,执行前应确认旧版本路径和当前控制器状态。不要在没有备份的情况下删除旧版本目录。
控制器应提供配置检查模式,例如:
sudo -u hk-autoscale /usr/local/sbin/hk-autoscale \
  --config /etc/hk-autoscale/current/config.yaml \
  --check-config
检查内容至少包括:
min不大于max;p95_latency_guard_ms为正数;创建服务文件:
# /etc/systemd/system/hk-autoscale.service
[Unit]
Description=Hong Kong Server Autoscale Controller
After=network-online.target
Wants=network-online.target

[Service]
Type=oneshot
User=hk-autoscale
Group=hk-autoscale
ExecStart=/usr/bin/flock -n /run/lock/hk-autoscale.lock \
  /usr/local/sbin/hk-autoscale \
  --config /etc/hk-autoscale/current/config.yaml
WorkingDirectory=/var/lib/hk-autoscale
TimeoutStartSec=900
创建定时器:
# /etc/systemd/system/hk-autoscale.timer
[Unit]
Description=Run Hong Kong Server Autoscale Controller

[Timer]
OnBootSec=2min
OnUnitActiveSec=1min
Persistent=true

[Install]
WantedBy=timers.target
加载并启动:
sudo systemctl daemon-reload
sudo systemctl enable --now hk-autoscale.timer
systemctl list-timers hk-autoscale.timer
这里使用flock避免上一次控制器还在等待新节点启动时,下一次任务又同时创建节点。若锁被占用,本次执行应记录“已有任务运行中”,而不是再次提交创建请求。
每台新节点应按固定顺序处理:
节点启动过程应尽量幂等。所谓幂等,是指同一份初始化配置执行一次或重复执行多次,都不会产生重复进程、重复配置或错误的后端成员。
应用节点上的Nginx配置可以采用版本化文件,例如:
# /etc/nginx/conf.d/app.conf
upstream local_app {
    server 127.0.0.1:8080;
    keepalive 32;
}

server {
    listen 80;
    server_name _;

    location = /healthz {
        proxy_pass http://local_app/healthz;
        proxy_connect_timeout 2s;
        proxy_read_timeout 3s;
    }

    location / {
        proxy_pass http://local_app;
        proxy_http_version 1.1;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header Connection "";
    }
}
应用端口、健康接口和超时时间应根据实际应用调整。配置修改后必须先测试:
sudo nginx -t
sudo systemctl reload nginx
nginx -t失败时不要执行reload。若reload后出现异常,应立即恢复上一份经过验证的配置。
控制器可以约定以下通用接口:
providerctl list --env hk-prod
providerctl create --env hk-prod --count 1 --image app-image-v3
providerctl wait-ready --env hk-prod --node NODE_ID --timeout 600
providerctl add-backend --env hk-prod --node NODE_ID
providerctl drain --env hk-prod --node NODE_ID --timeout 300
providerctl remove-backend --env hk-prod --node NODE_ID
providerctl terminate --env hk-prod --node NODE_ID
上述命令是适配器接口示例,不是可以直接使用的某个平台命令。部署时需要根据实际服务器API实现providerctl,并为每个返回值定义明确含义:
0:操作成功;0:操作失败;wait-ready只有在系统、应用和负载均衡健康检查都通过后才返回成功;drain超时不能默认视为成功;terminate必须校验节点属于当前环境且由控制器创建。适配器实现时应记录请求ID、节点ID、操作类型和返回状态,但不要将访问凭证写入日志。
控制器读取的指标可以统一成如下格式:
{
  "timestamp": "2026-10-04T19:45:00+08:00",
  "nodes": [
    {
      "id": "hk-app-01",
      "healthy": true,
      "cpu_percent": 68.4,
      "active_requests": 91,
      "p95_ms": 218
    },
    {
      "id": "hk-app-02",
      "healthy": true,
      "cpu_percent": 72.1,
      "active_requests": 103,
      "p95_ms": 241
    }
  ]
}
字段含义必须固定:
timestamp:指标采集时间,不是控制器读取时间;healthy:节点是否通过应用和负载均衡健康检查;cpu_percent:统一采样周期内的CPU平均使用率;active_requests:活跃请求数,不能混入空闲连接;p95_ms:同一采样窗口内的请求延迟分位值。如果指标采集失败或时间戳超过stale_after_seconds,控制器应停止缩容。扩容是否继续,需要根据剩余可靠指标决定;在无法确认压力时,宁可记录告警并等待下一周期,也不要根据过期数据反复创建节点。
每次systemd timer触发后,控制器建议按以下顺序执行:
3.读取上一次状态文件。
伪代码可以表达为:
if metrics_are_stale:
    record("metrics_stale")
    prohibit_scale_in()
    exit

if active_operation_exists:
    record("operation_in_progress")
    exit

scheduled_floor = current_schedule_minimum()
desired = max(current_nodes, scheduled_floor)

if scale_out_condition_is_satisfied:
    desired = min(current_nodes + 1, max_nodes)

elif scale_in_condition_is_satisfied:
    desired = max(current_nodes - 1, min_nodes)

if desired > current_nodes:
    create_one_node_then_health_check()
elif desired < current_nodes:
    drain_one_node_then_remove()
else:
    record("no_change")
扩容和缩容都应一次只处理一个节点。这样虽然不是最快的方式,但更容易观察新节点是否真正分担了流量,也能降低批量操作失败后的恢复难度。
扩容任务开始后,先保存操作前状态:
{
  "event": "scale_out_requested",
  "time": "2026-10-04T19:48:00+08:00",
  "before_nodes": 2,
  "target_nodes": 3,
  "reason": {
    "node": "hk-app-02",
    "cpu_percent": 72.1,
    "active_requests": 103,
    "p95_ms": 241
  }
}
然后执行:
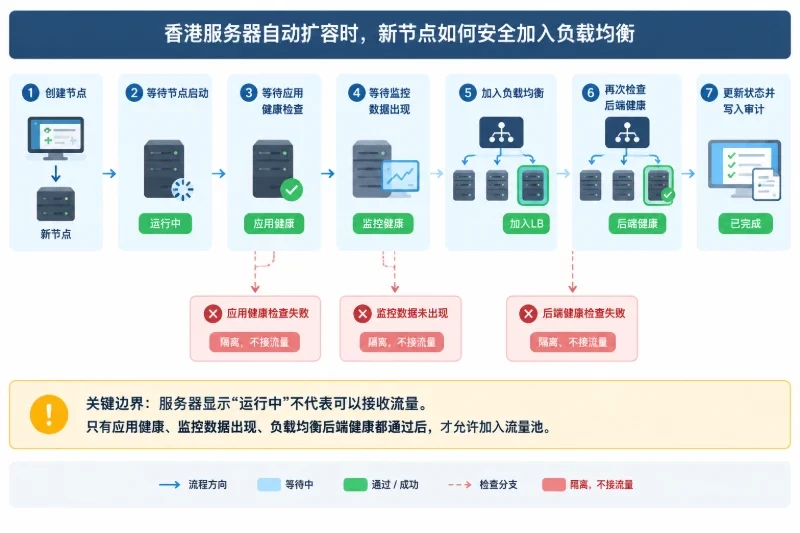
创建节点
→ 等待节点启动
→ 等待应用健康
→ 等待监控数据出现
→ 加入负载均衡
→ 再次检查后端健康
→ 更新状态
不能只根据服务器状态为“运行中”就认为节点可以接收流量。服务器运行中可能仍处于应用启动、配置下载或依赖连接建立阶段。
缩容时应优先选择以下节点:
缩容流程为:
选择候选节点
→ 标记为draining
→ 从负载均衡停止新请求
→ 等待活跃请求下降
→ 检查连接是否排空
→ 从后端池移除
→ 释放节点
→ 更新状态
如果等待超过drain_timeout_seconds仍有长连接或请求未完成,不应强制释放节点。应保留节点并记录超时,下一周期重新评估。
下面是一组用于说明测试过程的示例环境,不代表当前服务器规格或实际运行结果:
/healthz;测试前确认两台节点配置一致:
for host in hk-app-01 hk-app-02; do
  ssh "$host" 'nginx -t && systemctl is-active nginx'
done
检查健康接口:
curl -fsS --max-time 5 http://example.test/healthz
测试域名、接口路径和请求参数应替换为实际业务测试地址,不要直接对生产写接口进行压测。
至少记录以下指标:
| 指标 | 用途 |
|---|---|
| CPU平均值 | 判断计算资源是否持续饱和 |
| 单节点活跃请求数 | 判断请求是否超过单节点安全承载 |
| 总吞吐量 | 判断增加节点后处理能力是否提升 |
| p50延迟 | 观察典型请求体验 |
| p95延迟 | 观察高分位请求是否恶化 |
| 错误率 | 判断是否已经影响业务 |
| 节点创建耗时 | 计算扩容反应速度 |
| 健康检查通过耗时 | 判断新节点多久能接流量 |
| 负载均衡加入耗时 | 判断节点从创建到可服务的完整时间 |
| 扩容后指标恢复时间 | 判断阈值是否足够提前 |
wrk的-c表示客户端连接数,不等于应用层活跃请求数。测试时应同时读取监控中的active_requests,不能把-c 120直接写成“应用并发为120”。
一个简单的阶梯测试示例:
wrk -t4 -c40  -d5m --latency http://example.test/api/read
wrk -t4 -c80  -d5m --latency http://example.test/api/read
wrk -t4 -c120 -d5m --latency http://example.test/api/read
wrk -t4 -c160 -d5m --latency http://example.test/api/read
每个阶段至少持续到指标稳定,且应在阶段之间保留恢复时间。若前一个阶段已经造成错误率上升,不能马上进入更高压力阶段,否则会把前一阶段的排队和缓存影响带入下一阶段。
建议分为四轮:
保持2台节点,使用较低并发运行10分钟,确认:
逐步提高负载,观察活跃请求数接近96时的变化。重点不是马上触发扩容,而是确认单节点安全并发是否合理。
如果活跃请求数已经超过96,但CPU、p95和错误率仍然稳定,可以考虑提高阈值;如果活跃请求数只有80,p95已经明显恶化,则应降低阈值或增加延迟保护条件。
持续施加能够让至少一台节点超过阈值的负载,检查以下顺序:
停止压力或逐步降低压力,等待低负载条件持续满足15分钟以上,确认:
下面是用于判断流程的模拟结果:
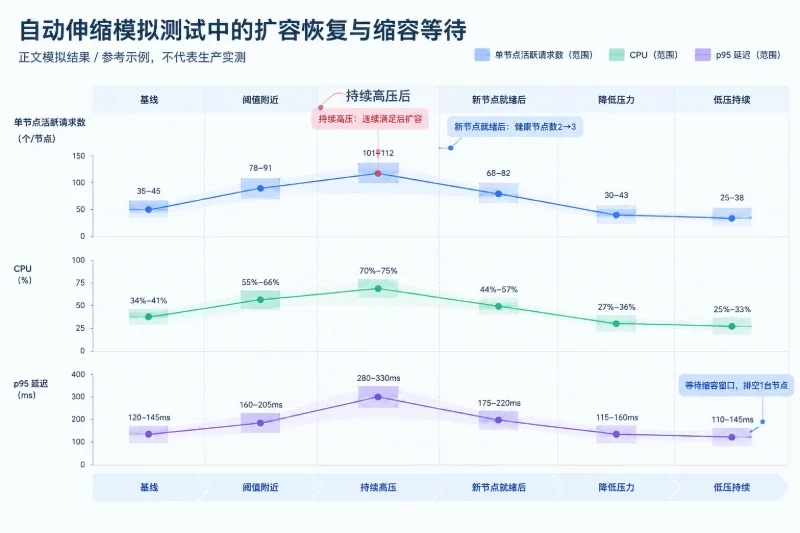
| 阶段 | 健康节点数 | 单节点活跃请求数 | CPU范围 | p95延迟 | 控制器动作 |
|---|---|---|---|---|---|
| 基线 | 2 | 35至45 | 34%至41% | 120至145ms | 保持 |
| 阈值附近 | 2 | 78至91 | 55%至66% | 160至205ms | 保持 |
| 持续高压 | 2 | 101至112 | 70%至75% | 280至330ms | 连续满足后扩容 |
| 新节点就绪后 | 3 | 68至82 | 44%至57% | 175至220ms | 保持 |
| 降低压力 | 3 | 30至43 | 27%至36% | 115至160ms | 等待缩容窗口 |
| 低压持续 | 3 | 25至38 | 25%至33% | 110至145ms | 排空1台节点 |
这个结果可以说明几个问题:
样例数据不能代替生产环境实测。正式上线前,应在相同应用版本、相同配置、相同接口类型和相近请求比例下复测。
当指标时间戳超过120秒,控制器应:
metrics_stale事件;示例日志:
{
  "event": "metrics_stale",
  "time": "2026-10-04T20:11:00+08:00",
  "last_timestamp": "2026-10-04T20:08:30+08:00",
  "action": "scale_in_blocked"
}
如果只是某一台节点指标缺失,不应立即把它判定为低负载。可以将该节点标记为unknown,在负载均衡健康状态和指标恢复前禁止把它作为缩容候选。
处理顺序如下:
释放节点属于破坏性操作,执行前必须确认:
hk-prod环境;不能使用按名称模糊匹配后批量删除的方式处理失败节点。
此时新节点可能已经运行应用,但还没有承载流量。控制器应将其标记为created_not_registered,而不是把整个扩容任务记为成功。
可按以下顺序恢复:
再次查询节点状态
→ 再次执行负载均衡成员检查
→ 重试加入操作
→ 仍失败则保持隔离
→ 超过重试次数后释放本次新建节点
重试要有上限,例如每5分钟重试一次,最多3次。不要在每个timer周期都无限重复加入请求。
如果日志中出现多个扩容任务同时进行,通常说明文件锁、状态文件或systemd配置存在问题。
检查:
systemctl status hk-autoscale.timer
journalctl -u hk-autoscale.service --since "30 min ago"
ls -l /run/lock/hk-autoscale.lock
控制器每次执行前都要检查状态文件中的operation_id和operation_started_at。如果任务已经超过合理超时,应进入人工确认状态,而不是直接开始下一次创建。
在19:40至23:00的定时窗口内,最低节点数为3。即使实时负载很低,也不能缩到2台。
窗口结束后也不要立即释放节点。控制器应恢复实时规则,等低负载条件连续满足15分钟,并经过20分钟缩容冷却后,再执行排空和缩容。
如果窗口开始时已经有3台节点,控制器不需要重复创建,只需把当前目标下限调整为3台。
上线配置前,保留上一版本路径:
readlink -f /etc/hk-autoscale/current
find /etc/hk-autoscale/releases -maxdepth 2 -type f -name config.yaml -print
发现新配置导致控制器无法启动时,先切换到上一版本:
sudo ln -sfn /etc/hk-autoscale/releases/previous \
  /etc/hk-autoscale/current

sudo systemctl start hk-autoscale.service
切换后查看:
journalctl -u hk-autoscale.service -n 100 --no-pager
cat /var/lib/hk-autoscale/state.json
不要在问题未确认前删除新版本配置,因为审计、复盘和再次验证都可能需要它。
扩容前的状态应记录为:
before_nodes = 2
requested_target = 3
created_nodes = []
registered_nodes = []
如果新节点创建后健康检查失败:
保留before_nodes中的健康节点
→ 从负载均衡中确认没有新节点成员
→ 隔离created_nodes中的失败节点
→ 释放确认属于本次任务的节点
→ 将目标恢复为2
→ 写入rollback事件
如果新节点已经加入负载均衡但加入后错误率升高:
停止新节点接收新请求
→ 等待或强制摘除新增节点
→ 保留原有健康节点
→ 观察错误率和p95恢复
→ 禁止同一版本节点继续自动扩容
若多台新节点是分批创建的,只回滚失败批次,不要误删原有节点。
缩容过程中如果drain超时:
只有在负载均衡确认节点已经不接收新请求、活跃请求降为零或达到业务允许的排空条件后,才能继续执行释放。强制终止进程或直接关机可能造成请求中断,除非已经确认该节点处于故障状态且没有业务连接。
正式启用自动伸缩前,至少完成以下检查。
min、max和扩缩容步长符合预期;Asia/Hong_Kong;nginx -t;最终可以把自动伸缩判断固定为一条可审计链路:
监控指标
→ 连续窗口确认
→ 阈值和冷却判断
→ 创建或排空节点
→ 健康检查
→ 加入或移出负载均衡
→ 结果验证
→ 审计记录
→ 失败补偿或回滚
CPU和并发阈值负责回答“什么时候需要增加容量”,性能测试负责回答“阈值应该设在哪里”,配置管理和审计负责回答“执行了什么”,而健康检查、排空和回滚负责保证“自动操作失败时不会直接影响现有业务”。这四部分同时具备,香港服务器的大流量突发场景才适合真正交给自动伸缩处理。