

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


单看 Debian 香港服务器上的 %util、iowait 或应用响应时间,都可能把问题判断错。磁盘变慢既可能是挂载参数让每次写入承担了额外同步或日志开销,也可能是底层存储已经达到 IOPS、吞吐或队列上限;内存回收、CPU 调度、网络延迟、应用锁等待和数据库提交策略,同样会改变“看起来像磁盘慢”的现象。
判断的关键不是先修改 /etc/fstab,而是在同一个观察窗口内,把挂载参数、文件系统状态、块设备队列、CPU、内存、网络、应用和数据库指标对齐。围绕“香港服务器Debian系统:文件系统挂载与磁盘IO性能最大化方案”,可以先用 findmnt 确认实际生效的参数,再用 iostat、vmstat 和进程级 I/O 数据判断:如果队列和等待时间在多个应用之间同步升高,优先怀疑存储路径或硬件额度;如果只有特定写入类型受影响,且有效挂载参数包含 sync、高日志写放大或在线 discard,才把挂载参数作为主要候选。
至少分别采集一段正常时段和一段磁盘变慢时段。短时抖动可以观察 1~5 分钟,周期性任务、数据库批处理或日志轮转造成的波动,通常应覆盖 10~30 分钟。每次采集都要保留时间戳,否则很难把请求延迟和磁盘队列对应起来。
建议先确认工具是否已经安装:
command -v iostat vmstat pidstat mpstat sar
若工具不存在,可在维护窗口安装 Debian 对应的软件包;不要为了采集指标而在高峰期批量更新系统或修改服务配置。常用采集命令如下:
date '+%F %T'
iostat -xz 1 10
vmstat 1 10
pidstat -d -p ALL 1 10
mpstat -P ALL 1 10
cat /proc/pressure/io
cat /proc/pressure/memory
这些命令的用途不同:
iostat -xz 观察块设备的读写速率、等待时间、队列和设备忙碌程度。vmstat 观察运行队列、阻塞任务、内存换入换出以及 CPU 的 wa。pidstat -d 将 I/O 归因到具体进程,避免把数据库、日志服务和备份程序混为一谈。mpstat 判断是否只有某个 CPU 核心繁忙,或者整体 CPU 已经接近饱和。/proc/pressure/io 和 /proc/pressure/memory 反映任务因 I/O 或内存资源而被延迟的时间比例。若文件不存在,说明当前内核或配置未提供 PSI 数据,不能据此认定没有压力。不要直接根据 /dev/sda 或 /dev/vda 猜测业务磁盘。Debian 服务器可能使用分区、LVM、软件 RAID 或虚拟块设备,挂载点和底层设备之间可能不是一一对应关系。
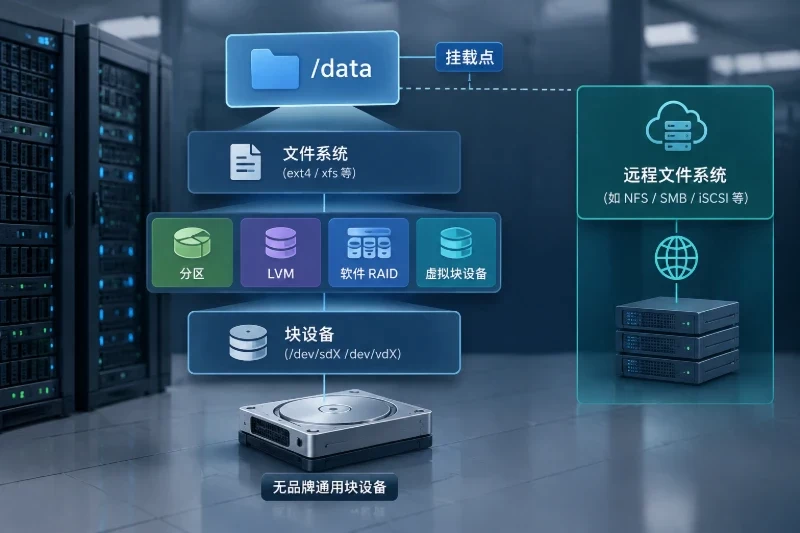
findmnt -no TARGET,SOURCE,FSTYPE,OPTIONS /
findmnt -no TARGET,SOURCE,FSTYPE,OPTIONS /data
lsblk -o NAME,TYPE,FSTYPE,SIZE,MOUNTPOINTS,RO
df -hT
df -ih
其中:
findmnt 显示当前实际生效的文件系统类型和挂载选项。lsblk 用来追踪分区、逻辑卷和底层块设备关系。df -hT 检查容量是否接近上限。df -ih 检查 inode 是否耗尽。小文件数量过多时,即使磁盘空间尚未用满,也可能出现创建文件、目录遍历和元数据操作变慢。如果 /data 显示的是网络文件系统,而不是本地块设备,判断方式需要改变:网络延迟、丢包和远端文件服务器负载也会表现为进程阻塞,但本机 iostat 未必显示对应的物理磁盘队列。
挂载参数改变的是文件系统如何提交元数据、日志和数据,不会凭空提升底层磁盘的 IOPS 或吞吐上限。下面的影响是判断方向,不应脱离业务语义直接套用。
| 参数或状态 | 可能造成的现象 | 判断边界 |
|---|---|---|
relatime | 只在必要条件下更新访问时间,通常是性能与兼容性的折中 | 常见默认行为,通常不是突发 I/O 变慢的首要嫌疑 |
noatime | 减少文件访问时间更新,元数据写入可能下降 | 依赖精确 atime 的程序可能受到影响,不能只看磁盘指标决定 |
sync | 写操作更倾向于同步完成,每次写入的等待时间可能显著增加 | 对数据库、日志、事务文件影响尤其明显;应先确认业务是否依赖该语义 |
ext4 的 data=journal | 数据和元数据都经过日志,可能增加写放大 | 一致性语义更强,但不应为了速度直接改成其他模式 |
commit=N | 改变日志提交周期和写入突发形态 | 影响数据持久化时间窗口,不能当作降低硬件延迟的开关 |
discard | 删除或释放空间时在线执行 TRIM,可能引入额外延迟 | 是否适合取决于底层存储支持方式,通常应先验证定期 TRIM 的可行性 |
| 接近满盘或 inode 用尽 | 文件创建、目录操作和后台整理可能变慢 | 这属于容量或文件系统状态问题,不等同于硬件损坏 |
| 只读重挂载、I/O 错误 | 应用出现写入失败、数据库报错或服务异常 | 应优先处理错误和数据安全,不应继续做性能调参 |
noatime 经常被当作通用优化项,但它主要减少访问时间更新,并不能解决大块顺序写已经达到存储吞吐上限的问题。相反,如果有效参数中出现 sync,且业务是大量小文件写入或频繁提交,挂载语义就可能直接放大每次写入的等待时间。
discard 也不能简单地归类为“开启更好”或“关闭更快”。部分存储对在线 TRIM 的处理延迟较高,删除大量文件时可能出现短时 I/O 抖动;另一部分存储则需要定期释放提示来维持空间管理效率。应先确认底层设备是否支持,再比较在线方式和维护窗口内定期处理方式。
块设备调度策略不是文件系统挂载参数,但它会影响队列行为。可以先查看设备实际暴露出的能力:
lsblk -d -o NAME,ROTA,SIZE,DISC-GRAN,DISC-MAX,SCHED
也可以针对已确认的设备查看可用调度器:
cat /sys/block/vda/queue/scheduler
这里的 vda 只是示例,必须替换成 lsblk 和 findmnt 查到的实际设备。虚拟服务器可能只暴露一层虚拟队列,管理员无法改变宿主机调度策略。即使能够切换调度器,也不应在生产高峰期直接修改,因为它会影响整个设备上的业务,而不是某个目录。
iostat 时不要只盯一个阈值重点观察同一设备上的以下字段:
r/s、w/s:每秒读写请求数,近似反映 IOPS 负载。rkB/s、wkB/s:每秒读写数据量。不同版本的 sysstat 显示单位可能是 kB/s,应以表头为准。await:请求从进入设备队列到完成的平均等待时间,包含排队和服务时间。aqu-sz:平均队列长度。%util:设备处于处理请求状态的时间比例。r_await、w_await:分别观察读和写的等待差异。例如,下面是一组用于解释方法的模拟数据,不代表任何实际服务器:
| 观察时段 | 读写请求 | 数据速率 | await | aqu-sz | %util | 其他指标 |
|---|---|---|---|---|---|---|
| 正常 | 约 2,000 IOPS | 读约 48 MB/s、写约 32 MB/s | 约 3 ms | 约 4 | 72% | 无明显换入换出 |
| 变慢 | 约 2,400 IOPS | 读约 50 MB/s、写约 33 MB/s | 约 38 ms | 约 60 | 99% | 多个应用同时出现 I/O 等待 |
这组变化更像是存储路径接近队列或 IOPS 上限:请求数量没有大幅增加,吞吐也接近原来的水平,但等待时间和队列长度同时升高。如果此时所有应用都变慢,且挂载参数没有变化,优先检查存储额度、底层设备状态或虚拟化平台的存储路径。
但 %util 不能单独作为结论。高并发 SSD 或 NVMe 可能在较高 %util 下仍保持较低延迟;相反,远程文件系统或某些虚拟设备即使本机 %util 不高,也可能因为远端响应变慢而阻塞。await、aqu-sz、业务响应时间和进程 I/O 必须放在同一时间窗口比较。
如果业务响应时间上升,同时出现以下现象,问题可能主要在 CPU,而不是磁盘:
mpstat 显示整体 usr 或 sys 持续较高。vmstat 的 r 长时间明显高于可用 CPU 核心数。iostat 中设备 await 和 aqu-sz 没有同步升高。pidstat -d 显示业务进程并没有明显增加读写量。iowait 高也不能直接证明磁盘是唯一瓶颈。它表示 CPU 有任务等待块 I/O 的时间比例,但如果系统同时存在内存回收、文件系统锁、虚拟化调度或大量短 I/O,iowait 可能被放大。必须继续看设备等待时间和进程归因。
内存不足时,系统可能把匿名页换出,或频繁回收文件缓存。此时磁盘读写增加,但根因并非业务主动产生了更多有效 I/O。
free -h
vmstat 1 10
cat /proc/pressure/memory
swapon --show
重点关注:
vmstat 的 si、so 是否持续有数据。free -h 中的 available 是否持续下降,而不是只看 free。iostat 中是否出现大量读写,但 pidstat -d 并没有对应的业务进程。如果 si/so 与磁盘队列同时上升,应该先处理内存工作集、进程数量或缓存策略,而不是贸然修改 noatime。Linux 使用空闲内存作为文件缓存是正常现象,单纯看到 free 较小,并不能认定内存不足。
普通本地文件系统的业务响应时间,可能受到网络请求、远程数据库或上游接口影响。此时应用线程在等待网络,但本地磁盘没有同步升高。
ss -s
sar -n DEV 1 10
ip -s link
如果挂载点本身是远程文件系统,还应特别观察网络接口的丢包、错误、重传和带宽占用。对于网络文件系统,一次文件操作的完成时间同时包含网络往返和远端存储处理,本机 iostat 的结果不能代表远端磁盘性能。
一个常见误判是:网页或接口响应变慢,应用日志恰好在同一时间增加,于是把日志写盘当成根因。应先对比业务进程的 pidstat -d、本地块设备队列和网络状态。如果本地磁盘指标平稳,而网络连接重传或远端请求耗时升高,挂载参数通常不是首要方向。
系统级 iostat 只能告诉你设备忙,不会说明是谁提交了请求。pidstat 可以进一步观察进程的读写速率和 I/O 延迟:
pidstat -d -p ALL 1 10
判断时可以按以下方式组合:
await 同步增加,同时设备队列持续上升,存储路径瓶颈的可能性更高。数据库经常使用同步写入、事务日志和周期性检查点。一次提交耗时增加,可能来自磁盘的 fsync 延迟;但查询变慢也可能是锁等待、连接池耗尽、缓存命中率下降或执行计划变化。
可以先把数据库进程在 pidstat 中单独标记,再与数据库自身的等待分类、事务提交耗时、锁等待和慢查询时间对齐。判断逻辑如下:
| 现象 | 更可能的方向 |
|---|---|
数据库日志写入量增加,写 await 和事务提交耗时同步上升 | 存储写延迟、挂载同步语义或日志盘争用 |
| 数据库查询延迟上升,但磁盘队列平稳,锁等待明显增加 | 数据库并发或事务冲突 |
| 所有查询都变慢,CPU 用户态接近满载,磁盘等待平稳 | CPU、执行计划或计算资源 |
| 数据库进程 I/O 很低,但应用接口变慢且网络请求耗时增加 | 上游网络、远程服务或连接池 |
| 检查点期间写队列短时暴涨,平时正常 | 数据库后台写入策略、日志布局或存储突发能力 |
数据库对持久化语义通常比普通缓存文件更敏感。不要为了验证速度,直接关闭同步写入、修改数据库日志策略或在生产目录运行破坏性测试。任何参数变化都应先确认数据安全要求,并准备回滚。
同时满足的条件越多,挂载参数越值得优先验证:
findmnt 显示存在与业务写入方式不匹配的选项,例如 sync,或存在明显增加日志写放大的设置。iostat 的设备吞吐并未达到历史上限,队列只在特定操作时短时尖峰。await 同方向恢复,并且在重复测试中能够复现。这里的“改变后恢复”必须是可重复的相关性,而不是一次偶然下降。比如高峰刚好结束时响应变快,不能把功劳归于刚修改的 noatime。
下面的组合更接近底层存储额度、虚拟块设备或硬件路径问题:
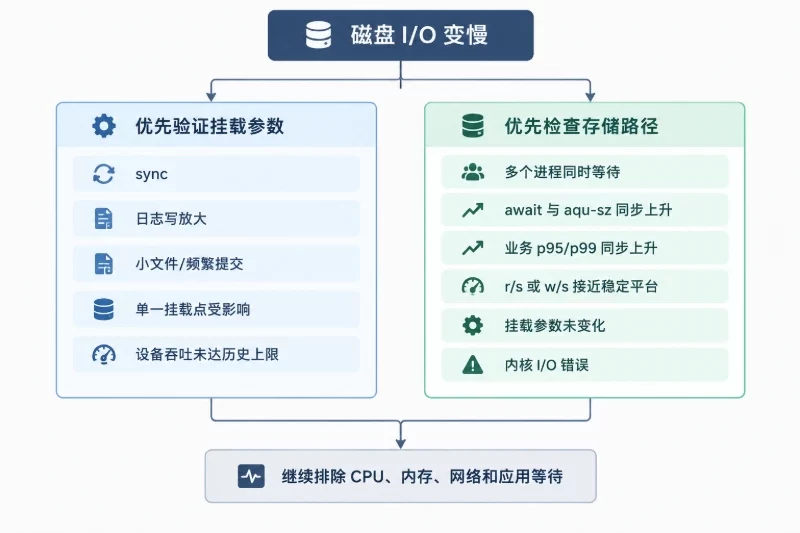
await、aqu-sz 和业务 p95/p99 延迟同步上升。r/s 或 w/s 接近一个相对稳定的平台,继续增加请求只会拉长队列。可查看近期内核日志:
journalctl -k --since "15 min ago"
如果出现 I/O 错误、设备重置或文件系统被迫只读,应先保护数据、暂停高风险写入并检查备份,不要继续反复切换挂载参数。对于虚拟服务器,即使没有物理硬盘的 SMART 信息,也可以确认“当前虚拟存储路径或分配额度存在瓶颈”;不能仅凭客户机指标断言宿主机某块物理硬盘已经损坏。
| 观察结果 | 优先判断 | 下一步 |
|---|---|---|
设备 await 高、队列长、多个进程一起等待 | 存储路径或设备瓶颈 | 核对容量、IOPS、吞吐限制和平台侧事件 |
await 不高,但 si/so 持续增加 | 内存压力诱发 I/O | 处理工作集、进程数量和交换行为 |
CPU usr/sys 高,设备队列平稳 | CPU 或应用计算瓶颈 | 查热点线程、锁和执行逻辑 |
| 只有一个进程写入异常,其他进程正常 | 应用、数据库或日志任务 | 检查进程级 I/O、任务调度和内部等待 |
| 本地磁盘平稳,网络错误或远端请求耗时升高 | 网络或远程依赖 | 对齐网络、上游请求和远程挂载状态 |
| 接近满盘、inode 用尽或出现只读重挂载 | 文件系统状态异常 | 先处理容量、错误和数据安全,再做性能验证 |
在修改 /etc/fstab 之前,先记录当前状态和备份配置文件:
findmnt -no TARGET,SOURCE,FSTYPE,OPTIONS /data
cp -a /etc/fstab "/etc/fstab.bak.$(date +%Y%m%d-%H%M%S)"
findmnt --verify --verbose
findmnt --verify --verbose 主要用于检查挂载配置的可解析性,不能代替业务验证。备份文件要保留原有权限和内容,修改范围只针对目标挂载点,不能顺手调整其他磁盘或服务。
验证挂载参数时,建议遵守以下顺序:
findmnt、iostat、vmstat、pidstat 结果。await、队列长度、进程写入量、业务 p95/p99 和错误率。修改挂载参数可能改变持久化语义、文件时间行为或故障后的数据恢复边界。涉及 sync、日志模式、错误处理和在线 TRIM 时,回滚不仅是恢复速度,也要恢复原来的数据安全语义。不要在生产挂载点直接运行会覆盖数据的磁盘压测;若必须做合成测试,应使用独立测试卷或明确隔离的测试文件,并提前确认不会触碰业务数据。
挂载参数验证最容易被业务负载变化干扰。以下条件应尽量保持一致:
如果修改 noatime 后吞吐没有变化,但目录操作延迟略有下降,这可能说明原问题确实与元数据更新有关;如果设备队列、写等待和所有应用延迟都没有改变,则不应继续围绕 atime 调参。若切换任何挂载选项都无法改变高队列和高 await,而设备读写量已经贴近稳定上限,判断应转向存储资源或平台侧限制。
某时段接口 p99 从约 120 ms 上升到 900 ms。iostat 显示写入量增加,await 从约 4 ms 上升到 15 ms,但设备队列并未持续堆积;与此同时,vmstat 的 si/so 连续出现,内存 PSI 上升,应用进程的主动写入量没有明显增加。
这种组合不支持“底层磁盘已经达到上限”的结论。更合理的解释是内存压力导致页面换入换出,磁盘被动承担了回收工作。此时修改 noatime 或调度器通常不能解决根因,应先检查进程工作集、并发增长和交换空间使用情况。
某日志处理服务出现大量小文件写入,接口 p95 与写入操作同步变慢。pidstat -d 显示主要写入者是该服务,设备吞吐只有约 10~20 MB/s,但 w_await 明显高于正常值,其他应用读写基本不变。findmnt 发现目标挂载点包含 sync,且业务并不要求每个普通日志写入都以同步方式完成。
这时挂载参数是合理候选,但仍需要维护窗口验证:先保留原配置和回滚路径,只改变一个参数,使用同样的日志批次复测。如果 w_await、应用 p95 和错误率同时改善,且业务能够接受新的持久化语义,才可以形成参数调整结论。若修改后设备队列仍然高、所有服务继续等待,则应回到存储路径判断。
下一次遇到磁盘 I/O 变慢,建议把以下指标作为一个整体采集,而不是只截取某一行 iostat:
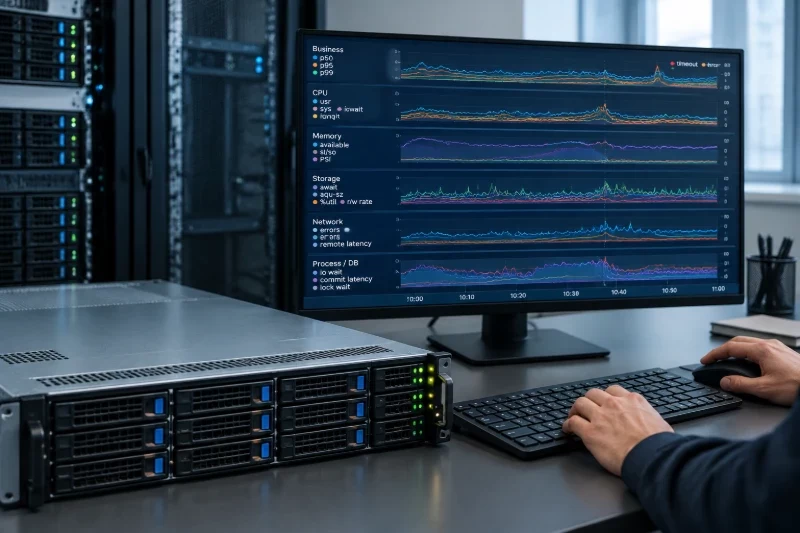
| 层次 | 同时观察的指标 |
|---|---|
| 业务 | p50、p95、p99 响应时间、超时率、错误率 |
| CPU | usr、sys、iowait、运行队列、单核是否饱和 |
| 内存 | available、si/so、内存 PSI、交换空间 |
| 存储 | r/s、w/s、读写速率、await、r_await、w_await、aqu-sz、%util |
| 文件系统 | 实际挂载参数、容量、inode、内核 I/O 错误 |
| 网络 | 接口错误、丢包、重传、远程请求耗时 |
| 应用与数据库 | 进程级 I/O、线程池、锁等待、提交或日志写入耗时 |
只有当这些指标在同一时间轴上相互印证,才能把问题从“磁盘变慢”进一步收敛为挂载参数、内存压力、CPU 饱和、网络依赖、应用等待、数据库提交,或底层存储路径瓶颈。


