

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


在 Ubuntu 香港服务器上部署 Ceph 多节点集群,建议以 3 台服务器作为起步规模:每台配置独立系统盘和至少一块可清空的数据盘,使用 cephadm 统一编排 MON、MGR 和 OSD。以下以 Ubuntu Server 22.04/24.04、Ceph Reef 系列为示例,演示从环境检查、集群引导到状态验证的完整过程。生产部署前应确认所选 Ceph 版本仍处于维护周期内,并让所有节点使用一致的 Ubuntu、Ceph 和容器运行时版本。
示例使用 3 台主机:ceph01 为引导节点,ceph02、ceph03 为另外两台节点;管理网段为 10.20.0.0/24,集群网段为 10.30.0.0/24。请将主机名、IP、网段和磁盘设备名替换为实际值。若集群只有一个网络,可不配置独立的集群网络,但生产环境应评估复制流量与客户端流量共用链路的影响。
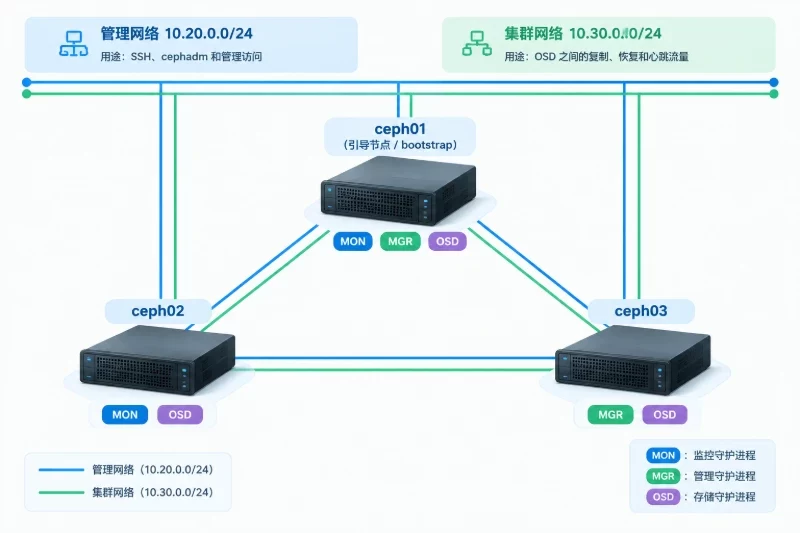
Ceph 的副本机制需要多个故障域才能发挥作用。3 台服务器是常见的入门部署规模;如果使用三副本,至少要有 3 个可用 OSD 故障域,通常将 OSD 分布在不同主机上。节点或磁盘数量不足时,集群即使能够启动,也可能无法达到预期的容错能力。
部署前确认以下条件:
Ceph 客户端与守护进程之间的网络通常称为 public network;OSD 之间复制、恢复和心跳流量可使用 cluster network。两者可以共用一个网段,也可以分开配置。使用独立网段时,所有相关节点必须具备双向可达性,并在路由、防火墙和网卡配置中保持一致。
主机防火墙或上游访问控制应按实际网段放行 Ceph 通信。常见 Ceph 服务端口包括:
端口范围和守护进程绑定方式可能随版本与配置变化。不要将上述端口无条件开放到公网;应仅允许可信管理网段和集群网段访问,并结合实际监听情况核对规则。
以下命令适用于 Ubuntu 22.04/24.04。先在每台节点上确认系统版本、主机名、地址和时间:
lsb_release -a
hostnamectl
ip -br address
timedatectl
预期所有节点显示一致的 Ubuntu 主版本,主机名互不重复,管理地址与部署规划相符,系统时间同步状态正常。若时间未同步,先启用 Ubuntu 常用的时间同步服务:
sudo apt update
sudo apt install -y chrony
sudo systemctl enable --now chrony
chronyc tracking
chronyc tracking 应能显示时间同步信息。若服务无法同步,先检查 DNS、上游时间源和防火墙,不要继续引导集群,否则证书、日志时间和节点状态可能难以判断。
在每台服务器配置主机名解析。可使用内部 DNS;小规模测试环境也可以在所有节点的 /etc/hosts 中维护一致记录。示例:
10.20.0.11 ceph01
10.20.0.12 ceph02
10.20.0.13 ceph03
检查解析结果:
getent hosts ceph01 ceph02 ceph03
每台机器都应解析到规划中的管理地址。若采用独立集群网络,需另外确认集群地址互通;不要将同一个主机名在不同节点解析成不一致的地址。
在每台节点上查看磁盘和挂载情况:
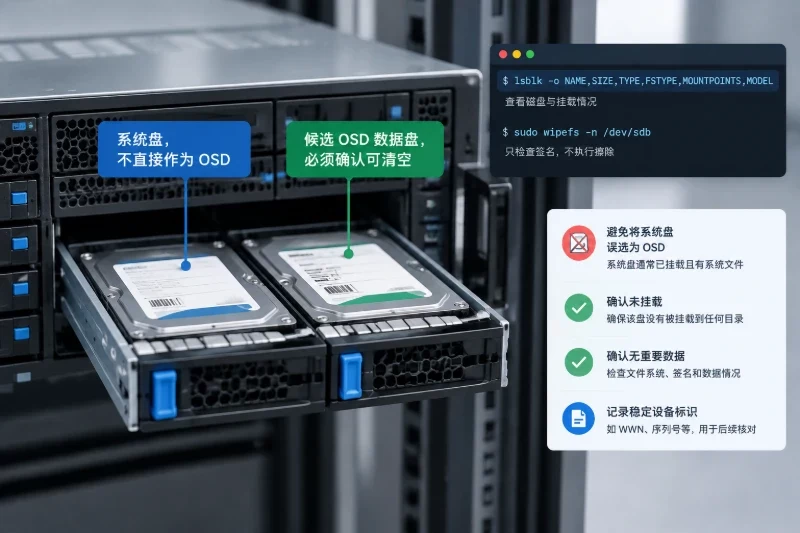
lsblk -o NAME,SIZE,TYPE,FSTYPE,MOUNTPOINTS,MODEL
sudo wipefs -n /dev/sdb
这里的 /dev/sdb 只是示例设备名。wipefs -n 只检查签名,不执行擦除。确认目标盘未挂载、没有需保留的数据,并记录设备的稳定标识。设备名可能因硬件枚举变化而改变,生产环境可结合 /dev/disk/by-id/ 识别磁盘。
在引导节点准备 SSH 密钥,并将公钥部署到其余节点。下例假设使用 root SSH:
sudo -i
ssh-keygen -t ed25519
ssh-copy-id root@ceph02
ssh-copy-id root@ceph03
ssh root@ceph02 'hostname'
ssh root@ceph03 'hostname'
如果组织策略不允许 root 直接登录,应使用符合 cephadm 要求的管理账号,并在开始前验证该账号能够完成远程管理操作。SSH 连接失败时,先检查账号、密钥、主机名解析和 TCP 22 连通性,不要通过关闭整台服务器的安全控制来绕过问题。
在引导节点上安装容器运行时及常用依赖。以下以 Ubuntu 软件仓库中的 Podman、LVM2 为例:
sudo apt update
sudo apt install -y podman lvm2 chrony curl
sudo systemctl enable --now chrony
不同 Ubuntu 软件源或 Ceph 版本对依赖的要求可能不同。安装后确认容器运行时可用:
podman --version
使用 cephadm 安装脚本添加 Ceph 软件仓库并安装工具。示例固定使用 Reef 仓库,生产环境应根据维护状态选择合适版本,并确保所有节点使用同一版本系列:
curl -fsSLO https://raw.githubusercontent.com/ceph/ceph/reef/src/cephadm/cephadm
chmod 0755 cephadm
sudo ./cephadm add-repo --release reef
sudo ./cephadm install
cephadm version
如果下载或添加仓库失败,先核对 DNS、HTTPS 出站访问、系统时间以及所选分支是否有效。不要在节点间混用不同 Ceph 主版本。
引导前确认 MON 使用的管理地址、节点名称和网络规划。若管理网段为 10.20.0.0/24,集群网段为 10.30.0.0/24,在 ceph01 执行:
sudo cephadm bootstrap \
  --mon-ip 10.20.0.11 \
  --cluster-network 10.30.0.0/24 \
  --initial-dashboard-user admin
命令会在本机引导集群、创建初始管理配置并部署首批守护进程。执行前确认该 IP 是 ceph01 的稳定地址,且不会被其他接口或节点占用。若没有独立集群网络,删除 --cluster-network 参数即可。
引导成功后,输出中通常会包含 Dashboard 访问地址和初始凭据相关信息。立即安全保存管理凭据,不要将密码写入公开文档或提交到代码仓库。验证本机管理命令可用:
sudo cephadm shell -- ceph -s
sudo cephadm shell -- ceph orch status
此时只有一个节点的集群可能显示健康告警,例如副本数不足或 MON 数量未达到预期;这并不一定代表引导失败。若命令无法连接集群或显示 MON 无法启动,应先检查 ceph01 的 IP、端口占用、容器运行时和守护进程日志,再继续扩容。
后续命令可使用 cephadm shell -- ceph ... 执行。也可在引导节点安装 ceph-common 后使用本机 ceph 命令;不要把管理密钥随意复制到普通客户端或其他无关主机。
将其余节点加入编排器。以下命令在引导节点执行:
sudo cephadm shell -- ceph orch host add ceph02 10.20.0.12
sudo cephadm shell -- ceph orch host add ceph03 10.20.0.13
sudo cephadm shell -- ceph orch host ls
主机列表应显示 ceph01、ceph02、ceph03。如果主机加入失败,检查 SSH 是否可以免交互登录、节点名称解析是否一致,以及系统时间是否正常。
将管理配置标记部署到需要执行管理命令的节点。下面示例将 ceph01 标记为管理节点:
sudo cephadm shell -- ceph orch host label add ceph01 _admin
然后部署 3 个 MON,并将其分散到三台服务器:
sudo cephadm shell -- ceph orch apply mon --placement="3 ceph01 ceph02 ceph03"
sudo cephadm shell -- ceph orch apply mgr --placement="2 ceph01 ceph02 ceph03"
MON 形成多数派后,集群控制面具备节点级冗余;MGR 部署两个实例时通常由一个处于活动状态,另一个待命。检查守护进程分布:
sudo cephadm shell -- ceph orch ps
sudo cephadm shell -- ceph quorum_status --format json-pretty
quorum_status 应能看到 MON 法定人数包含预期节点。若 MON 未加入 quorum,先检查各节点间的管理网络连通性、时间同步和 MON 端口放行情况。不要在尚未确定原因时反复删除或重建 MON。
OSD 会使用整块磁盘或符合条件的设备作为存储后端。通过编排器查看设备:
sudo cephadm shell -- ceph orch device ls --wide
目标盘应显示为空闲且可用。若设备被文件系统签名、分区、挂载或已有数据占用,Ceph 可能拒绝使用。先确认磁盘归属和数据备份,再决定是否清理。
风险提示:下面的 OSD 操作可能清除目标盘上的分区、文件系统签名和原有数据。仅对已核实为可销毁的专用数据盘执行,不要将示例设备名直接复制到生产环境。执行前记录设备序列号、容量及备份状态。
确认每台目标盘后,按主机添加 OSD。示例使用三台机器各一块 /dev/sdb:
sudo cephadm shell -- ceph orch daemon add osd ceph01:/dev/sdb
sudo cephadm shell -- ceph orch daemon add osd ceph02:/dev/sdb
sudo cephadm shell -- ceph orch daemon add osd ceph03:/dev/sdb
不要假设三台机器上的 /dev/sdb 一定对应预期磁盘。执行前应逐台核对 lsblk 输出;如果设备名不稳定,应使用核实后的设备路径。也可以在确认盘上无保留数据后由编排器应用自动发现规则,但自动发现的范围必须明确限制到专用数据设备,避免误选系统盘。
观察 OSD 创建状态:
sudo cephadm shell -- ceph orch ps --daemon_type osd
sudo cephadm shell -- ceph osd tree
sudo cephadm shell -- ceph osd stat
预期每台主机至少有一个 OSD,状态为 up 和 in。若 OSD 未出现,检查设备是否被识别、LVM 是否可用、容器是否正常,以及编排器和 OSD 日志:
sudo cephadm shell -- ceph orch device ls --wide
sudo cephadm shell -- ceph orch ps --daemon_type osd --refresh
sudo cephadm shell -- ceph health detail
MON、MGR 和 OSD 正常后,创建一个用于验证的池。示例池名为 app-pool,三副本、允许在两份副本可用时继续提供 I/O。此设置适合演示基本操作,生产环境的副本数、故障域和最小副本数应根据可用 OSD 数、数据重要性和恢复目标确定。
sudo cephadm shell -- ceph osd pool create app-pool
sudo cephadm shell -- ceph osd pool set app-pool size 3
sudo cephadm shell -- ceph osd pool set app-pool min_size 2
sudo cephadm shell -- ceph osd pool set app-pool pg_autoscale_mode on
sudo cephadm shell -- ceph osd pool application enable app-pool rbd
sudo cephadm shell -- rbd pool init app-pool
启用 RBD 应用标记并初始化池,是为了后续可作为块存储池使用;若实际用途不同,应按对应应用类型配置。三副本不会产生三倍可用容量,原始容量还要扣除副本、元数据、恢复预留空间和运行余量。
创建一个小型测试镜像,确认客户端管理路径和池配置可用:
sudo cephadm shell -- rbd create app-pool/check-image --size 1G
sudo cephadm shell -- rbd info app-pool/check-image
sudo cephadm shell -- rbd rm app-pool/check-image
最后一条命令会删除刚创建的测试镜像。只应在确认它是本次验证对象时执行;不要把该删除命令改成真实业务镜像名称。若需要验证读写,应使用独立测试客户端和测试文件,避免对生产数据执行覆盖式测试。
用以下命令检查整体状态、健康详情、主机分布和容量:
sudo cephadm shell -- ceph -s
sudo cephadm shell -- ceph health detail
sudo cephadm shell -- ceph orch host ls
sudo cephadm shell -- ceph osd tree
sudo cephadm shell -- ceph df
健康集群通常应满足:
mon 法定人数包含预期的 3 个 MON,MGR 有活动实例。up、in,并分布在计划中的主机上。active+clean。HEALTH_ERR;告警应逐条评估是否与当前节点数、容量或维护状态有关。单节点、OSD 数量不足或副本尚未恢复时出现 HEALTH_WARN 较常见,但不能一概忽略。重点按由低风险到高风险的顺序检查:
| 现象 | 优先检查 | 处理方向 |
|---|---|---|
| 主机无法加入 | DNS、SSH 密钥、主机名、时间 | 先修复管理连接,再重试主机添加 |
| MON 不在 quorum | 节点互通、MON 地址、3300/6789 端口、时间同步 | 先确认网络和服务状态,不要直接删除 MON |
| OSD 为 down 或 out | 磁盘识别、设备状态、容器运行、OSD 日志 | 确认是进程、磁盘还是网络问题,再处理对应层 |
| PG 长时间不为 clean | OSD 数量、容量余量、OSD 状态、恢复进度 | 先恢复故障 OSD 或补足故障域,避免盲目修改副本数 |
| 容量告警 | ceph df、各 OSD 使用率、池副本配置 | 清理无用测试数据或扩容;不要通过降低阈值掩盖容量风险 |
查看服务和日志时,先从编排器获取守护进程名称:
sudo cephadm shell -- ceph orch ps
sudo cephadm shell -- ceph health detail
然后根据守护进程类型和主机定位日志。不要在原因不明时直接删除 OSD 数据目录、清理整块磁盘或执行集群级重置操作。若问题出现在网络层,先分别测试管理网与集群网的双向连通性,并核对防火墙规则是否只对预期网段开放。
部署中断时,优先回退最近一步,而不是清空整个集群:
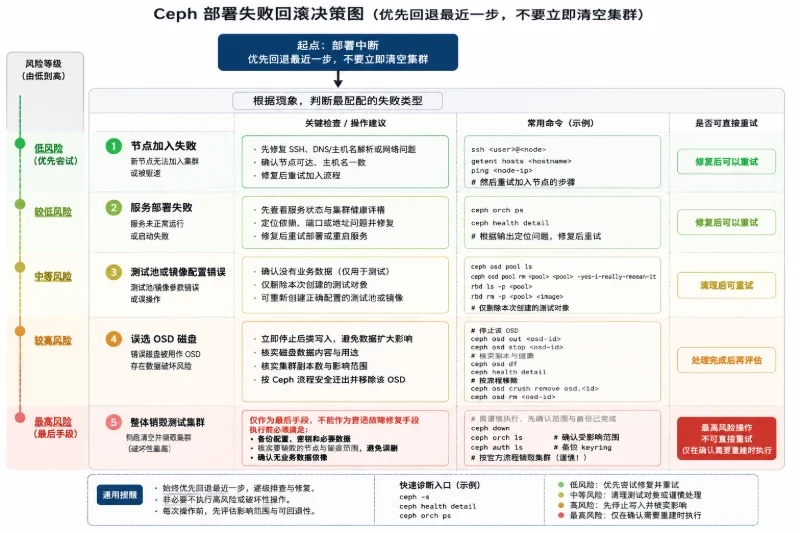
ceph orch ps 和 ceph health detail,修复依赖、端口或地址问题后重试。不要直接删除容器目录或手工清理 Ceph 配置。上线前复核所有节点的地址、时间同步、SSH 管理方式、防火墙范围和磁盘归属;确认 MON 有多数派、OSD 全部 up/in、PG 达到稳定状态,并为监控告警、容量预留、磁盘故障更换和配置备份制定维护流程。若上线前状态仍有未解释告警,应先查明原因,不要仅凭守护进程已启动就判定部署完成。


