

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


美国Linux服务器页面上的“100Mbps”或“1Gbps”,通常描述的是服务器接入端口、出口能力或服务商允许的带宽上限,并不等于某个目标用户从浏览器访问业务时能够持续获得的下载速度。跨境实际访问速度还会受到传输路径、往返时延、丢包、并发连接、服务器负载、应用响应大小以及用户本地网络的共同影响,因此出现“标称带宽很高,但页面打开或文件下载仍然偏慢”的情况,并不矛盾。
当企业采用 Linux 系统的美国服务器部署跨境业务时,最先需要确认的不是“带宽数字越大越好”,而是这个数字究竟代表端口速率、可持续保障值,还是短时突发上限;随后再用目标用户所在网络进行真实业务请求测试。只有把这两个问题分开,才能判断瓶颈到底在服务器出口,还是在跨境传输和应用本身。
服务商页面中的带宽参数,常见含义并不完全相同。采购或部署前,至少要确认以下几项:
| 需要确认的参数 | 它主要说明什么 | 它不能直接说明什么 |
|---|---|---|
| 端口速率 | 服务器网络端口理论上可处理的最高速率 | 单个用户一定能达到的速度 |
| 可持续带宽 | 在约定条件下可以长期使用的出口能力 | 所有时段、所有访问网络都能达到该速度 |
| 突发带宽 | 短时间内允许达到的峰值 | 长时间下载时的稳定速度 |
| 总出口上限 | 所有用户、所有连接合计能够使用的带宽 | 每个访问者独享的带宽 |
| 计费或流量限制 | 传输量、超额费用或使用边界 | 网络路径上的延迟和丢包情况 |
例如,1Gbps换算成理论字节速度约为125MB/s,但这是理想条件下的比特到字节换算结果。实际应用还要扣除网络协议、传输加密、数据重传和应用处理等开销。更重要的是,这125MB/s通常是整个服务器出口的理论上限,不是每个访问者都能分别得到125MB/s。
如果10个用户同时下载,服务器的出口能力需要在这些连接之间分配;如果业务本身只有几十KB的接口响应,即使服务器具备1Gbps带宽,也不代表单次请求会明显变快。带宽更像是一条道路的总通行能力,而不是每辆车固定获得的行驶速度。
用户访问美国Linux服务器时,数据不会从服务器直接“直线”抵达客户端,而是经过多个网络设备和互联环节。每个环节都可能带来排队、转发延迟或短时拥塞。服务器端的带宽只能控制服务器出口这一端,无法直接控制中间路径的实时状态。
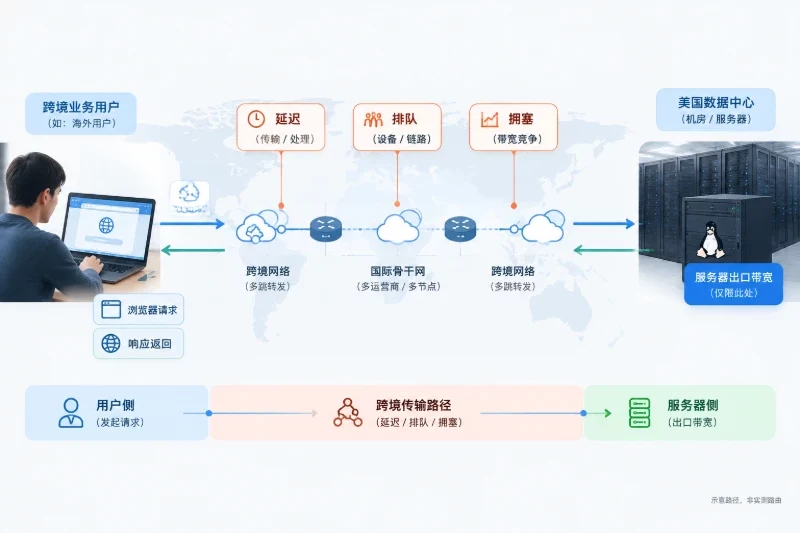
最容易被忽略的是往返时延。一次请求通常包含建立连接、发送请求、等待服务器响应和接收数据等过程。对于较小的网页、接口或管理请求,传输的数据量并不大,时延反而可能比带宽更影响响应时间。
以一组演算数据说明:如果客户端到服务器的往返时延约为180毫秒,单个TCP连接要稳定承载100Mbps的数据,链路中需要同时保持传输的数据量大约为100÷8×0.18,即2.25MB。这个数值还没有考虑丢包和重传。若连接窗口不足、请求很小,或者连接频繁建立和关闭,标称带宽就很难被单个请求充分利用。
丢包的影响通常比单纯的延迟更明显。少量丢包可能触发重传和拥塞控制,使发送端主动降低速率;当丢包和抖动持续存在时,下载速度可能表现为忽高忽低,而不是稳定地接近带宽上限。
带宽参数一般针对服务器整体出口。以下几种情况会导致单个业务请求明显低于标称值:
因此,测试时要同时观察“单连接速度”和“所有连接合计速度”。如果单个连接只有40Mbps,但10个并发连接合计能够达到400Mbps,问题可能在单连接的时延、窗口或请求模型;如果并发总速度长期停留在接近某个固定值,则更应核对服务器出口上限和服务商的带宽策略。
不同业务对带宽的敏感程度不同。
| 业务类型 | 带宽不足时的表现 | 更需要关注的条件 |
|---|---|---|
| 大文件下载 | 传输时间拉长,多个用户同时下载时更明显 | 持续出口、并发总量、文件传输稳定性 |
| 图片或静态资源访问 | 高峰期资源加载排队 | 单个文件大小、并发请求、缓存命中情况 |
| 小型接口或管理后台 | 页面可能并不快,但未必是带宽不足 | 往返时延、连接复用、服务器处理时间 |
| 文件上传 | 上传速度受用户到服务器的上行能力影响 | 用户网络、请求超时、断点续传能力 |
| 多用户同时访问 | 单个用户速度随并发数下降 | 峰值并发、总出口、应用处理能力 |
例如,一个接口只返回几十KB数据,即使将服务器出口从100Mbps升级到1Gbps,也未必能明显缩短用户等待时间。相反,如果业务需要持续传输大量文件,带宽上限和高峰期总出口就会成为更直接的约束。
Linux系统本身不会自动把标称带宽变成实际吞吐量。服务器需要同时处理连接、应用请求、数据读取和加密发送。当某一项资源达到瓶颈时,网络端口仍然空闲,访问速度也可能下降。
常见情况包括:
所以,看到客户端测速偏低时,不能立刻把问题归因于带宽。需要将客户端实际下载速度、服务器出口计数器、应用响应时间和连接状态放在同一时间段内观察。
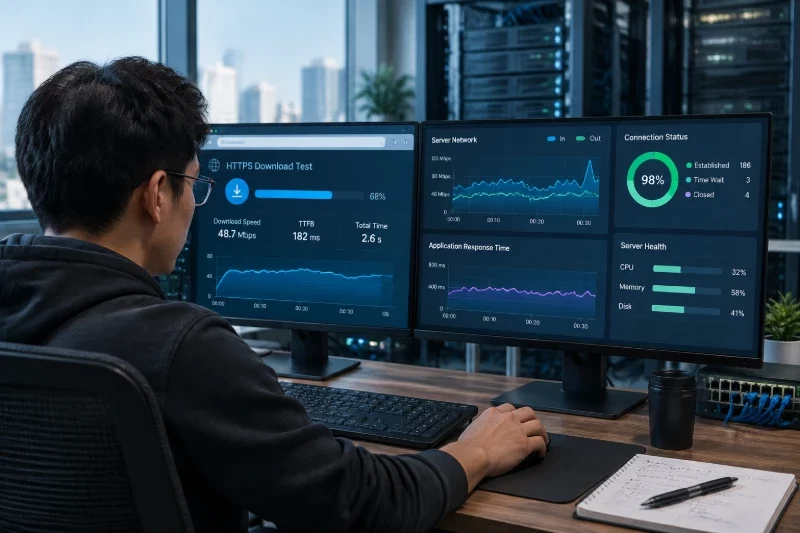
测试应尽量从目标用户实际使用的网络发起,而不是只在美国服务器本机执行。服务器本机测试往往只能说明服务器到测试目标的方向,无法代表用户访问服务器的方向。
在接近实际用户网络的Linux客户端上执行:
ping -c 20 -W 2 your-domain.example
重点观察:
ping能够帮助判断基础时延和部分丢包情况,但它不能证明HTTP或HTTPS下载速度,也不能证明业务端口一定可用。有些网络会降低或限制ICMP响应,出现无响应时,不能单凭这一点认定业务路径中断。
如果客户端安装了traceroute,可以执行:
command -v traceroute && traceroute -n -q 3 -w 2 your-domain.example
它可以帮助观察:
但traceroute中的某一跳出现*,并不必然表示该跳丢包。中间设备可能只是不回应探测报文,而后续跳点和最终目标仍然正常。判断是否影响业务,应重点看最终目标的响应和连续多次测试结果,不能只根据中间某一行下结论。
准备一个由企业自行控制的测试文件,文件大小可以按业务情况选择,例如几十MB或几百MB,避免使用过小文件导致连接建立时间占比过高。通过HTTPS直接请求该文件:
curl -o /dev/null -sS \
  -w 'dns=%{time_namelookup}s connect=%{time_connect}s start=%{time_starttransfer}s total=%{time_total}s speed=%{speed_download}B/s\n' \
  'https://download.example.com/test-file.bin'
这条命令中的地址需要替换为企业自己的测试地址。重点看:
time_connect:建立连接所需时间;time_starttransfer:收到第一部分响应前的等待时间;time_total:整个请求完成时间;speed_download:本次请求的平均下载速度。如果连接建立和首字节等待时间较长,但文件开始传输后速度稳定,问题可能偏向时延或应用处理;如果首字节很快,但下载速度始终受限,则需要继续核对出口能力、传输路径和客户端网络。
测试至少应重复多次,并覆盖业务高峰和相对空闲时段。单次结果只能代表某一时刻、某一客户端、某一个文件大小,不能直接当作所有用户的长期承诺。
在服务器上查看网络接口累计计数:
ip -s link
如果系统已安装并启用了sysstat,可以查看短时间内各接口的流量变化:
sar -n DEV 1 5
还可以查看当前套接字概况:
ss -s
这些信息应与客户端测试时间对应起来。可以按下面的方式理解结果:
面向跨境业务采购美国Linux服务器时,建议把带宽问题拆成一组可以核验的条件:
询问标称值是端口速率、长期可用带宽,还是短时突发峰值;同时确认是服务器总出口还是单连接上限。
了解多个用户同时访问时是否共享同一出口,以及是否存在单连接、单IP或持续传输限制。
核对出站流量计费、超额处理、流量封顶和高峰期限制。带宽足够但流量策略不清晰,仍可能带来成本和业务风险。
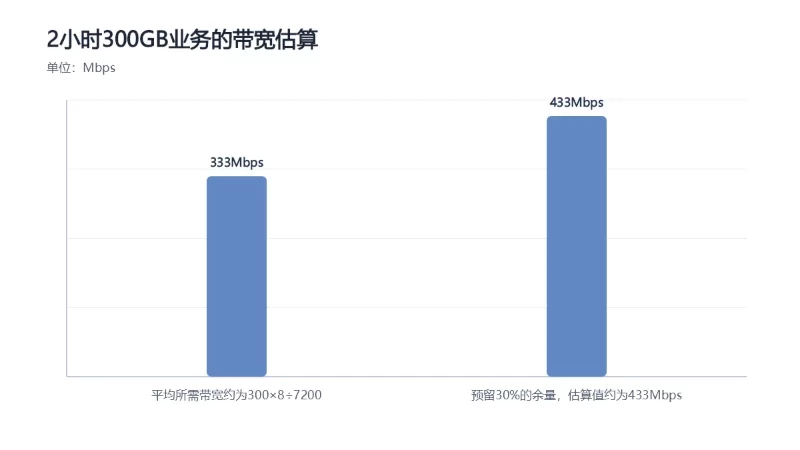
如果业务在2小时内需要传输约300GB,平均所需带宽约为300×8÷7200,即333Mbps。若预留30%的余量,估算值约为433Mbps。但如果流量集中在其中几分钟,按两小时平均值采购仍然不够,必须以更短时间窗口的峰值重新计算。
在上线前使用实际文件、实际接口和具有代表性的用户网络进行测试,并记录时延、丢包、首字节时间、单连接速度、并发总速度和服务器出口流量。
余量不是越大越好,而是要覆盖访问峰值、传输波动和短期增长。对于接口型业务,应优先改善响应时间和连接复用;对于大文件业务,才更需要把持续出口和并发吞吐放在前面。
“1Gbps一定比100Mbps快”并不总是成立。只有当业务确实受到出口容量限制,并且传输路径、服务器处理和客户端网络都能继续承载更高流量时,升级带宽才会带来明显改善。
“Ping延迟低就代表下载快”也不成立。ping只反映探测报文的往返情况,不能覆盖HTTPS握手、应用响应、文件传输和并发争用。
“服务器端测速正常就代表用户访问正常”同样不成立。服务器本机或同一网络内的测试可能绕开了真实用户会经过的跨境路径,必须从实际使用网络发起应用层请求。
带宽标称值真正有参考价值的前提,是服务商明确了参数口径,业务方掌握了峰值流量和并发模型,并且测试结果显示瓶颈确实在服务器出口。对Linux系统的美国服务器部署跨境业务而言,更稳妥的选择方法是先从业务反推所需的持续吞吐、峰值并发和可接受响应时间,再用分时段、分客户端的实际请求验证,而不是只根据页面上的“100Mbps”或“1Gbps”做判断。


