

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


以一台已经通过宝塔面板部署 Typecho 的 Linux 服务器为例:站点平时首页响应约 0.8 秒,访问变慢时升到 4~6 秒。此时不要先重启服务器或盲目增加 PHP-FPM 进程,而应把同一时间窗口内的业务现象、Nginx 访问日志、PHP-FPM 慢日志、数据库慢查询、CPU/内存/磁盘指标和告警放在一起比较。若 request_time 与 upstream_response_time 同时升高,且 PHP-FPM 慢日志也有对应 URL,问题通常在 Typecho 执行链路;若数据库慢查询与磁盘等待同时升高,则应优先检查数据库和磁盘,而不是调整 Nginx。
下面以“10:08 左右开始变慢”的示例数据说明判断过程。示例数值用于解释方法,不代表本站实测或某台服务器的实时监控结果。
| 时间窗口 | 首页 p95 响应 | Nginx 5xx | Load1 | CPU 使用率 | 磁盘等待 | PHP-FPM 活跃进程 |
|---|---|---|---|---|---|---|
| 10:00—10:05 | 0.8 秒 | 0 | 0.6 | 32% | 2% | 3/10 |
| 10:08—10:13 | 4.7 秒 | 1.2% | 3.4 | 94% | 4% | 10/10 |
| 10:14—10:19 | 1.1 秒 | 0.1% | 0.9 | 41% | 3% | 4/10 |
这组数据更像是 PHP 执行变慢或某个 Typecho 插件触发了高 CPU 逻辑,而不是网络本身变慢。真正的判断依据是多个信号在同一时间出现,并且能够沿着“客户端请求 → Nginx → PHP-FPM → Typecho/数据库”的链路互相印证。
以下步骤适用于使用宝塔面板管理的常见 Debian、Ubuntu 或 CentOS 系 Linux 服务器。不同面板版本的菜单名称可能略有差异,服务版本和路径以服务器实际输出为准。
在宝塔面板中确认:
utf8mb4。先查看服务器基本状态:
date '+%F %T %z'
nproc
uptime
free -m
df -h
df -i
uptime 中的 Load1 要结合 nproc 解读。比如服务器有 2 个逻辑 CPU,Load1 长时间接近 3,通常已经说明任务排队;如果有 8 个逻辑 CPU,Load1 为 3 未必异常。
确认宝塔网站日志位置时,不要直接猜路径:
find /www/wwwlogs -maxdepth 1 -type f -type f -name '*example.com*' -print
find /www/wwwroot/example.com -maxdepth 2 -type f -name 'config.inc.php' -print
把 example.com 替换为实际域名。宝塔常见的网站日志目录是 /www/wwwlogs/,但具体文件名可能包含域名、端口或其他后缀。
从服务器本机访问站点,可以先排除浏览器缓存和外部访问路径的干扰:
curl -sS -o /dev/null \
  -w 'code=%{http_code} dns=%{time_namelookup}s connect=%{time_connect}s start=%{time_starttransfer}s total=%{time_total}s\n' \
  --resolve example.com:443:127.0.0.1 \
  https://example.com/
连续执行 5 次,记录 starttransfer 和 total。这个测试只验证本机到 Nginx、PHP-FPM、Typecho 和数据库的处理链路,不能代表所有访问者的结果。
再分别访问一个静态文件和动态页面:
curl -sS -o /dev/null \
  -w 'static code=%{http_code} start=%{time_starttransfer}s total=%{time_total}s\n' \
  --resolve example.com:443:127.0.0.1 \
  https://example.com/favicon.ico

curl -sS -o /dev/null \
  -w 'dynamic code=%{http_code} start=%{time_starttransfer}s total=%{time_total}s\n' \
  --resolve example.com:443:127.0.0.1 \
  https://example.com/
如果静态文件很快、首页很慢,排查重点应放到 PHP-FPM、Typecho 插件和数据库;如果静态文件也慢,再检查 Nginx、磁盘、主机资源和连接状态。
默认访问日志往往只能看到状态码和 URL,无法直接知道请求究竟卡在 Nginx、PHP-FPM 还是上游处理。可以增加 request_time 和 upstream_response_time。
先备份配置。下面命令不会修改正在运行的配置,只复制文件:
sudo cp -a /www/server/nginx/conf/nginx.conf \
  "/www/server/nginx/conf/nginx.conf.bak.$(date +%Y%m%d%H%M%S)"
在 Nginx 主配置的 http {} 区域中增加一个新的日志格式。不要覆盖已有的 log_format main,避免影响其他站点:
log_format typecho_timing
    '$msec $remote_addr "$request" '
    'status=$status bytes=$body_bytes_sent '
    'rt=$request_time urt=$upstream_response_time '
    'uaddr=$upstream_addr ref="$http_referer"';
然后在对应站点的 server {} 区域,将访问日志指向该格式:
access_log /www/wwwlogs/example.com.log typecho_timing;
实际日志路径应替换为宝塔站点配置中的路径。修改前后都要检查配置:
sudo nginx -t
只有看到语法检查成功后,才执行平滑加载:
sudo systemctl reload nginx
如果 nginx -t 失败,不要 reload。恢复备份并重新检查放置位置:
sudo cp -a /www/server/nginx/conf/nginx.conf.bak.YYYYMMDDHHMMSS \
  /www/server/nginx/conf/nginx.conf
sudo nginx -t
rt 是从 Nginx 收到请求到响应完成的总耗时,urt 是上游响应耗时。对于通过 PHP-FPM 执行的 Typecho 页面,通常可以这样理解:
rt 和 urt 都高:时间主要耗在 PHP-FPM 或 PHP 调用的数据库、文件操作。rt 高但 urt 很低:可能是客户端读取慢、响应发送、静态文件或 Nginx 处理阶段耗时。urt=- 且状态码为 404:请求可能没有进入 PHP。502、504 同时出现:优先检查 PHP-FPM 进程、FastCGI Socket、进程耗尽和超时。urt 高:优先按 URL 对应的 Typecho 页面、插件或查询排查。查看最近日志:
tail -n 100 /www/wwwlogs/example.com.log
提取耗时字段进行排序:
awk -F'rt=' '{split($2,a," "); if (a[1] != "") print a[1]}' \
  /www/wwwlogs/example.com.log | sort -n | tail -n 20
查看 Nginx 是否有上游连接失败或超时:
grep -Ei 'upstream timed out|connect\(\) failed|502|504' \
  /www/wwwlogs/example.com.error.log | tail -n 50
在发现慢请求的时间点,执行:
vmstat 1 5
重点看:
r:等待运行的任务数量,持续高于 CPU 逻辑核数,说明存在运行队列。si、so:交换分区换入换出,持续非零可能意味着内存压力。wa:等待磁盘 I/O 的时间比例。us、sy:用户态和内核态 CPU 使用情况。如果服务器已安装 iostat,可以进一步查看磁盘:
iostat -xz 1 3
示例判断如下:
| 现象 | Nginx 日志 | 主机指标 | 优先方向 |
|---|---|---|---|
rt、urt 同时升高 | 大量动态 URL 变慢 | CPU 接近 100%,wa 较低 | PHP 代码、Typecho 插件或 PHP-FPM 排队 |
rt、urt 同时升高 | 伴随数据库相关错误 | wa、磁盘利用率升高 | 数据库查询、磁盘 I/O 或日志写入 |
rt 高、urt 低 | 静态和动态请求都受影响 | CPU 不高但连接数异常 | Nginx、连接、客户端读取或系统资源 |
| 502/504 增加 | PHP 请求没有正常完成 | PHP-FPM 进程消失或达到上限 | PHP-FPM 服务、Socket、超时和内存 |
| 只有单个 URL 慢 | 其他 URL 正常 | 主机指标变化不明显 | 该页面的插件、数据库查询或外部调用 |
磁盘空间和 inode 也要检查:
df -h
df -i
日志分区接近 100% 时,Nginx、PHP-FPM 或数据库可能无法继续写日志,进而出现异常。不要在故障期间直接删除日志;先备份、确认日志轮转状态,再按保留策略处理。
先确认实际 PHP-FPM 服务名称,不要直接套用未核验的服务名:
systemctl list-units --type=service --all | \
  grep -Ei 'php.*fpm|fpm'
再查看进程数量和命令行:
pgrep -af 'php-fpm'
ps -eo pid,ppid,user,%cpu,%mem,etime,cmd | \
  grep '[p]hp-fpm' | head -n 30
如果 PHP-FPM 进程数在慢请求时持续达到配置的 pm.max_children,新请求会排队。此时增加 pm.max_children 不是默认答案,因为每个 PHP Worker 都会占用内存。应先查看内存:
free -m
ps -eo comm,rss --sort=-rss | grep -E 'php-fpm|mysqld|mariadbd' | head -n 20
可以临时开启 PHP-FPM 慢日志,定位执行时间较长的脚本。先找到实际 Pool 配置:
find /www/server/php -type f \
  \( -name 'www.conf' -o -name 'php-fpm.conf' \) -print
在对应 Pool 配置中加入或调整以下内容。82 只是示例版本号,应替换为实际 PHP 版本;路径也要以配置文件已有目录为准:
request_slowlog_timeout = 3s
slowlog = /www/server/php/82/var/log/www-slow.log
修改前先备份配置,并确认 PHP-FPM 服务名称。改完后使用面板重载或重启对应 PHP 服务。重启 PHP-FPM 会中断正在处理的 PHP 请求,适合低流量窗口执行:
sudo cp -a /实际路径/www.conf \
  "/实际路径/www.conf.bak.$(date +%Y%m%d%H%M%S)"
查看慢日志:
tail -n 100 /www/server/php/82/var/log/www-slow.log
如果慢日志显示某个 Typecho 插件文件或特定页面长期占用 3 秒以上,而数据库慢查询没有同步增加,通常应:
不要在没有内存余量的情况下直接把 pm.max_children 从 10 调到 50。以一台 2GB 内存的普通博客服务器为例,数据库、Nginx、系统和缓存可能已经占用相当部分内存,PHP Worker 的实际占用还会因插件不同而变化。调整时可先增加 2~4 个进程,观察内存、交换分区和响应时间,再决定是否继续。
当 Nginx 的 urt 升高、PHP-FPM 慢日志出现对应请求,同时数据库慢查询在相同时间段增加,才有较强证据认为数据库参与了变慢。
在宝塔数据库管理入口或服务器命令行中执行只读检查。不要把数据库密码直接写进命令历史:
mysql -u数据库用户 -p
进入数据库后执行:
SHOW FULL PROCESSLIST;
SHOW GLOBAL STATUS LIKE 'Threads_connected';
SHOW GLOBAL STATUS LIKE 'Threads_running';
SHOW VARIABLES LIKE 'slow_query_log';
SHOW VARIABLES LIKE 'long_query_time';
SHOW VARIABLES LIKE 'slow_query_log_file';
重点观察:
SHOW FULL PROCESSLIST 是否有大量长时间运行的查询。Locked、Waiting for table 等等待状态。Threads_running 是否在慢请求发生时持续升高。为了定位短时间故障,可以临时开启慢查询日志:
SET GLOBAL slow_query_log = 'ON';
SET GLOBAL long_query_time = 1;
这会增加日志写入和存储压力,只建议在磁盘空间充足、故障窗口可控时使用。不要在生产高峰期长时间开启“记录所有未使用索引查询”等宽泛选项。
定位完成后,按原值恢复。例如原先 long_query_time 为 10 秒:
SET GLOBAL slow_query_log = 'OFF';
SET GLOBAL long_query_time = 10;
对于慢查询,不要直接执行删除、更新或修改表结构。先保存 SQL 文本和执行时间,再针对具体 SELECT 使用 EXPLAIN 分析索引和扫描范围。Typecho 插件产生的查询也应优先从插件配置、查询条件和版本兼容性入手。
将故障时间统一到同一时区。服务器、宝塔面板和数据库日志可能出现时区差异,先执行:
date '+%F %T %z'
timedatectl 2>/dev/null | grep -E 'Time zone|System clock'
然后以一个较窄窗口关联信号,例如 10:08:00 至 10:09:00:
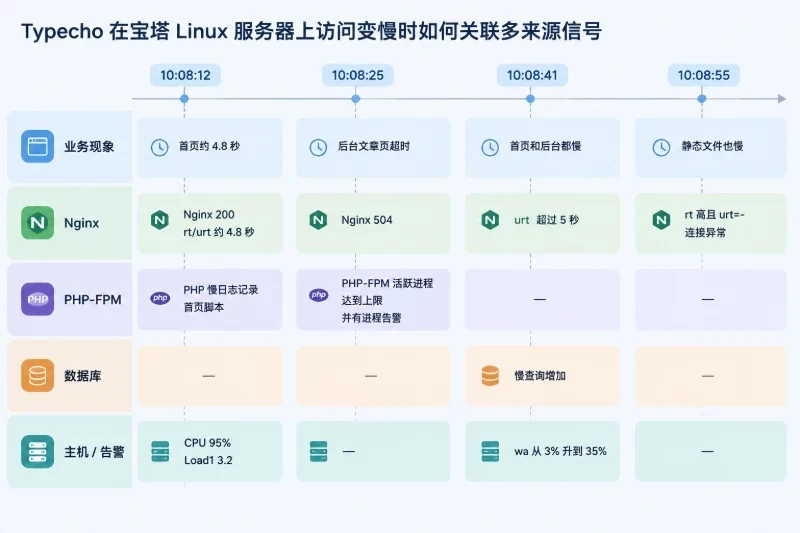
| 时间 | 业务现象 | Nginx | PHP-FPM | 数据库 | 主机/告警 | 判断 |
|---|---|---|---|---|---|---|
| 10:08:12 | 首页约 4.8 秒 | status=200 rt=4.80 urt=4.79 | 慢日志记录首页脚本 | 无慢查询 | CPU 95%,Load1 3.2 | Typecho/PHP 计算偏重 |
| 10:08:25 | 后台文章页超时 | 504 rt=60 urt=60 | 活跃进程达到上限 | 查询正常 | PHP-FPM 进程告警 | PHP-FPM 排队或单请求阻塞 |
| 10:08:41 | 首页和后台都慢 | urt 均超过 5 秒 | 多个请求同时慢 | 慢查询增加 | wa 从 3% 升到 35% | 数据库或磁盘 I/O |
| 10:08:55 | 静态文件也变慢 | rt 高、urt=- | 无 PHP 慢日志 | 无慢查询 | Nginx 连接异常 | Nginx 或系统层问题 |
这里的“链路”不一定要先安装复杂的分布式追踪系统。对于单台宝塔服务器上的 Typecho,Nginx 的请求耗时、PHP-FPM 慢日志和数据库慢查询,已经可以构成一条可用的简化链路。关键是使用同一 URL、同一时间窗口和同一故障告警进行交叉确认。
典型组合是:
rt、urt 同时升高。处理顺序:
典型组合是:
pm.max_children。request_time 明显高于平时。这时才适合小幅提高 pm.max_children。修改前备份 Pool 配置,修改后检查内存和 5xx;如果出现内存不足、系统开始交换或数据库响应变慢,应立即恢复原值。
如果 PHP-FPM 进程并未满,但请求仍长时间占用,增加进程只会放大并发压力,应继续查 PHP 慢日志和数据库。
典型组合是:
SHOW FULL PROCESSLIST 出现等待。iostat 的磁盘利用率或 vmstat 的 wa 明显升高。urt 持续偏高。先处理长时间运行的查询来源,再检查插件查询、索引和日志空间。不要通过重启数据库掩盖问题;重启会中断连接,也可能让故障证据消失。只有确认数据库进程异常、连接无法恢复,并且已经具备备份和维护窗口时,才考虑在面板中重启数据库服务。
告警不能只提示“服务器异常”,应带上站点、时间、指标当前值和关联日志路径。可先使用以下参考阈值,再根据正常基线调整:
| 告警项 | 初始参考阈值 | 持续时间 | 触发后查看 |
|---|---|---|---|
| CPU 使用率 | 大于 80% | 10 分钟 | PHP-FPM 慢日志、进程 CPU |
| Load1 | 大于逻辑 CPU 数的 1.5 倍 | 5 分钟 | vmstat、运行队列、I/O |
| 可用内存 | 低于 15% | 5 分钟 | free -m、PHP 和数据库进程 |
| 磁盘空间 | 大于 80% | 10 分钟 | 日志、数据库文件、inode |
| Nginx 5xx | 超过正常基线或 5 分钟内持续增加 | 5 分钟 | error.log、PHP-FPM 状态 |
| 页面响应 p95 | 高于基线约 2 倍,例如超过 1.5 秒 | 5 分钟 | rt、urt、PHP 慢日志 |
| PHP-FPM 进程上限 | 达到 pm.max_children | 连续多个采样周期 | Pool 配置、内存、慢请求 |
宝塔面板不同版本的监控项和告警入口可能不同。若面板只能监控 CPU、内存、磁盘和负载,至少先配置这些基础告警;站点响应时间和 5xx 则通过 Nginx 日志轮询或外部监测补充。
收到“访问变慢”告警后,固定执行同一组采样,避免每次临时猜测:
date '+%F %T %z'
uptime
free -m
df -h
vmstat 1 5
tail -n 50 /www/wwwlogs/example.com.log
如果告警时间是 10:08,而日志中最慢请求集中在 10:08:10—10:08:40,且主机指标也在同一窗口升高,关联可信度较高。如果只有用户描述变慢、服务器本机请求正常、日志也没有延迟,则不能直接把问题归因于 Typecho 或数据库。
每次只改一个变量,使用相同 URL、相同请求次数和相近时间进行对比。一个可执行的验证过程是:
如果 Nginx 配置修改后失败:
sudo nginx -t
测试不通过时不要 reload;恢复对应备份后再次测试。PHP-FPM 配置修改后如果服务无法启动,先从面板查看错误日志,再恢复 Pool 配置。确认服务名后执行状态检查:
systemctl status 实际的php-fpm服务名 --no-pager
临时开启的 PHP 慢日志和数据库慢查询日志,在定位结束后应关闭或恢复原值,避免日志持续增长。不要使用 rm -rf 清理日志目录,也不要在未确认进程和影响范围前执行 kill -9。这些操作可能直接造成日志丢失、请求中断或数据服务异常。
同一组指标在不同前提下可能代表不同问题:
因此,Typecho 部署到宝塔 Linux 服务器后出现访问变慢,最可靠的入口不是“重启后是否恢复”,而是把业务时间点与 rt/urt、PHP-FPM 慢日志、数据库慢查询、Load1、CPU、I/O 和告警逐项对齐。能够同时解释这些信号的最小故障范围,通常就是下一步最值得处理的位置。


