

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


假设一台服务器配置为 CPU:金牌 6138(20核40线程)、64GB DDR4-2666内存、960GB NVMe PCIe Gen4 SSD,业务每天新增或变更数据约12GB,最多允许丢失1小时数据,并希望故障后4小时内恢复。此时不应简单地“每天复制一次全部文件”,而应按数据类型制定方案:数据库恢复点每15~30分钟生成一次,业务文件每小时同步,完整备份每天生成,短期保留7~14天,周备份再保留1~6个月。
因此,搜索“CPU:金牌 6138(20核40线程) 内存:64GB DDR4-2666 硬盘:960GB NVMe PCIE Gen4 SSD这款香港服务器适合做什么业务”时,不能只看处理器、内存和硬盘容量。这类配置通常适合网站、CMS、管理系统、API服务、中小型电商后台、企业内部应用以及需要数据库支撑的业务;但它不应被当作唯一备份设备。业务写入量较高、要求15分钟以内数据恢复点,或要求1小时内恢复整站时,必须准备独立的备份存储,并通过恢复演练验证方案。
备份规划首先要回答三个问题:
RPO主要决定备份频率,RTO则决定备份格式、恢复路径和是否需要保留可直接启动的完整副本。每天只有一个数据库导出文件,可能适合低频内容网站,却不适合订单、库存、支付状态等每小时持续变化的业务。相反,保存大量细粒度日志可以缩短数据丢失窗口,但会增加存储占用、恢复链长度和管理复杂度。
可以先采用以下判断规则:
备份间隔应小于或等于业务允许的数据丢失窗口,并且要以“备份成功完成”的时间为准,而不是以任务开始时间为准;保留周期则应覆盖“故障发现可能延迟的时间”。
例如,系统每小时启动一次备份,但单次任务需要70分钟,实际就无法稳定满足1小时RPO。此时应缩短单次任务耗时、拆分数据类型,或者改用增量备份和数据库日志归档。
可以用一个简化公式估算备份间隔内产生的变化量:
单次变化量 ≈ 日均写入量 × 备份间隔小时数 ÷ 24
假设业务每天产生12GB新增或变更数据:
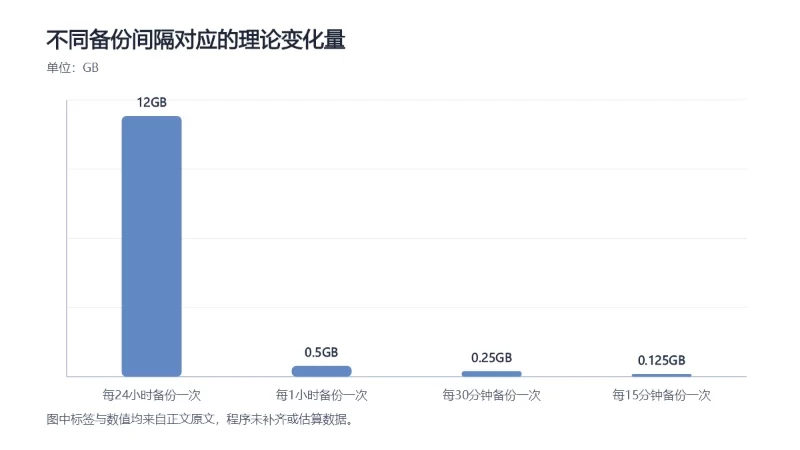
这是容量规划的起点,不等于最终备份文件大小。数据库索引更新、事务日志、重复写入、压缩率、文件修改方式以及备份软件的元数据都会改变实际占用。正式运行后,建议连续观察7~14天,至少记录日均写入量、峰值写入量、单次增量大小和任务耗时,再调整频率。
不同业务可以这样选择起点:
如果业务要求RPO为4小时,每天保存96个恢复点通常没有必要;如果要求RPO为15分钟,每天一次完整备份显然不够。频率应由业务变化速度和可接受的数据损失共同决定。
备份不应无差别复制整个系统目录。更实用的方式是把内容分为“必须恢复”“可以重新生成”和“需要单独保护”三类。
必须纳入备份的内容通常包括:
缓存、临时文件、缩略图、编译缓存和可以重新下载的依赖文件,通常可以排除。但排除前必须验证它们确实能够重新生成。例如缩略图虽然可以重新生成,但如果生成耗时很长或影响业务上线,就可以将其作为低频备份内容;运行日志如果承担审计功能,也不能简单归入可排除范围。
配置文件和密钥尤其容易被遗漏。备份密钥时要限制读取权限,并记录密钥用途、对应服务以及替换方式。只恢复了配置文件,却没有恢复密钥、证书或数据库账号,可能仍然无法启动业务。
标称960GB不等于全部可用于业务和备份。操作系统、文件系统、应用程序、数据库、临时文件以及磁盘预留空间都会占用容量。规划时建议保留约20%~25%的空闲空间,以应对数据库扩容、日志突增、备份压缩临时文件和恢复过程中的额外占用。
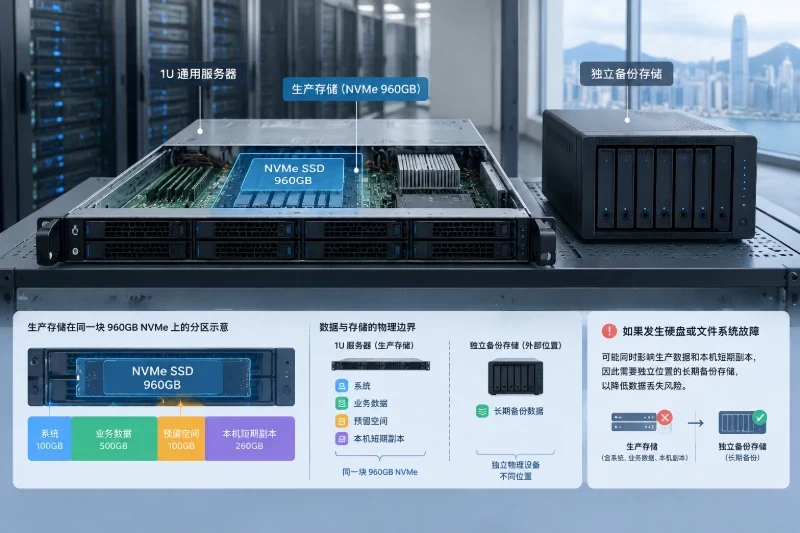
按一个估算案例计算:
如果业务每天产生12GB增量,仅保留30天增量就可能需要:
12GB × 30天 = 360GB
这还没有计算完整备份、数据库日志、校验文件和备份失败后留下的临时文件。因此,本机空间更适合保留最近3~7天的快速恢复副本,而不是承担全部长期备份。
较稳妥的布局是:
NVMe SSD可以改善本机备份和恢复时的读写条件,但它仍然与生产数据共享同一块物理存储。硬盘损坏、文件系统损坏或误执行删除操作时,生产数据和本机备份可能同时失效。
数据库正在写入时,直接复制数据目录可能得到一个不一致的副本:部分表已经写入,部分索引尚未同步,或者事务只保存了一半。复制过程即使没有报错,也不能说明副本可以可靠恢复。
以Linux服务器上的MySQL InnoDB为例,可以使用数据库自身的导出机制:
install -d -m 700 /var/backups/mysql

backup_file="/var/backups/mysql/appdb-$(date +%F-%H%M).sql.gz"

mysqldump -u backup_user -p \
  --single-transaction \
  --routines \
  --events \
  --triggers \
  appdb | gzip > "$backup_file"

gzip -t "$backup_file"
上述命令适用于备份账号已具备所需权限、数据库主要使用InnoDB表,并且Linux本机有足够临时空间的情况。--single-transaction主要适用于支持事务一致性读取的表;如果存在不支持该方式的表,导出期间可能需要锁表,进而影响写入。
执行前应确认:
mysql --version
mysql -u backup_user -p -e "SHOW TABLE STATUS FROM appdb;"
需要检查表引擎、账号权限和数据库版本。命令退出状态异常、导出文件大小明显异常或gzip -t校验失败时,不能把该文件标记为成功备份。恢复时应先导入测试数据库,确认表数量、关键记录和应用读取结果,再考虑生产切换。
数据库规模较大、写入持续密集,或者要求按时间点恢复时,应使用适合数据库版本的物理备份、事务日志或归档机制,而不是单纯提高逻辑导出的频率。逻辑备份便于迁移和单表恢复,但大库恢复时间可能较长。
PostgreSQL可以使用自带的归档格式:
install -d -m 700 /var/backups/postgresql

backup_file="/var/backups/postgresql/appdb-$(date +%F-%H%M).dump"

pg_dump -Fc -d appdb \
  -f "$backup_file"

pg_restore -l "$backup_file" > /tmp/appdb-restore-list.txt
pg_restore -l只是列出归档内容,不代表数据库已经完成恢复。正式演练时,应先准备独立测试库,再执行恢复。数据库全局对象、角色、权限和扩展如果没有单独记录,可能导致数据导入成功但应用无法连接。
用户上传文件可能仍在写入。如果同步任务正好读取到未完成文件,恢复后可能得到损坏附件。应用层可以采用“先写入临时文件,校验完成后再改名为正式文件”的方式;备份程序也可以排除临时后缀文件。
Linux下使用rsync建立本机副本时,先确认源目录和目标目录:
rsync -aH --numeric-ids \
  /srv/app/uploads/ \
  /var/backups/files/current/
这条示例没有使用--delete,适合先建立保守副本。执行前可以增加--dry-run查看变化。--delete会删除目标目录中源目录不存在的文件,只有在已经保留上一份可用副本、确认目录方向正确并完成测试后才应使用。若误用--delete,可能把备份目录中的文件一并删除,回滚只能依赖上一份独立副本。
对前述“日均写入12GB、RPO为1小时、RTO为4小时”的假设业务,可以先采用以下组合:
用于订单、库存、客户操作、支付状态等变化密集的数据:
如果数据库恢复依赖一条完整日志链,就必须保证链条连续。中间缺失一个日志文件,可能使后续恢复点无法使用,因此不能只统计“文件数量”,还要检查时间序列是否完整。
用于整套业务快速恢复:
完整副本的价值在于减少恢复时需要拼接的增量数量。即使高频日志保存完整,恢复链过长也可能超过RTO。
用于数周前才发现的误删、错误更新或数据污染:
容量估算可以写成:
预计占用 ≈ 完整备份 × 完整备份份数
        + 日均增量 × 增量保留天数
        + 数据库日志占用
        + 临时文件与校验文件
如果使用增量链或数据库日志,恢复时可能需要依次读取完整备份和多份增量。保留周期越长不一定越好,还要确认恢复链完整、恢复时间可接受,并且存储空间不会在备份过程中耗尽。
备份任务显示成功,只能证明备份流程完成,不能证明文件可读、数据库可导入或业务可以启动。恢复演练应在独立目录、测试数据库或临时业务实例中进行,不要直接覆盖生产环境。
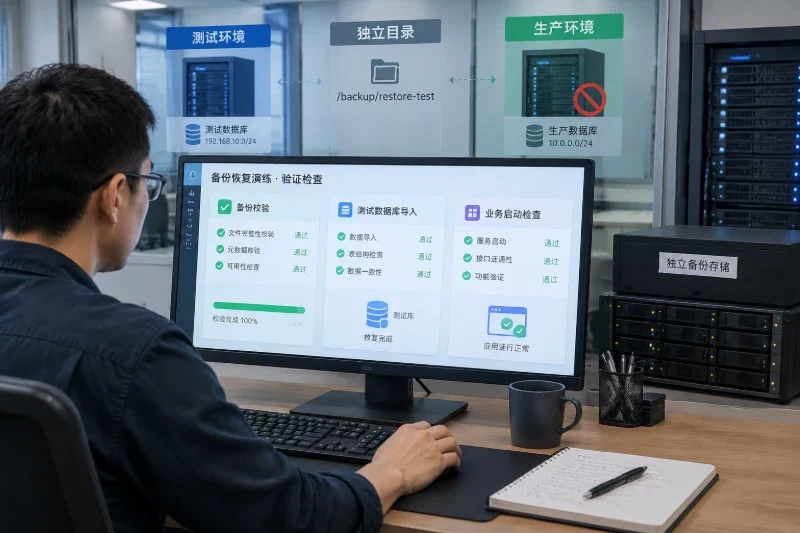
建议每月至少随机恢复一个业务文件,检查:
例如:
gzip -t /var/backups/mysql/appdb-2026-01-15-0230.sql.gz
sha256sum -c /var/backups/mysql/appdb-2026-01-15-0230.sql.gz.sha256
校验失败时,不要继续覆盖线上文件。应切换到上一份可用副本,并检查备份过程中是否被中断、磁盘是否写满,以及校验文件是否对应了错误版本。
以PostgreSQL为例,先创建专门用于演练的测试库:
createdb restore_test

pg_restore \
  -d restore_test \
  /var/backups/postgresql/appdb-2026-01-15-0230.dump
该操作的前提是当前账号有创建数据库和导入测试库的权限,且restore_test不是生产数据库。恢复完成后检查:
如果出现角色、权限或扩展缺失,应把数据库全局对象、权限清单和版本信息纳入备份范围。MySQL则应先创建测试数据库,再导入单库导出文件,确认导出内容和目标范围后再进行测试。
整站演练应模拟“原业务目录不可用”,但不能通过删除生产目录来制造故障。准备一份恢复记录,至少包含:
不同结果代表不同问题:
这台20核40线程、64GB内存和960GB NVMe SSD的服务器,适合承载中小型网站、API、管理系统和数据库业务,但硬件性能不能替代独立备份,也不能自动保证恢复时间。
以下变化出现时,应重新计算频率、容量和保留周期:
真正应作为调整依据的,是连续观察得到的写入量、峰值变化、备份大小、任务完成率、恢复耗时和业务能够接受的数据损失窗口。只要这些变量发生变化,原来的“15~30分钟数据库恢复点、每小时文件同步、每日完整备份、7~14天短期保留”就应重新验证,而不是继续沿用固定模板。


