

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


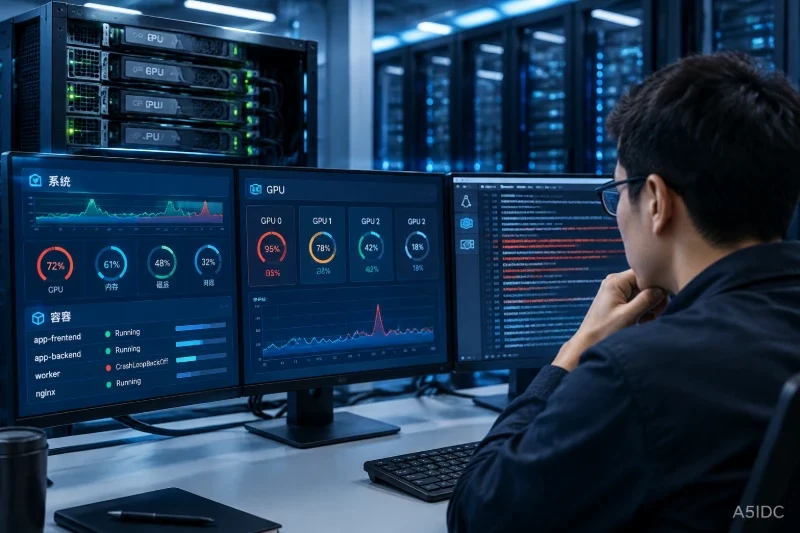
GPU任务出现报错、卡死、退出或反复重启时,最容易误判的是只看应用最后一行异常。真正的故障可能发生在更早的时间点:宿主机触发内存回收、容器被终止、GPU驱动报告设备错误,应用只是最后感知到“设备不可用”或“任务失败”。因此,定位时不能只围绕一份日志,而要把任务日志、容器状态、系统日志和GPU监控数据放到同一条时间线上。
现场排查建议遵循“先固定范围和时间,再看任务与容器,随后核对系统和GPU,最后做修复验证”的顺序。这样既能避免过早重启导致证据丢失,也能区分是应用配置问题、容器资源限制、宿主机资源不足,还是GPU驱动或设备链路异常。
| 层级 | 主要查看内容 | 重点字段 | 能回答的问题 |
|---|---|---|---|
| 任务或应用 | 训练、推理、渲染、计算任务日志 | 时间戳、任务ID、进程PID、进程组或rank、异常类型、退出码、GPU编号 | 哪个任务、哪个进程、哪个计算阶段先失败 |
| 容器或编排 | Docker日志、容器状态、Kubernetes Pod事件 | 容器ID、Pod名称、节点、重启次数、退出码、OOMKilled、启动和结束时间 | 任务是否被容器运行时或编排系统终止 |
| 宿主机系统 | systemd、内核、资源和服务日志 | 内核时间、OOM、cgroup、磁盘、驱动错误、服务重启 | 宿主机是否在任务失败前出现资源或驱动异常 |
| GPU监控 | GPU历史指标和驱动查询结果 | GPU UUID、利用率、显存、温度、功耗、进程、ECC、Xid或同类错误 | GPU是否已经异常、显存是否耗尽、故障影响哪块卡 |
同一个“任务退出”可以对应完全不同的原因。例如,应用报显存不足,不等于宿主机内存不足;容器退出码为137,也不等于一定是GPU故障;nvidia-smi当前显示正常,也不能证明故障发生时没有短暂的驱动异常。
至少记录以下信息:
Linux系统上可以先执行只读命令确认当前时间和基础环境。以下命令适用于常见的systemd Linux主机;没有systemd的环境,应使用系统自身的日志查询方式。
date -Is
timedatectl
hostname
cat /etc/os-release
free -h
df -h
df -i
如果使用的是NVIDIA GPU,可以记录当前设备和驱动可见性:
nvidia-smi -L
nvidia-smi
这些结果只能反映采集时刻的状态,不能替代历史监控。执行前应确认具备主机或容器内的读取权限,并注意日志可能包含任务参数、路径、用户名或环境变量等敏感信息,导出给其他人员前应进行脱敏。
在没有保存证据前,不建议直接重启主机、重载GPU驱动、删除容器、清理Docker资源或清空系统日志。这些操作可能使原始时间线断裂,也可能让短暂的GPU错误无法再次确认。
如果业务必须立即恢复,应先保存:
应用日志应重点查找以下字段:
多卡任务尤其要区分“第一个失败的rank”和随后被连带终止的rank。一个进程先失去GPU设备,其他进程可能只显示通信超时或同步失败。后续日志看起来更严重,但不一定是根因。
如果应用日志只显示类似“任务被终止”或“设备断开”,不要马上修改模型或任务参数,应继续核对容器和系统日志。应用往往只能报告它观察到的结果,无法说明是谁发出了终止信号。
先查看容器的最终状态、退出码和是否被判定为内存终止:
docker inspect --format 'id={{.Id}} status={{.State.Status}} exit={{.State.ExitCode}} oom={{.State.OOMKilled}} started={{.State.StartedAt}} finished={{.State.FinishedAt}}'
再按故障时间读取带时间戳的标准输出和错误输出:
docker logs --timestamps --since "" --until ""
如果任务由Docker直接启动,还应查看容器事件:
docker events --since "" --until ""
重点关注:
ExitCode是否为非零;OOMKilled是否为true;StartedAt和FinishedAt是否与应用日志吻合;退出码137通常表示进程收到SIGKILL,常见原因包括内存不足或外部强制终止,但它本身不能证明一定是内存问题。只有当OOMKilled、内核OOM记录或容器资源事件同时吻合时,才能把容器内存不足作为主要方向。退出码143通常对应SIGTERM,还要结合编排事件判断是人工停止、滚动更新、节点维护还是其他控制动作。
如果docker logs没有内容,可能是应用把日志写到了容器内文件、使用了其他日志驱动,或者容器已经被删除。此时应查看容器挂载目录、日志驱动配置和宿主机运行时日志,而不是直接认定任务没有输出。
如果任务运行在Pod中,应同时查看Pod描述、当前日志、上一次容器实例日志和事件:
kubectl get pod  -n  -o wide
kubectl describe pod  -n
kubectl logs  -n  --timestamps
kubectl logs  -n  --previous --timestamps
kubectl get events -n  --field-selector involvedObject.name= --sort-by=.lastTimestamp
重点字段包括:
Restart Count;Last State、Reason、Exit Code;OOMKilled;--previous只能读取上一次已经结束的容器实例。如果Pod经历多次重启,较早的实例日志可能已经被轮转或清理,需要依靠集中式日志系统或节点上的容器日志文件补充。
容器运行时和节点代理的服务名可能因环境不同而变化,不要直接假定服务名称。可以先列出实际服务:
systemctl list-units --type=service | grep -Ei 'docker|containerd|kubelet'
确认名称后,再读取对应时间窗口:
sudo journalctl -u  --since "" --until "" -o short-precise
sudo journalctl -u  --since "" --until "" -o short-precise
systemd主机可以先查看故障时间窗口内的告警和错误:
sudo journalctl --since "" --until "" -p warning..alert -o short-precise
sudo journalctl -k --since "" --until "" -o short-precise
针对GPU任务,可筛选常见关键词:
sudo journalctl -k --since "" --until "" -o short-precise \
  | grep -Ei 'oom|out of memory|killed process|cgroup|NVRM|Xid|gpu|pcie|aer'
需要重点观察:
Out of memory、oom-killer或cgroup内存限制;如果内核日志中出现NVIDIA的Xid或其他厂商对应的GPU错误码,应把它当作重要线索,但不要仅凭错误码直接下硬件或驱动结论。错误码的具体含义与驱动版本、设备状态和厂商文档有关,应结合前后日志、GPU监控和复现结果判断。
还要区分主机内存、容器内存和GPU显存:
GPU监控平台提供的是带时间序列的指标,虽然不一定以“日志”形式保存,但在定位短暂故障时通常比当前查询更有价值。应查看故障前后至少一个完整任务阶段,重点核对:
在NVIDIA环境中,以下命令适合做当前状态核验:
nvidia-smi -L
nvidia-smi
nvidia-smi --query-gpu=index,uuid,utilization.gpu,memory.used,memory.total,temperature.gpu,pstate,power.draw --format=csv
nvidia-smi --query-compute-apps=pid,process_name,used_memory --format=csv
不同驱动版本支持的查询字段可能不同。如果某个字段返回不支持,应先查看本机帮助信息,不要据此判定GPU故障:
nvidia-smi --help-query-gpu
nvidia-smi --help-query-compute-apps
当前查询能够回答“现在是否可见、现在有哪些进程”,不能回答“十分钟前是否曾经掉卡”。历史问题必须回到监控系统或已保存的采集日志。
日志关联不应只按“相同错误关键词”进行,而要同时满足时间、对象和因果顺序三个条件。
首先确认主机、容器日志、监控平台是否使用相同的时区。建议把所有时间转换为带时区的绝对时间,并保留原始时间。对于跨主机或跨节点任务,还要考虑时钟偏差。
应用日志可能使用本地时间,内核日志可能使用主机时间,监控系统可能统一保存为UTC。如果不先统一时间,容易把恢复动作误判为故障起点。
GPU索引可能因设备枚举顺序、容器可见设备映射或任务重启而变化。关联时优先使用:
容器内PID与宿主机PID可能不同,尤其在启用PID命名空间时,不能直接拿容器日志中的PID与主机GPU进程列表机械匹配。应结合容器ID、进程启动时间和GPU UUID共同确认。
可以建立如下时间线:
| 时间点 | 证据来源 | 关键事件 | 判断方向 |
|---|---|---|---|
| T0 | 任务日志 | 最后一次成功计算或检查点 | 确定任务正常边界 |
| T1 | GPU监控 | 显存快速上涨、利用率异常或设备指标中断 | 判断GPU侧是否先出现变化 |
| T2 | 内核日志 | OOM、驱动错误或设备访问异常 | 判断宿主机是否先感知故障 |
| T3 | 容器日志 | 收到信号、容器退出或重启 | 判断是否由运行时终止 |
| T4 | 任务日志 | 框架抛出最终异常 | 确定应用层表现 |
| T5 | 编排事件 | 重调度、驱逐或重新拉起 | 判断后续恢复动作 |
如果T2早于T4,且T2的事件与任务所在GPU或节点一致,系统或GPU侧故障的优先级更高。如果只有T4,没有T1和T2,而异常明确指向显存分配或业务参数,则应先检查任务本身的资源使用。若T3早于T4且容器被标记为OOMKilled,则应优先核对容器内存限制和主机内存压力。
| 观察结果 | 更可能的方向 | 下一步核验 |
|---|---|---|
| 应用报显存不足,监控显示显存接近上限,系统无OOM | GPU显存分配或任务峰值问题 | 核对失败批次、显存历史曲线、同一GPU上的其他进程 |
容器退出码137,OOMKilled=true,内核同时有OOM记录 | 容器或主机内存不足 | 核对容器内存限制、任务峰值和节点剩余内存 |
| 应用报设备不可用,内核先出现GPU驱动错误 | 驱动或GPU设备路径异常 | 保存驱动版本、GPU UUID和完整内核日志,避免先清除现场 |
| GPU监控在异常时段断点,容器随后退出 | GPU采集或设备可见性中断 | 对比宿主机和容器内的GPU查询结果,查看运行时事件 |
| Pod重启,事件显示探针失败或节点驱逐 | 编排层终止任务 | 查看节点事件、重启前日志和探针配置 |
| 只有一个分布式rank先失败,其余rank随后超时 | 首个rank或其GPU先异常 | 以最早失败rank为主线,关联其PID、GPU UUID和节点 |
| 应用日志没有结束记录,容器突然消失 | 外部终止、日志未落盘或容器被删除 | 查看运行时事件、节点日志和集中式日志保留情况 |
nvidia-smi当前正常,但任务之前曾失败 | 短暂故障已经恢复或当前状态与历史不同 | 依靠GPU历史监控和内核日志,不以当前状态否定历史异常 |
排查方法本身基本一致,区别主要在于能够看到哪一层日志。
在自有或托管的GPU服务器上,通常可以直接查看操作系统、容器运行时、内核和GPU驱动日志,管理员能够把主机、容器和设备信息放到同一条时间线上。但能否查看更底层的设备管理信息,仍取决于实际权限和运维方式。
在GPU云服务器上,用户通常能够查看实例操作系统、容器和任务日志,但云平台宿主机、虚拟化层或物理设备侧的日志未必对实例开放。此时,实例内没有对应内核记录,并不等于云平台侧没有事件。向平台技术支持提交问题时,应提供:
不要只提交“GPU任务失败”的描述,也不要在没有证据时直接要求更换设备。时间窗口、设备标识和原始错误信息越完整,越容易判断问题发生在应用、实例系统、容器运行时还是云平台不可见的底层范围。
故障处理完成后,至少分三层验证。
确认主机时间正常,GPU设备数量和UUID与任务预期一致,驱动查询可以正常返回。随后查看新的测试窗口内是否出现新的内核GPU错误、OOM或运行时重启。
对于已经发生过驱动或设备不可见问题的环境,不应只执行一次查询就结束。应在短时测试任务和正式任务阶段分别观察GPU监控,确认指标没有再次中断。
检查:
OOMKilled保持为false;如果修复涉及镜像、资源限制或GPU运行时配置,应把修改前后的配置版本记录下来,避免多个变量同时改变后无法判断真正原因。
先执行能够覆盖同一GPU路径的短时测试,再运行具有代表性的任务阶段。多卡任务要确认所有rank都能完成初始化、计算和退出,不能只观察主进程。正式任务结束后,还应核对检查点、输出文件和最终退出码,避免“进程退出但结果不完整”。
最容易遗漏的是复核日志保留和时间同步。很多故障并不是没有发生,而是日志已经轮转、容器重启后旧实例日志被覆盖,或者应用、主机和监控平台使用了不同时间基准。只要保留原始时间戳、容器ID、GPU UUID和第一次异常位置,系统、容器与GPU监控日志通常就能从“各自孤立的报错”还原为一条可验证的故障链。


