

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


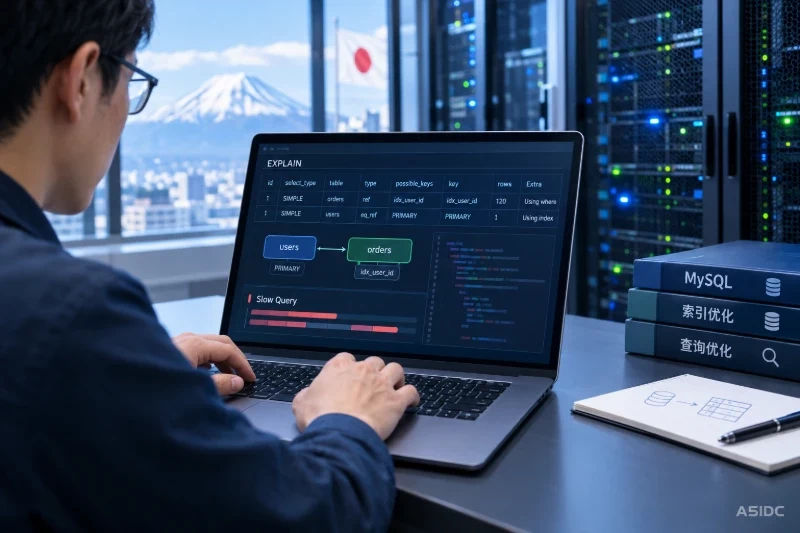
给订单表加了索引,查询却仍然很慢,常见原因不是“日本服务器性能不够”,而是索引没有服务于这条查询的筛选和排序。优化的入口应当是先确认慢的时间发生在数据库执行阶段,再查看慢 SQL 的执行计划:它从哪个索引读取、预计检查多少行、是否还要额外排序。只有找到多读数据的环节,新增或调整索引才有明确目标。
对于“按租户和状态筛选订单,按创建时间倒序取最新记录”这类查询,通常值得评估将等值筛选列放在前面、排序列接在后面的联合索引。但这不是看到慢查询就照抄的配方:现有索引、数据分布、实际 SQL 写法,以及查询是否真的耗时于读行和排序,都要先核验。下面以 MySQL 8.0 的 InnoDB 订单表为例说明判断方法;表名、字段和查询值均为示例,操作前应替换为实际业务对象。
用户看到的页面耗时,并不等于数据库执行耗时。一次请求可能包含等待连接池空闲连接、应用处理、数据库执行以及结果传输。在日本服务器上排查慢查询时,可以从同一请求的应用记录和数据库记录对齐时间:如果应用侧等待连接的时间很长,而 SQL 在数据库内执行很快,优先检查连接池占用、并发量和事务持有连接的时长;此时给表加索引未必能直接解决排队。
反过来,如果数据库记录显示某条查询反复耗时较长,且检查行数明显多于返回行数,就有理由进一步查看执行计划。不要只凭一条偶发慢记录下结论:记录 SQL 模板、绑定参数、执行时段、返回行数和耗时,区分“所有参数都慢”与“特定租户或状态才慢”。两者可能对应不同的数据分布。
缓存也会干扰观察。应用缓存命中时可能根本没有访问数据库;数据库缓存较热时,同一计划的磁盘读取又可能减少。因此,比较优化前后效果,应尽量使用相同 SQL、相近参数和相近负载,同时保留数据库执行耗时与应用端到端耗时,避免把缓存变化误认为索引效果。
假设业务常用以下查询读取某个租户的最新已支付订单:
SELECT id, created_at
FROM orders
WHERE tenant_id = 42
  AND status = 'paid'
ORDER BY created_at DESC, id DESC
LIMIT 20;
这里的 42 和 20 只用于展示 SQL 形状,不代表应采用的业务值或性能阈值。分析前,先确认实际表结构、已有索引和数据库版本;查看表结构可能涉及业务字段信息,应由有权限的人员在合适环境中执行。
SELECT VERSION();
SHOW CREATE TABLE orders;
SHOW INDEX FROM orders;
对于这条 SQL,数据库需要完成两件事:找到符合 tenant_id、status 的行,并按 created_at、id 的顺序返回前面的记录。如果只有 status 的单列索引,数据库可能仍要检查大量其他租户的订单;如果只有 (tenant_id, created_at) 索引,它虽然有机会按时间读取某租户的数据,却可能需要逐行排除不符合 status 的记录。最终采用哪种方式,取决于优化器对数据分布和成本的判断,不能仅凭索引名称推断。
可以先对与线上慢 SQL 筛选条件、排序、返回列一致的语句运行 EXPLAIN。普通 EXPLAIN 用于查看计划,不会像正常查询那样返回业务结果,适合作为较低风险的第一步。
EXPLAIN
SELECT id, created_at
FROM orders
WHERE tenant_id = 42
  AND status = 'paid'
ORDER BY created_at DESC, id DESC
LIMIT 20;
重点看 key 是否选用了预期索引、rows 的估算规模,以及 Extra 中是否出现 Using filesort 等信息。rows 是估算,不是本次真实读取行数;出现 Using filesort 也不必然是故障,小结果集排序可能很合适。真正值得追问的是:数据库是否为了返回少量记录,却检查了大量候选行,或者为了满足排序付出了明显代价。
在示例 SQL 长期保持“tenant_id 等值筛选、status 等值筛选、按创建时间和 ID 倒序取前几条”的前提下,可以评估以下联合索引:
CREATE INDEX idx_orders_tenant_status_created_id
ON orders (tenant_id, status, created_at DESC, id DESC);
它的作用可以理解为:先把同一租户、同一状态的记录放在可连续查找的范围内,再按查询需要的顺序读取。若优化器采用该索引,数据库通常更有机会在取得所需记录后停止,而不是先收集大量候选行再排序。示例查询只返回 id 和 created_at,也有机会减少回表;是否形成覆盖索引,应以实际表结构和执行计划为准。
列顺序不能机械套用“选择性最高的列放最前”。对这条查询,前两个等值条件与后两个排序列能否衔接,更值得关注。索引还要服务整个表的查询组合:如果业务经常只按 tenant_id 查,而很少按 status 查,这个索引的前缀仍可能有用;如果大量查询不带 tenant_id,它就未必适合那些查询。新增索引也会占用存储,并增加写入、更新和维护成本,因此应先检查现有索引能否满足需求,避免只换一个名字重复创建。
SQL 写法同样会影响索引效果。例如将时间字段包在函数中筛选,可能使数据库难以直接按原字段的索引范围定位;可在业务时间含义一致的前提下,改用明确的起止时间范围。但如果“某一天”是按用户时区定义的,边界必须先正确换算,不能为了让计划使用索引而改变查询结果。
对正在运行的业务库,验证可以分成以下步骤:
EXPLAIN。如果计划已能利用合适索引,检查行数也不高,应继续查等待时间和资源状态,不要直接增加相似索引。ROLLBACK 就能撤销的普通事务。EXPLAIN,观察实际选用的索引是否变化;结合相近负载下的慢查询记录,比较耗时、检查行数与返回行数,同时留意写入负载是否受到影响。若版本核验结果支持 EXPLAIN ANALYZE,还可以在可控环境中观察实际执行的行数与耗时。它会真正执行查询,不是普通 EXPLAIN 的无负载替代品;即使是只读 SELECT,较重的查询也可能占用明显资源,应先确认语句性质并选择合适时段。
EXPLAIN ANALYZE
SELECT id, created_at
FROM orders
WHERE tenant_id = 42
  AND status = 'paid'
ORDER BY created_at DESC, id DESC
LIMIT 20;
如果估算与实际读取量差距很大,可能需要检查统计信息是否反映当前数据分布;更新统计信息也可能改变该表其他 SQL 的计划,应评估影响后再操作。如果新索引没有被使用,不要立刻强制指定索引:先查参数类型、列条件、排序方向、数据分布,以及优化器选择原计划是否反而更便宜。
执行计划改善,不代表所有慢请求都会消失。若新索引使检查行数下降,但数据库执行耗时随磁盘 I/O 拥堵而波动,应结合服务器 CPU、内存压力、磁盘读写与数据库等待信息判断资源瓶颈;若 SQL 本身很快、请求仍慢,则回到连接池排队和应用链路核对。指标应与慢查询发生的时间对应,不能拿全天平均值解释某一时段的尖峰。
索引也有明确边界。查询使用很大的 OFFSET 翻页时,数据库仍可能读取并跳过前面大量记录;status 改为多个取值时,示例索引也未必还能直接满足全局时间排序。表很小、匹配范围很大,或一次要返回大量行时,扫描与排序可能比走索引更合算。这些情形应重新分析真实 SQL,而不是继续叠加索引。
如果上线后新索引未改善目标查询,或给写入带来不可接受的影响,可在确认没有其他查询依赖它后,安排窗口删除本次新建的索引;不要误删原有业务索引。删除同样属于会影响表的 DDL,需保留变更记录、确认备份,并在操作后复查执行计划和业务查询。
ALTER TABLE orders
DROP INDEX idx_orders_tenant_status_created_id;
判断一次优化是否成立,最终看三组证据能否互相印证:执行计划显示读取路径更贴合筛选与排序,数据库记录显示目标 SQL 在可比条件下少读了不必要的数据,应用请求也获得了相应改善。若只有计划“看起来更漂亮”,而实际检查行数、耗时或请求体验没有变化,就应继续定位等待和负载来源,而不是把索引当作已经完成的优化。


