

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


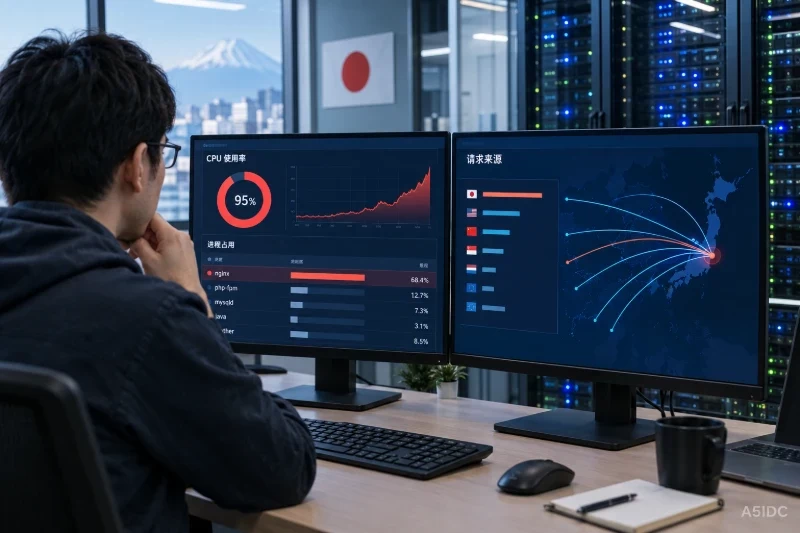
CPU曲线升高,不能直接说明“访问量太大”,更不能仅凭访问日志中出现的某个 IP 就判断它占满了日本服务器的 CPU。CPU 可能消耗在网站进程、数据库、定时任务或后台队列;访问量没有明显变化时,也可能是单次请求的计算成本变高。排查时要建立两条能对上时间的证据链:哪一个进程在消耗 CPU,以及高负载时哪些请求进入了该进程负责的业务。
如果网站正在变慢,先不要重启服务或封禁 IP。记录故障发生的时间与时区,在同一时间段采集进程、内存、磁盘和连接状态,再查看对应的访问日志。这样既能保留现场,也能避免把重启后的正常状态误当成故障原因。
本文以下命令适用于可登录的 Linux 服务器,主要使用常见的 procps 工具;访问日志示例以 Nginx 常见的 combined 格式为前提。执行前需确认自己有权限查看进程和网站日志,并知道站点实际使用的 Web 服务及日志位置。如果网站运行在容器内,还要区分是在宿主机还是容器内观察:两处看到的 PID、可用 CPU 和进程范围可能不同。
先在负载发生时取得一组现场数据:
date -Is
uptime
nproc
top -b -n 2 -d 1
ps -eo pid,ppid,user,stat,pcpu,pmem,etimes,args --sort=-pcpu | head -n 20
date -Is 用于和日志时间对齐。uptime 给出负载平均值,但负载平均值不是 CPU 使用率:等待 CPU 的任务和部分不可中断等待任务都可能计入其中。判断它是否异常,需要结合可用 CPU 数、平时基线和进程状态,而不是看到一个较大的数字就下结论。
top 连续采样两次,比只看一次更容易发现正在持续占用 CPU 的进程。Linux 上进程显示的 %CPU 可能按单个逻辑 CPU 计量,多线程进程的数值也可能超过 100%;不要直接拿它与整台机器的 CPU 百分比相加比较。ps 的 %CPU 更偏向进程运行以来的平均值,适合筛选嫌疑进程,不宜单独用来判定某一秒的尖峰。etimes 则有助于识别刚启动的任务:若高负载恰好从某个新进程出现时开始,应继续核验它的用途。
第一次采样没有抓到尖峰很常见。不要为了让截图“看起来异常”而反复刷新;应记录采样时间,在下一次业务变慢时重采,并与监控曲线、日志中的同一时段比较。
网站响应慢和 CPU 高负载可以同时出现,但不一定有相同原因。继续读取内存、等待状态和磁盘指标:
free -h
vmstat 1 5
ss -s
ss -ltnp
这些命令只读取状态,不修改服务。vmstat 的首行数据通常是启动以来的统计,重点看后续采样行。ss -ltnp 用于核对实际监听端口及其所属进程;权限不足时可能看不到完整进程信息。它不能替代访问日志统计。
| 同一时间段的信号 | 更值得追查的方向 | 单凭该信号不能证明 |
|---|---|---|
CPU 持续繁忙,top 中少数进程持续靠前 | 进一步定位进程、线程及其承担的请求或任务 | 请求一定来自某个 IP |
vmstat 的 wa 较高,进程常处于 D 状态 | 核验磁盘 I/O 或存储等待 | CPU 正在执行大量计算 |
free 中可用内存持续紧张,vmstat 的 si、so 持续出现 | 排查换页及内存压力是否放大响应时间 | 单次 free 输出就能确定内存泄漏 |
ss -s 显示连接增多 | 结合监听端口、访问日志和代理位置核验请求 | 连接数等于当前请求数,或每条连接都在耗费 CPU |
vmstat 的 st 较高 | 核验虚拟机可用的 CPU 时间及同时段表现 | 某个网站进程本身有缺陷 |
其中,wa 表示 CPU 等待 I/O 的时间占比,不能当作“磁盘使用率”;st 表示虚拟化环境中未获得的 CPU 时间,也不应算到某个站点进程头上。若怀疑磁盘等待且系统已安装 iostat,可补充执行:
iostat -xz 1 4
它的首组结果通常反映启动以来的统计,应关注后续采样中的等待时间、吞吐和队列变化,并与进程状态一起解释。单看 %util,尤其在可并行处理 I/O 的设备上,不能直接断言磁盘已达到性能上限。若命令不存在,先用已有的 vmstat、进程状态和应用日志继续排查,不必在故障高峰临时安装工具。
从 top 或 ps 记下持续靠前的 PID,而不是只截取一次排名。下面的 12345 是占位示例,执行时须替换为实际 PID:
PID=12345
ps -p "$PID" -o pid,ppid,user,stat,pcpu,pmem,etimes,args
ps -T -p "$PID" -o pid,tid,stat,pcpu,comm
readlink -f "/proc/$PID/exe"
cat "/proc/$PID/cgroup"
先核对命令行、父进程、运行用户和可执行文件,再判断它属于 Web 服务、应用工作进程、数据库,还是与网站请求无直接关系的后台任务。ps -T 可观察线程;若进程已退出,读不到 /proc 信息并不代表先前的采样错误,应到下一次高负载时重新取得 PID。部分进程信息也可能因权限而不可见。
进程状态同样会改变解释方向。持续处于 R 的线程更可能正在运行或等待 CPU;大量 D 状态线程则提示不可中断等待,需要转向 I/O 排查。S 状态通常表示正在等待事件,不能因为一个进程有许多休眠线程,就认定它占用了大量 CPU。
PID 与请求来源之间不是天然的一对一关系。一个应用工作进程可能依次处理多个访客的请求;数据库进程的计算也可能由许多不同页面调用共同触发。反过来,某个进程的高 CPU 若出现在定时任务、数据处理或队列消费期间,访问日志中最活跃的 IP 可能只是同时在线,并非原因。因此,找到进程后要先确认它在业务链路中的角色,再去关联请求。
先确认网站实际启用了哪个访问日志、日志时间使用什么时区,以及记录了哪些字段。对于 Nginx,可在有权限的环境中检查相关配置;nginx -T 会输出配置信息,结果可能包含敏感内容,不要原样对外发送:
nginx -T 2>&1 | grep -E '^[[:space:]]*(access_log|log_format|real_ip_header|set_real_ip_from)'
tail -n 3 /var/log/nginx/access.log
/var/log/nginx/access.log 只是常见路径,应以实际配置为准。下面的统计要求日志接近常见 combined 格式:第 1 列为日志记录的客户端地址,第 4 列含请求时间,第 7 列为请求目标。若日志格式经过定制,或网站使用其他 Web 服务,必须先按真实字段调整,不能直接套用列号。
在日志时间与服务器本地时间一致、故障发生于当前分钟的条件下,可以先抽取一个小时间窗:
minute="$(LC_TIME=C date '+%d/%b/%Y:%H:%M')"

tail -n 5000 /var/log/nginx/access.log |
  awk -v t="[$minute:" 'index($4,t)==1 {print $1}' |
  sort | uniq -c | sort -nr | head

tail -n 5000 /var/log/nginx/access.log |
  awk -v t="[$minute:" 'index($4,t)==1 {print $7}' |
  sort | uniq -c | sort -nr | head
第一组看日志记录的来源地址,第二组看请求目标。命令只读取文件,但排序会占用一定资源;故障期间先限定样本,避免直接对庞大日志反复做全量统计。tail -n 5000 只是取样,不代表这一分钟的完整请求:如果该分钟的日志超过取样范围,计数会偏低;如果当时没有新请求,也可能没有输出。排查历史故障时,应按实际日志时间设置 minute,并检查对应的轮转日志。
这些计数支持“某地址或某路径在样本中更活跃”,不能直接证明它造成了 CPU 高负载。还需查看高 CPU 开始前后、负载回落前后,同一路径的请求频率是否同步变化;并对照状态码、应用错误及已有的请求耗时记录。若日志原本就记录了请求耗时或上游耗时,它们可帮助区分“某类请求执行成本高”和“所有请求因服务器繁忙而一起变慢”。普通 combined 日志通常没有这些耗时字段,不应从状态码猜测执行时间。
识别来源时还要考虑代理。若站点经过反向代理或 CDN,而源站日志只记录代理地址,按第 1 列统计只能得出代理层来源;X-Forwarded-For 等请求头也只有在代理链明确、服务端仅信任可信代理时,才能用于识别原始客户端。客户端地址可能对应共享网络,User-Agent 也可被伪造。因此,“请求来源”应同时包含可信的客户端地址、请求路径、时间分布及其经过的代理层,不宜只输出一个 IP。
最终判断应能同时回答三个问题:高 CPU 时哪个进程持续繁忙;它是否负责被统计的请求;请求变化是否早于或伴随 CPU 变化。不同结果应走不同分支:
如果必须采取限流、关闭任务或调整配置等措施,先保存当前配置与关键日志,确认影响的站点和接口,并准备恢复原配置的方法;不要把尚未核实的来源直接加入封禁规则。用于定位的只读采样可继续保留,以便比较操作前后的同类指标。
复测时选择业务条件可比的时间段,重复采集 top、vmstat、连接状态和同格式访问日志:若请求量及请求结构相近,而目标进程 CPU 和页面耗时回落,处理方向才得到较强支持;若只是流量自然消退,尚不能证明改动有效。若每次业务高峰都出现相同进程持续繁忙、等待项没有成为主因,且请求与进程负载稳定相关,才适合进一步评估代码、缓存策略或容量需求。


