

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


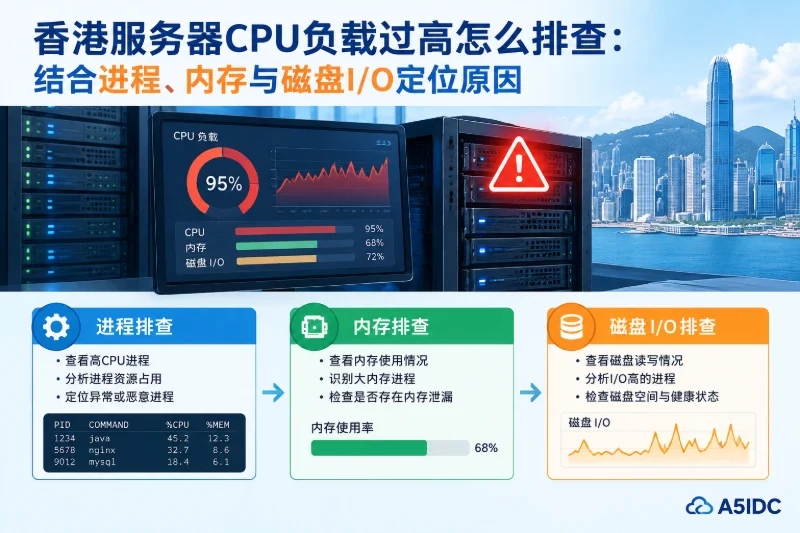
香港服务器出现访问变慢、SSH响应迟钝、接口超时或定时任务延迟时,不要只看到 load average 升高就直接判断为CPU不足。Linux中的负载值通常同时反映处于可运行状态和不可中断睡眠状态的任务,后者常见于磁盘I/O等待。因此,CPU使用率不高但负载持续升高,可能是磁盘、内存或大量阻塞进程导致。
排查时应先回答三个问题:
建议先记录当前状态,再按照“系统现象—资源类型—具体进程—业务服务”的顺序检查,避免在没有证据时重启服务或终止进程。
适用于大多数Linux发行版:
uptime
nproc
top
uptime通常会显示系统运行时间、登录用户数以及最近一段时间的负载平均值。nproc用于查看可用逻辑CPU数量。负载需要结合CPU数量和趋势判断,不能脱离环境只看一个数字。
进入 top 后,可重点观察:
load average:负载的短期、中期和长期变化趋势。%Cpu(s):用户态、系统态、I/O等待、空闲等比例。Tasks:进程总数以及运行中、睡眠中、僵死进程数量。%CPU、%MEM、STAT 和 COMMAND。如果短期负载明显升高、长期负载基本稳定,可能是一次性任务或流量波动;如果三个周期都持续上升,则更像是资源持续消耗、任务堆积或服务处理能力不足。
如果系统已安装 sysstat,可以使用:
sar -q
sar -u
sar -r
sar -b
这些命令分别用于观察运行队列与负载、CPU使用情况、内存情况以及块设备I/O。不同发行版的软件包名称和采集服务可能不同,若命令不存在,可先核验:
command -v sar
systemctl status sysstat
没有历史监控数据时,只能根据当前状态和日志进行判断,不应把一次采样结果当成长期趋势。
先确认是单个站点、单个接口,还是整台香港服务器上的所有服务都变慢:
ps -eo pid,ppid,user,stat,etime,%cpu,%mem,cmd --sort=-%cpu | head -n 20
ss -s
systemctl --failed
如果只有一个业务进程占用资源,优先检查该服务及其请求、任务和日志;如果多个服务同时响应变慢,则应先检查系统级CPU、内存和磁盘I/O。systemctl --failed仅适用于使用systemd的系统,若服务管理方式不同,应使用对应的管理工具核验。
高负载可以按以下路径分支判断:
| 观察结果 | 更可能的方向 | 下一步 |
|---|---|---|
%us或进程%CPU持续较高 | 应用计算、脚本、加密、压缩或异常循环 | 定位高CPU进程及其线程 |
%sy持续较高 | 系统调用、网络包处理、内核或设备压力 | 检查连接数、线程、I/O和系统日志 |
%wa较高,CPU空闲仍较多 | 磁盘或块设备等待 | 使用iostat、iotop确认设备和进程 |
free很低且Swap增长 | 内存不足或进程泄漏 | 查看内存占用、Swap和OOM日志 |
| 运行队列长,但单个进程不突出 | 多任务并发、线程过多或采样瞬间变化 | 查看线程、进程状态和历史数据 |
D状态进程较多 | 不可中断等待,常与I/O相关 | 检查磁盘、文件系统和相关服务 |
| 连接数异常增加 | 请求洪峰、连接泄漏或服务配置问题 | 按端口、状态和来源统计连接 |
这张表只能用于缩小范围,最终仍要把资源现象与具体进程、日志和业务行为对应起来。
先按CPU使用率排序:
ps -eo pid,ppid,user,stat,etime,%cpu,%mem,cmd --sort=-%cpu | head -n 20
也可以在 top 中按 P 按CPU排序。若安装了 htop,其交互式界面更适合观察进程和线程,但不能因为某次采样显示高占用,就立即认定该进程是根因。需要观察一段时间,并结合进程启动时间、业务日志和任务调度记录。
常见判断方式如下:
kworker等内核线程占用异常:不要直接结束,应结合系统日志、设备状态和I/O现象排查。查看进程打开的文件和工作目录:
readlink -f /proc//exe
readlink -f /proc//cwd
tr '\0' ' ' < /proc//cmdline
将 /proc通常是低风险操作,但命令行参数可能包含敏感信息,不要直接复制到公开工单或聊天环境。
一个进程整体CPU占用不高,不代表其中没有单个线程异常。使用:
top -H -p
或者:
ps -L -p -o pid,tid,stat,psr,%cpu,%mem,comm
如果某个线程持续占用CPU,应结合应用自身的线程、请求和任务信息定位。不要仅凭线程编号判断业务原因,因为不同软件的线程命名和编号规则不同。
ps -eo stat,pid,ppid,user,etime,%cpu,%mem,cmd --sort=stat | head -n 30
重点关注:
R:正在运行或等待运行,数量持续增加时可能存在CPU竞争。D:不可中断睡眠,常与磁盘、网络文件系统或设备等待有关。Z:僵尸进程,表示子进程已退出但父进程未回收。少量短暂出现不一定是故障,持续增加则应修复父进程。S:可中断睡眠,单独出现通常不能说明异常。如果确认某个进程失控,优先使用应用自身的优雅停止方式或服务管理器停止。强制结束进程可能造成请求中断、缓存丢失或数据写入不完整。执行前应确认服务可重启、数据已备份,并记录PID和命令行,便于回滚和复盘:
systemctl status
systemctl stop
systemctl start
systemctl status
如果无法确认服务与进程的对应关系,不要直接执行 kill -9。
free -h
cat /proc/meminfo | head -n 20
free -h中的 available 比单纯的 free 更适合判断系统还可供新进程使用的内存。Linux会将空闲内存用于缓存,因此“free较低”本身不等于内存不足。
需要重点观察:
available是否持续偏低;查找内存占用较高的进程:
ps -eo pid,ppid,user,stat,etime,%mem,rss,vsz,cmd --sort=-rss | head -n 20
其中 RSS 更接近进程当前驻留在物理内存中的部分,但共享库、共享内存和容器环境会影响解释,不能简单把所有进程RSS相加后与物理内存直接等同。
vmstat 1 5
dmesg -T | egrep -i 'oom|out of memory|killed process'
journalctl -k --since "1 hour ago" | egrep -i 'oom|out of memory|killed process'
vmstat中持续出现较高的换入换出活动,说明系统可能正在频繁使用Swap。若发现OOM记录,应查看被终止的进程、当时的业务请求和内存增长情况,而不是只增加Swap。增加Swap可能缓解短时内存峰值,但无法修复内存泄漏或并发失控。
针对内存异常,可按风险由低到高处理:
1. 暂停或错峰运行非必要的批处理、备份和压缩任务。
2. 降低应用并发、缓存上限或单批次数据量。
3. 修复持续增长的进程,并通过灰度重启恢复服务。
4. 在确认磁盘空间、性能和业务影响后,再评估Swap或内存配置调整。
修改Swap、服务资源限制或应用配置前,应保存原配置并确认回滚方式。不要在高负载状态下直接清空Swap或删除缓存文件,这类操作可能短时加重I/O,甚至导致服务中断。
如果系统安装了 sysstat,执行:
iostat -xz 1 5
重点看:
%util:设备忙碌程度,持续接近设备处理能力时要关注。await:I/O平均等待时间,持续升高说明请求完成变慢。r/s、w/s:读写请求数量。rkB/s、wkB/s:读写吞吐。avgqu-sz:等待队列情况。这些指标需要结合磁盘类型、文件系统、业务负载和历史基线判断,不能用一个固定数值适用于所有香港服务器。
在确认工具已安装且有足够权限时:
iotop -oPa
如果 iotop不可用,可以先通过进程I/O计数进行对比:
for p in /proc/[0-9]*; do
  pid=${p##*/}
  [ -r "$p/io" ] || continue
  awk -v pid="$pid" '
    /read_bytes|write_bytes/ {printf "%s %s ", $1, $2}
    END {print "PID=" pid}
  ' "$p/io"
done | head -n 30
该类读取操作本身风险较低,但单次结果只能表示累计值。更可靠的做法是间隔一段时间采集两次,比较读写字节的增长量,并与进程启动时间和业务任务对应。
常见根因包括:
检查磁盘空间和挂载点:
df -hT
df -ih
findmnt
df -hT用于查看容量,df -ih用于查看inode使用情况。容量未满但inode耗尽,同样可能导致新文件无法创建。不要直接删除日志、数据库文件或未知目录;清理前应确认文件归属、是否已被进程打开,并按应用的保留策略备份或归档。删除操作具有不可逆风险,必须准备恢复路径。
连接数异常可能让应用进程、内存和内核网络栈同时承压。先查看总体状态:
ss -s
ss -lntp
按TCP状态统计:
ss -ant | awk 'NR>1 {print $1}' | sort | uniq -c | sort -nr
按本地端口统计已建立连接:
ss -ant | awk 'NR>1 && $1 == "ESTAB" {print $4}' | sort | uniq -c | sort -nr
如果某个监听端口的连接数明显异常,应继续确认:
不要仅根据连接数量判断攻击或异常,也不要在未确认业务影响、备份现有规则和准备回滚方案前直接修改防火墙。防火墙调整可能误封正常访问,且会影响远程管理连接。应先保存当前规则、通过控制台或备用管理通道准备恢复方式,再进行小范围变更。
若网络连接增加同时CPU也升高,可将连接来源、访问日志、应用线程和CPU热点结合起来;若连接数不高但进程处于大量 D 状态,则网络连接可能只是表象,根因仍要回到I/O或后端依赖。
资源指标只能告诉你“哪里忙”,日志和任务记录才能帮助判断“为什么忙”。根据实际服务名检查状态和日志:
systemctl status  --no-pager
journalctl -u  --since "30 minutes ago" --no-pager
同时查看系统级错误:
journalctl -p warning..alert --since "30 minutes ago" --no-pager
如果系统不是systemd管理,需使用实际的日志路径和服务管理方式,不要假设所有发行版都使用相同文件位置。
重点对照以下时间关系:
如果重启后恢复但问题重复出现,重启只是清除了进程状态,并没有解决根因。应保留重启前的进程、内存、I/O、连接和日志证据,避免复发时无法比较。
处理后不要只看 uptime 中的负载变小,应至少完成以下验证:
uptime
vmstat 1 5
iostat -xz 1 5
free -h
ss -s
同时重新检查原先的异常进程:
ps -eo pid,ppid,user,stat,etime,%cpu,%mem,cmd --sort=-%cpu | head -n 20
验证应覆盖三个层面:
1. 资源层:CPU使用率、I/O等待、Swap活动、运行队列或连接数回到可接受的历史范围。
2. 进程层:异常进程不再持续增长,D或Z状态没有继续堆积,服务进程数量符合预期。
3. 业务层:通过实际健康检查、管理后台或受控请求确认接口、登录、任务执行和日志写入正常。
如果只是终止高CPU进程,需确认父进程没有自动重复拉起;如果调整了并发或缓存,需观察一段完整业务周期;如果清理了文件或修改了服务配置,还要确认磁盘空间、权限和服务重载状态没有引入新问题。
高负载处理完成后,建议保留一份故障前后的对比记录,至少包括:
后续监控应同时设置资源指标和业务指标。只监控CPU,可能漏掉磁盘等待和内存压力;只监控接口响应,又可能错过进程泄漏的早期信号。对香港服务器而言,真正有效的排查不是寻找一个固定阈值,而是持续建立“现象—进程—资源—日志—业务结果”的对应关系。


