

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


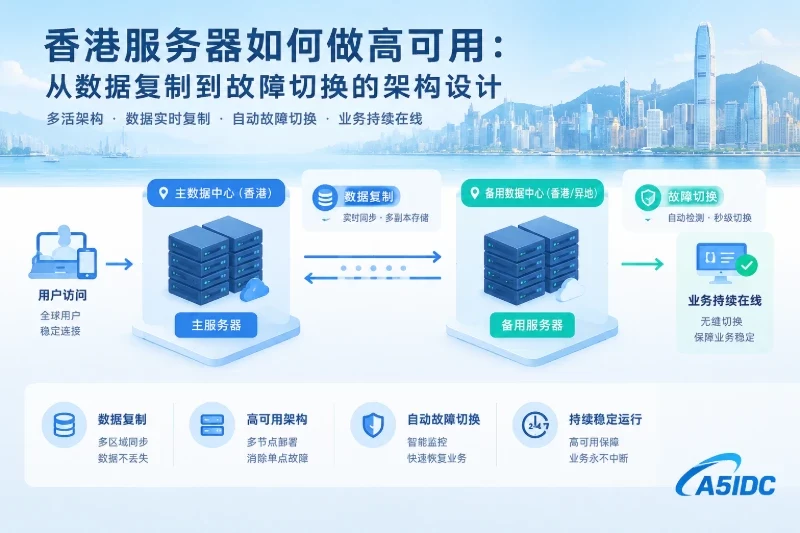
香港服务器高可用的目标,不是简单准备两台服务器,而是在入口、应用、数据和运维控制面发生故障时,仍能判断故障范围、保护写入、切换到明确的有效节点,并在恢复后确认数据一致。若两台服务器共享同一宿主机、存储、管理链路或切换凭据,底层资源仍是单点故障。
实施前先明确两个恢复指标。RPO(恢复点目标)表示故障后最多允许丢失多长时间的数据;同步复制通常更接近零数据丢失,但会受到网络和存储性能影响,异步复制则可能存在复制延迟。RTO(恢复时间目标)表示从确认故障到业务恢复所需的时间。自动切换能够缩短RTO,但必须同时具备故障判定、脑裂防护和切换后验证,否则“自动恢复”可能演变为双主写入或数据分叉。
一个可执行的香港服务器高可用方案,通常需要同时处理以下依赖:
应用节点增加后,仍要检查以下隐藏单点:共享存储是否只有一个实例、数据库认证是否依赖故障节点、DNS或服务发现是否只在一处维护、健康检查是否使用单一控制器、管理账号和证书是否无法从备用节点取得。高可用判断的是完整故障域,而不是服务器数量。
应用应尽量只保存代码、运行时文件和可丢失的临时缓存。登录会话、用户上传文件、订单与支付状态、跨节点配置和未完成任务队列,都应放在具备复制或恢复机制的组件中。若必须使用本地缓存,要明确缓存丢失后的业务影响,并验证缓存不可用时应用能够降级,而不会被入口统一判定为故障。
故障处理应遵循“由外到内、由低风险到高风险”的顺序。不要在尚未确认旧主节点状态时直接执行数据库强制提升。先确定影响范围,再逐层确认入口、应用、复制和写入方向。
在Linux管理终端执行以下只读检查,将域名替换为实际业务域名:
dig +short example.com
curl -I --connect-timeout 5 https://example.com/health
结果的含义如下:
健康检查接口应尽量验证应用是否能接收请求,而不是在每次探测中执行数据库深度读写。数据库短暂抖动时,过重的探针可能把全部节点同时摘除。更稳妥的方式是将进程、入口、数据库只读状态、队列和共享存储分别监控,并根据业务风险设置不同的摘除条件。
在疑似异常的香港服务器节点上执行:
# 适用于systemd管理的Linux系统
systemctl --failed
ss -lntp
systemctl status nginx --no-pager
systemctl status your-app.service --no-pager

# 查看最近服务日志,不清理或覆盖原日志
journalctl -u your-app.service --since "15 minutes ago" --no-pager
df -h
free -m
uptime
如果 ss 中没有业务端口,通常说明应用未监听、监听地址错误或服务未启动;如果业务端口存在但入口仍不可访问,则应继续检查反向代理、访问控制、节点间网络和健康检查配置。磁盘空间、内存、文件描述符和连接数达到限制时,服务可能表现为间歇性失败,而不是完全停止。
同时核对所有节点的健康检查路径、应用版本和配置是否一致,并确认节点时间已经同步。时间偏差可能影响TLS、令牌有效期以及数据库选主判断。若应用把会话、上传文件或临时状态写在本地磁盘,节点摘除后可能出现登录失效、文件不可见或任务丢失,这属于应用状态设计问题,不应仅通过重启服务处理。
修复单节点应用时,先从入口摘除该节点,再保留日志和当前配置,最后重启服务。重启只适用于已确认服务状态或配置问题的场景;不要用重新安装代替定位故障。修复后应先直接访问节点健康检查,再将少量流量放回入口,确认错误率没有回升。
节点之间的TCP端口可达,只能证明网络路径存在,不能证明数据库或其他数据组件已经完成复制。Linux系统中可先执行:
# 只测试连通性,不修改配置
ping -c 3 peer-hostname
nc -vz peer-hostname 5432
timedatectl status
端口应替换为实际组件使用的端口。nc失败可能由服务未监听、防火墙拦截或地址配置错误造成;连接成功后,还必须查看组件自身的复制状态。
切换前至少确认:
1. 当前主节点和候选副本的身份;
2. 最后一次成功复制时间;
3. 复制延迟或日志位点差异;
4. 候选副本是否处于可提升状态;
5. 是否存在复制槽、日志保留不足或认证失败;
6. 复制链路是否依赖故障节点上的DNS、证书或本地文件。
以PostgreSQL为例,确认版本和权限后,可在主库查询下游复制状态:
SELECT application_name,
       client_addr,
       state,
       sync_state,
       write_lag,
       flush_lag,
       replay_lag
FROM pg_stat_replication;
查询结果为空,可能表示当前实例没有下游连接,也可能说明当前实例并非主库。因此不能凭空结果直接执行提升,必须结合数据库角色和集群管理工具确认。复制延迟超过业务允许范围时,候选节点即使“在线”,也不一定满足既定RPO。
数据库配置变更前,应保存当前配置和运行状态:
# 适用于Linux系统;仅备份文本配置,不会修改服务
mkdir -p /var/backups/ha-check
cp -a /path/to/database.conf /var/backups/ha-check/database.conf.$(date +%F-%H%M%S)
路径和配置文件必须以实际数据库版本为准。复制模式、认证、归档和日志保留等变更,应先在备用节点验证,并准备使用备份文件恢复配置。不要直接套用其他版本的参数,也不要手工删除锁文件、复制标记或数据目录。
复制模式必须与业务允许的数据损失和写入中断相匹配:
监控不应只检查服务器存活,还要告警复制连接断开、延迟超限、WAL或binlog等事务日志即将被覆盖、副本磁盘不足、出现多个可写节点,以及切换控制器失去仲裁或无法访问节点。告警阈值应依据业务RPO和组件能力核定,不能用一个固定数值代替业务判断。
切换前必须确认四件事:旧主节点已经停止写入;旧主节点已被入口摘除或可靠隔离;候选节点拥有最后可确认的有效数据;应用连接池和服务发现能够指向新主节点。无法确认旧主节点是否仍可写时,先下线入口并执行隔离,而不是直接提升从库。
计划内切换时,原主库仍可访问,应先暂停或停止业务写入,等待复制追平,再切换角色。故障切换时,原主库不可访问或无法确认状态,只能依据最后确认的复制位置选择候选节点,并记录可能的RPO损失。“看起来最新”不是一致性证明;强制提升后,旧主库恢复可能形成分叉数据,通常需要重建复制关系。
一次切换应提前记录节点角色、复制延迟、入口记录、监控状态和回滚条件。推荐流程如下:
1. 暂停发布、扩容和配置修改,冻结变更。
2. 确认最近备份已完成,并至少验证过一次恢复流程。备份文件存在不等于能够恢复。
3. 从负载均衡或反向代理中摘除旧主节点;如果使用DNS切换,记录解析记录和TTL,并考虑缓存导致的过渡时间。
4. 通过维护模式或业务开关阻止新增写入。
5. 计划内切换等待副本追平;故障切换记录最后可确认的复制位置。
6. 停止旧主节点数据库写入和相关服务,必要时通过管理控制台或网络策略隔离。修改防火墙前保存现有规则,并保留带外管理通道。
7. 仅使用数据库集群工具或已验证的提升流程提升候选节点。
8. 更新数据库服务发现、连接池或应用配置,使写请求只指向新主节点。
9. 先放行少量请求,观察错误率、读写结果和复制状态,再逐步恢复流量。
10. 旧主节点恢复后不得直接作为可写节点上线,应按集群工具要求重新同步或重建后再加入。
入口健康检查通过,并不代表切换成功。验收至少要确认新主节点只有一个可写角色,新增测试数据能够按业务流程读取,登录、查询、队列和文件访问正常,监控能够识别新主节点,复制链路已经重新建立,旧节点不会再次接收写请求。对订单、支付等可重试操作,还应使用幂等键,避免连接切换或人工重试造成重复提交。
如果两台节点都显示为主节点,应立即停止对外写入,保留双方日志、事务状态和数据库现场,不要直接合并或覆盖数据。先结合备份、事务日志和业务记录确认最终有效写入,再隔离另一节点并重建复制。覆盖数据目录前必须明确备份位置、影响范围和回滚路径,因为重建可能删除或替换原节点数据。
如果从节点延迟过大仍被提升,说明原定RPO可能已经无法满足。业务必须恢复时,应记录可能丢失的数据范围,并根据应用日志、队列或备份进行补偿。恢复后检查日志保留、复制带宽、磁盘性能和长事务,避免再次出现“副本在线但数据落后”的假高可用状态。
切换后应用仍连接旧主库时,检查连接字符串、DNS、服务发现和连接池缓存。连接池可能保留旧连接,即使入口已切换,应用仍会继续向旧地址写入。可以在维护窗口重载应用或清理连接池,但要先确认不会造成重复提交。
如果健康检查通过但业务失败,应重新审查探针内容。只检查进程存活,无法发现数据库只读、队列不可用或共享存储失效。可将关键依赖拆分为不同检查项,既避免探针过轻,也避免单一深度探针给数据库制造额外压力。
回滚也不能简单理解为把DNS改回旧地址。计划内切换中,若新主节点尚未产生独有写入,可停止新主节点写入,确认旧节点数据未分叉后恢复旧节点写权限;一旦新主节点已经产生独有写入,就必须先导出、核对并处理这些数据,不能无条件回退。故障切换后通常不应立即回切,旧节点应先以副本身份重新同步,完成一致性验证,再安排下一次计划内切换。
香港服务器高可用是否成立,最终取决于故障时能否保护唯一写入方向,切换后能否验证业务和数据,恢复时能否避免旧节点重新造成分叉。复制、入口、监控、隔离、回滚和备份恢复验证缺一不可。


