

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


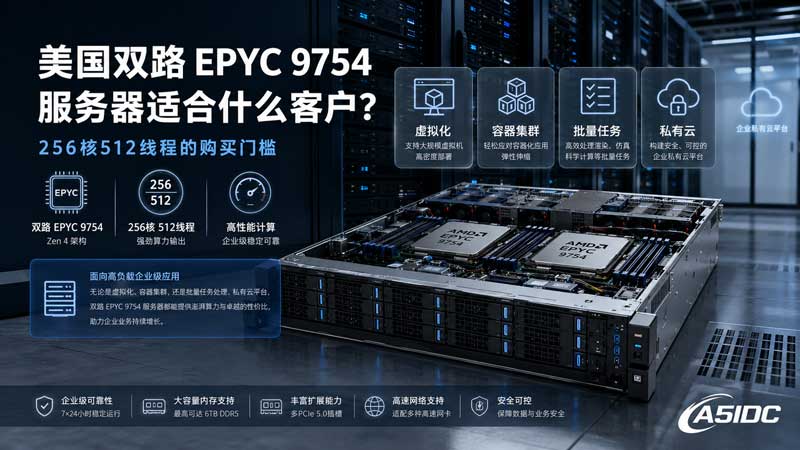
很多用户看到“双路 EPYC 9754、256核512线程”这种配置,第一反应通常是:这台机器性能肯定很强。但真正决定它值不值得买的,并不是核心数有多夸张,而是你的业务能不能把这些核心用起来。
这类美国 AMD 高性能服务器,已经不是普通建站、单个后台系统、轻量数据库能充分消化的配置。它更适合那些明确需要大量并行计算、多虚拟机承载、多容器调度、批量任务处理、私有云资源池、数据处理节点的客户。简单说,它不是“为了快一点”而买的服务器,而是“为了同时跑很多任务、长期吃满算力、减少多台服务器管理成本”而买的服务器。
根据 A5IDC 美国 AMD 服务器产品页,这款高配美国 AMD 服务器的核心配置如下:
| 配置项 | 具体参数 |
|---|---|
| CPU | 2 × AMD EPYC 9754 |
| 核心 / 线程 | 256 核 512 线程 |
| 内存 | 128GB DDR5-4800 |
| 硬盘 | 2 × 1.92TB NVMe SSD |
| 带宽 | 100M CN2 |
| IP 数量 | 1 个 |
| 价格 | ¥8999 起 / 月 |
从 CPU 本身来看,单颗 AMD EPYC 9754 就是 128 核 256 线程,基础频率 2.25GHz,最高加速频率可到 3.1GHz,L3 缓存为 256MB,默认 TDP 为 360W。双路部署后,整机算力密度非常高,更偏向数据中心里的高并发、多任务和虚拟化负载,而不是传统意义上的“单个网站服务器”。
如果只是一个企业官网、WordPress 站点、普通商城、CRM 后台,哪怕访问量不低,也很难把 256 核 512 线程发挥出来。因为这类业务的瓶颈往往不在 CPU 核心数量,而在程序架构、数据库查询、缓存命中率、带宽、磁盘 I/O 或代码本身。
这台机器真正适合的是下面几类客户。
比如你要在美国节点搭建 Proxmox、KVM、VMware ESXi 类虚拟化环境,给多个业务部门、多个客户项目或多个测试环境分配独立虚拟机,这种双路 EPYC 9754 就有明显价值。
它的优势不是“单个虚拟机更快”,而是可以同时承载更多虚拟机。例如可以按业务轻重做这样的分配:
| 虚拟机类型 | 建议分配 |
|---|---|
| 小型网站 / 管理后台 | 2-4 vCPU / 4-8GB 内存 |
| 中型应用服务 | 8-16 vCPU / 16-32GB 内存 |
| 数据处理节点 | 16-32 vCPU / 32GB+ 内存 |
| 编译 / 批处理节点 | 16-64 vCPU,按任务量弹性分配 |
但这里要注意一个关键点:CPU 很富余,内存不一定富余。
这台配置是 128GB DDR5 内存,放在 512 线程面前,其实内存容量并不算特别大。粗略计算,平均到每个线程只有 256MB 左右内存空间。也就是说,如果你计划创建大量虚拟机,真正限制数量的可能不是 CPU,而是内存。
所以它更适合“CPU 密集型虚拟化”,不太适合每台虚拟机都要大内存的数据库集群型虚拟化。
这类服务器特别适合大量任务并行运行,比如:
这类业务有一个特点:任务可以拆开,并且可以同时跑很多份。
例如你有 500 万张图片要压缩,如果用普通 16 核服务器,可能要排队很久;但如果任务调度做得好,在 256 核服务器上可以同时开很多 worker,整体完成时间会明显缩短。
不过这里也有门槛:程序必须支持并发任务调度。
如果你的程序本身只能单线程运行,或者任务队列没有设计好,那么 512 线程看起来很强,实际可能只有十几个线程在工作,剩下的核心都在空闲。
对于 Docker、Kubernetes、CI 测试环境、SaaS 多租户服务来说,这类机器可以作为一个高密度计算节点使用。
例如一个企业有很多内部系统:
如果每个服务单独买一台小机器,数量多、管理复杂、资源利用率也不一定高。双路 EPYC 9754 的价值在于可以把大量服务集中到一个强计算节点上,再通过容器资源限制来做隔离。
推荐做法是:
docker run -d \
  --cpus="8" \
  --memory="16g" \
  --name app-worker \
  your-app-image
不要让所有容器无限制抢 CPU。
这类大核心机器最怕“资源看起来很多,所以不做限制”。一旦某个异常任务疯狂占用 CPU 或内存,就可能影响整台物理机上的其他服务。
如果企业内部有研发、测试、数据分析、运维实验环境,经常需要临时开机器、跑任务、部署测试环境,这类服务器适合作为美国节点的私有云资源池。
它的优势是:
但它不适合拿来当“便宜云主机批发机”盲目切小 VPS。因为内存、IP 数、带宽都不是无限的。如果大量小 VPS 同时跑网站、下载、代理、爬虫,最终瓶颈会很快从 CPU 转移到内存、网络和磁盘队列。
很多人以为门槛是价格,其实价格只是表面。真正门槛主要有四个。
这类服务器最适合“多任务同时跑”,而不是“单任务跑得特别快”。
例如:
| 业务类型 | 是否适合 |
|---|---|
| 单个 WordPress 网站 | 不适合,明显浪费 |
| 单个企业官网 | 不适合 |
| 单个轻量商城 | 不适合 |
| 多虚拟机平台 | 适合 |
| 多容器服务集群 | 适合 |
| 批量转码 / 编译 / 计算 | 适合 |
| 大量定时任务 / 队列任务 | 适合 |
| 多租户 SaaS 后端 | 适合,但要做好资源隔离 |
| 大型数据库单机部署 | 要谨慎,内存和磁盘规划更关键 |
如果业务没有并发调度能力,买这台机器就像买了一辆大货车去送一杯奶茶,车很强,但场景不匹配。
双路 EPYC 9754 的 CPU 核心数非常大,但当前产品配置里的内存是 128GB DDR5-4800。对于普通服务器来说,128GB 内存已经不小;但对于 256 核 512 线程的机器来说,它更像是“起步内存”。
如果是下面这些业务,建议重点评估是否需要扩展内存:
一个比较实用的判断方法是:
| 使用方式 | 建议内存思路 |
|---|---|
| CPU 批处理任务 | 128GB 可作为起步 |
| 虚拟化平台 | 建议按 VM 数量重新估算 |
| 容器集群 | 建议按服务实例数和峰值内存估算 |
| 数据库主节点 | 不建议只看 CPU,内存可能更重要 |
| 大数据分析 | 通常需要更高内存容量 |
如果你计划让 512 线程长期高负载运行,128GB 内存很可能会先成为瓶颈。
这台服务器配的是 2 × 1.92TB NVMe SSD。NVMe 的性能比普通 SATA SSD 和机械硬盘强很多,适合高频读写、构建缓存、临时任务数据、日志处理和容器镜像存储。
但问题在于:CPU 核心越多,并发任务越多,对磁盘 I/O 的压力也越大。
如果 200 个任务同时读写磁盘,瓶颈可能不是 CPU,而是:
/tmp 爆满。建议这样规划:
| 业务类型 | 磁盘建议 |
|---|---|
| 虚拟化 | 两块 NVMe 可考虑 RAID1,优先保证安全 |
| 批处理临时任务 | 可按任务目录分盘,减少互相抢 I/O |
| 高速缓存 / 临时数据 | 可以独立挂载数据目录 |
| 数据库 | 不建议和大量任务共享同一高压磁盘路径 |
| 容器集群 | 定期清理镜像、日志和 overlay2 占用 |
如果业务对数据安全要求高,两块 NVMe 更建议做 RAID1;如果更看重临时计算吞吐,可以根据业务接受度做性能型规划,但要配套备份。
这台服务器标配 100M CN2 带宽。CN2 的优势是国内访问质量、线路稳定性和跨境访问体验更好,适合国内团队访问美国服务器、跨境业务后台、API 服务、企业系统、管理平台等场景。A5IDC 产品页也将美国 AMD 服务器定位为适合高并发、大数据处理及虚拟化场景,并支持 DDR5 内存与 NVMe 高速存储。
但 100M 带宽并不适合下面这些场景:
所以这台机器的定位应该是:强计算 + 稳定跨境访问,而不是“超大带宽下载服务器”。
如果你的业务是 CPU 计算为主,100M CN2 足够支撑管理、接口访问、任务调度、数据回传;如果你的业务是流量分发为主,那应该优先考虑美国大带宽服务器,而不是单纯买最强 CPU。
如果你现在有 10 台、20 台甚至更多中低配服务器,管理成本高、资源利用率低,可以考虑用这种高核心服务器做整合。
比如:
这种情况下,双路 EPYC 9754 的价值会比较明显。
例如爬虫数据清洗、日志分析、编译构建、视频预处理、图片处理、AI 数据预处理等业务,只要任务能拆分,就能吃到多核心红利。
但前提是你要有任务队列,比如:
如果没有队列系统,只是手动跑脚本,那这台机器的优势很难完全发挥。
对于 IDC、软件公司、跨境企业、开发团队来说,这种服务器可以作为美国私有云节点:
它的好处是核心数多、可调度空间大,缺点是需要更专业的运维规划。
有些客户一提到高性能计算就想到 GPU,但并不是所有任务都适合 GPU。
下面这些任务更偏 CPU:
如果你的任务不是深度学习训练、不是大模型推理、不是 CUDA 加速型计算,那么高核心 CPU 服务器可能比 GPU 服务器更合适。
普通官网、博客、展示站、轻量商城,不需要这种规格。
这种业务更应该关注:
买 256 核服务器不会让一个没有优化的 WordPress 自动变快。
数据库性能不是只靠 CPU 核心数。
MySQL、PostgreSQL、MongoDB、Redis、ClickHouse 等系统都要看:
如果数据库瓶颈是 SQL 写得差、索引缺失、磁盘写入慢,那么换到 256 核也不一定解决问题。
这台机器 CPU 极强,但标配是 100M CN2。
如果业务核心是大流量传输,应该优先看带宽,而不是 CPU。
比如下载站、视频资源站、镜像站、图片外链站,更应该考虑美国大带宽服务器或 CDN 架构。
建议将业务分成几类:
| 层级 | 业务内容 | 建议 |
|---|---|---|
| 核心业务层 | 数据库、核心 API、用户系统 | 资源固定、优先级高 |
| 计算任务层 | 批处理、转码、编译、队列 | 可弹性扩展 |
| 测试环境层 | 开发、预发布、临时服务 | 限制 CPU 和内存 |
| 管理监控层 | Prometheus、Grafana、日志 | 独立部署,避免被挤占 |
不要把数据库、批处理、测试环境、日志系统全部无限制堆在一起。机器越强,越需要规划资源边界。
双路 CPU 服务器通常会涉及 NUMA 架构。简单理解就是:不同 CPU 插槽访问本地内存和远端内存的速度不完全一样。
如果虚拟机或容器跨 NUMA 节点调度不合理,可能会出现:
在 Proxmox、KVM、VMware 或 Kubernetes 环境里,建议对关键业务做 CPU 绑定、NUMA 感知调度和资源隔离。
很多人拿到大核心机器后,会直接把 worker 数量开到几百个,这不一定是好事。
更稳妥的方式是逐步压测:
# 示例:先从 32 个 worker 起步
php artisan queue:work --queue=default --sleep=1 --tries=3
再逐步增加到 64、128、192,观察:
最终并发数不是越大越好,而是要找到“吞吐提升明显、系统仍然稳定”的平衡点。
这种级别的服务器,如果没有监控,很容易出现“资源很多但不知道瓶颈在哪里”的问题。
建议至少监控:
如果是生产业务,建议部署 Prometheus + Grafana,或者使用现成的服务器监控面板,把 CPU、内存、磁盘、网络、进程、容器都纳入监控。
双路 EPYC 9754 的最大价值,不是让一个网站打开速度从 300ms 变成 100ms,而是让你能够在一台物理服务器上同时承载更多任务、更多容器、更多虚拟机和更多计算进程。
它适合的客户通常具备几个特征:
如果你的业务只是普通网站或单一后台系统,建议选择更均衡的美国 AMD 服务器或美国精品线路服务器,把预算放在线路、缓存、数据库优化和安全防护上。
但如果你需要的是美国节点上的高密度计算资源池、虚拟化平台、批量任务中心或多容器承载节点,那么双路 EPYC 9754 + DDR5 + NVMe + CN2 的组合,才真正能体现它的价值。


