

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


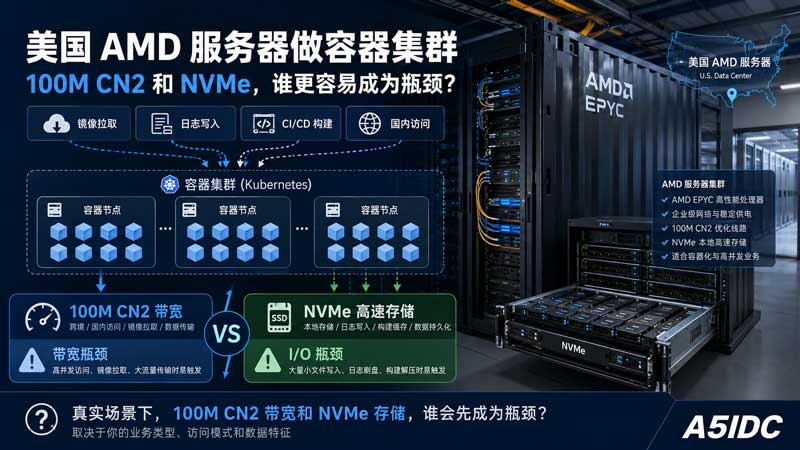
很多客户在选择美国AMD服务器做容器集群时,第一反应通常是看 CPU 核心数够不够、内存够不够。但真正跑起来以后,最容易让业务卡住的,往往不是 CPU,而是两个地方:100M CN2 带宽和本地 NVMe 磁盘 I/O。
这两个瓶颈表现完全不同。100M CN2 一旦满了,外部访问、镜像拉取、跨境接口请求都会变慢;NVMe 一旦被打满,容器启动、日志写入、数据库响应、CI/CD 构建都会变慢。表面上都是“系统卡”,但排查方向完全不一样。
如果简单回答“哪个更容易成为瓶颈”,我的结论是:
对于面向国内用户访问、频繁拉取镜像、跨境接口请求较多的容器集群,100M CN2 更容易先成为瓶颈;对于本地日志量大、数据库密集写入、CI 构建、镜像仓库、缓存服务较重的集群,NVMe 才更容易成为瓶颈。
真正选型时,不能只看“AMD CPU 很强”或者“NVMe 很快”,而是要看容器集群到底在消耗什么资源。
美国 AMD 服务器比较适合容器集群,核心原因有三个:核心数多、单核性能强、内存带宽和 PCIe 扩展能力比较好。
以常见的美国 AMD 高性能服务器为例,可以按下面这种思路选:
| 集群角色 | 推荐配置方向 | 适合场景 |
|---|---|---|
| 管理节点 / 控制节点 | AMD EPYC 4584PX / 4585PX,16核32线程,64GB 内存,960GB NVMe | Kubernetes 控制平面、轻量业务编排、后台服务 |
| 计算节点 | AMD EPYC 9554,64核128线程,256GB DDR5,2×1.92TB NVMe | Web 服务、API 服务、微服务集群、高并发应用 |
| 构建节点 / 批处理节点 | AMD EPYC 9754,128核以上级别,512GB 内存,多盘 NVMe | CI/CD、批量任务、数据处理、爬虫、转码、镜像构建 |
| 存储/镜像节点 | AMD EPYC 多核心平台,128GB 内存,2×1.92TB 或 4×3.84TB NVMe | Harbor 镜像仓库、日志系统、缓存、对象文件中转 |
如果业务部署在美国,但访问用户主要来自中国大陆,那么线路通常会搭配 100M CN2 优化带宽。这类线路的价值不是“带宽特别大”,而是相对普通国际线路,国内访问延迟、抖动和丢包更可控。
但是问题也正好出在这里:CN2 线路质量好,但 100M 本身容量并不大。
100M 带宽换算成实际下载速度,理论上大约是:
100Mbps ÷ 8 = 12.5MB/s考虑 TCP 开销、跨境链路波动、并发连接、晚高峰抖动,实际稳定可用值通常可以按 10MB/s 左右估算。
也就是说,如果你的容器集群有 10 台节点,每台节点同时拉取一个 3GB 的业务镜像,理论传输量就是:
3GB × 10 = 30GB
30GB ÷ 10MB/s ≈ 3000秒 ≈ 50分钟
这还只是镜像拉取。如果同时还有用户访问、API 回源、日志上报、备份同步,那 100M CN2 很容易被挤满。
所以在容器集群里,100M CN2 最容易在这些场景下成为瓶颈:
| 场景 | 为什么会卡 |
|---|---|
| 多节点同时拉取 Docker 镜像 | 镜像体积大,节点多,瞬间占满出入口带宽 |
| 面向国内用户提供 Web/API 服务 | 用户访问流量全部经过 CN2,100M 容量有限 |
| 容器频繁更新发布 | 每次发布都要拉镜像、同步依赖、请求仓库 |
| 大量日志回传到国内平台 | 日志持续占用上行带宽 |
| 跨境数据库/API 调用 | 不是大流量,但对延迟和抖动敏感 |
| 文件下载、安装包分发、APK 分发 | 100M 很快被下载流量打满 |
所以,如果这个美国 AMD 容器集群主要是给国内用户访问,100M CN2 往往比 NVMe 更早暴露瓶颈。
很多人看到 NVMe,就觉得磁盘肯定不是问题。这个判断只对了一半。
单块企业级 NVMe SSD 的顺序读写可能达到几 GB/s,随机 IOPS 也远高于 SATA SSD 和机械硬盘。从原始性能看,NVMe 肯定比 100M CN2 强很多。
但容器集群不是直接裸写磁盘,它中间还有很多层:
应用程序
  ↓
容器文件系统 overlay2
  ↓
Docker / containerd
  ↓
宿主机文件系统 ext4 / xfs
  ↓
NVMe SSD
这些层会带来额外开销,尤其是小文件、日志、镜像层、临时目录、数据库写入混在一起时,NVMe 也可能被打爆。
NVMe 容易成为瓶颈的场景主要有这些:
| 场景 | 典型表现 |
|---|---|
| 大量容器同时启动 | image layer 解压、overlay 挂载、文件复制导致 I/O 飙高 |
| CI/CD 构建任务密集 | npm install、composer install、go build、docker build 产生大量小文件 |
| 容器日志没有限速 | json log 持续写入,磁盘 util 长期接近 100% |
| 数据库跑在容器里 | MySQL、PostgreSQL、Redis AOF、MongoDB 写放大明显 |
| 本地镜像仓库 Harbor | 镜像上传、下载、扫描、GC 都消耗磁盘 I/O |
| Elasticsearch / Loki 日志系统 | 写入、索引、压缩、查询同时发生 |
| 多租户容器混跑 | 某个业务异常写日志,拖慢整台宿主机 |
所以,NVMe 不是“不会成为瓶颈”,而是它通常不会因为正常 Web 容器流量先成为瓶颈,更多是在日志、构建、数据库、镜像仓库、缓存落盘这些场景下出问题。
可以用一个简单判断方法。
比如这些业务:
这类场景下,用户请求、静态资源、接口响应、文件下载都会消耗 CN2 带宽。100M CN2 的优势是线路质量,但容量并不大。
如果一个页面平均资源体积 2MB,100M CN2 理论上每秒最多传输约 10MB 数据,也就是:
10MB/s ÷ 2MB ≈ 5个完整页面/秒当然真实 Web 访问会有缓存、压缩、CDN、浏览器复用,不会这么简单粗暴计算,但这个数字能说明一个问题:100M CN2 不适合承担大量静态资源直出。
如果你把图片、视频、安装包、JS/CSS、大文件下载都放在美国 AMD 服务器上直接走 100M CN2,瓶颈大概率先出在线路上。
比如这些业务:
这类场景未必产生很大的外部访问流量,但会在服务器本地频繁读写文件。
比如一个构建节点同时跑 20 个 Docker build,每个任务都在执行依赖安装、代码编译、镜像分层、压缩上传,本地 NVMe 的 IOPS 和写入延迟就会快速升高。
这时你会看到:
iostat -x 1里面的磁盘指标可能出现:
%util 接近 100%
await 明显升高
r/s、w/s 持续很高
这种情况下,即使 CN2 带宽没有跑满,容器启动和构建速度也会变慢。
很多人部署 Kubernetes 集群时,会让所有节点直接访问 Docker Hub、GitHub Container Registry 或其他海外镜像源。美国服务器访问这些源通常不慢,但如果控制端、国内开发环境、多个节点同步发布,就容易把 CN2 出入口挤满。
更合理的做法是:
公网镜像源
  ↓
美国本地 Harbor 镜像仓库
  ↓
集群内部节点拉取
也就是说,公网镜像只拉一次,集群内部走内网分发。
美国 AMD 服务器适合跑计算、跑业务逻辑、跑容器,不建议把大量图片、视频、安装包全部放在 100M CN2 上直出。
推荐结构是:
用户访问
  ↓
CDN / 对象存储 / 静态资源节点
  ↓
美国 AMD 容器业务集群
  ↓
数据库 / 缓存 / 内部服务
业务服务器负责动态请求,静态资源交给 CDN 或大带宽节点。
容器日志如果全部实时回传国内,会持续占用 CN2 带宽。尤其是 debug 日志没有关闭时,一个异常接口就可能产生大量日志。
更合理的方式是:
容器本地日志
  ↓
本地日志采集 Agent
  ↓
美国日志节点 / Loki / Elasticsearch
  ↓
按需同步关键日志到国内
日志不要无脑实时跨境全量传输。
很多容器集群出问题,不是因为 NVMe 性能差,而是因为所有东西都混在同一块盘里:
/var/lib/docker
/var/lib/containerd
/var/log
数据库数据目录
Redis AOF
Harbor 镜像仓库
CI 构建缓存
临时文件目录
这些全部放在一块 NVMe 上,短时间看不出问题,业务一多就会互相抢 I/O。
更稳妥的做法是分层:
| 数据类型 | 建议处理方式 |
|---|---|
| 容器运行目录 | 单独挂载到高速 NVMe |
| 数据库目录 | 独立 NVMe 或独立服务器 |
| 日志目录 | 单独分区,限制单容器日志大小 |
| 镜像仓库 | 独立存储节点,不和业务容器混跑 |
| 构建缓存 | 单独构建节点,避免影响线上服务 |
| 临时文件 | 设置定期清理策略 |
例如可以把 Docker 数据目录迁移到独立挂载盘:
mkdir -p /data/docker
systemctl stop docker

rsync -aHAX /var/lib/docker/ /data/docker/

cat > /etc/docker/daemon.json <<EOF
{
  "data-root": "/data/docker",
  "log-driver": "json-file",
  "log-opts": {
    "max-size": "200m",
    "max-file": "3"
  }
}
EOF

systemctl start docker
这里重点不是命令本身,而是两个思路:
第一,容器运行数据不要长期挤在系统盘。
第二,日志必须限制大小,否则再快的 NVMe 也可能被日志写爆。
如果是中小型业务,我更建议采用下面这种结构,而不是把所有服务都塞进一台服务器。
| 节点 | 推荐配置 | 角色 |
|---|---|---|
| Node-01 | AMD EPYC 4584PX,16核32线程,64GB 内存,960GB NVMe,100M CN2 | 控制节点 + 轻量业务 |
| Node-02 | AMD EPYC 4584PX / 4585PX,16核32线程,128GB 内存,960GB 或 1.92TB NVMe,100M CN2 | Web/API 容器 |
| Node-03 | AMD EPYC 9554,64核128线程,256GB 内存,2×1.92TB NVMe | 构建、缓存、日志、镜像仓库 |
这种结构适合:
这里 100M CN2 主要负责用户访问和关键接口,内部镜像、日志、缓存尽量走内网,避免全部压到 CN2 上。
如果国内访问比较多,建议把入口流量单独拆出来:
国内用户
  ↓
CDN / 高防 / 边缘加速
  ↓
美国 CN2 入口节点
  ↓
美国 AMD 容器集群内网
  ↓
数据库 / 缓存 / 日志 / 镜像仓库
入口节点可以使用 100M CN2,负责高质量访问;后端 AMD 容器节点主要走美国本地内网或国际带宽。
这样做的好处是:
如果容器集群里有大量构建任务,不建议和线上业务混跑。
推荐拆成:
线上业务节点:Web / API / Worker
构建节点:CI/CD / Docker build / 镜像打包
镜像节点:Harbor / Registry
日志节点:Loki / Elasticsearch / ClickHouse
数据库节点:MySQL / PostgreSQL / Redis
尤其是 Docker build、npm install、镜像压缩、日志索引这些任务,会大量消耗 NVMe I/O。如果它们和线上 API 服务混在一起,就会出现一种很难排查的问题:CPU 看起来不高,带宽也没满,但接口延迟突然变大。
这种情况很多时候就是磁盘 I/O 抢占导致的。
不要凭感觉判断,直接看指标。
可以看网卡实时流量:
sar -n DEV 1或者:
iftop -i eth0如果持续接近:
90Mbps - 100Mbps并且同时出现访问变慢、镜像拉取慢、接口响应慢,那基本可以判断 CN2 带宽已经接近瓶颈。
还可以配合:
mtr 目标IP
ping 目标IP
观察晚高峰是否出现延迟升高、抖动明显、丢包增加。
看磁盘 I/O:
iostat -x 1重点看:
| 指标 | 含义 |
|---|---|
| %util | 磁盘繁忙程度 |
| await | I/O 等待时间 |
| r/s、w/s | 每秒读写次数 |
| rkB/s、wkB/s | 每秒读写吞吐 |
| aqu-sz | I/O 队列长度 |
如果 %util 长期接近 100%,await 明显升高,容器启动、数据库查询、日志写入都变慢,就要重点排查 NVMe。
还可以看系统负载:
top如果 CPU idle 还有很多,但 load average 很高,并且 wa 也很高,通常说明系统卡在 I/O 等待上。
可以在发布前执行:
docker pull registry.example.com/app:v20260520Kubernetes 可以用 DaemonSet 或预热脚本提前拉取镜像。
目标是避免上线瞬间所有节点一起抢带宽。
推荐在美国 AMD 服务器集群内部署 Harbor:
开发环境推送镜像
  ↓
Harbor 镜像仓库
  ↓
K8s 节点内网拉取
这样公网镜像源和跨境链路只在必要时使用,节点之间尽量走内网。
100M CN2 应该优先留给:
图片、视频、安装包、附件下载不应该长期占用 CN2。
例如日志、备份、同步任务可以安排在低峰期执行:
rsync --bwlimit=5000这里的 5000 表示限制传输速度,避免备份任务把业务访问带宽吃满。
Docker 可以配置:
{
  "log-driver": "json-file",
  "log-opts": {
    "max-size": "200m",
    "max-file": "3"
  }
}
否则一个异常容器可能写出几十 GB 日志,既占空间,也拖慢 I/O。
如果只是测试环境,MySQL 放容器里问题不大。
但正式业务里,如果数据库有持续写入,建议单独部署:
业务容器节点
  ↓
独立数据库服务器
  ↓
独立 NVMe 数据盘
不要把数据库、日志系统、镜像仓库、业务容器全部放在同一台机器上。
CI/CD 构建节点最好独立出来。构建任务短时间内会产生大量小文件和镜像层,不适合和线上 API 服务抢磁盘。
如果重视安全性,可以用 RAID1:
2×1.92TB NVMe RAID1如果重视吞吐和容量,可以考虑 RAID10:
4×1.92TB NVMe RAID10但不建议只为了跑分使用 RAID0。容器集群里的业务数据、镜像仓库、日志数据一旦损坏,恢复成本很高。
如果只是企业后台、API 服务、少量容器,推荐:
AMD EPYC 4584PX / 4585PX
16核32线程
64GB - 128GB DDR5
960GB NVMe
100M CN2 优化带宽
优化重点:
这种场景里,100M CN2 更容易成为瓶颈。
如果有几十个容器,推荐:
控制节点:16核32线程 / 64GB / 960GB NVMe
业务节点:32核以上 / 128GB / 1.92TB NVMe
日志或镜像节点:64核128线程 / 256GB / 2×1.92TB NVMe
优化重点:
这种场景下,100M CN2 和 NVMe 都要重点监控。
如果业务包含大量构建、批处理、日志分析,推荐:
AMD EPYC 9554 / 9754
64核128线程或更高
256GB - 512GB 内存
多块企业级 NVMe
100M CN2 + 国际大带宽组合
这里不能只靠 100M CN2,也不能只靠单块 NVMe。更合理的是:
CN2:负责国内优质访问
国际大带宽:负责镜像、备份、同步、下载
NVMe:负责本地构建、日志、缓存、数据库
内网:负责节点之间通信美国 AMD 服务器做容器集群,CPU 通常不是最先出问题的地方。真正要提前设计的是:流量怎么走,镜像怎么拉,日志怎么写,数据库放哪里,NVMe 怎么分区,CN2 给谁用。
简单总结:
| 业务类型 | 更容易成为瓶颈 |
|---|---|
| 国内用户访问 Web/API | 100M CN2 |
| 多节点同时拉镜像 | 100M CN2 |
| 静态资源/文件下载 | 100M CN2 |
| CI/CD 构建 | NVMe |
| 日志系统 | NVMe |
| 数据库容器 | NVMe |
| 镜像仓库 | NVMe |
| 批量任务落盘 | NVMe |
| 普通后台系统 | 通常先看 100M CN2 |
| 高密度容器集群 | CN2 和 NVMe 都要拆分设计 |
如果业务只是普通后台、企业系统、API 服务,使用美国 AMD 服务器搭配 100M CN2 是比较合适的,重点是把静态资源、镜像拉取、日志同步控制好。
如果业务已经进入多节点容器集群、频繁发布、构建任务密集、日志量大、数据库写入明显的阶段,就不能只买一台高配置 AMD 服务器硬扛。更稳的方案是:入口 CN2、计算 AMD、存储 NVMe、日志独立、镜像本地化、静态资源走 CDN。
这样,美国 AMD 服务器的多核心性能才能真正用在业务计算上,而不是被 100M CN2 的出口流量和混乱的磁盘 I/O 白白拖慢。


