

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


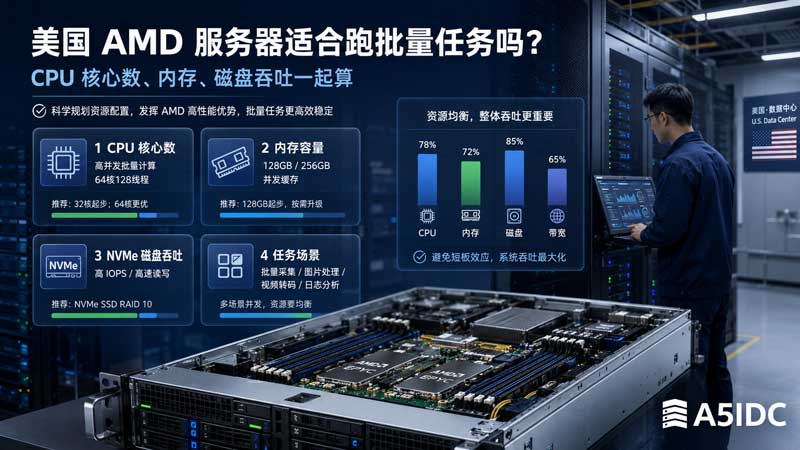
很多人一听到“批量任务”,第一反应就是:核心数越多越好,线程越多越好,直接上高配 CPU 就行。
但我在实际服务器部署里看到的情况恰恰相反:有些客户买了高核心 AMD 服务器,任务一跑起来 CPU 只用了 40%,机器却已经开始卡;也有些客户 CPU 满载了,但磁盘、内存和网络几乎没压力,这种才是真正的 CPU 算力瓶颈。
所以,美国AMD服务器到底适不适合跑批量任务,不能只看“CPU 有多少核心”。真正要一起算的是:CPU 核心数、内存容量、磁盘吞吐、网络带宽、任务类型和并发调度方式。尤其是美国服务器这类适合大带宽、国际访问、长时间稳定运行的节点,用好了非常适合跑批量任务;用不好,也很容易出现“配置看着很高,实际跑不满”的情况。
批量任务有一个特点:它不一定要求用户实时访问,但通常要求服务器能长时间稳定执行大量重复工作。
比较适合放在美国 AMD 服务器上的场景主要有这些:
| 批量任务类型 | 典型业务 | 主要瓶颈 |
|---|---|---|
| 数据采集任务 | 海外站点采集、API 拉取、跨境数据同步 | 网络、连接数、磁盘写入 |
| 图片处理任务 | 批量压缩、缩略图生成、格式转换 | CPU、磁盘 I/O |
| 视频转码任务 | 短视频切片、转码、封面提取 | CPU、磁盘吞吐 |
| 文件分发任务 | 安装包、APK、游戏补丁、素材包分发 | 带宽、磁盘读取 |
| 日志分析任务 | Nginx 日志、业务日志、访问统计 | 磁盘读取、内存 |
| 定时计算任务 | 报表生成、订单统计、库存同步 | CPU、数据库、内存 |
| AI 数据预处理 | 图片清洗、文本切分、向量入库前处理 | CPU、内存、磁盘 |
美国 AMD 服务器特别适合这类任务的原因是:
一方面 AMD EPYC 系列 CPU 通常核心数多、多线程能力强;另一方面美国机房带宽资源充足,适合国际业务、海外数据处理、下载分发和长时间任务运行。
但要注意:美国服务器不适合所有“实时交互型”业务。例如国内玩家实时游戏、国内用户高频访问后台、强依赖低延迟的接口请求,这类业务更适合香港 CN2、美国精品线路或亚洲节点。美国 AMD 服务器更适合“任务跑得稳、算得快、吞吐够”的后台型业务。
很多客户问:“我这个任务要不要上 32 核、64 核、128 核?”
我一般不会直接回答核心数,而是先看任务属于哪一种瓶颈。
这类任务的特点是 CPU 一直很忙,top 里能看到 CPU 使用率长期接近 90% 到 100%。
常见场景包括:
这种任务适合高核心 AMD EPYC 服务器。
例如 EPYC 4584PX、EPYC 4585PX 这类高主频 AMD 平台,适合中小规模高频任务;EPYC 9554、双路 EPYC 9754 这类平台更适合大规模并行计算。
有些任务看起来是批量计算,实际最先爆的是内存。
比如:
假设一个任务进程平均占用 800MB 内存,服务器是 64GB 内存,系统和缓存预留 10GB 后,真正可用大概 54GB。
那么理论并发数大约是:
54GB ÷ 0.8GB ≈ 67 个任务但这只是理论值。实际还要给磁盘缓存、数据库连接、队列服务、监控程序留空间,所以更合理的并发可能是 40 到 50 个。
这就是为什么 64 核 CPU 配 64GB 内存,有时反而不如 32 核 CPU 配 128GB 内存好用。
批量任务里很容易忽视磁盘。
例如:
这时瓶颈可能不是 CPU,而是磁盘 IOPS 和顺序读写吞吐。
机械硬盘适合大容量冷数据,不适合高并发小文件读写。
SATA SSD 比 HDD 好很多,但在高并发批处理里也可能不够。
NVMe SSD 才更适合批量任务,特别是大量并发读写、临时文件处理、数据库中间表、缓存目录。
美国 AMD 服务器经常用于海外数据拉取、文件下载、API 同步、对象存储迁移、跨境业务分发,这类任务很吃网络。
例如你有 100 个并发任务,每个任务平均下载速度 2MB/s,那么总带宽需求就是:
100 × 2MB/s = 200MB/s
200MB/s × 8 = 1600Mbps
这时候 1Gbps 端口就明显不够,至少要考虑 3Gbps 国际带宽,甚至 10Gbps 大带宽服务器。
所以批量任务不是“能跑就行”,而是要看任务高峰期能不能持续吃满资源。
下面这几组配置,可以作为美国 AMD 服务器跑批量任务时的选型参考。
| 配置项 | 推荐配置 |
|---|---|
| CPU | AMD EPYC 4584PX / EPYC 4585PX,16 核 32 线程 |
| 内存 | 64GB DDR4 / DDR5 |
| 硬盘 | 960GB NVMe SSD |
| 带宽 | 1Gbps 国际带宽起步 |
| 适合业务 | 采集任务、图片压缩、后台脚本、轻量数据处理、API 同步 |
这类配置适合刚开始做批量任务的用户。
它的优势不是“核心数特别夸张”,而是 CPU 主频高、单任务响应快、成本相对可控。
例如:
这种配置最适合“任务数量多,但单个任务不算特别重”的业务。
| 配置项 | 推荐配置 |
|---|---|
| CPU | AMD EPYC 9554,64 核 128 线程 |
| 内存 | 128GB / 256GB DDR5 |
| 硬盘 | 2 × 960GB NVMe SSD 或 1.92TB NVMe SSD |
| 带宽 | 1Gbps / 3Gbps 国际带宽 |
| 适合业务 | 大规模图片处理、日志分析、批量转码、CI/CD 编译、跨境数据处理 |
这类配置适合已经有稳定任务量的企业。
它的核心价值是:CPU 线程多,内存容量更大,磁盘吞吐也能跟上。
比如一个业务每天需要处理:
这时候 16 核 32 线程可能可以跑,但跑得慢;
64 核 128 线程配合足够内存和 NVMe 磁盘,才能把任务窗口压缩下来。
很多批量任务不是要求 24 小时都满载,而是要求在固定时间内完成。
例如每天凌晨 1 点开始跑任务,早上 7 点前必须完成报表、图片处理和数据同步。
这种情况下,服务器的并行能力就很重要。
| 配置项 | 推荐配置 |
|---|---|
| CPU | 双路 AMD EPYC 9754,最高 256 核 512 线程 |
| 内存 | 512GB / 1TB DDR5 |
| 硬盘 | 多块 NVMe SSD,可做 RAID 0 / RAID 10 |
| 带宽 | 3Gbps / 10Gbps 国际带宽 |
| 适合业务 | 海量数据预处理、视频批量转码、大型编译集群、AI 数据清洗、分布式任务节点 |
这种配置就不是普通建站服务器了,而是偏计算型、任务型、平台型服务器。
适合:
但这种配置也有一个问题:
CPU 太强,其他资源跟不上会浪费。
例如双路 EPYC 9754 有非常强的并行能力,但如果只配一块普通 SSD,任务很可能卡在磁盘读写;如果只配 64GB 内存,根本无法发挥 512 线程的价值;如果网络只有 100Mbps,数据拉取和分发会成为最大瓶颈。
所以高端 AMD 服务器必须按整体吞吐来设计。
很多用户喜欢在程序里直接开 100 个、200 个、500 个线程。
这种方式在测试环境里看起来很猛,上线后很容易把服务器打挂。
比较稳妥的估算方式是:
先分别算 CPU、内存、磁盘、网络能支撑多少并发,最后取最小值。
可以用这个思路:
可用并发数 = min(
  CPU 可支撑并发,
  内存可支撑并发,
  磁盘可支撑并发,
  网络可支撑并发
)
举个例子。
一台美国 AMD 服务器配置如下:
| 项目 | 配置 |
|---|---|
| CPU | AMD EPYC 9554,64 核 128 线程 |
| 内存 | 256GB |
| 磁盘 | 2 × 960GB NVMe SSD |
| 带宽 | 3Gbps 国际带宽 |
某个图片处理任务:
那么可以大概估算:
64 核 ÷ 0.5 ≈ 128 个任务考虑系统开销和任务波动,建议打 70% 折扣:
128 × 70% ≈ 90 个任务系统预留 20GB,实际可用约 236GB:
236GB ÷ 0.6GB ≈ 393 个任务内存不是瓶颈。
假设 NVMe 实际稳定吞吐按 1500MB/s 计算:
1500MB/s ÷ 8MB/s ≈ 187 个任务磁盘也不是第一瓶颈。
3Gbps 大约等于 375MB/s:
375MB/s ÷ 3MB/s ≈ 125 个任务综合来看,这台机器比较合理的并发不是 300,也不是 500,而是大约 80 到 100 个任务。
也就是说,这台服务器真正限制并发的主要是 CPU,其次是网络,内存和磁盘暂时够用。
这就是批量任务选服务器时最关键的地方:
不是看某一个参数很强,而是看最短的那块板在哪里。
很多早期项目喜欢用 crontab:
* * * * * /usr/bin/php /data/task/run.php小任务可以这样做,但任务量一大就会失控。
比如上一个任务还没跑完,下一轮又启动了,最后进程越堆越多,CPU、内存、磁盘全部被打满。
更建议使用队列系统,例如:
核心原则是:
任务进入队列,Worker 按服务器资源有节奏地消费。
例如一台 64 核 AMD 服务器,可以先开 32 个 Worker,观察 CPU、内存、磁盘、网络,再逐步增加到 64、80、100,而不是一开始直接开 300。
CPU 密集型任务不要盲目追求线程数量。
例如视频转码、图片压缩、编译任务,通常一个任务本身就会占用多个线程。
这时开太多 Worker,反而会造成 CPU 上下文切换严重,最终每个任务都变慢。
可以用下面命令观察 CPU 压力:
top
htop
mpstat -P ALL 1
pidstat -u 1
重点看几个指标:
| 指标 | 说明 |
|---|---|
| us | 用户态 CPU 使用率,任务计算主要看它 |
| sy | 系统态 CPU 使用率,过高说明系统调用压力大 |
| wa | I/O 等待,过高说明磁盘拖慢任务 |
| load average | 负载均值,长期高于核心数太多就要注意 |
| context switch | 上下文切换过高说明线程太多 |
比较稳的做法是:
CPU 密集型任务,让 CPU 使用率长期保持在 75% 到 90%,不要长期 100% 顶死。
因为服务器还需要处理系统服务、日志写入、监控、SSH、队列调度等基础任务。
批量任务最怕内存泄漏。
特别是 Python、Java、Node.js 这类长时间运行的 Worker,跑几个小时后内存越来越高,最后触发 OOM。
建议做三件事:
第一,限制单个 Worker 内存。
例如 systemd 可以设置:
[Service]
MemoryMax=4G
Restart=always
第二,设置 Worker 最大执行任务数。
例如每个 Worker 执行 1000 个任务后自动重启,释放内存碎片。
第三,任务拆分要小。
不要一次性读取 20GB 文件到内存,而是分块处理。
例如处理大日志时,应该按行流式读取:
tail -f access.log或在程序里按 chunk 读取,而不是一次性加载整个文件。
图片处理、视频转码、压缩解压、日志分析都会产生大量临时文件。
建议至少分三个目录:
/data/source      原始文件
/data/tmp         临时文件
/data/output      处理结果
如果磁盘条件允许,临时目录可以单独放在 NVMe SSD 上。
这样可以避免临时文件读写影响源文件读取和结果写入。
对于高强度任务,可以考虑:
| 方案 | 适合场景 |
|---|---|
| 单块 NVMe | 中小型批量任务 |
| 双 NVMe 分盘 | 源文件和临时文件分离 |
| RAID 0 | 追求极致吞吐,数据可重建 |
| RAID 10 | 兼顾性能和安全 |
| HDD + NVMe 缓存 | 大容量冷数据 + 高频热数据 |
需要注意:
RAID 0 速度快,但任何一块盘出问题都会影响数据完整性。
批量任务中间文件可以放 RAID 0,核心数据不建议只放 RAID 0。
美国 AMD 服务器经常用于海外数据拉取。
这类任务容易把网络连接数打爆。
建议控制:
例如采集任务不要这样设计:
失败后立刻重试
每个任务独立 DNS 查询
每个请求新建 TCP 连接
几百个 Worker 同时打同一个目标站
这样不仅容易被目标站限制,也会造成服务器本地连接堆积。
更合理的方式是:
连接池 + 限速 + 队列 + 指数退避重试 + 失败任务延迟处理对于需要大量国际下载、文件分发的业务,建议选择 3Gbps 或 10Gbps 带宽方案。
1Gbps 对普通批处理够用,但面对大文件、高并发下载、批量同步时很容易成为瓶颈。
假设一个客户租用美国 AMD 高性能服务器,配置如下:
| 项目 | 配置 |
|---|---|
| CPU | AMD EPYC 9554,64 核 128 线程 |
| 内存 | 256GB |
| 硬盘 | 2 × 960GB NVMe SSD |
| 带宽 | 3Gbps 国际带宽 |
| 系统 | Ubuntu 22.04 LTS |
业务是批量处理商品图片:
一开始客户开了 200 个 Worker,结果出现这些问题:
CPU 使用率:55% 左右
内存使用率:70%
磁盘 iowait:20% - 35%
带宽偶尔打满
任务失败率升高
处理速度不稳定
表面看 CPU 没跑满,客户以为 CPU 不够强。
但真正的问题是:磁盘临时文件和网络下载互相抢资源,Worker 数量过多导致 I/O 等待增加。
优化后这样调整:
/data/tmp 单独放到 NVMe;优化后的效果:
| 指标 | 优化前 | 优化后 |
|---|---|---|
| CPU 使用率 | 55% | 78% - 88% |
| iowait | 20% - 35% | 5% - 12% |
| Worker 数量 | 200 | 96 |
| 任务失败率 | 较高 | 明显降低 |
| 处理速度 | 波动大 | 更稳定 |
| 日处理能力 | 不稳定 | 接近业务目标 |
这个案例说明一个很重要的问题:
批量任务不是并发越高越快,而是资源利用越平衡越快。
普通美国服务器也能跑批量任务,但 AMD 高性能服务器更适合长期并行计算。
主要区别在这里:
| 对比项 | 普通美国服务器 | 美国 AMD 高性能服务器 |
|---|---|---|
| CPU 核心数 | 较少 | 核心数更多 |
| 多线程能力 | 一般 | 更适合并行任务 |
| 内存扩展 | 有限制 | 更适合 128GB / 256GB / 512GB |
| 磁盘组合 | 常规 SSD / HDD | 更适合 NVMe 多盘 |
| 适合业务 | 网站、轻量后台 | 批处理、计算、数据处理 |
| 成本结构 | 低成本起步 | 更适合生产型任务 |
简单说:
普通服务器适合“放网站”。
美国 AMD 服务器更适合“跑任务”。
如果只是企业官网、WordPress、展示型网站,没必要一上来就选高核心 AMD。
但如果是采集、转码、图片处理、日志分析、批量同步、数据清洗,美国 AMD 服务器的价值就非常明显。
推荐配置:
AMD EPYC 4584PX / 4585PX
64GB 内存
960GB NVMe SSD
1Gbps 国际带宽
重点不是 CPU 极限,而是网络稳定、连接数控制、失败重试机制。
建议使用队列,控制并发,不要直接开几百个采集线程。
推荐配置:
AMD EPYC 9554
128GB - 256GB 内存
2 × 960GB NVMe SSD
1Gbps / 3Gbps 国际带宽
图片处理通常 CPU 和磁盘都吃。
建议源文件、临时文件、输出文件分目录,必要时分盘。
推荐配置:
AMD EPYC 9554 / 双路 EPYC 9754
256GB - 512GB 内存
多块 NVMe SSD
3Gbps / 10Gbps 国际带宽
视频任务非常容易吃满 CPU 和磁盘。
如果是纯 CPU 转码,核心数很重要;如果有 GPU 转码需求,则应考虑 GPU 服务器,而不是单纯堆 CPU。
推荐配置:
AMD EPYC 9554
256GB 内存
NVMe SSD
3Gbps 国际带宽
日志分析往往不是 CPU 最先满,而是磁盘读取、内存缓存、查询引擎配置先成为瓶颈。
ClickHouse、Elasticsearch、Loki、OpenSearch 这类系统对磁盘和内存都比较敏感。
推荐配置:
双路 AMD EPYC 9754
512GB / 1TB 内存
多块 NVMe SSD
3Gbps / 10Gbps 国际带宽
AI 数据预处理不一定需要 GPU。
比如文本清洗、图片分类前处理、样本去重、格式转换、数据切片,很多都是 CPU + 内存 + 磁盘型任务。
这类任务适合高核心 AMD 服务器。
等到真正进入模型训练或推理阶段,再考虑 A100、H100、RTX 4090、RTX 5090 等 GPU 服务器。
批量任务上线前,建议不要只看配置表,一定要做压力测试。
可以使用 sysbench:
sysbench cpu --threads=64 --time=60 run不同线程数分别测试:
sysbench cpu --threads=16 --time=60 run
sysbench cpu --threads=32 --time=60 run
sysbench cpu --threads=64 --time=60 run
sysbench cpu --threads=128 --time=60 run
观察线程增加后性能是否线性提升。
如果 64 线程以后提升不明显,说明任务可能不是纯 CPU 瓶颈。
可以用 fio 测试顺序读写:
fio --name=seqwrite --rw=write --bs=1M --size=10G --numjobs=1 --runtime=60 --time_based --group_reporting测试随机读写:
fio --name=randrw --rw=randrw --bs=4k --size=10G --numjobs=8 --runtime=60 --time_based --group_reporting批量任务里,小文件多就看随机 IOPS;
大文件转码、日志扫描就看顺序吞吐。
可以用 iperf3 测试节点间吞吐:
iperf3 -c 测试节点IP -P 8 -t 60也可以测试多线程下载:
wget -O /dev/null 测试文件URL或:
curl -o /dev/null 测试文件URL重点观察:
最有价值的测试不是跑分,而是用真实任务压测。
例如:
先跑 10 个 Worker,观察 30 分钟
再跑 30 个 Worker,观察 30 分钟
再跑 60 个 Worker,观察 1 小时
最后跑到目标并发,观察完整任务周期
观察这些指标:
| 指标 | 正常表现 | 异常表现 |
|---|---|---|
| CPU | 稳定 70% - 90% | 长期 100% 或大量 iowait |
| 内存 | 有缓存但不持续上涨 | 持续上涨直到 OOM |
| 磁盘 | 读写稳定 | iowait 很高 |
| 网络 | 接近预期带宽 | 波动大、丢包、重传高 |
| 队列 | 有积压但能消化 | 积压越来越多 |
| 错误率 | 稳定较低 | 失败任务持续增加 |
批量任务环境建议使用稳定版本系统。
Ubuntu 22.04 LTS 对新硬件、容器、Python、Go、Node.js、Docker 支持比较成熟,适合大多数任务型服务器。
CentOS 7.x 仍然有不少老业务在用,但新项目更建议使用 Ubuntu 22.04 或其他长期支持版本,后续维护更省心。
建议至少监控:
可以使用:
Prometheus + Grafana
Netdata
Zabbix
Node Exporter
ELK / Loki
批量任务最怕“看不到问题”。
任务失败、速度下降、机器卡顿,必须能从监控里看出是 CPU、内存、磁盘还是网络。
批量任务一定要考虑失败恢复。
建议设计:
任务状态:待处理 / 处理中 / 已完成 / 失败 / 延迟重试
任务 ID:唯一标识
任务日志:记录开始时间、结束时间、失败原因
断点续跑:失败后不重复处理已完成部分
幂等设计:重复执行不会造成数据错乱
很多服务器配置问题,最后其实暴露的是程序调度问题。
一旦任务不能断点续跑,服务器重启、网络波动、磁盘满、程序崩溃,都会造成大面积重复任务或数据不一致。
中大型批量任务不要把所有东西都塞在一台服务器上。
更合理的架构是:
任务调度节点:负责分发任务
计算节点:美国 AMD 服务器,负责执行批量任务
数据库节点:单独部署,负责存储任务状态
对象存储 / 文件服务器:存放源文件和结果文件
监控节点:负责日志和指标采集
如果预算有限,可以先从一台美国 AMD 服务器开始。
但业务量上来后,数据库和批处理最好分开,不然批量任务一跑满,数据库也会被拖慢。
| 你的业务情况 | 是否适合美国 AMD 服务器 |
|---|---|
| 只是放企业官网 | 不一定需要,普通服务器即可 |
| 有大量定时脚本 | 适合 |
| 有批量图片处理 | 很适合 |
| 有视频转码任务 | 适合高配 AMD 或 GPU 服务器 |
| 有海外数据采集 | 适合 |
| 有大量国际下载分发 | 适合,建议关注带宽 |
| 国内用户实时访问后台 | 要谨慎,可能更适合精品线路 |
| 国内游戏实时交互 | 不建议普通美国线路 |
| AI 数据预处理 | 适合高核心 AMD |
| AI 推理 / 训练 | 更建议 GPU 服务器 |
一句话总结:
只要你的任务不是强实时交互,而是大量计算、处理、同步、转码、采集、分析,美国 AMD 服务器就很适合。
对于想跑批量任务的用户,可以按这三个层级选择:
适合:
采集任务
图片缩略图
定时脚本
API 同步
中小型后台任务
推荐:
AMD EPYC 4584PX / 4585PX
64GB 内存
960GB NVMe SSD
1Gbps 国际带宽
特点是成本可控,适合先把任务跑起来。
适合:
批量图片处理
日志分析
中大型队列任务
数据清洗
批量导入导出
多业务 Worker
推荐:
AMD EPYC 9554
128GB / 256GB 内存
2 × NVMe SSD
1Gbps / 3Gbps 国际带宽
特点是 CPU、内存、磁盘比较均衡,适合生产环境长期运行。
适合:
大规模视频处理
AI 数据预处理
大型编译任务
海量日志分析
多任务并行平台
推荐:
双路 AMD EPYC 9754
512GB / 1TB 内存
多块 NVMe SSD
3Gbps / 10Gbps 国际带宽
特点是并行能力强,但必须搭配足够内存、NVMe 磁盘和带宽,不适合只看 CPU 单项配置。
美国 AMD 服务器非常适合跑批量任务,但前提是选型和部署方式要对。
真正的判断逻辑不是:
核心数越多越好而是:
CPU 核心数够不够
内存能不能撑住并发
磁盘吞吐会不会拖慢任务
带宽能不能支撑数据进出
队列调度能不能控制任务节奏
对于批量任务来说,一台服务器的价值不是看配置表上哪个参数最大,而是看它能不能在真实业务里持续、稳定、可控地完成任务。
如果是中小型数据采集、图片处理、后台脚本,美国 AMD 16 核 32 线程平台已经可以起步。
如果是生产级批处理、日志分析、转码和数据清洗,建议直接考虑 EPYC 9554 这类 64 核 128 线程平台。
如果是 AI 数据预处理、大规模并行计算和重型批量任务,则应选择双路 EPYC 9754、多 NVMe、大内存和高带宽组合。
批量任务最终拼的不是单点性能,而是整体吞吐。
CPU、内存、磁盘、带宽一起算,才是真正适合生产环境的美国 AMD 服务器选型方式。


