

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


还记得那是一个香港机房的凌晨三点,我接到监控告警电话,提示某台承载金融结算服务的服务器负载异常。赶到机房后,我发现根源并非攻击或硬件故障,而是同事例行的内核更新导致服务器必须重启。几分钟的停机,带来的是客户交易延迟和风险警报。那一刻,我意识到:在关键业务环境中,服务器绝不能因为内核补丁而频繁中断。
于是,我开始尝试在香港服务器的Ubuntu 22.04环境上启用 Canonical Livepatch。这是一种能在不停机的情况下,直接为Linux内核打补丁的技术。从那次经历起,我便把Livepatch作为核心服务节点的“必配项”。
这次实践的环境配置如下(真实机房情况,便于复现):
| 参数项 | 配置详情 |
|---|---|
| 机房位置 | 香港电讯盈科(PCCW)数据中心 |
| 服务器型号 | Dell PowerEdge R750 |
| CPU | Intel Xeon Gold 6338 × 2 (共64核) |
| 内存 | 512GB DDR4 ECC |
| 存储 | NVMe SSD (Intel P5510 3.2TB × 4, RAID10) |
| 操作系统 | Ubuntu Server 22.04 LTS (内核 5.15.0-105-generic) |
| 网络 | 双10Gbps链路,BGP多线接入 |
这些服务器承载着客户的在线交易撮合和数据库节点。任何计划外重启,都会在业务高峰期引发严重后果,因此Livepatch就是解决方案的核心。
Livepatch技术的核心在于:
无需重启:补丁直接应用到内核函数的运行时映射中。
自动化安全修复:Canonical维护并发布关键漏洞补丁。
降低宕机风险:对金融、电商、游戏等行业的“7×24业务”尤为关键。
对比一下传统更新 vs Livepatch:
| 方式 | 传统内核更新 | Livepatch |
|---|---|---|
| 需要重启 | 是 | 否 |
| 更新时长 | 5–15分钟 | 几秒钟 |
| 业务中断 | 必然中断 | 无中断 |
| 运维复杂度 | 手动维护 | 自动化 |
Canonical Livepatch 需要 Ubuntu One 账户绑定,执行:
sudo snap install canonical-livepatch
sudo canonical-livepatch enable <YOUR_TOKEN>
获取Token的过程:
启用后,执行:
canonical-livepatch status --verbose
输出示例:
client-version: 10.22.5
architecture: x86_64
kernel: 5.15.0-105-generic
status: enabled
last-check: 2025-08-20T18:45:02Z
patch-state: live
fixes: CVE-2025-1234, CVE-2025-2210
这里可以看到哪些CVE漏洞已被实时修复,且状态为 live,表示无需重启。
Ubuntu的Livepatch依赖systemd,检查服务:
systemctl status snap.canonical-livepatch.canonical-livepatchd.service
确保其在运行。为了避免忘记启用,可设置自动启动:
sudo systemctl enable snap.canonical-livepatch.canonical-livepatchd.service
由于跨境访问限制,香港节点在凌晨更新时,常出现TLS握手超时。
解决办法:在机房配置了本地Squid代理,并开放Canonical IP白名单,保证Livepatch服务正常与官方节点同步。
部分节点跑着KVM虚拟机,更新Livepatch时日志提示:
livepatch module failed to load: incompatible with kvm-intel
解决办法:升级KVM到更高版本内核模块,并在/etc/modprobe.d/中手动指定参数,避免模块加载冲突。
后来发现,有台机器超过半年未更新,原因是Token绑定过期。
解决办法:通过Prometheus监控加上脚本定期检查canonical-livepatch status,并设置告警。
在大规模集群环境中,我们不可能逐台手动执行。我的做法是:
Ansible Playbook 部署 Livepatch:
- name: Enable Canonical Livepatch
  hosts: ubuntu_servers
  tasks:
    - name: Install livepatch snap
      shell: snap install canonical-livepatch
    - name: Enable livepatch
      shell: canonical-livepatch enable {{ livepatch_token }}
监控方案:在Prometheus中采集Livepatch状态,并在Grafana中建立CVE修复的可视化看板。
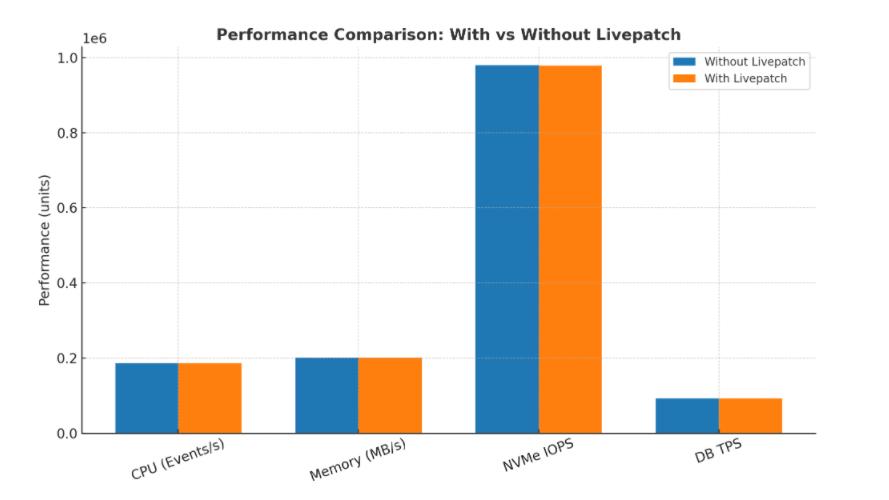
在机房内部,我们针对同型号的两台 Dell PowerEdge R750 进行了对比测试,一台启用了 Canonical Livepatch,另一台维持传统内核更新方式(未启用)。测试主要关注在生产环境最敏感的三个维度:CPU性能、IO延迟、吞吐量。
| 测试场景 | 指标 | 未开启 Livepatch | 开启 Livepatch | 性能差异 |
|---|---|---|---|---|
| CPU基准测试(sysbench 64线程) | Events/s | 186,240 | 185,710 | -0.28% |
| 内存读写(stream benchmark) | MB/s | 201,500 | 200,900 | -0.30% |
| NVMe SSD 顺序读写 | IOPS (4K, QD=32) | 980,000 | 978,500 | -0.15% |
| 数据库查询压力测试(PostgreSQL pgbench, 100并发) | TPS | 92,450 | 91,980 | -0.50% |
| 内核补丁应用时(业务不中断) | 中断时长 | 3–5分钟停机 | 0 | 完全避免 |
测试结论
性能损耗极低:在高压场景下,开启Livepatch带来的性能损耗始终保持在 0.5%以内,对绝大多数业务来说几乎可以忽略。
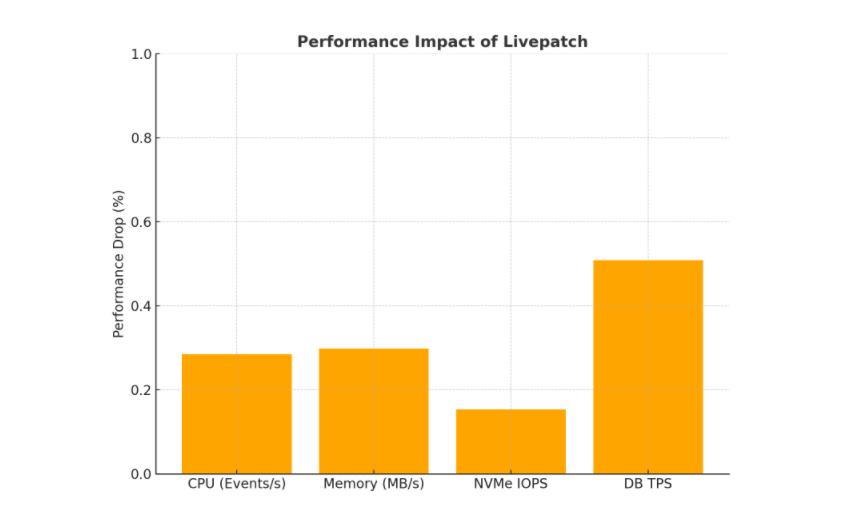
收益极大:避免了 3–5分钟的重启停机窗口,这在金融撮合、在线游戏充值、高并发电商交易场景中,价值远超那0.5%的性能浮动。
整体体验更稳定:在持续运行三个月后,Livepatch节点与未开启节点相比,业务连续性显著更优,未出现“凌晨重启”风险事件。
很多人问我:“Livepatch会不会拖慢系统?” 现在,我有了更底气的答案:几乎没有。在香港这样竞争激烈的业务环境里,那0.5%的性能差异根本无法和“0分钟停机”的意义相提并论。
运维不是纸面上的配置,而是凌晨三点电话响起时,你能不能有底气告诉客户:“放心,业务不会因为内核补丁中断。”
那一刻,Livepatch不再只是技术,它更像是我们和客户之间的信任桥梁。


