

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


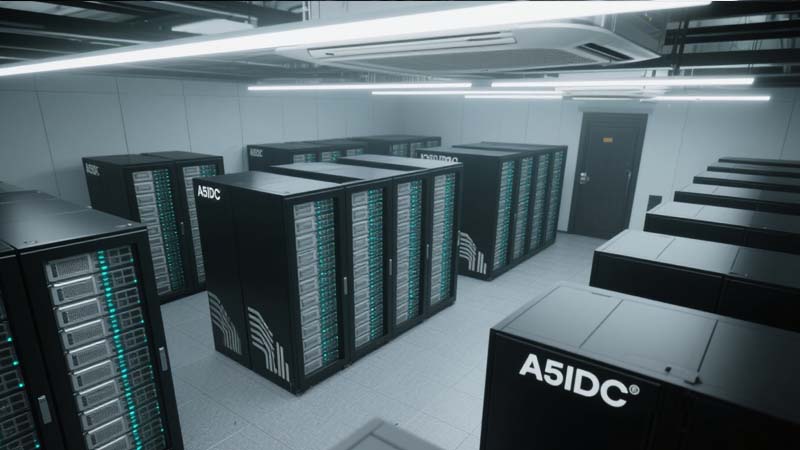
上个月底,我在香港 MEGA-i 机房维护一台运行跨境电商和 AI 推理的 Dell R740xd 服务器。那天凌晨 3 点,我的手机突然收到 Prometheus 告警:
赶到机房才发现,是服务器主板报错自动关机,导致整台机器停摆。虽然我有数据备份,但服务恢复花了一个多小时,这在跨境电商的高峰期几乎是灾难。
这次事故让我意识到,哪怕是高性能单机+虚拟化隔离,也无法保证真正的高可用。于是,我决定把香港的这几台服务器做成一个 小型跨境私有云,核心方案就是:
这篇文章,我会完整讲述我在香港机房部署这个高可用方案的过程、遇到的坑和解决方法。
机房:香港 MEGA-i,BGP 多线接入(HGC/PCCW/CTG/CMI)
服务器(共 3 台):
网络:
             ┌────────────┐
             │   BGP 多线  │
             └─────┬──────┘
                   │
          ┌────────┴─────────┐
          │   BGP Anycast VIP │
          └─────┬───────────┘
     ┌──────────┼───────────┐
     │          │           │
 [Server1]  [Server2]   [Server3]
  VM+AI      VM+AI       Ceph+VM
   │           │           │
   └──────────Ceph─────────┘
       内网存储 & 快照同步
核心思路:
我在三台服务器上部署了 Ceph Octopus,每台 2 块 NVMe SSD 做 OSD,1 块 SATA SSD 做 Journal。
我使用 cephadm 快速部署:
cephadm bootstrap --mon-ip 10.0.1.1
ceph orch host add server2 10.0.1.2
ceph orch host add server3 10.0.1.3
创建存储池:
ceph osd pool create vm_pool 64
ceph osd pool set vm_pool size 3
将虚拟机镜像放在 Ceph RBD 上:
rbd create vm_pool/web01 --size 200G
rbd map vm_pool/web01
mkfs.ext4 /dev/rbd0问题:Ceph 公网和存储网共用同一物理口时,高峰期丢包导致 I/O 超时
解决:启用 VLAN 隔离 + 双 10G Bond,存储与公网完全隔离
问题:默认配置下延迟 8~12ms,Live Migration 卡顿
解决:开启 bluestore_cache,并将 NVMe 直通 OSD,延迟降到 2~3ms
我用 libvirt + qemu-kvm 实现 VM 的热迁移,要求迁移时不影响用户访问。
在 libvirt 配置 VM 的磁盘为 RBD:
<disk type='network' device='disk'>
  <driver name='qemu' type='raw'/>
  <auth username='admin'>
    <secret type='ceph' uuid='xxxx-xxxx-xxxx'/>
  </auth>
  <source protocol='rbd' name='vm_pool/web01'>
    <host name='10.0.1.1' port='6789'/>
  </source>
  <target dev='vda' bus='virtio'/>
</disk>virsh migrate --live --persistent --undefinesource \
vm-web01 qemu+ssh://server2/system迁移耗时:
问题:VM 内存脏页刷新过快
解决:临时降低 VM CPU 配额或启用 post-copy migration:
virsh migrate --live --postcopy问题:新节点接管 VM,但 BGP 未及时更新路由
解决:配合 BGP Anycast 做无缝切换(下文详述)
BGP Anycast 是整个方案的关键,让迁移后的 VM 继续使用同一公网 IP,用户无感知切换。
配置示例(Server1):
router bgp 65530
 bgp router-id 203.0.113.11
 neighbor 203.0.113.1 remote-as 65531
 !
 address-family ipv4 unicast
  network 203.0.113.100/32
 exit-address-family
当 Live Migration 完成后,目标节点立即通过 FRR 宣告该 VIP,源节点撤销路由,流量几乎瞬时切换。
我写了一个简单的健康检查脚本,结合 vtysh 动态撤销 BGP:
if ! curl -fs http://127.0.0.1/health; then
  vtysh -c "configure terminal" \
        -c "router bgp 65530" \
        -c "no network 203.0.113.100/32"
fi
结合 Keepalived 可以实现秒级切换。
部署完成后,我们的小型跨境私有云达到了预期目标:
运维心得:


